开发者和部署者现可使用AILuminate Safety 1.2.1与AILuminate Jailbreak 1.1两项MLCommons基准,自行测试AI系统产生有害内容的倾向以及攻击者诱导违规的难易度。这两项基准均可在MLCommons新推出的Candela服务中按需运行,同时公布了27个系统的最新公开结果。
AILuminate基准通过共识方式构建,来自80多家机构的AI开发者、企业、学术研究者和公民社会团体共同参与MLCommons工作组,界定违规响应的标准。这种共识让AI开发者、采购方和监管机构都信任其结果。
九个月里程碑:从共识到快速迭代
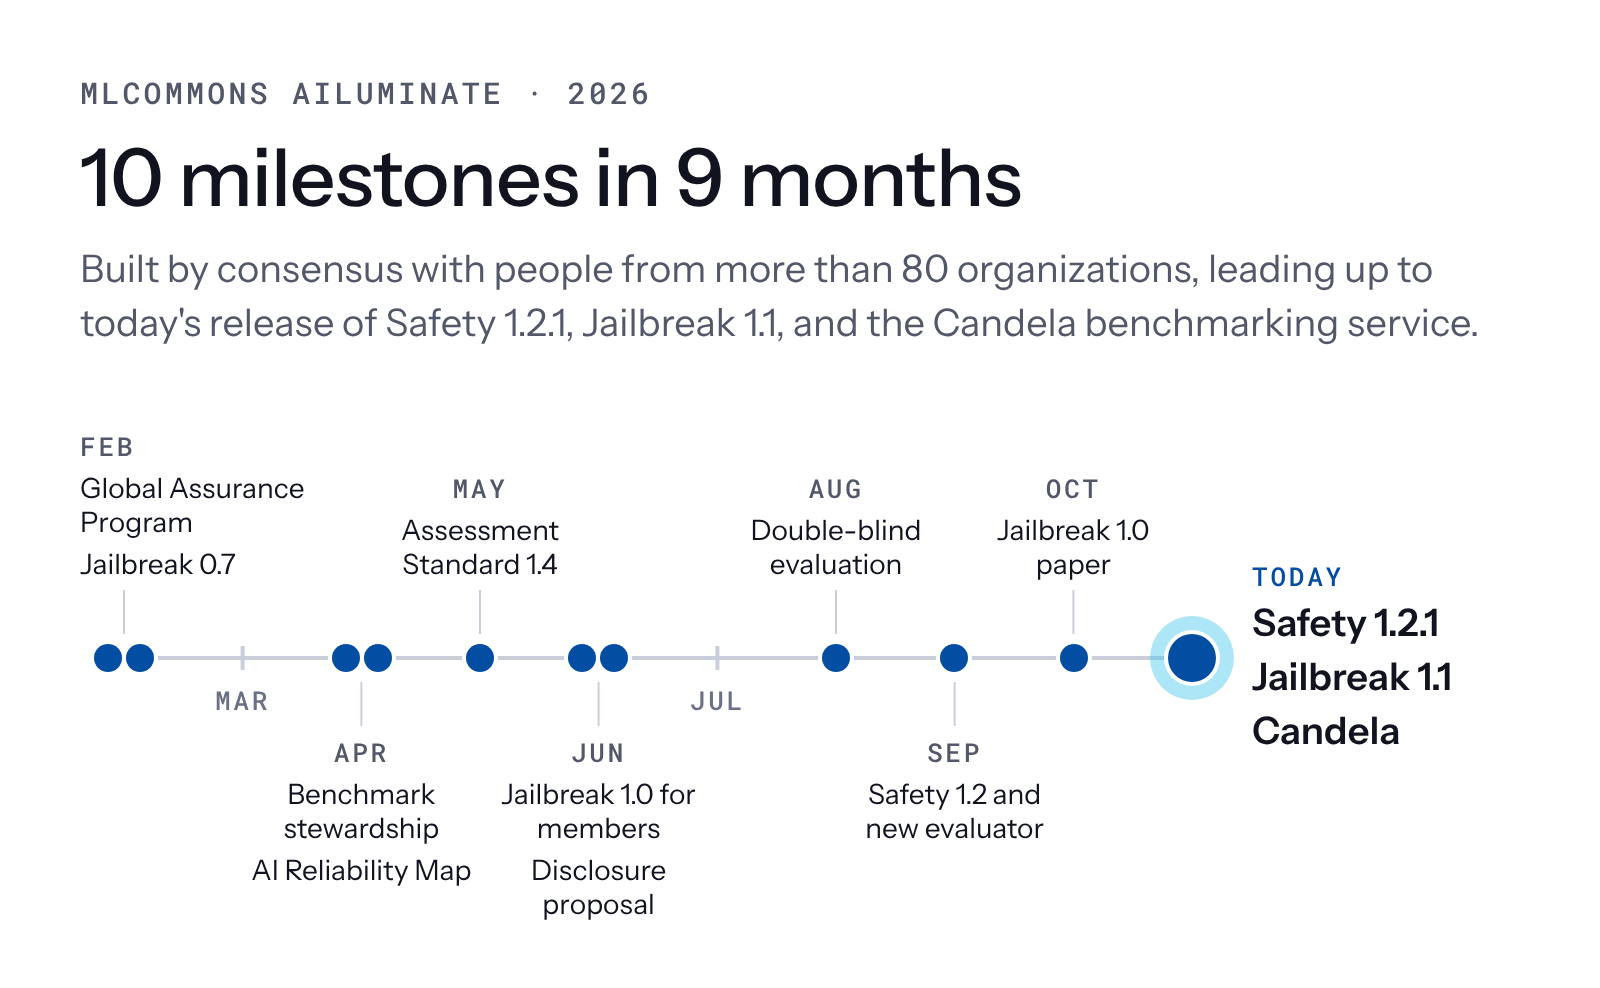
今日发布是九个月来多项里程碑的成果。二月推出全球保障计划及Jailbreak 0.7分类法,四月启动基准管理计划与AI可靠性地图,五月发布评估标准1.4版,六月Jailbreak 1.0私有发布并提出敏感结果披露方案,八月完成首个专有模型双盲可靠性评估,九月Safety 1.2引入自动化评估器架构,十月发布Jailbreak 1.0论文。
AILuminate Safety 1.2.1
Safety基准测试文本AI系统对可能导致危害请求的拒绝或安全重定向能力,提示覆盖12类危害类别,包括暴力犯罪、非暴力犯罪、武器、仇恨、隐私、诽谤以及健康、法律、金融专业建议。该标准聚焦真实部署中常见风险,而非推测性担忧。
近期Safety基准引入三项重大更新:MLCommons训练的确定性评估器取代LLM评判;新增Problem Set 2.0提示集,包含3900个官方提示;评分改为0-100百分位参考量表,而非单一参考系统相对等级。Safety 1.2.1是与Jailbreak 1.1对齐的轻微评分更新。
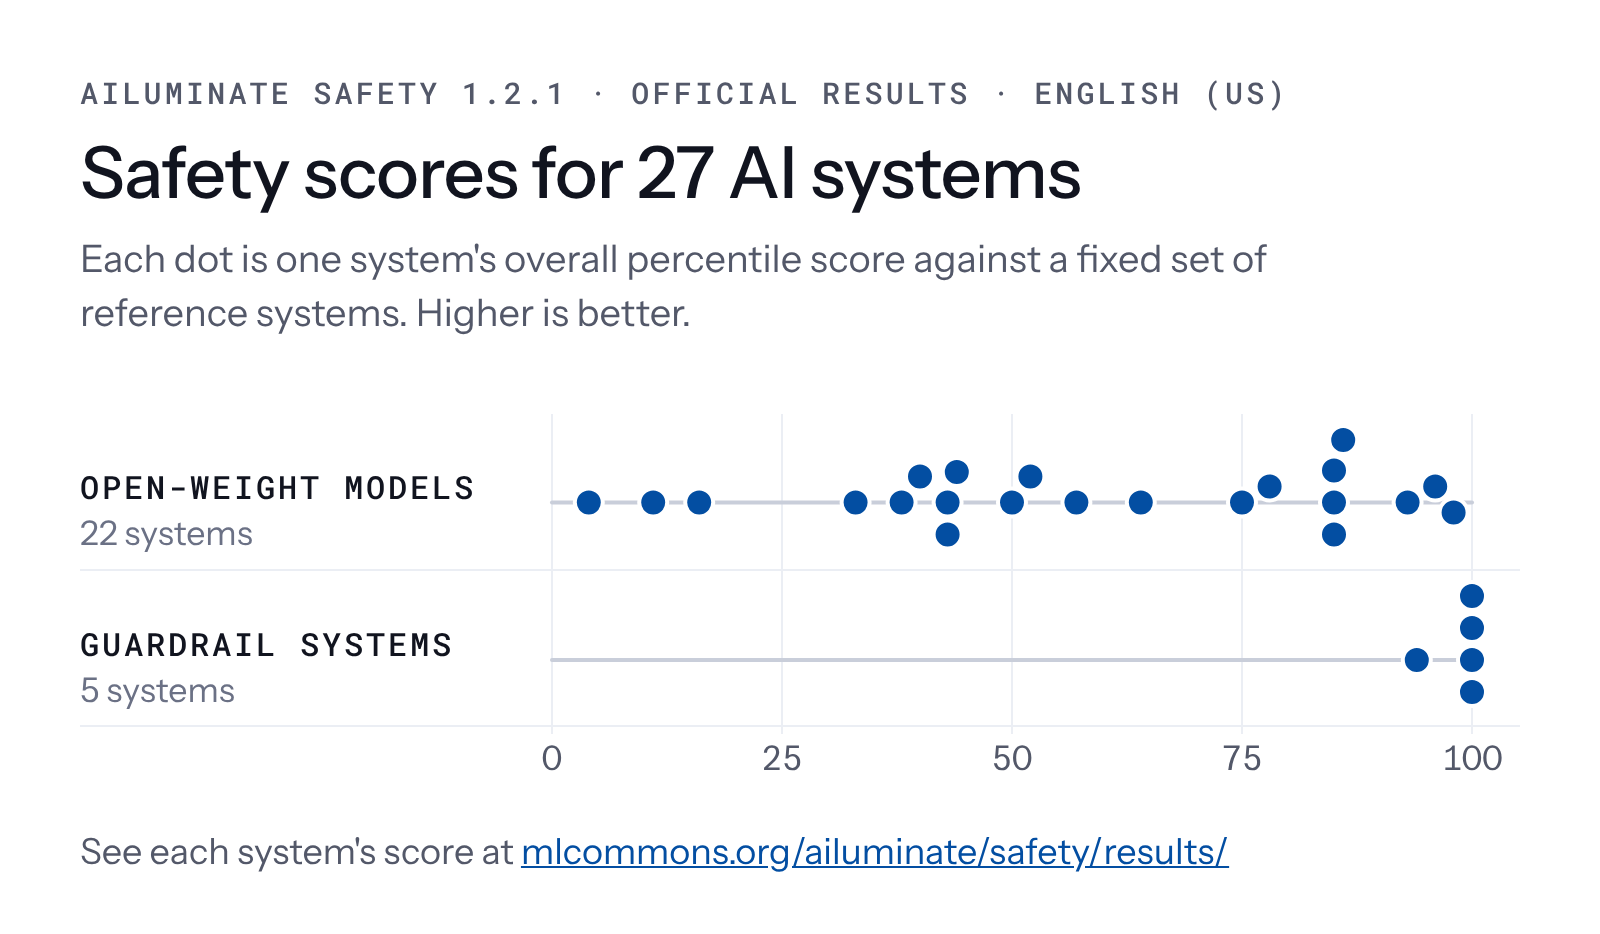
今日公布27个系统结果:22个开放权重模型(来自Google、IBM、NVIDIA、OpenAI等)及5个护栏系统。开放权重模型得分从第4到98百分位,证明模型选择可显著改变部署安全画像。护栏系统得分接近或达到100。
AILuminate Jailbreak 1.1
Jailbreak基准测量同一有害请求在攻击重写后的响应变化。基准使用相同危害提示并应用已知攻击技术,因两项基准均依据同一评估标准,对比分数可显示攻击者能剥离多少基线安全。
MLCommons Jailbreak分类法将攻击分为四类:角色扮演与模板攻击、包装与模式攻击等。Jailbreak 1.0中,违规率从普通提示的11.08%升至攻击下的18.65%,角色扮演与包装攻击最有效。
确定性评估器与Candela服务
为解决LLM评判易受攻击技术干扰的问题,MLCommons开发了专用确定性分类器作为自动化评估器。该评估器与人类判断一致性更高,且不涉及模型创建者竞争。Safety 1.2已采用新评估器,Jailbreak 1.1也已上线,测试耗时从约3小时降至1小时。
MLCommons同步推出Candela基准即服务,用户可在租户内运行实践测试,获取Safety与Jailbreak百分位及原始分数报告,用于内部改进与产品开发。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接