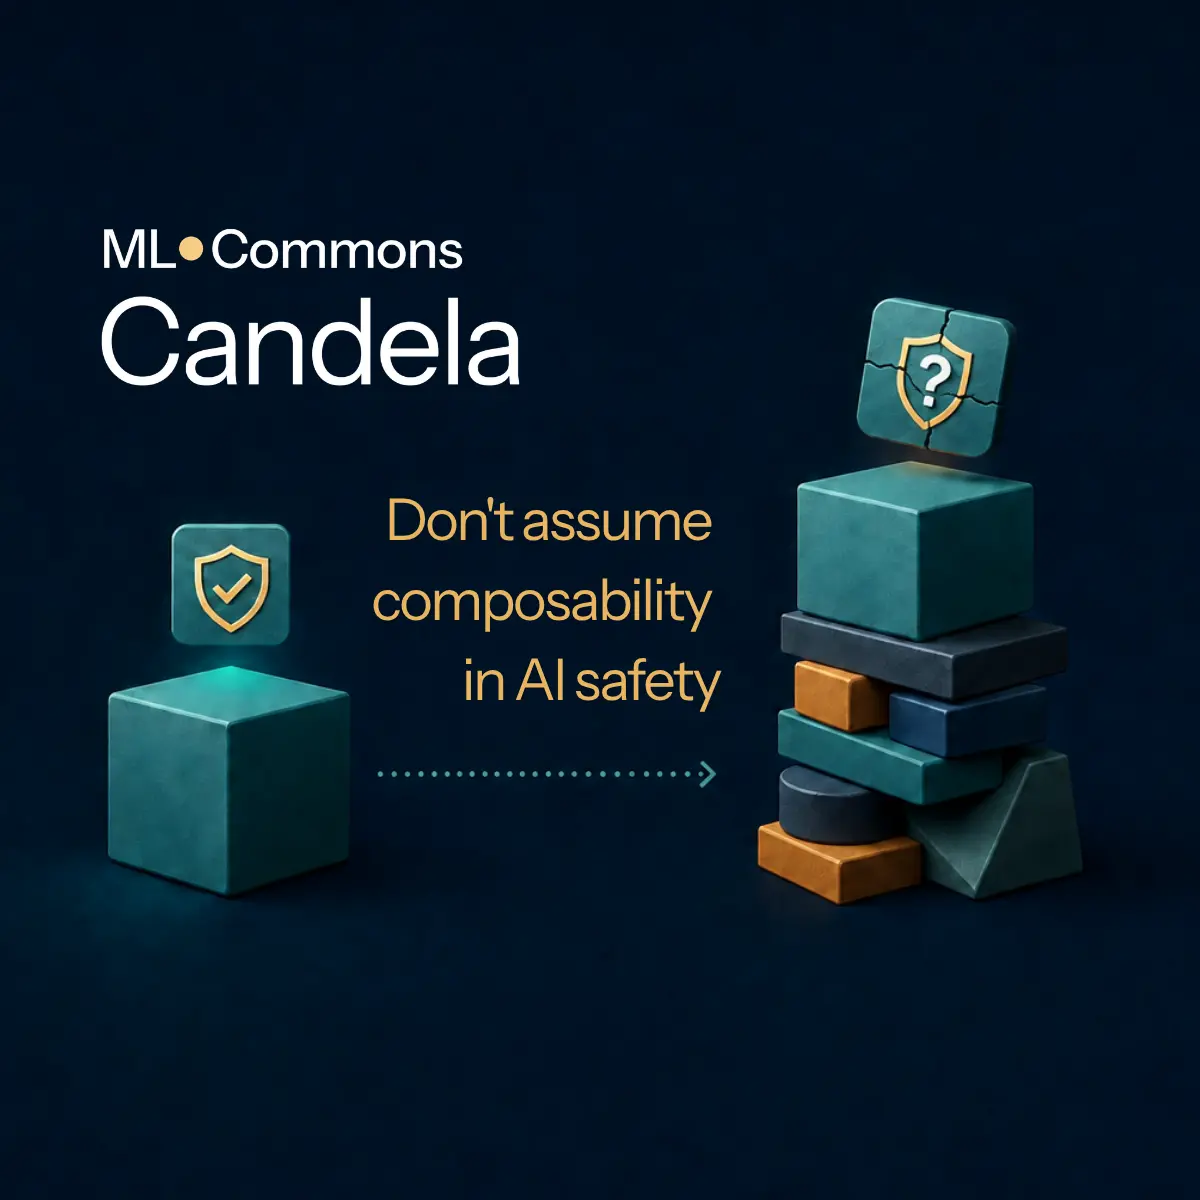
从业者深知,部署后的AI系统行为与基础模型大不相同。随着系统提示、检索层、微调等修改,行为持续变化。但安全评估常错误地假设可组合性,即直接引用基础模型系统卡上的安全分数。
系统可组合性并非理所当然
可组合性指上游系统的评估结果能否适用于下游构建的系统。在经典软件中这一假设通常成立,但在AI安全领域,情况往往相反。
安全分数变化不可预测
CDT与MIT研究显示,医疗和法律微调模型的安全分数与基础模型相比,有的更高、有的更低,没有单一因素可预测方向或幅度。添加运行时防护通常能提升分数,但具体效果需实际测试。
测量方法必须同步改进
许多常用基准噪声过大,无法可靠比较部署前后系统。MLCommons的Candela基准即服务产品,可对包含提示、防护、检索和工具的完整部署系统进行AILuminate测试,并提供误差范围。
让可组合性可测试
当测量不确定性已知时,研究者可测试哪些修改保留结果、哪些破坏结果。这有助于团队选择是否跳过测试、简化测试或全面审查,也能支持监管划分开发者与部署者责任。
立即参与
部署团队可立即使用Candela测试系统。研究者可加入AIRR Analytics工作组,共同推进AI安全可组合性研究。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接