
以 GPT-6 Astra 为代表的前沿通用智能模型,已经在部分操作任务上展现出不错的零样本能力。但落地部署不能只看零样本表现,模型策略是否可靠更为关键。哪怕是业内最强的通用模型,机器人也容易在接触交互、对齐以及长流程任务执行中反复出错。
研究发现,加入人类动作示范可以有效提升模型可靠性。可问题在于:倘若每次能力升级都需要人工示范,当机器人大规模部署时,能提供示范的专家人力将跟不上扩张需求。
大洋彼岸,Physical Intelligence 也在关注这一问题。联合创始人 Sergey Levine 在近期访谈中指出,机器人起初需要人类采集的高质量示范来建立基础能力;能力成熟之后,便可以在真实世界里自主试错,利用自己采集的数据继续迭代学习。
在相似的思考中,清华大学、智元与无问芯穹联合提出了群体经验学习(Collective Experience Learning,CEL)范式,并在 96 台机器人上完成了该学习范式的原型验证。
CEL 论文封面
在手机包装为代表的多阶段、长流程工业场景中,训练后的策略在两台未参与训练的同型号机器人上完成 120 次测试,成功率从 79.2% 提升至 98.3%。换成更直观的数字:同样 120 次测试,失败从 25 次降至 2 次,减少了 92%。
更值得关注的是规模带来的收益:在相同物理训练时间内,参与学习的机器人从 16 台增加至 96 台,测试成功率由 86.7% 提高至 98.3%。机器人数量的增加转化为了更可靠的任务执行能力。
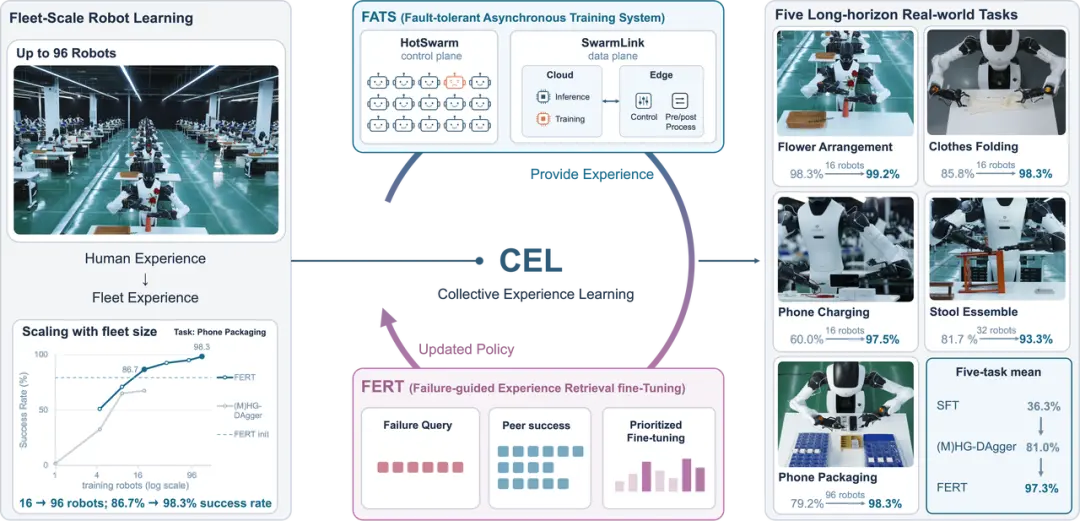
CEL 论文概览图
-
技术报告:https://arxiv.org/abs/2610.25736
-
网站链接:https://cel-robot-learning.github.io/
群体经验学习:机器人同伴,也能成为经验来源
机器人进化的现有路径高度依赖人类接管。无论是模仿学习还是人在环强化学习,都需要人类示范任务完成方式,或在机器人出错时介入。这不仅要求操作员动作流畅,还要熟悉接管时机,平衡自主探索与人类示教的数据比例。然而,随着训练机器人的数量增加,经验丰富的人类专家却难以同步扩展。
CEL 则改变了后续学习中动作监督的来源。
假设一台机器人在放置手机时遇到了困难,而另一台机器人曾在相似情境下成功完成操作。那么,后者的经验可以帮助共享策略弥补前者的不足,从而让一台机器人的练习惠及整个群体。
在这种范式中,人类的角色随之发生变化:从不断提供动作、协助探索,转向结果判定。
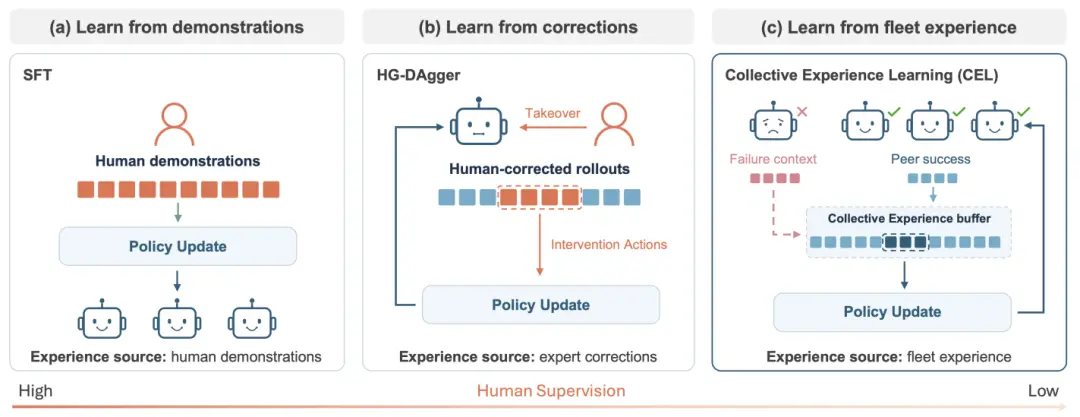
CEL 与之前学习范式的区别
要把 CEL 的思想变成可运行的学习过程,还需要跨过两道关。
-
第一,如何从仅有 0/1 反馈的大量执行经验中,找到真正值得学习的经验?
-
第二,如何让规模化的机器人在线运转,在通信受限和局部故障的情况下持续稳定地积累经验?
只有稀疏反馈,机器人究竟怎么学?
一次任务的时长有 3 分多钟,4000 多步,但任务最终的反馈却只有一个比特:成功记为 1,失败记为 0。这样的反馈可以区分任务是否完成,却无法直接指出:策略在哪些环节存在不足,又有哪些成功经验值得重点学习。为此,团队提出了失败引导的经验检索微调算法 FERT。它区分了成功与失败样本的作用:成功轨迹提供可学习的动作,失败场景则指明学习的重点方向。
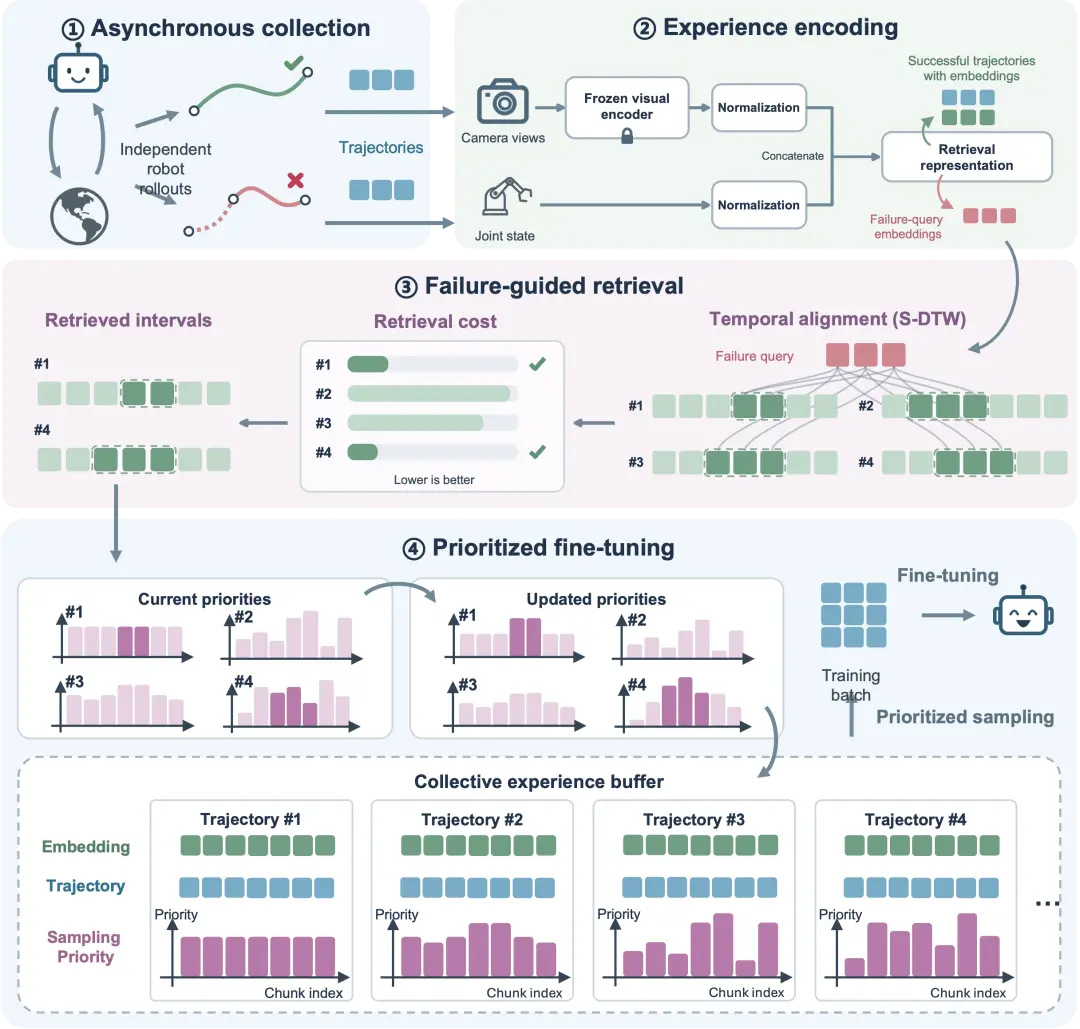
FERT 算法框架图
在 FERT 框架下,初始策略部署在各个机器人上异步执行任务。成功轨迹存入共享经验池,作为后续策略微调的学习素材。
失败轨迹的作用是定位模型需要重点学习的区域。算法会截取失败任务临近结束前的一段观测序列,对相机图像与机器人关节状态做联合编码,再凭借这段表征在成功经验池中检索相似的操作片段。
FERT 将成功轨迹与失败轨迹协同利用。和当前失败场景匹配的成功片段会被赋予更高采样优先级,引导训练重点聚焦于这些易出错环节。
更新完成的策略下发回机器人,持续生成新的成功与失败经验。群体经验的价值,一方面来自持续的数据积累,另一方面取决于能否把适配的经验精准送到模型最需要学习的地方。
96 台机器人同时训练,系统必须跟得上
让 96 台机器人持续积累经验,面对如下现实问题:有的执行快,有的复位慢;有的网络波动,有的需要充电,少数机器人还可能出现硬件故障。
如果局部故障就要重启整个训练,大规模的协同训练将无从谈起。
面对这一问题,团队设计了容错异步训练系统 FATS,将 100 台机器人、50 个边缘节点和 6 台云端服务器持续动态地组织起来,稳定支撑了大规模真实世界在线学习。FATS 将机器人视作和 GPU 同等的训练资源,实现了所有训练硬件的统一调度。
(1)SwarmLink:让数据高效流动
数据平面 SwarmLink 负责连通环境、推理与训练节点。每台机器人完成一轮任务后异步提交数据,训练侧可基于已抵达的经验数据实时更新策略,无需等待所有机器人任务完成。系统支持端云资源灵活编排,训练、推理等组件可按需部署在云端或端侧。支持基于多样化网络带宽与拓扑结构做自由配置,用以权衡权重同步带来的高带宽开销,以及推理、环境频繁交互引发的延迟压力。
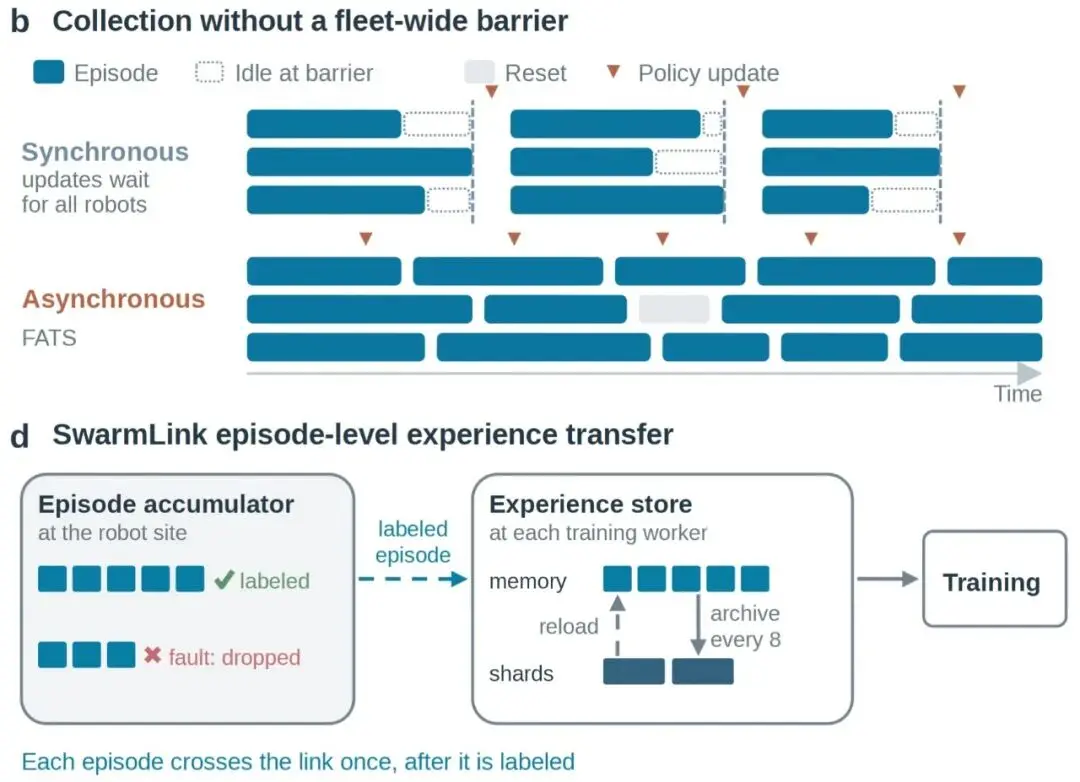
SwarmLink 设计
(2)HotSwarm:高容错的热插拔系统
控制平面 HotSwarm 管理节点和工作进程的动态进出。机器人暂停、离线或重新加入时,系统保留节点的注册信息与资源配置,更新工作进程,并修复受影响的连接。
在一项 96 台机器人规模的系统实验中,集群累计采集 9834 轮执行经验;期间共有 22 台机器人发生 30 起故障,而故障导致的机器人时间损失仅占总运行机时的 1.3%。即便硬件出现故障,集群的经验积累与训练学习过程仍可持续稳定推进。
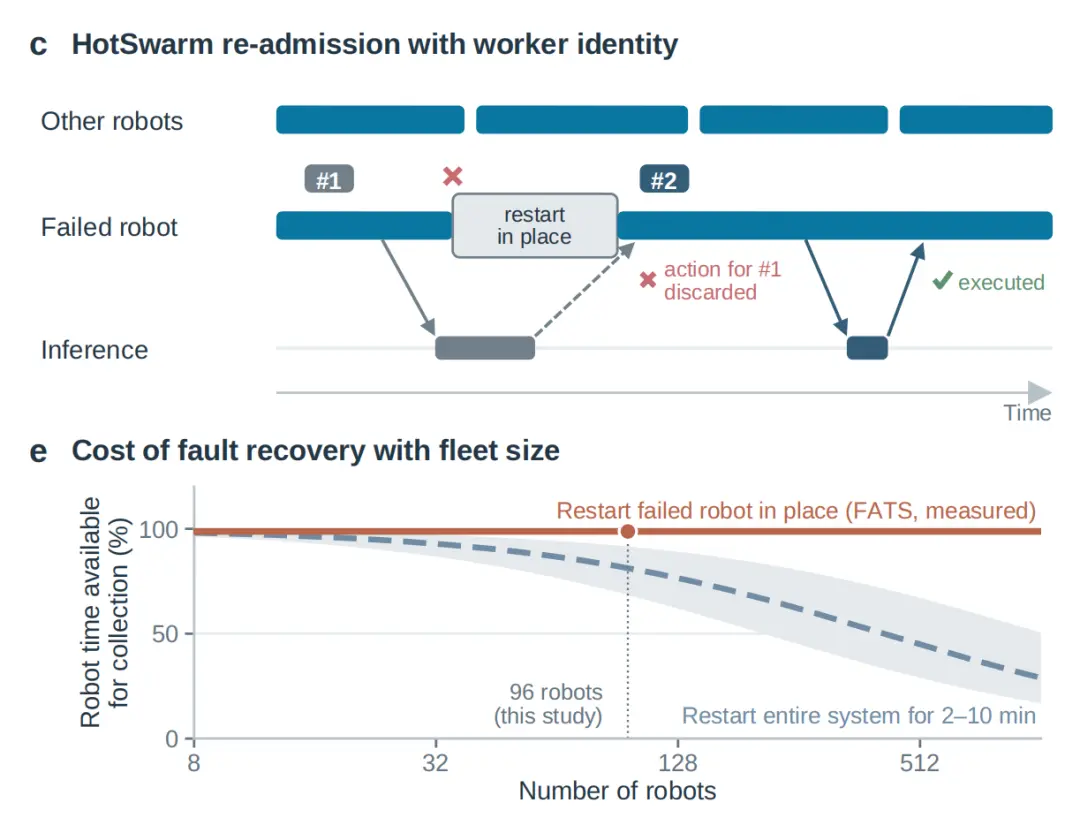
HotSwarm 设计
五类真实任务,群体经验能带来多少提升?
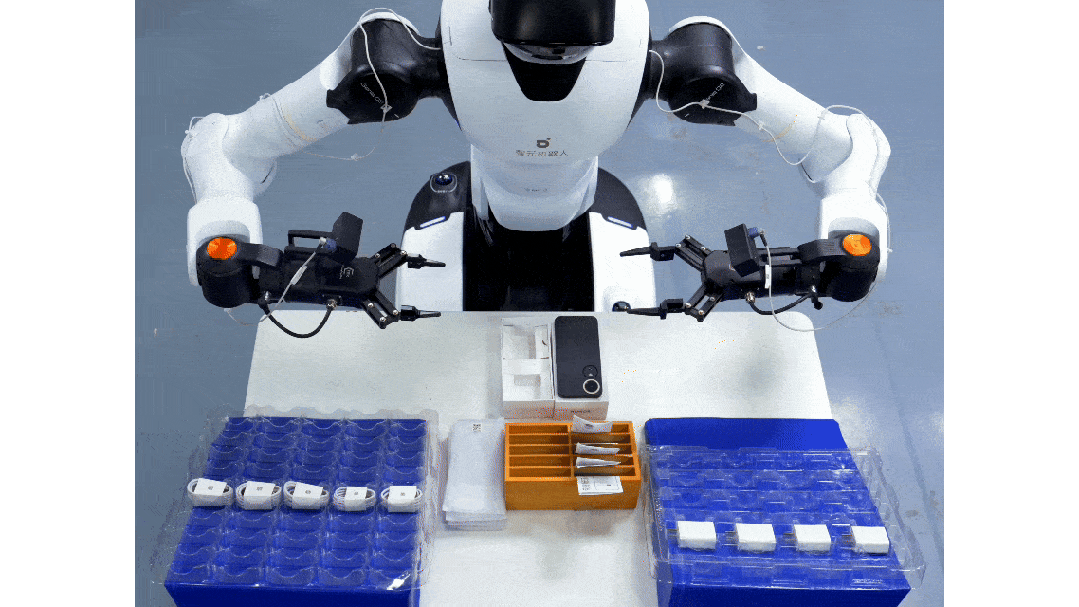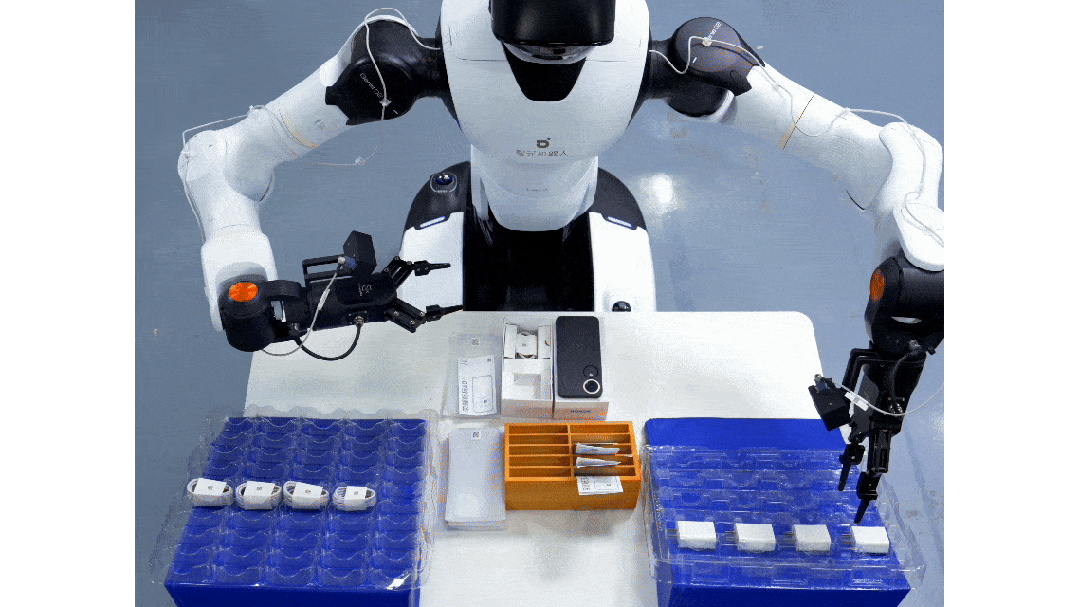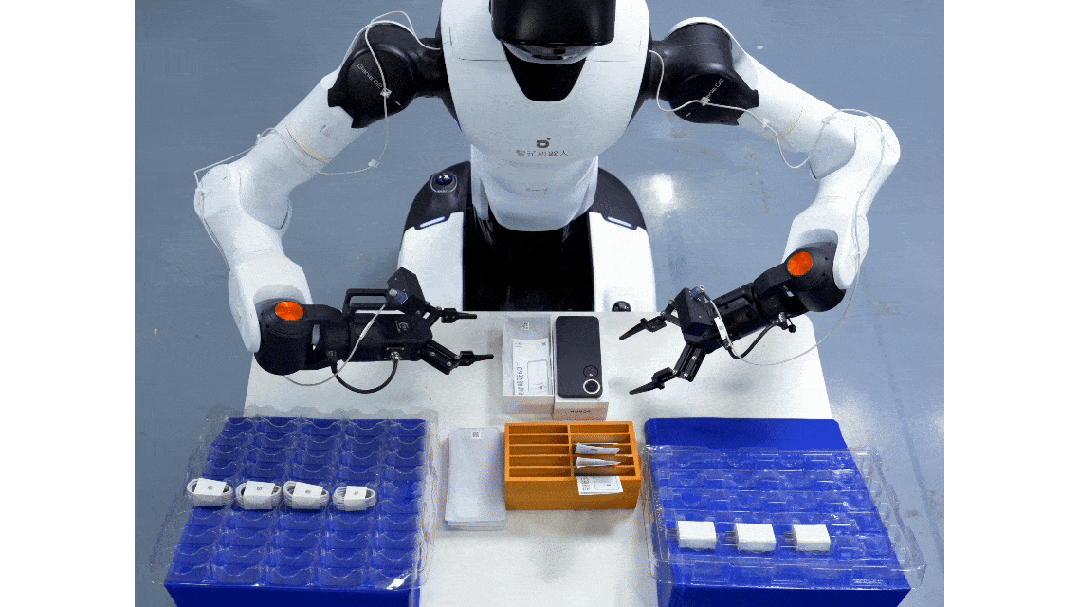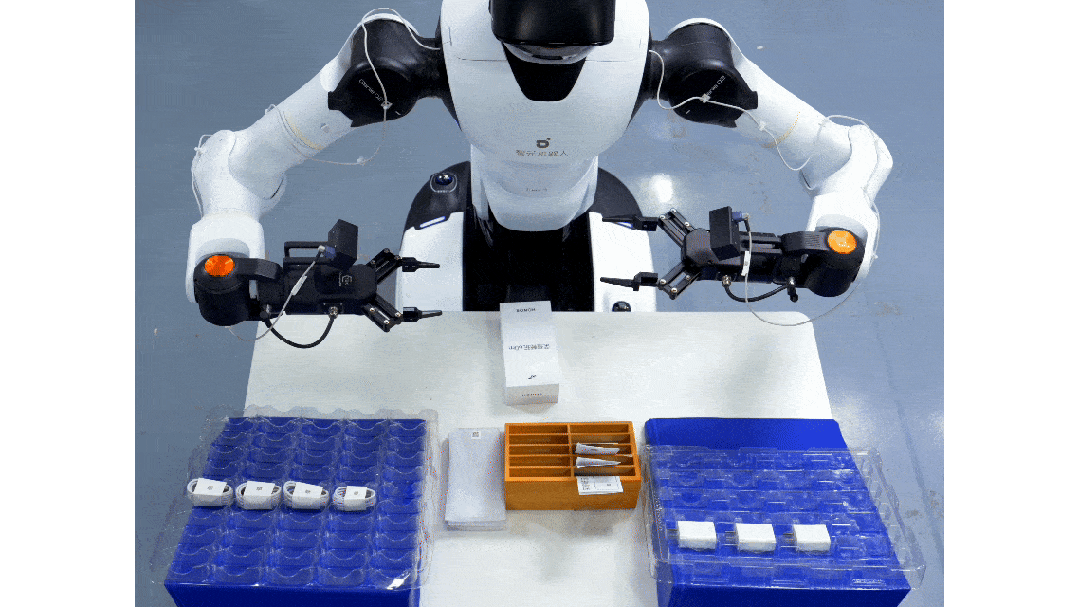
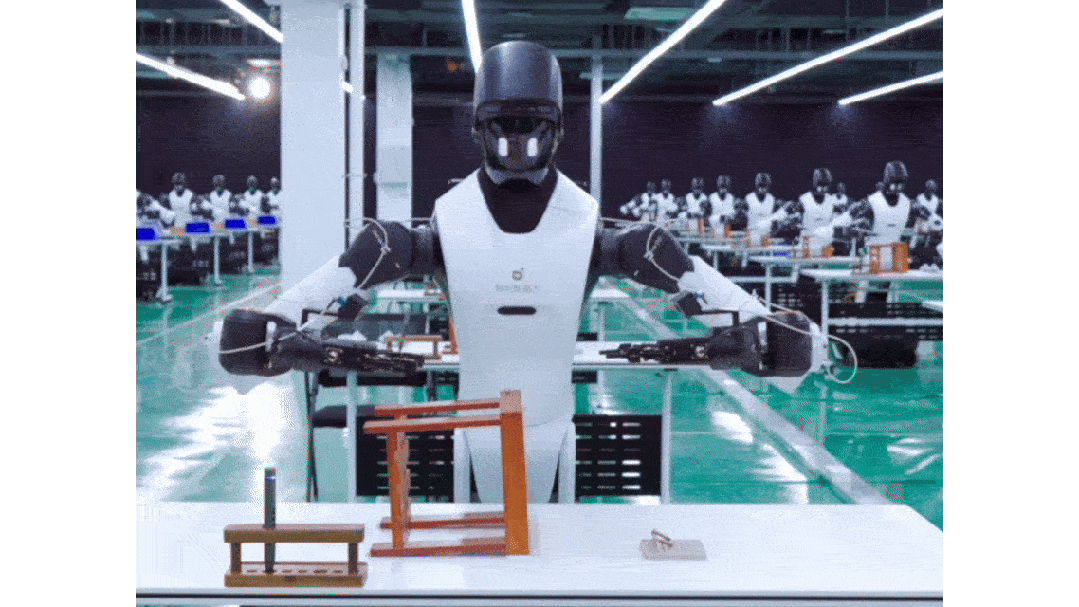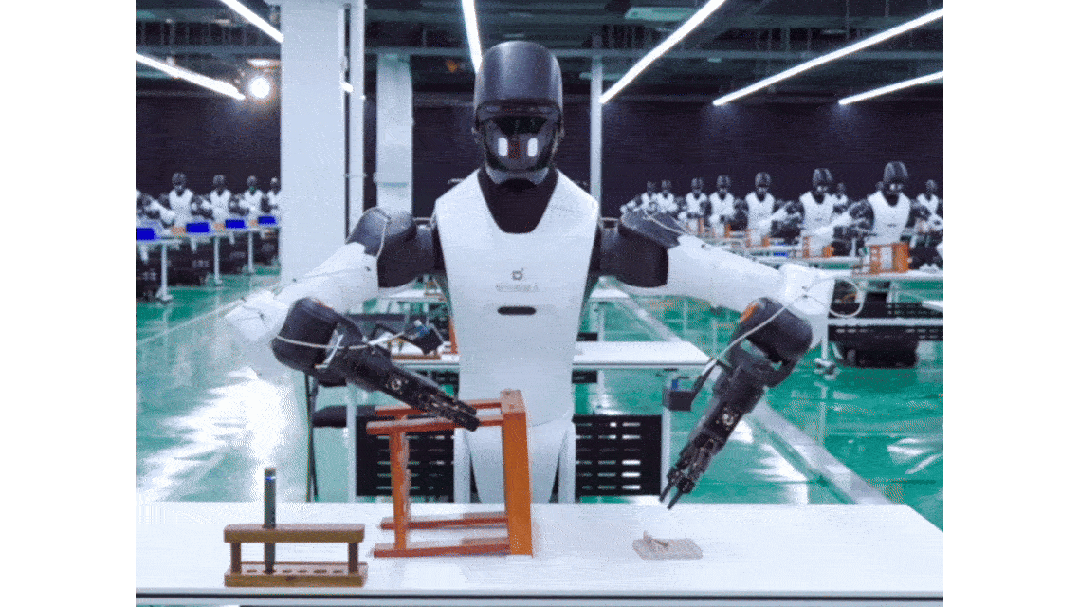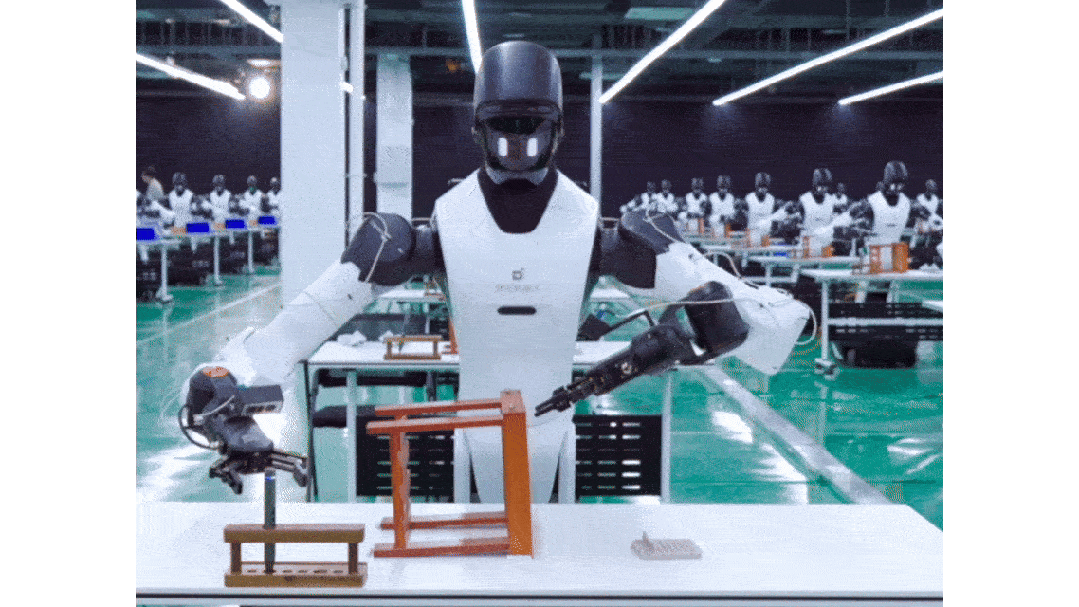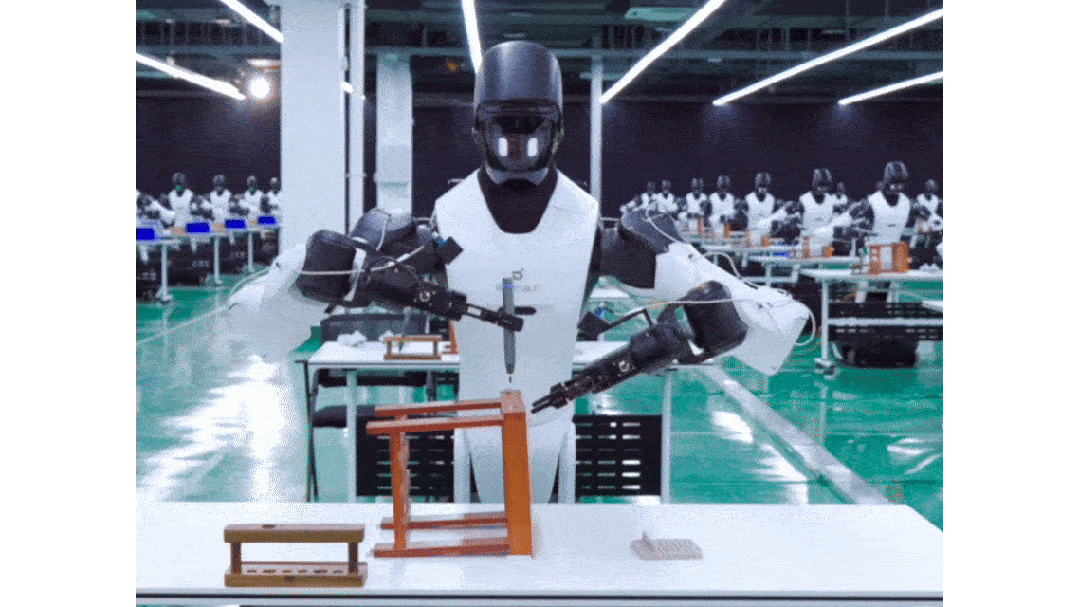
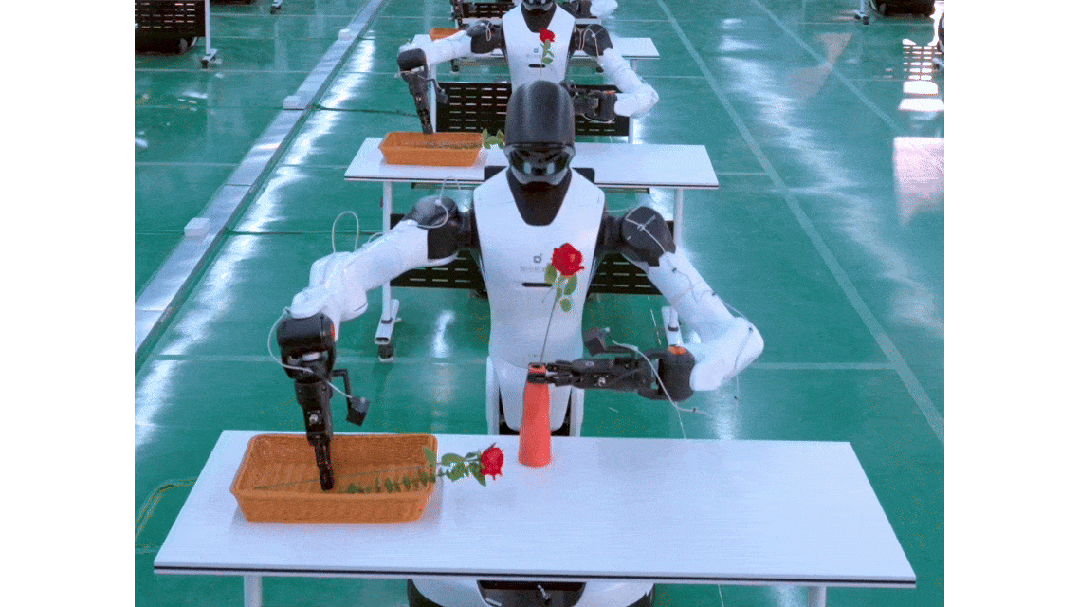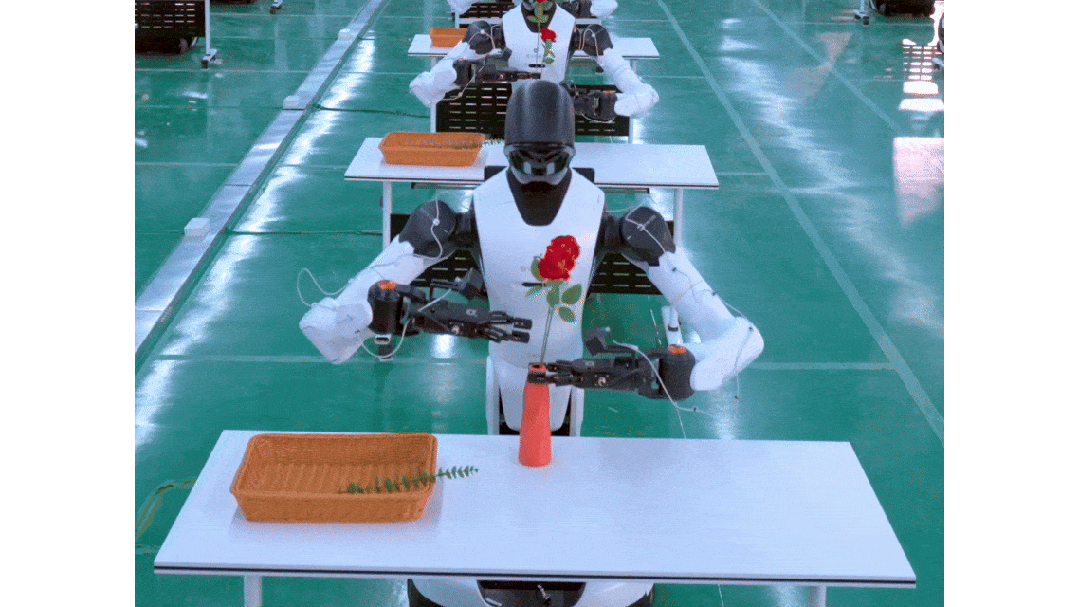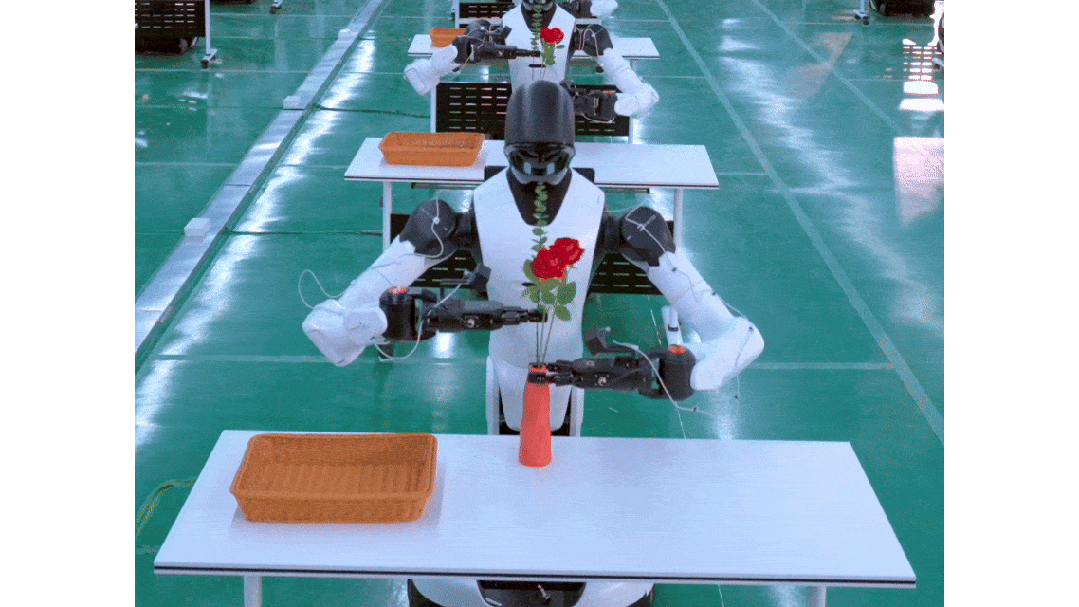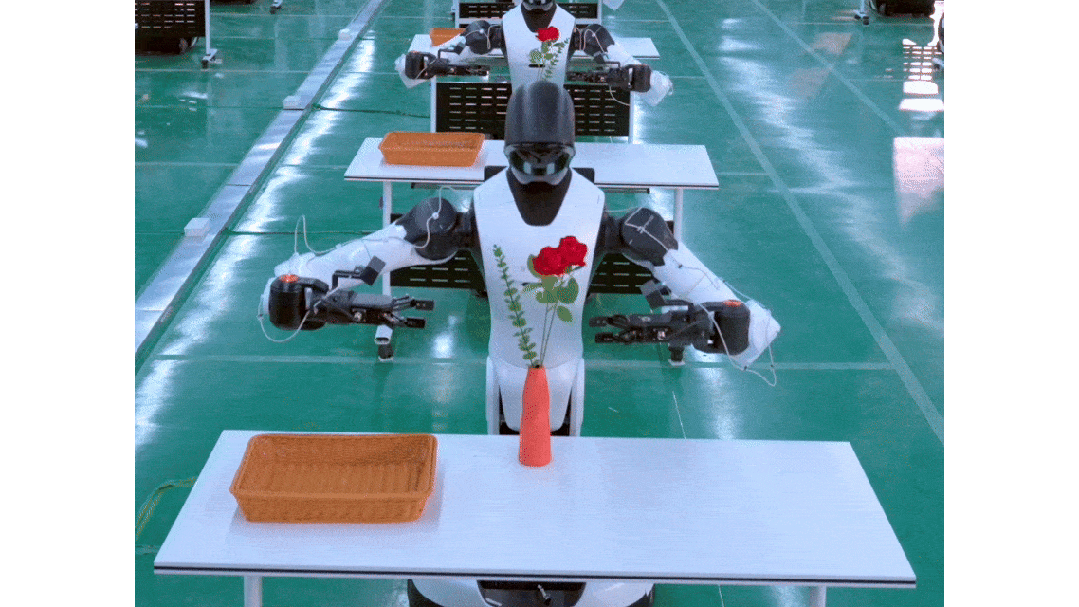
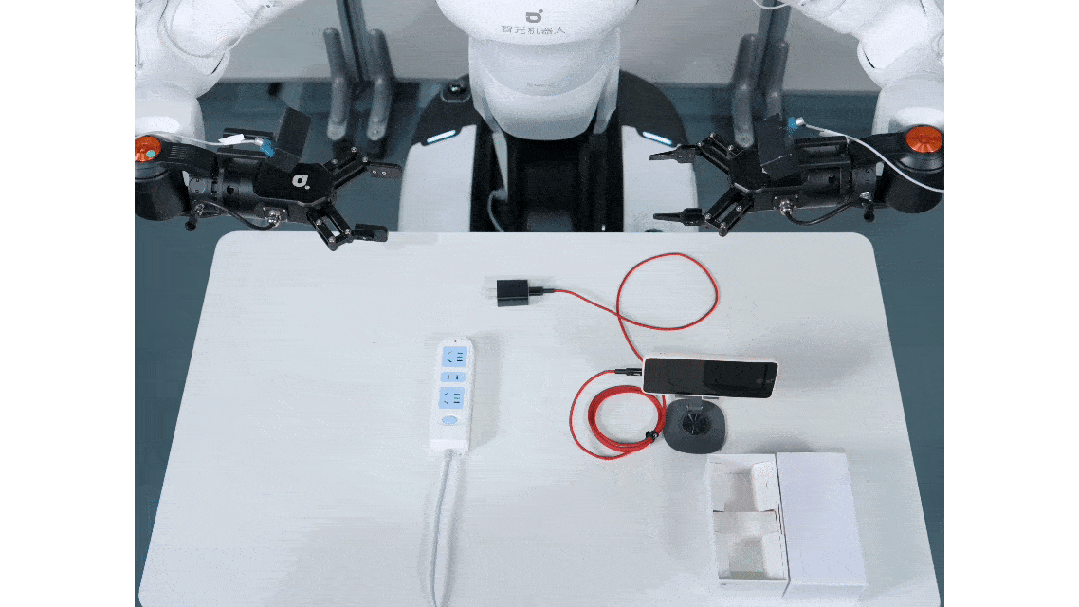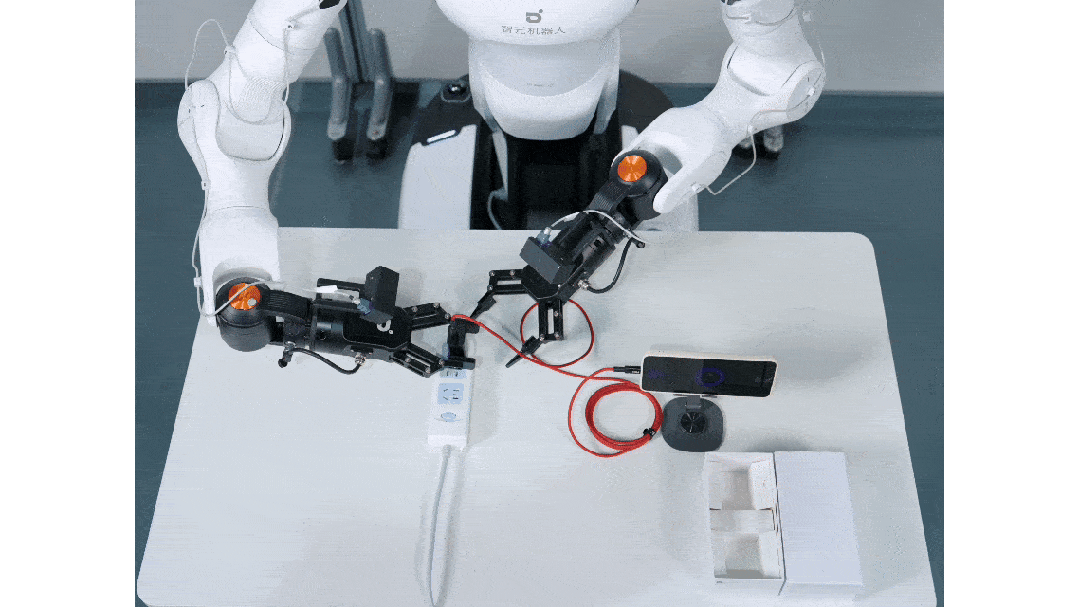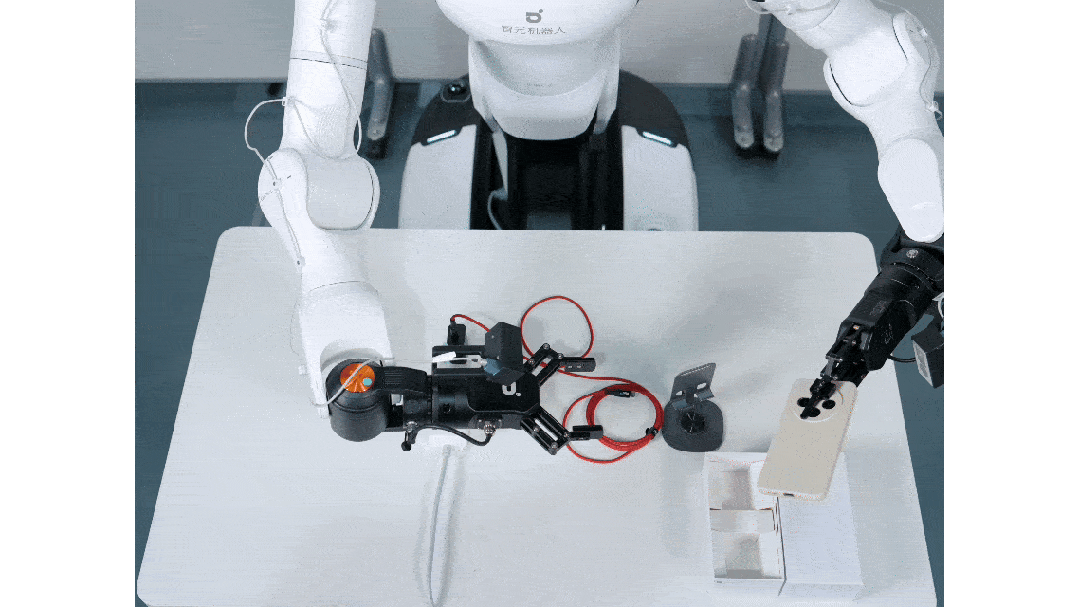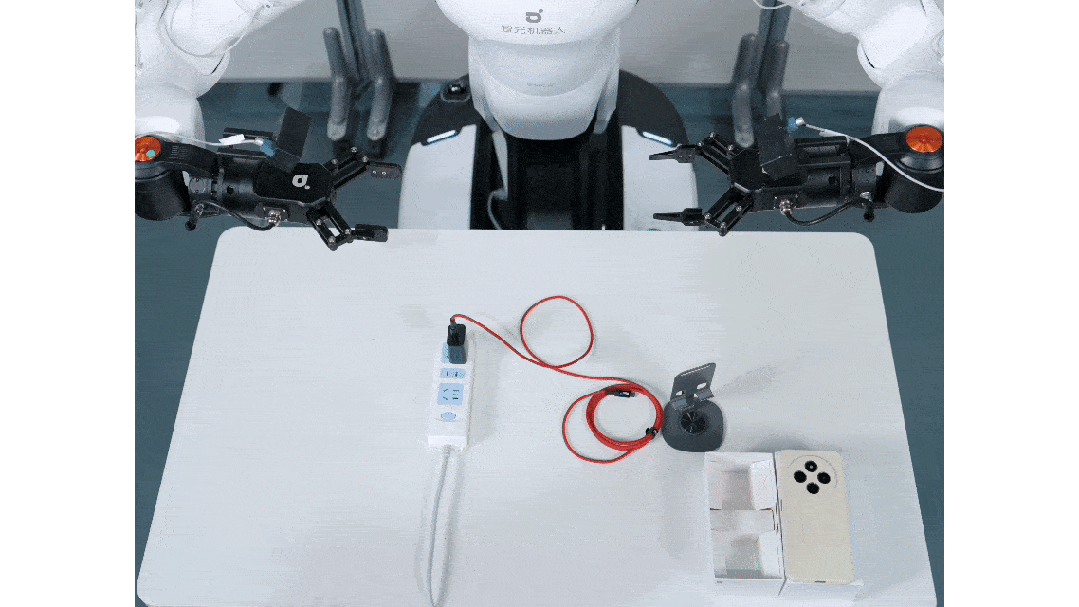
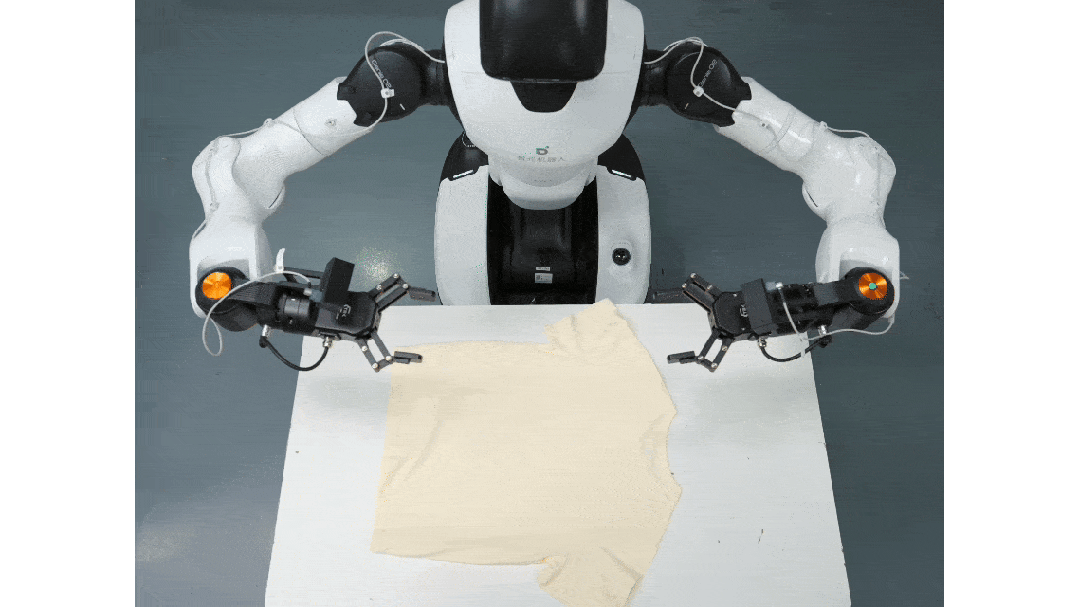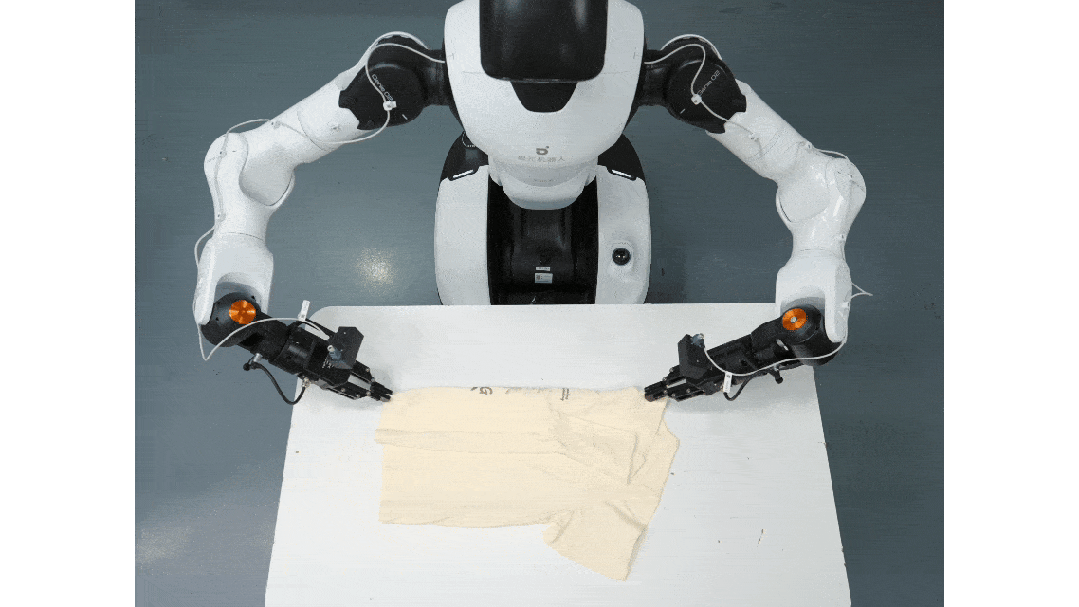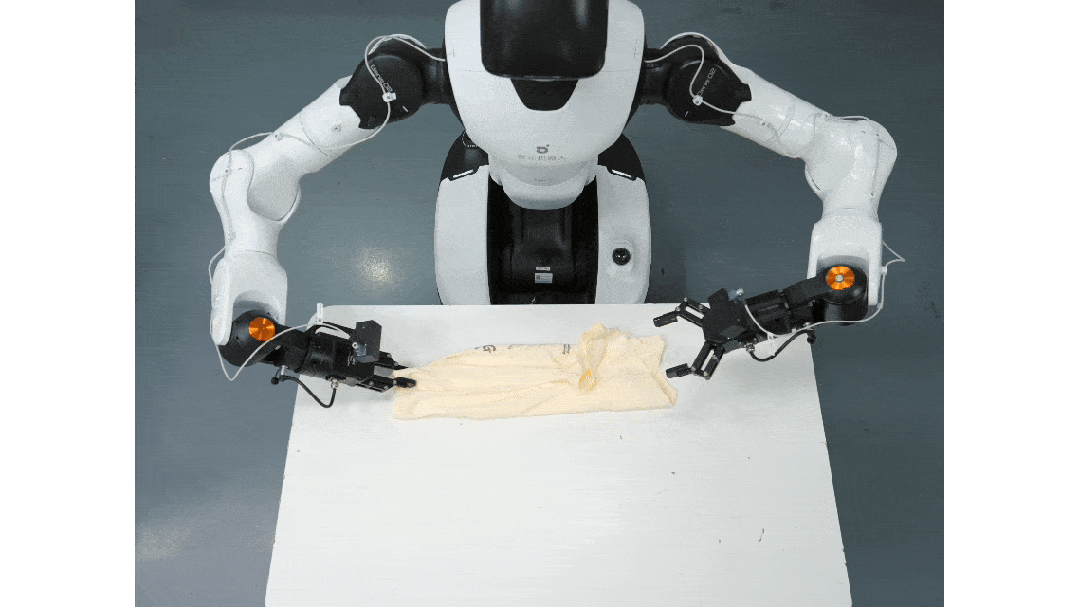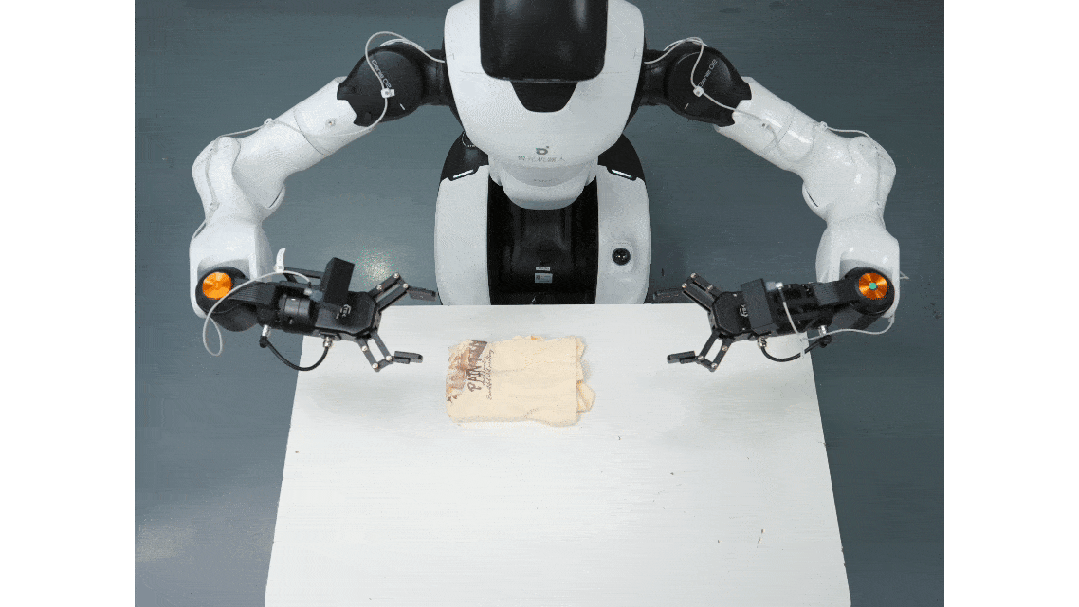
实验测试的5个任务演示,GIF经过加速处理
团队横跨家庭、工业场景,覆盖了插花、叠衣服、手机充电、凳子组装和手机包装五项任务,涉及柔性物体、精确操作、工具使用与长流程执行。
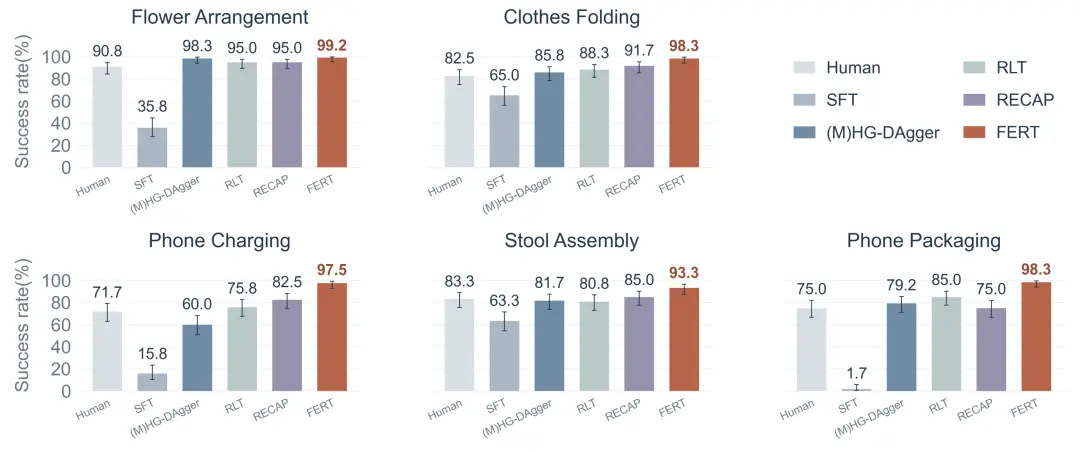
5 个测试任务成功率
在五项真实世界任务、两台未参与训练的机器人上,团队共完成 600 次测试,累计测试近 30 机器人小时,仅出现 15 次任务失败,总体成功率 97.5%,失败率仅为 2.5%。其中,单台机器人在叠衣服和手机充电任务中,分别实现连续 3 小时 34 分和 3 小时 19 分无任务失败。
传统离线微调(SFT)在上述任务中的平均成功率仅 36.3%;基于人类示范的多机 HG-DAgger 方案,成功率可提升至 81.0%;在此基础上,我们在 CEL 范式下采用的 FERT 算法进一步突破上限,最终模型在全任务上的表现均超过 6 名人类遥操员的平均水平。CEL 真正实现了摆脱人类示教,达成了更稳定、更鲁棒的任务执行效果。
机器人在线训练的 Scaling 趋势开始显现
如果群体本身能够提供学习经验,一个自然的问题是:增加机器人,能否继续改善策略?
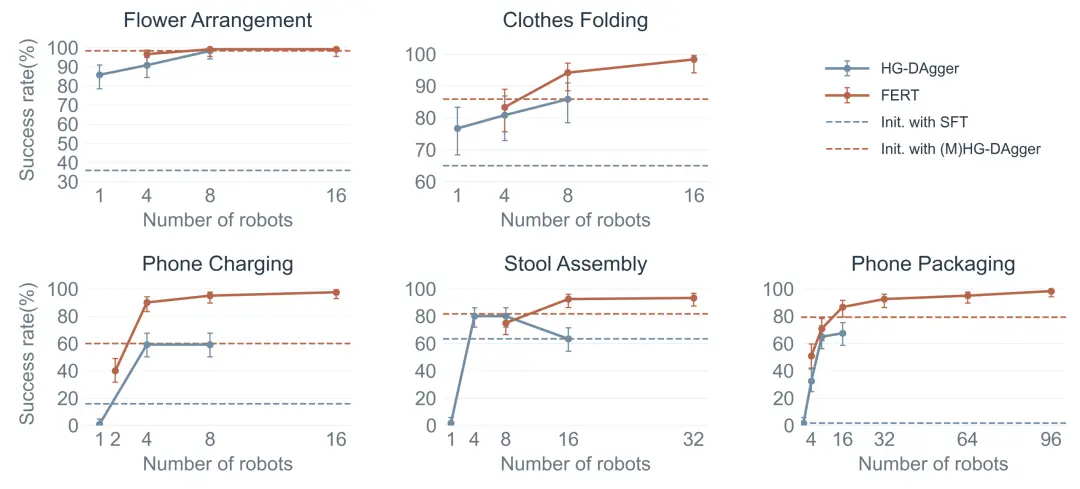
真机 scaling 曲线
团队逐步扩大参与训练的机器人集群规模。在相同的物理时间内,FERT 算法在五项任务上均呈现出显著的规模化趋势:机器人数量越多,任务成功率越高。相比之下,依赖人类示教的 HG-DAgger 方案仅表现出有限的扩展能力,人类示教的采集效率成为其进一步扩大规模、突破成功率上限的瓶颈。
在难度最高的手机包装任务中,参与 FERT 训练的机器人从 16 台扩展至 96 台,测试成功率从 86.7% 提升至 98.3%。在相同的真实世界交互时长内,更大规模的机器人群体直接转化为了更高的任务执行成功率。
这为具身智能提供了一个值得继续探索的规模化方向:除了积累人类示范数据,还可以扩大具备自主探索能力的机器人群体,让真实世界的物理交互成为持续学习的核心来源。
部署之后,机器人可以共同成长
从一次成功演示走向重复、可靠的执行,机器人需要在真实交互中不断改善能力。CEL 探索的路径,是让已经具备基础能力的机器人自主贡献经验,通过共享策略将个体实践转化为群体可复用的能力。
在这一过程中,部署现场成为新的经验来源。机器人执行任务时产生的成功与失败,可以进入后续学习循环。
96 机实验将经验获取、经验利用与持续运行连接起来,在真实机器人上展示了扩大群体带来的学习收益。当每台机器人都能贡献经验,机器人的数量就有机会成为能力增长的一个新维度。让每一台机器人的实践,成为更多机器人下一次做得更好的起点。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com