人把动作全录下来了,模型要学的还不止这些。
大家都有这样的体验:周末想照着视频学一道菜,视频里的博主动作利落,几分钟就把菜做好了,但轮到自己上手,不是油温没把握好,就是蛋下早了,葱花还没切完锅已经开始冒烟。
回头把视频再看一遍,每一步明明都看清楚了。差在哪?差在镜头没拍出来的那些东西:手什么时候该停一下,另一只手在干什么,火太大了是先关火还是先把锅端开。
机器人学做事时,也会遇到类似的问题:它看过人的操作,却未必能自己做出来。人把过程录下来,画面一帧不少,可模型真正能从里面学到多少?哪些信息它用上了,哪些细节根本没被记进去?
这也是整个机器人行业都在想办法解决的问题。研究人员想把人的经验教给机器人,就得弄清哪些细节有用、怎么教才有效,以及机器人学完后能做些什么。据了解,Ropedia在10月19日至23日举办了Ropedia Super Week,集中发布了六项研究。团队研究了如何准确记录人类经验、让模型从中学习,也探索了模型如何判断物体之间的位置关系,以及机器人如何完成抓取、搬运等操作。
Ropedia W0检验人类经验对世界预测与机器人动作学习的帮助;HoliWorld与EgoXperience关注经验如何被准确记录,分别梳理物体交互历史、还原动作与空间关系;DONIC则检验机器人能否依据人类双手演示,让物体按预期运动。S-Agent 2.0与Ropedia A0进一步关注信息的使用,前者借助工具与场景记忆判断空间关系,后者让机器人按可复用的程序完成操作并检查结果。
1.模型从人类经验中学习,
预测不同机器人的后续画面

一个人拿起饮料,走到冰箱前,再把饮料放进去。人做这件事时,视线、身体和手始终一起运动。世界模型Ropedia W0要学习的,是这些动作发生后,眼前的世界会怎样变化。研究团队给模型提供起始画面、文字,以及相机和骨架的运动条件,让它生成接下来的第一视角视频。
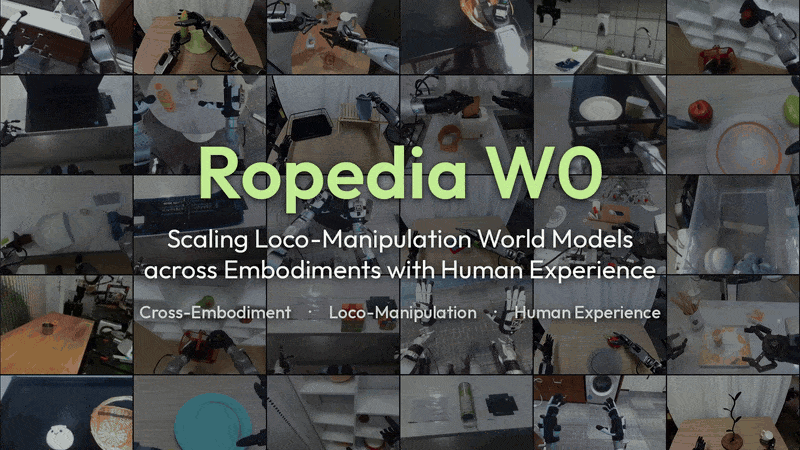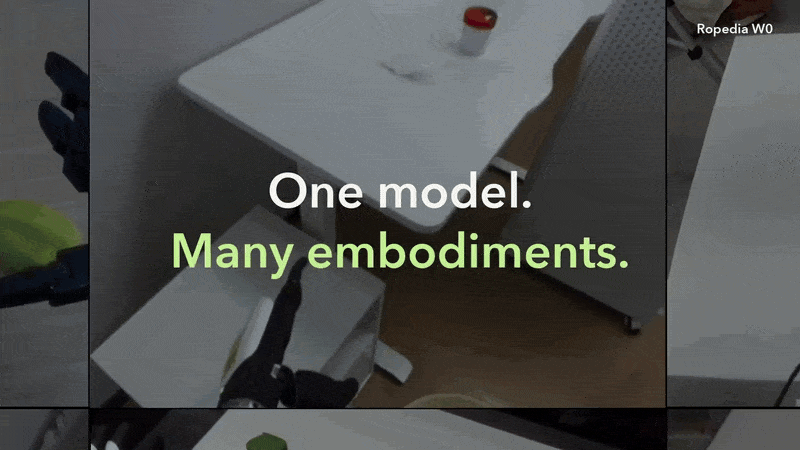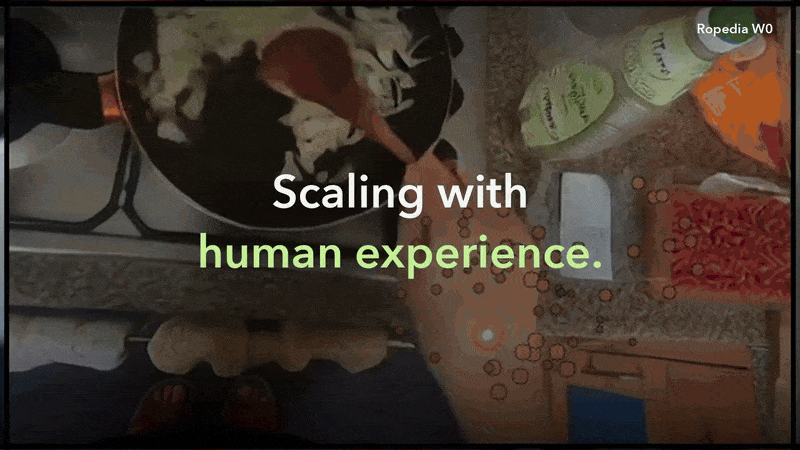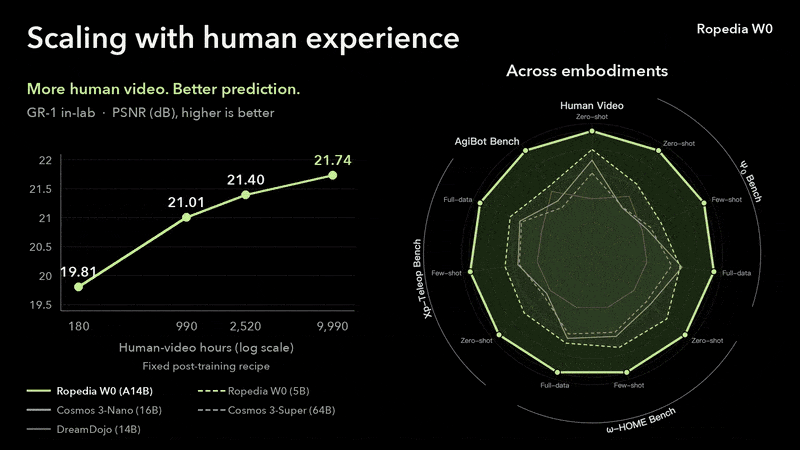
Ropedia W0根据相机轨迹与骨架等运动条件,预测不同本体的第一视角画面。人类视频越多,预测越准
人手、机械臂的夹爪和人形机器人的灵巧手各有不同,研究人员很难用同一套关节指令描述它们的运动。Ropedia W0把这些差异转成模型能共同使用的视觉信息:相机位姿描述视角怎样变化,投影在画面上的骨架描述手或机械臂怎样运动。模型由此可以把身体移动和手部操作放在一起学习,各种身体仍然保留自己的形态。
团队先用约一万小时人类第一视角数据预训练,再加入约三千小时机器人数据混合训练。同一个模型可以支持多个机器人本体的建模和预测,性能优于其他的具身世界模型比如Cosmos 3和DreamDojo。
预训练究竟能帮上多大的忙?团队随后比较了两种学习起点。
两套5B模型采用相同架构。一套从Ropedia W0预训练权重出发,只用1%的GR-1后训练数据;另一套从公开的Wan2.2权重出发,使用全部GR-1后训练数据。在In-lab测试集上,前者的画面预测指标PSNR达到20.85dB,超过后者的19.41 dB。这个指标衡量预测画面与真实画面的像素接近程度,数值越高越好。
研究人员还检验了预训练对机器人策略学习的帮助。他们用Ropedia W0 5B初始化FastWAM的视频骨干,保留动作预测头和训练方案,再用LIBERO仿真任务的全量示范训练机器人策略。在未参与训练的LIBERO-Plus测试中,成功率从50.06%提高到56.82%,相机、光照、背景等七类扰动下的表现都有改善。在真实的Unitree G1上,用Ropedia W0初始化的策略任务进度达到56.7%,与之,对比FastWAM为33.3%。
Ropedia W0还能实时运行。蒸馏为4步的自回归模型后,它在单张GPU上以每秒21.3帧生成640×480的画面,并能连续数分钟稳定运行。操作员戴上VR头显移动身体和双手,模型就实时生成人类或机器人此刻应看到的第一视角画面。
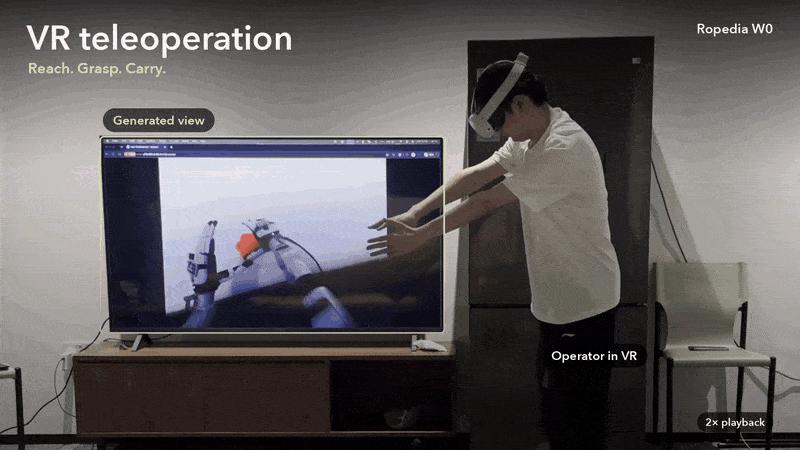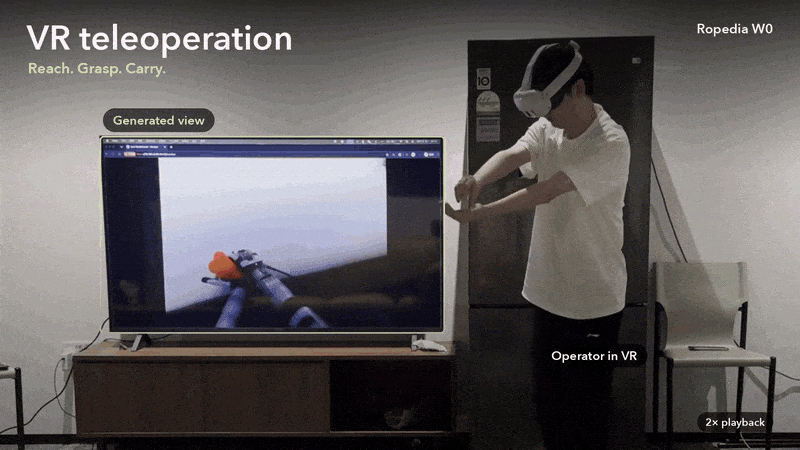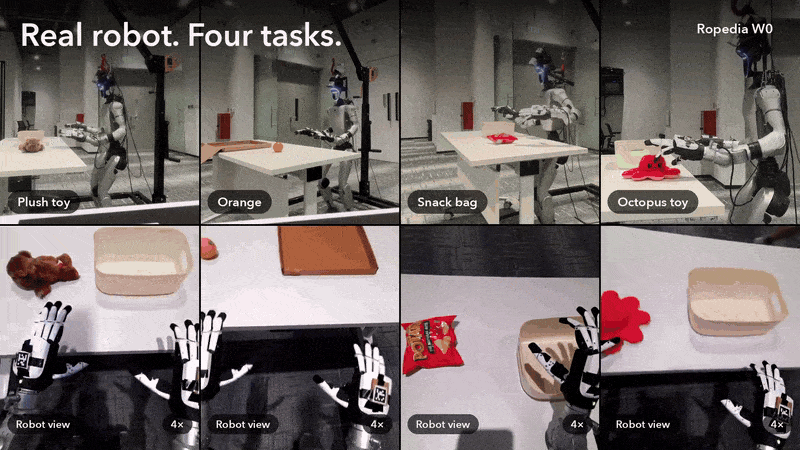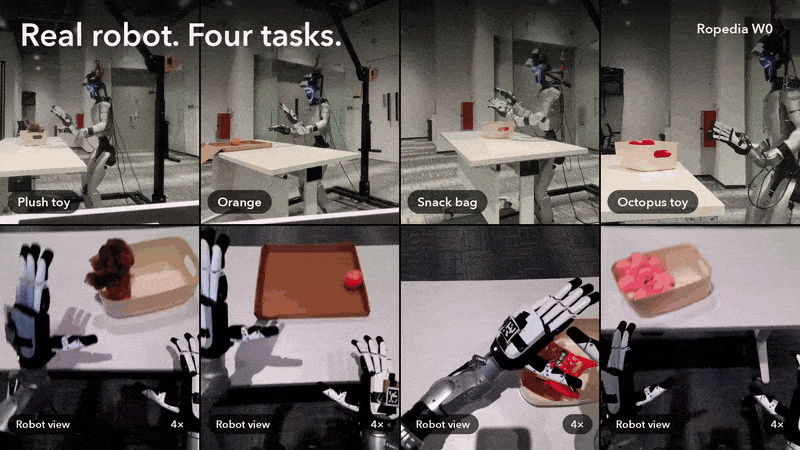
RopediaW0的两种应用。前段为VR遥操作:操作员戴着头显做动作,模型实时生成对应的第一视角画面(2倍速)。后段为真机策略:在真实Unitree G1上完成毛绒玩具、橙子、零食袋和章鱼玩具四项抓取放置任务(4倍速)
这些能力也对数据提出了更细的要求。相机轨迹、骨架和画面需要在时间与空间上对齐,文字描述也要对应当时发生的动作。团队为此修正了部分机器人关键点标注,将录像中的动作整理成 Ropedia W0 能够使用的运动条件,让人类与机器人的记录可以按同一套格式参与训练。
2.录像里的动作和空间关系,
都要还原清楚

HoliWorld把物体的交互记录整理成可核对的训练问答
假设一个人把杯子从桌上拿走,过了一会儿,杯子又出现在房间另一处。模型要回答杯子去了哪里,就得确认前后出现的是同一只杯子,还要分清它移动的时间和位置。镜头本身在动,杯子也可能暂时离开视野;一串画面中的识别结果,尚不足以交代整个过程。
HoliWorld为物体保留了一份能够前后核对的记录。系统通过两条分支分别恢复场景和交互:一条整理房间中的物体与几何结构,另一条关联交互片段中的物体身份、重建三维运动。相机路径、物体轨迹和时间随后汇入同一份世界记录,并保留对应的原始观测。研究人员因此能够回查,一条标注究竟来自哪段画面。有了这样的记录,团队就可以生成空间、时间和交互问答。例如,模型需要判断杯子移动前后的位置,或两个动作发生的先后顺序。训练材料既有问题和答案,也有可供核对的观测依据。据团队介绍,HoliWorld-Data已整理约100个真实场景、444段第一视角视频,生成约7.8万组问答;团队另外对留出录像进行独立人工标注,构建评测基准。
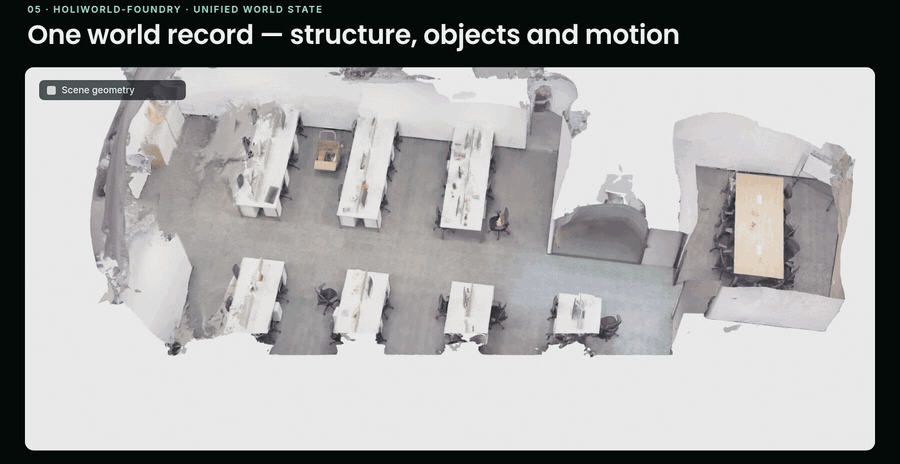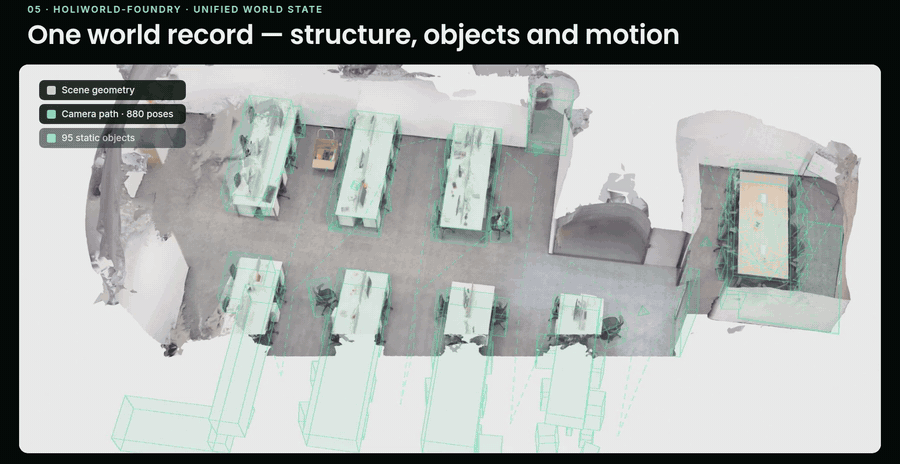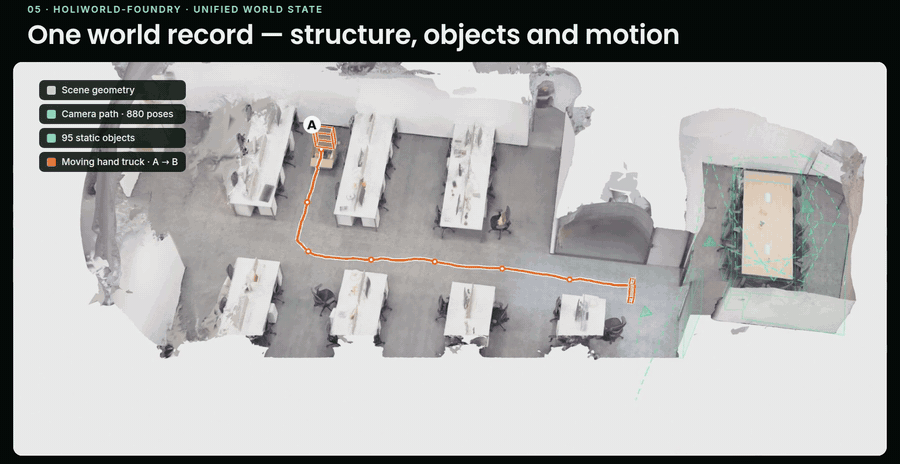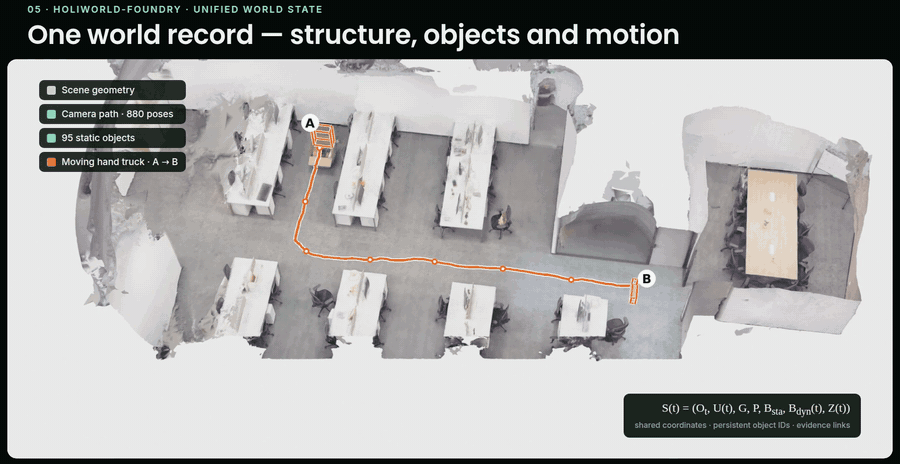
HoliWorld将场景结构、相机路径和物体运动保存在同一坐标系中。图中手推车从A移动到B,橙色轨迹记录其运动
这些问题能不能把模型教好,研究人员做了直接对照。他们使用上述数据微调Qwen3.5-4B,在外部基准EgoDynamic4D上,模型的答案匹配指标Token F1从18.29%提高到66.39%。基础模型没有更换,专项训练带来了明显改善。
HoliWorld当前的动态流程面向同一时刻至多一个物体运动的场景。研究人员可以逐步核对每条问答:系统有没有把同一物体认成两个,移动时间是否对得上,答案能否在原始录像里找到依据。HoliWorld将这些检查与后续训练放在同一项研究里,数据处理的效果因此可以通过模型表现验证。
EgoXperience同时还原相机、双手与物体的运动
物体始终停留在画面中央,也可能已经在房间里移动了很远。一个人端着碗穿过房间时,就可能出现这样的情况。人看得懂他在端碗走路,模型却需要同时还原相机、双手和碗的运动,才能分清哪些变化来自身体移动,哪些来自手部操作。EgoXperience处理的就是这种观察者与交互对象一起运动的情况。
研究团队把相机、场景、双手和物体放进同一个重建任务,希望各部分的位置能够相互对应。为此,团队围绕采集、标注、训练和评测搭建了整套流程,并整理出包含约50小时第一视角视频的EgoX-Data-6M数据集。标注系统提供几何监督,重建模型再学习如何从视频中预测这些关系。
采集时获得的精细信息,最终要帮助模型处理更简单的输入。EgoXperience的重建模型在推理时接收单目第一视角视频;需要重建指定物体时,研究人员再提供首帧中的物体区域掩码。模型在每个输入窗口内联合估计相机位姿、场景深度、双手姿态和刚体物体位姿,并以首帧相机为参考组织结果。采集标注阶段使用的额外设备,以及预先制作的物体三维模型,都不是这一推理过程的必需输入。
论文结果显示,在团队自建的EgoX-Bench上,这套模型的世界空间手部位置误差为113.24毫米,相比WiLoR与SLAM组合的328.81毫米,降低约65.6%。这里考察的是手在空间中的位置,模型需要同时处理手部姿态和观察者运动。
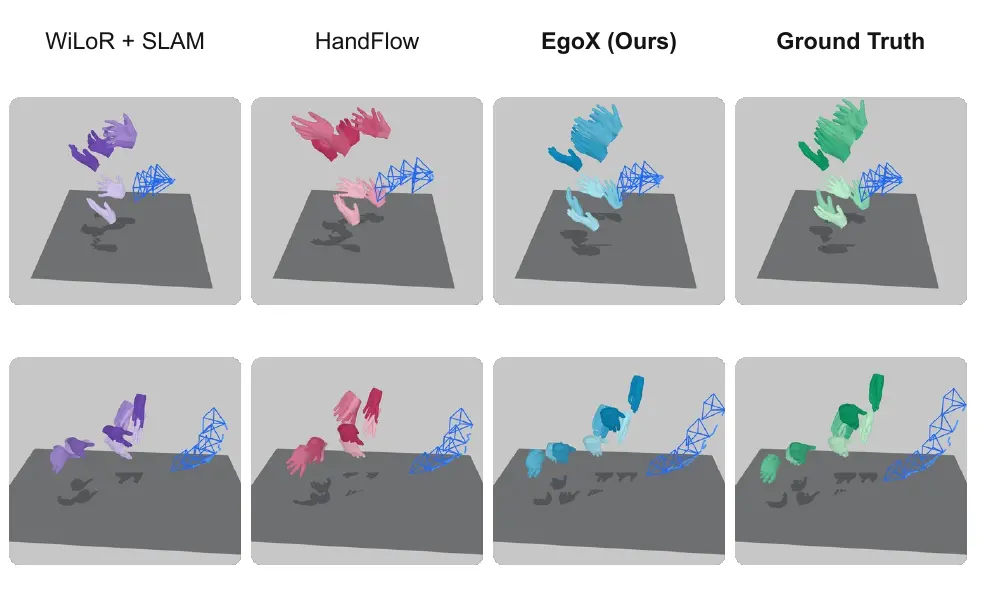
不同方法在世界坐标系中重建双手与相机。上排为HOT3D,下排为EgoX-Bench;第三列为EgoXperience的重建模型结果,最右列为真值
手的位置能否重建准确,还与周围的空间有关。
研究团队在HOT3D上去掉了深度预测头,世界空间手部位置误差随之从38.89毫米升至67.53毫米。这个实验把多种信息之间的关系写得很具体:场景深度能够帮助模型约束手部重建。研究人员在准备训练数据时,也就有理由关注深度与手部标注能否相互对齐,而不仅是分别把每一种标注做出来。
3.机器人学习双手操作,
不能只是动作相似

机器人拿到一段动作记录,仍然可能做不出来。
在双灵巧手控制策略DONIC的对比演示里,有的策略让手指跟着参考动了,物体却没有随之移动;有的策略则逐渐失去手与物体的对齐。对两只灵巧手来说,姿势相似只是其中一项要求,机器人还得在正确的时刻接触物体,让两只手承担各自的作用,并共同带动物体。
研究团队因此把双手和物体放进同一个跟踪任务。DONIC使用一个共享策略学习不同的人类演示,持续检查物体有没有按参考运动,并依据参考中每只手的接触角色提供反馈。团队还校准不同片段的学习信号,让难易差异较大的演示能够共同用于训练。
这项工作也提供了一个补充数据前后的对照。团队先从五个公开数据源中筛选出1,845段训练参考,随后通过自建的BiHOI数据集补充1,575段人类双手交互序列。团队将重建或已有三维标注中的手物运动适配到机器人手部结构,再用于仿真训练。成功执行且通过回放验证的轨迹会被收入示范库,继续支持策略更新。
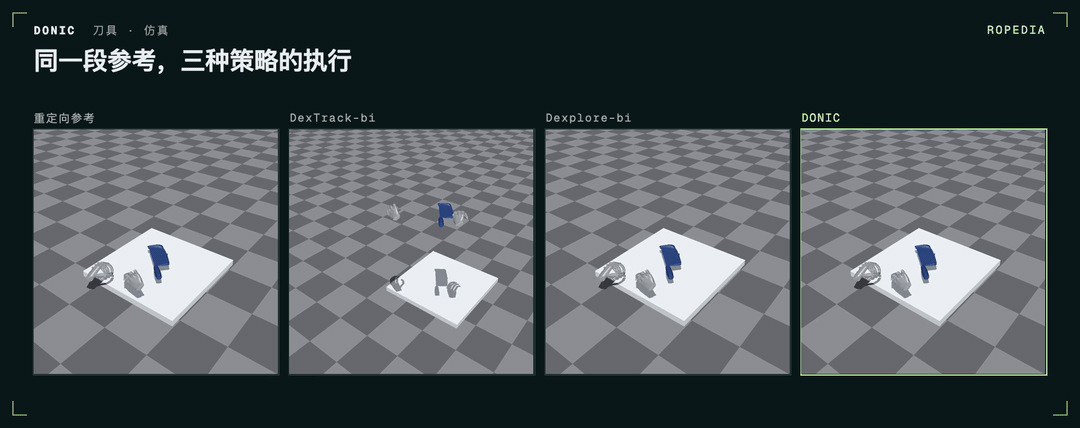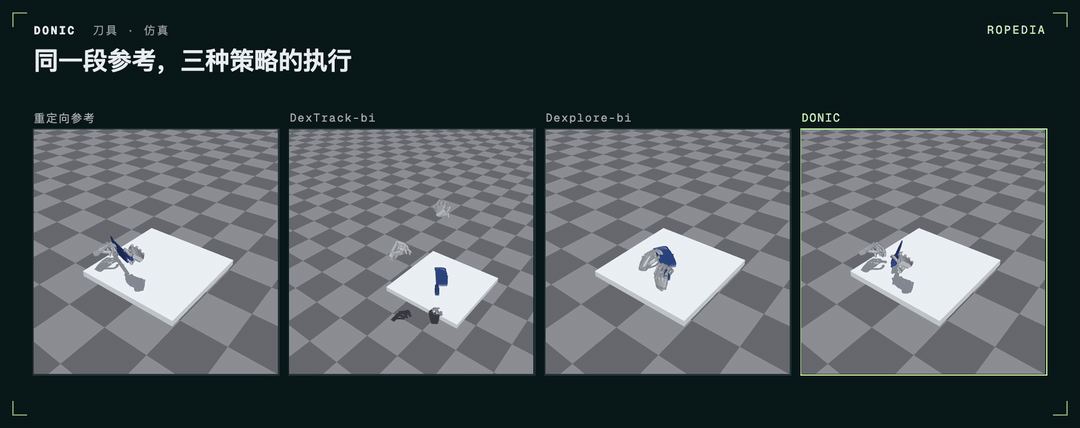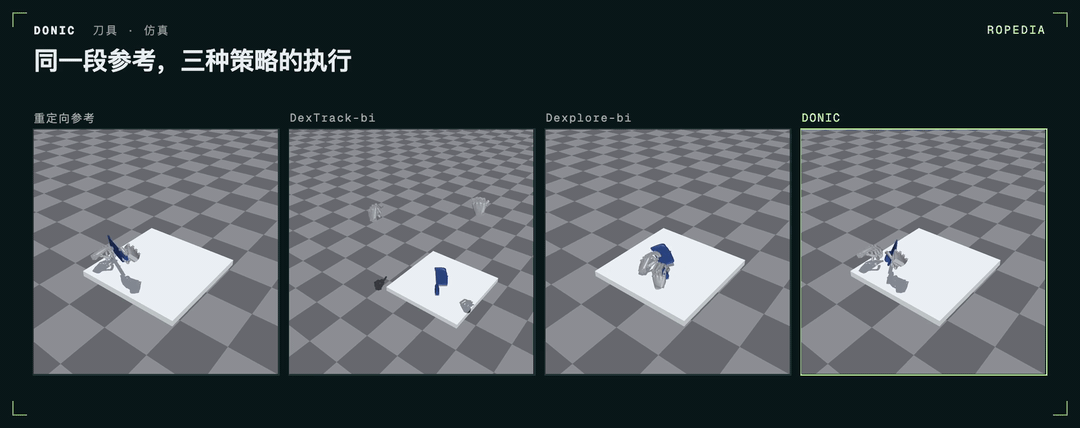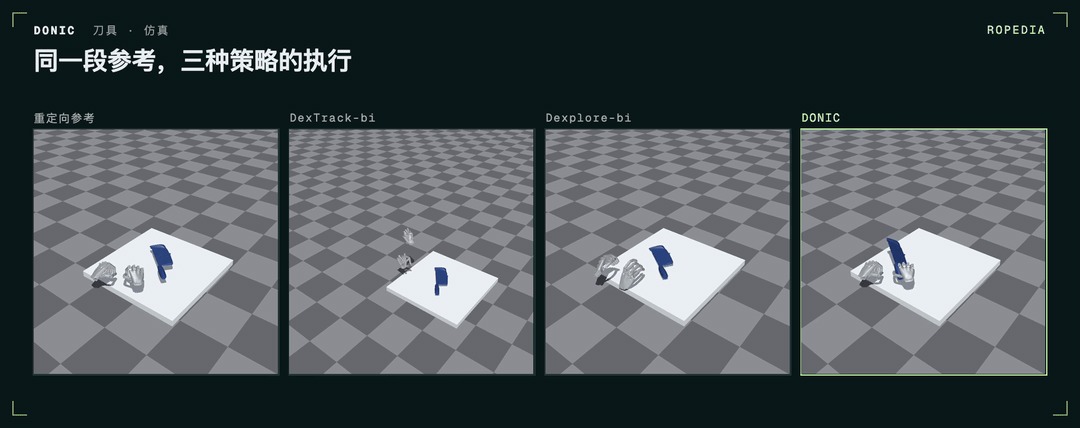
不同策略在仿真中执行同一段双手运动参考。画面从左至右依次为重定向参考、DexTrack-bi、Dexplore-bi与DONIC
仅使用公开训练数据时,DONIC在训练物体的53段未见轨迹上取得86.79%的跟踪成功率,在涉及未见物体的164段参考上取得57.32%。加入BiHOI后,两项结果分别升至88.68%和59.76%。每种训练设置下,团队都用同一组策略权重完成这两组测试,没有针对测试参考再微调。这些测试发生在仿真中,考察的是单个刚体物体的参考跟踪,两只手都要达到要求。在这一范围内,控制方法保持不变,补充的人类双手经验改善了未见轨迹和物体上的表现。团队由此可以沿着接触关系、物体运动与参考质量,继续检查不同演示对控制策略学习的帮助。
4.工具帮模型判断,
代码指挥机器人做事

S-Agent 2.0用工具和场景记忆帮助模型判断空间关系
在S-Agent 2.0论文讨论的一次基线测试中,系统已经取得正确的三维位置,却仍把“西侧”答成了“东侧”。这个例子提醒研究人员,模型即使得到了正确观测,也可能在后续推理中把信息用错。
研究团队没有为这项工作额外训练模型,而是给现成的通用编程智能体加入命令行感知工具包。智能体决定要测什么,工具返回测量结果,双方使用同一份三维场景记录。工具读数还要交代对象、参考系和方向,减少模型在解释结果时自行猜测的空间。比如,题目问“我躺在床上时,窗外停车场在我的哪一侧”,模型就必须先确定“我”的位置与朝向。S-Agent 2.0可以把这个观察者写入场景,再按他的视角查询停车场。图中的工具返回“右侧2.78 米”,其中2.78米表示右侧方向的距离分量,而不是两者之间的直线距离。
模型还需要记住自己刚刚确认过什么。
场景记忆保存当前问题中已经取得的空间信息,供后续推理继续使用。模型观察到的新内容也可以写入场景,补充目标或修正工具结果。多个测量步骤因此能够沿用一致的对象和坐标,研究人员也更容易追查答案在哪一步偏离了证据。
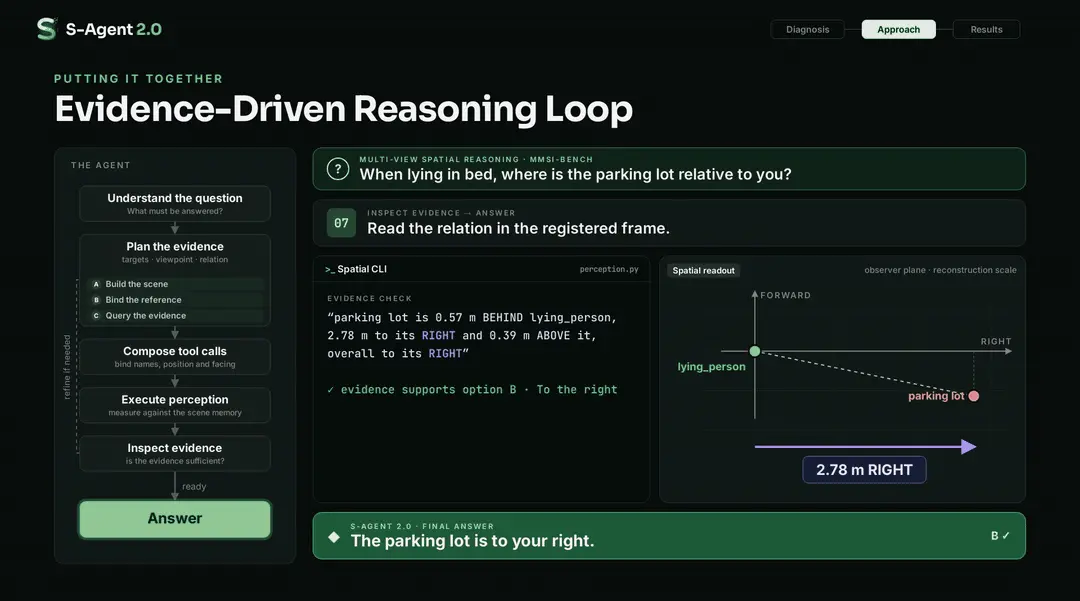
S-Agent 2.0按指定观察者的视角查询空间关系。工具返回停车场在观察者右侧2.78米,其中2.78米是右侧方向的分量
同一编程智能体接入这套工具后,以Qwen3.8-27B为骨干的ReVSI得分从61.8提高到82.3;换成Gemini-3.8-Flash后,得分从80.9提高到90.5。论文中的消融实验还显示,去掉模型感知接口或场景记忆,成绩都会下降。
Ropedia A0用软件工程的思路解具身任务
主流的机器人策略是模型在环(model in the loop):执行时由模型做决策,代码只是工具。Ropedia A0 提出一种新思路,采用纯代码闭环策略。在一次仿真中,灵巧手抓起番茄酱瓶,头部相机却看不出瓶子被提了起来。代码没有急着往下走,先让手再抬高一些,重新看一眼,确认瓶子确实在手里,才把它放进篮子。看、判断、重试,构成一个完整的闭环,全程没有调用大模型,执行高效快捷。
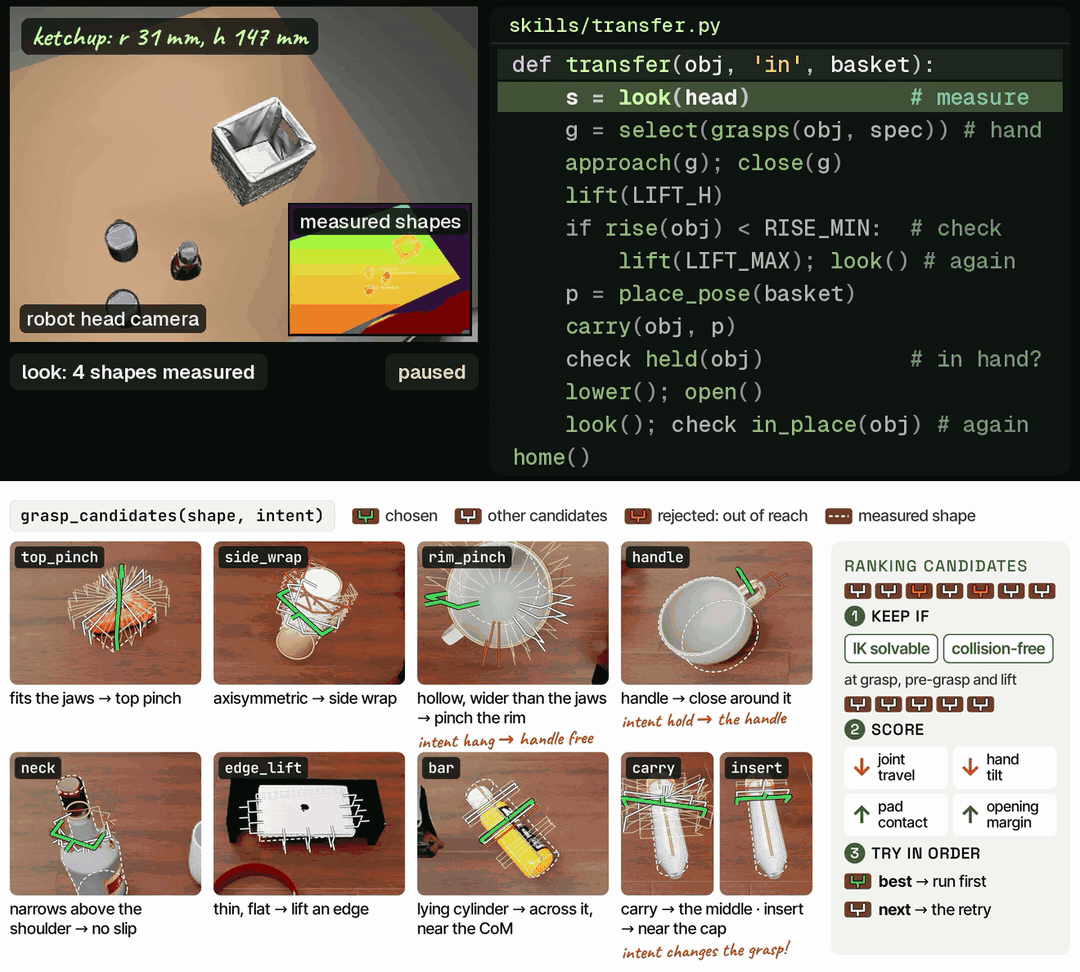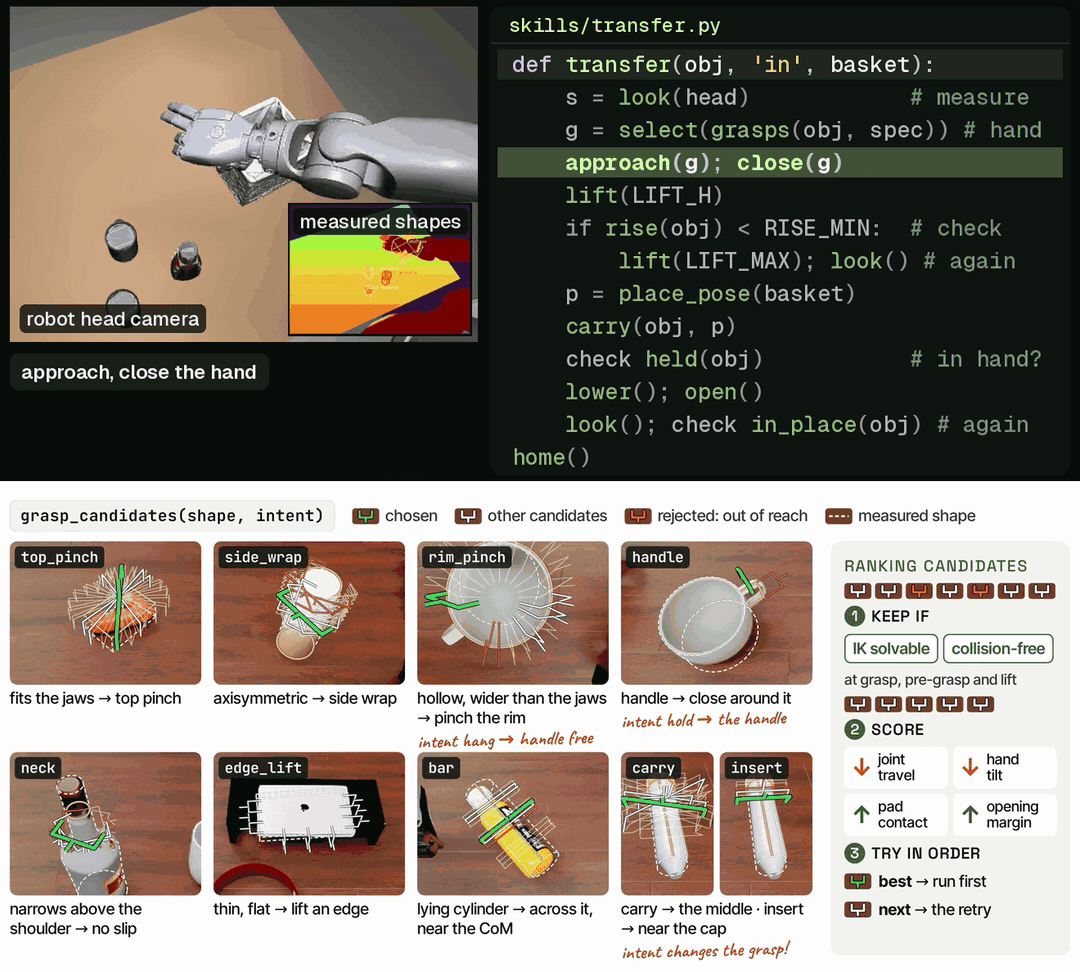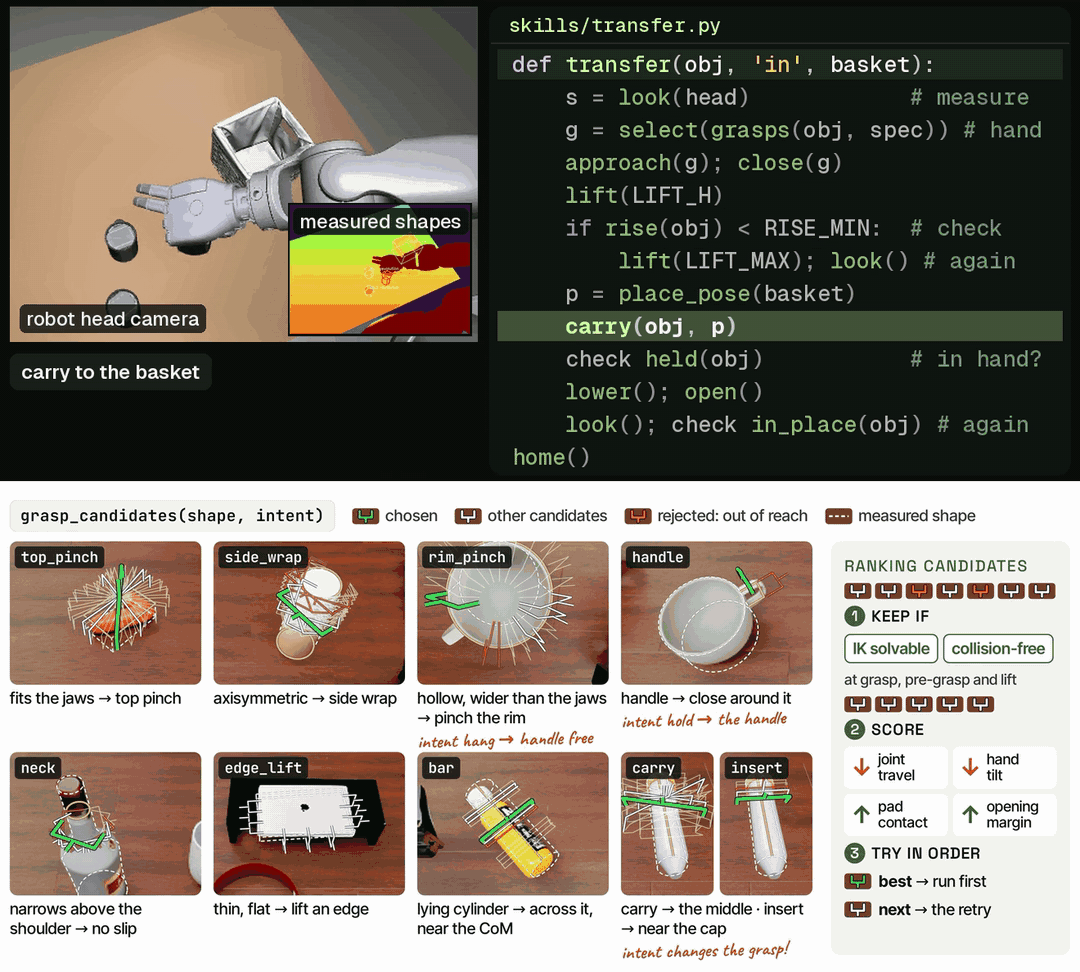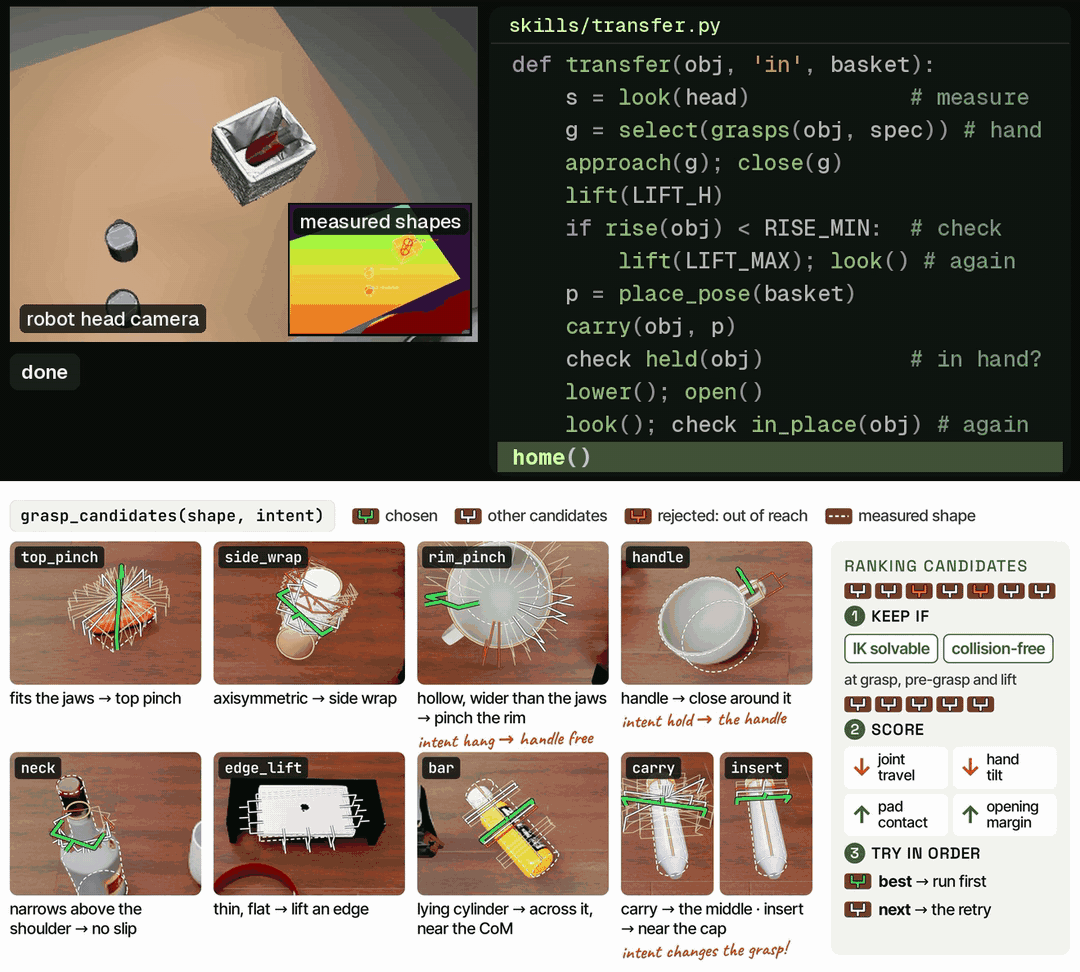
相机看不出瓶子被提起,代码便让手抬高重看,确认抓住再继续
这种范式名为Code-Only-as-Policy(COAP),即用纯代码作为机器人策略,出自Embodied Turing Machines论文。它借用软件工程(SWE)的方法:编程智能体在开发阶段像软件工程师一样,把感知、决策和检查写成代码;到了执行阶段,机器人只跑这些代码。在同一组任务上,纯代码执行很快,平均每局约17秒,模型在环平均每局约1.8分钟。
在团队看来,代码本身就能做闭环决策、处理错误。机器人策略由此变成解一个物理问题,不需要“背”轨迹:先看清物体和自身的状态,再按形状、尺寸等物理属性算出动作。Ropedia A0把这些决策连同检查和失败重试写进技能,原本要交给大模型的在线决策,改由代码自动完成。
这样写成的技能有三个特点:
-
运行快:执行时不用等模型推理,策略代码在CPU上就能跑,可以高效产出大量轨迹,作为数据引擎。
-
白盒,安全可控:每个决策都是一行可读的代码,机器人为什么这样动都能查到,出了问题能定位到具体一行,需要停止也可以立即停下。
-
复用泛化:技能按物理属性编写,换摆放、物体、换任务都能用;代码沉淀在共享库里,新任务开发越来越快。
研究团队按照RoboDojo榜单协议,对42个双臂仿真任务进行自测,取得70.24%的成功率。
换一台机器人,Ropedia A0的共享代码库也能继续复用。团队只需编写一个新本体的适配层,其他代码保持不变。团队在LIBERO中的Franka Panda和配备22自由度灵巧手的MARVIN上做了仿真验证,灵巧手pick-and-place的首次抓取准确率为94%。在sim-to-real上,AgileX PiPER先在仿真孪生中零样本测试,首次成功率为95%;上真机后,pick-and-place也能成功。
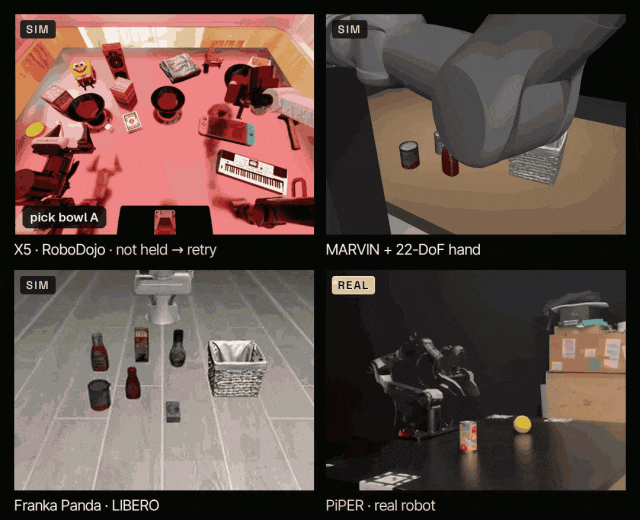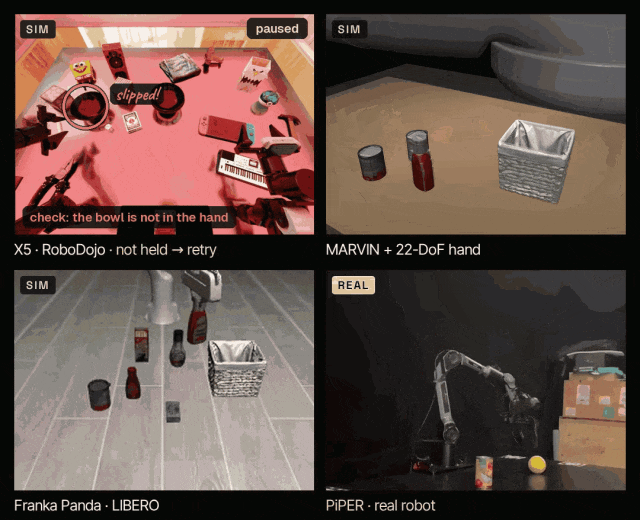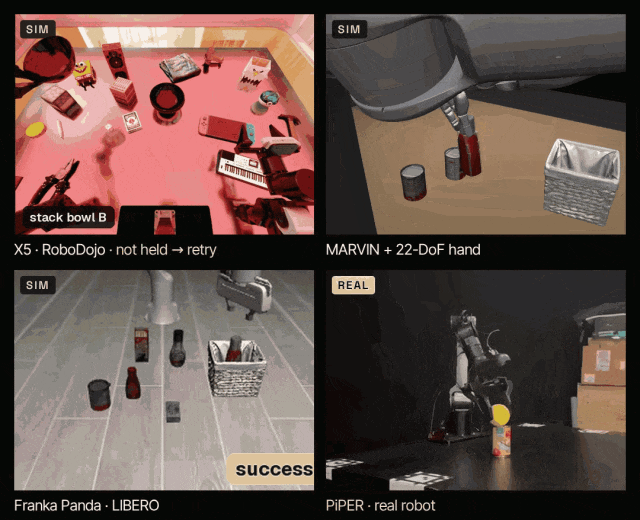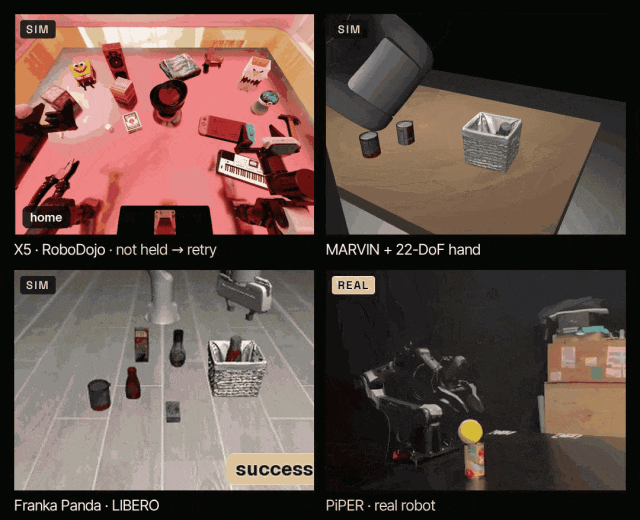
同一套技能跨本体复用
Ropedia A0想探索纯代码作为机器人策略的可能。在这一范式下,代码从供模型调用的工具,变成了自带感知、决策、能自我检查和纠错的闭环技能。这项工作也验证了代码的泛化性:一个共享库就能跨任务、跨本体复用,并实现sim-to-real transfer。
5.Ropedia用研究检验人类经验的价值

Ropedia此次发布的研究,展示了人类经验能给行业带来的几种具体改变。Ropedia W0的实验表明,人类视频能够帮助模型更准确地预测机器人的后续画面,相关预训练还能改善动作学习的效果。HoliWorld将物体的交互记录整理成训练问答,提升了模型的时空推理表现;DONIC加入更多人类双手演示后,机器人在仿真中的双手跟踪也更加准确。
这些研究也让“高质量的人类经验”有了更具体的含义。一次操作中,手在什么时候接触物体、物体的位置怎样变化、前后动作如何衔接,都可能是模型学习所需的线索。研究人员把这些细节记录清楚,让动作、位置与画面准确对应,就能为不同的学习任务准备更有用的材料。
(封面图:Ropedia)
END.