新智元报道
新智元报道

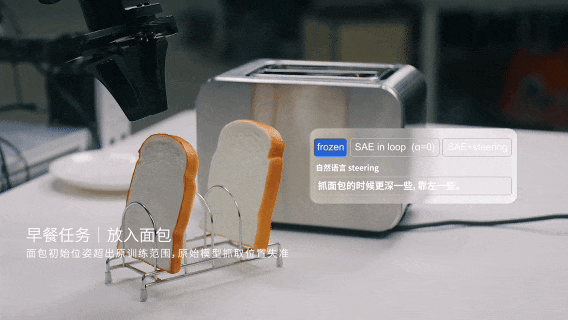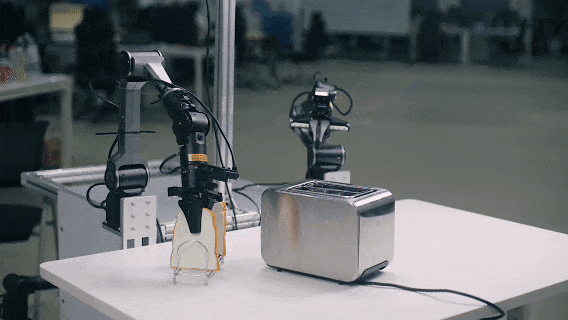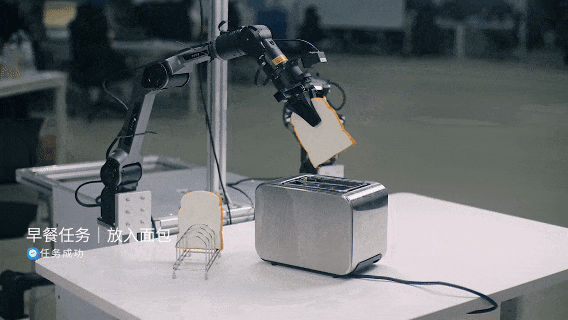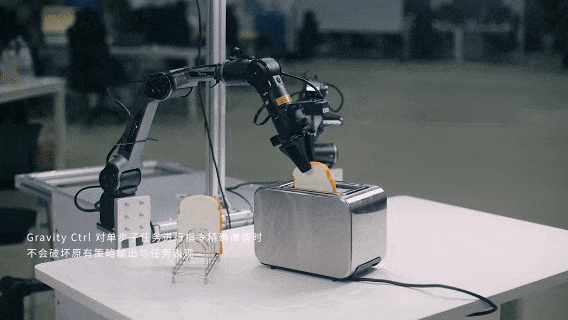
一块普普通通的面包,变换了摆放姿态,常常就能难倒「已经学会了」的机器人!
训练时,面包通常是竖放的;
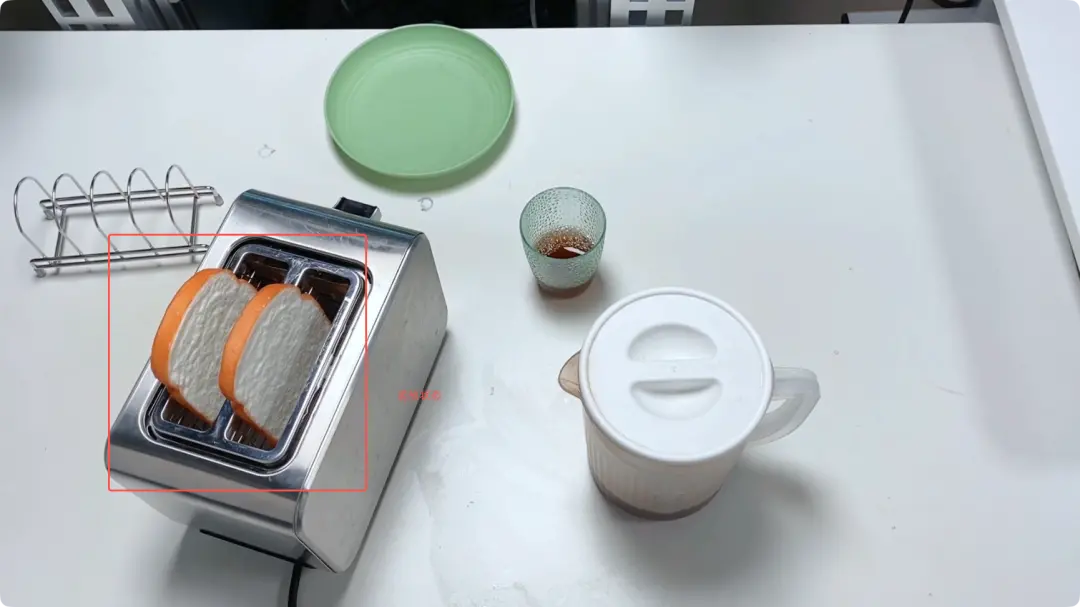
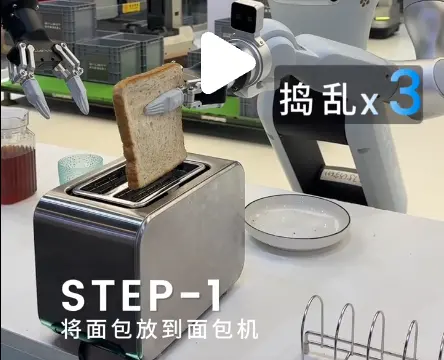
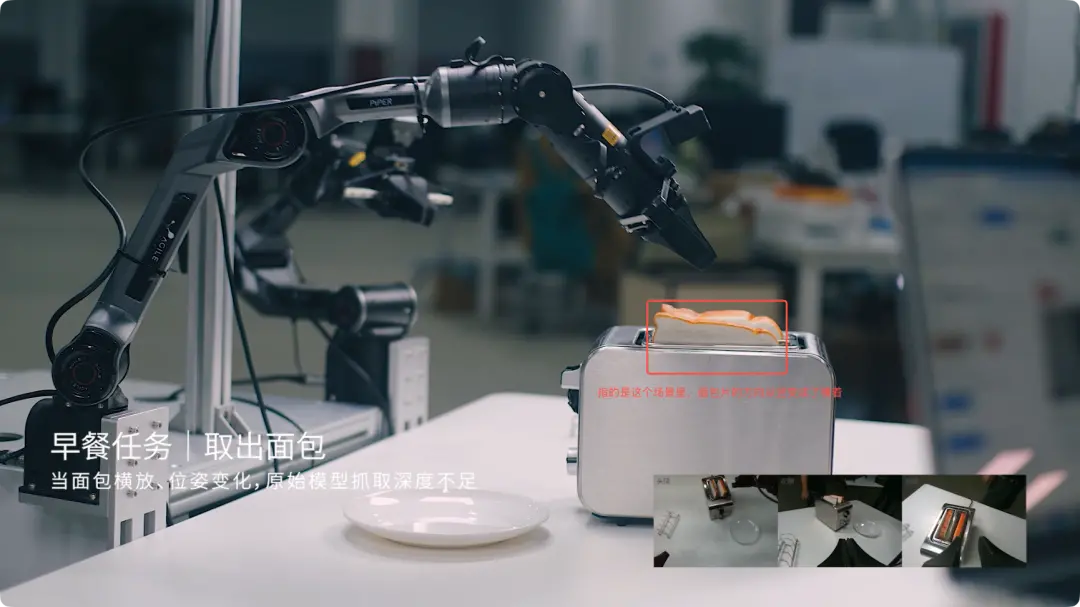
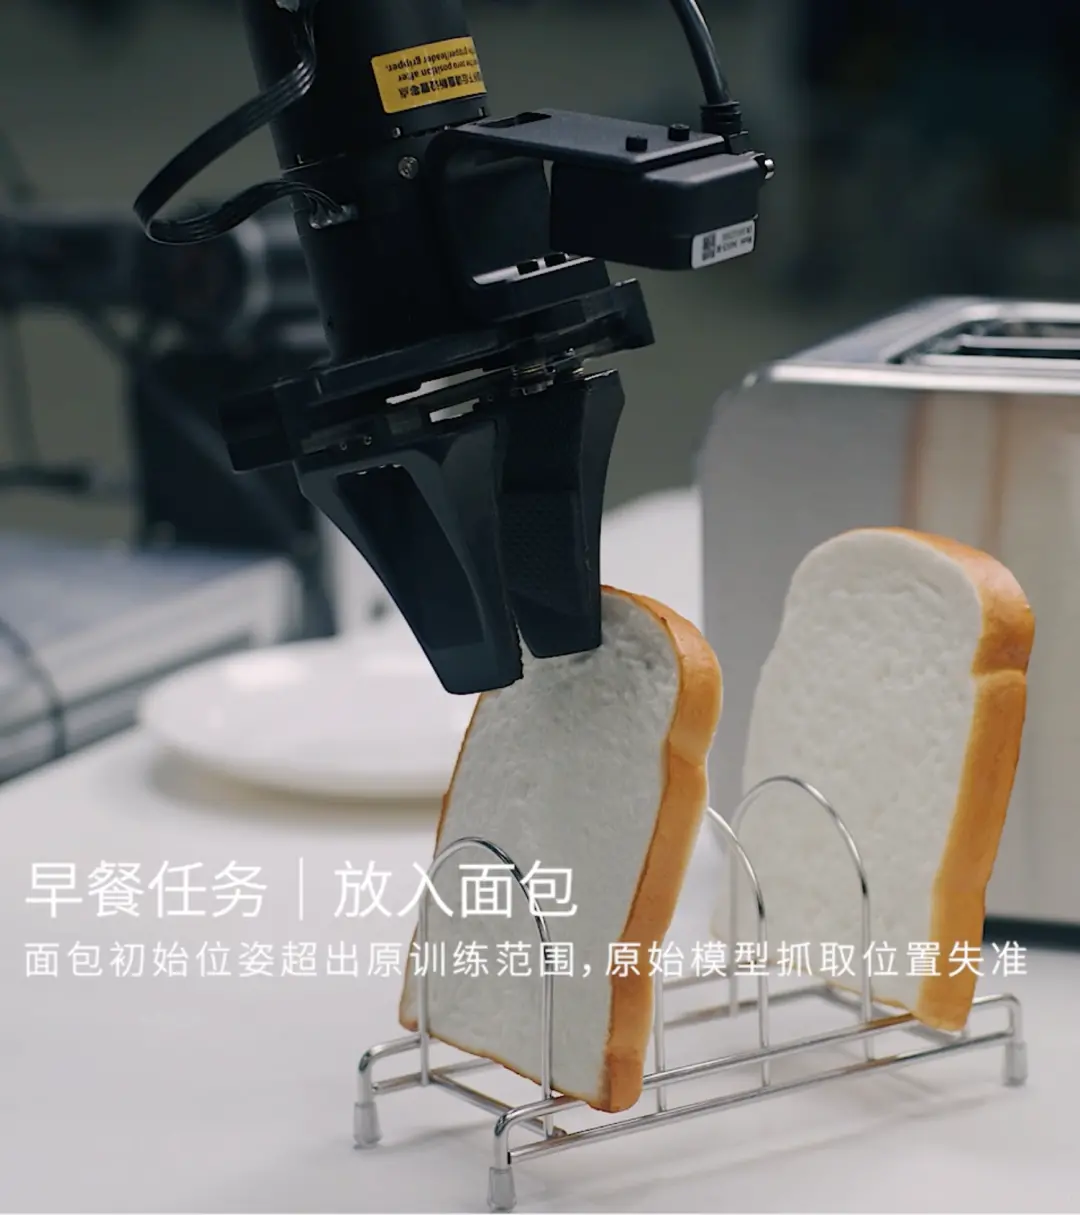
如果把面包横过来,机械臂明明还能识别、也会抓取,却总是偏了那么一点距离,被难倒在了这个幼儿园小孩都能轻松解决的问题上。。。
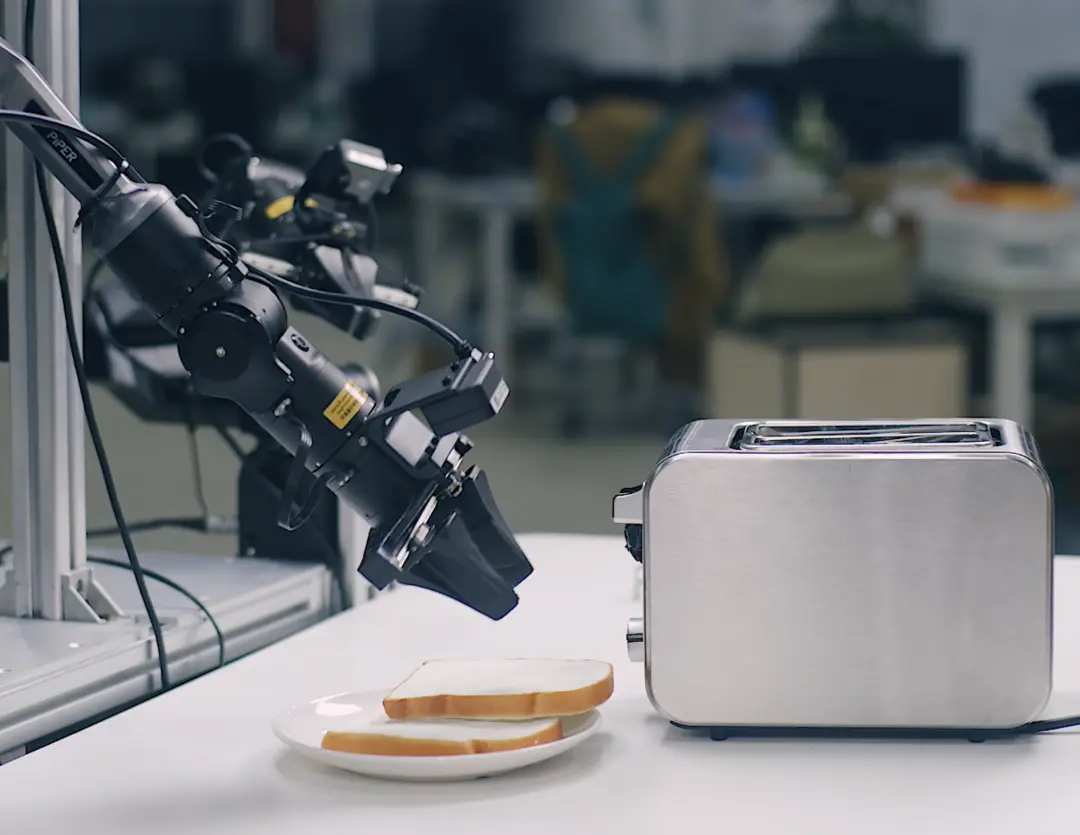
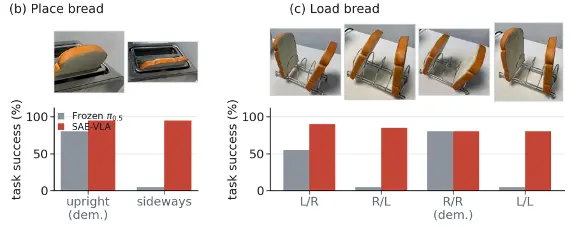
在这个「横放面包」的测试设置里,原始策略模型的成功率只有 5%。
它并不是不会。抓取、移动、放置,整套技能都在,只是这次的初始位姿越出了训练分布(OOD,Out-of-Distribution),导致它「做偏了」。
重新采集示教数据、增加训练吗?不仅需要额外时间投入,对算力也是不小的负担。
更麻烦的是,端到端模型的「黑盒」特性让人很难真正解释,到底是哪一步出了问题?
好消息是,面对「已有任务能力、但某一步做偏」的情况,极智嘉(Geek+)具身智能最新给出的答案是——不用回炉,用大白话即修正机器人局部动作偏差!
近日,极智嘉在其 Gravity 具身智能框架下推出 Gravity Control 因果干预模型。
它深入黑箱模型内部,找到真正「握着方向盘」的那些特征,在推理阶段直接调节。
面对分布外任务,操作人员只需给出一句自然语言提示(如「抓面包的时候更深一些。」),机器人就能把跑偏的动作改过来。
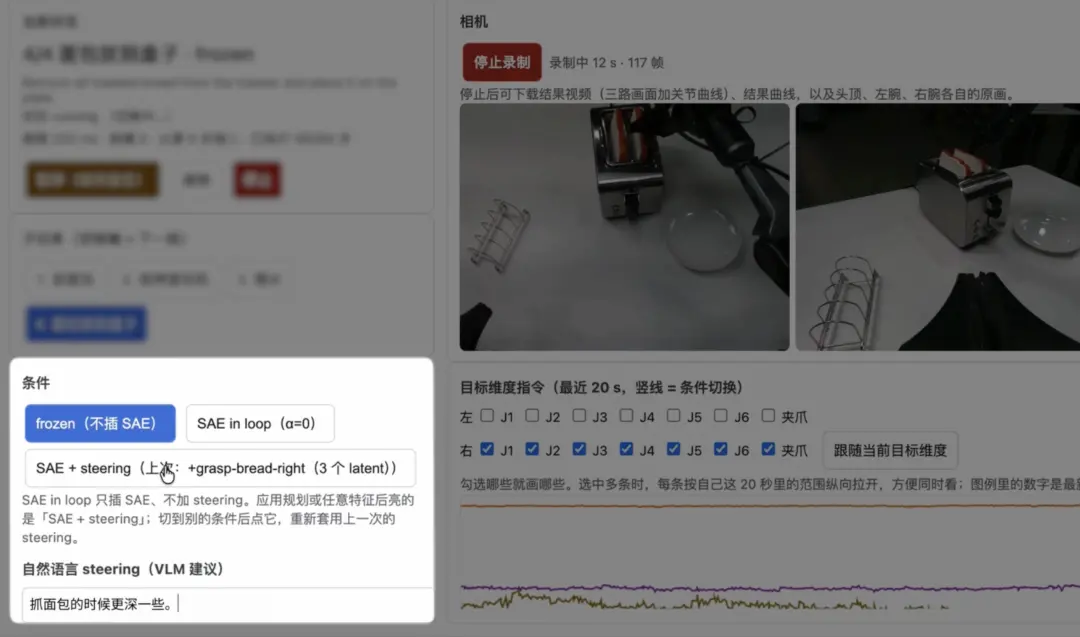
结果是:在真实的分布外复杂操作任务测试中,整体成功率从 17.5% 大幅提升至 87.5%;其中横放面包这一单项 OOD 设置,直接由 5% 飙升至 95%!
这组惊艳的数字背后,是一个值得全行业关注的变化——
机器人纠错这件事,第一次有了一条可解释、可验证、可约束的运行时路径!
过去两年,具身智能模型的进步有目共睹,但是真实物理世界从不按训练集出牌。
大量失败并不来自「完全不会」,而来自「差一点」。
这类局部偏差最折磨人。
对部署方而言,它意味着:现场不能停,问题又说不清,只能把数据上传回去,等下一版模型。
于是问题变成:对于模型已有能力范围之内的执行偏差,有没有一种更直接、可验证的纠偏方式?
要在推理运行时纠偏,先得回答一个底层问题:模型内部成千上万的高维隐藏表征里,哪些才真正掌握动作的控制权?
学界流传着一个迷思:如果某个表征能被解码出「抓取」「向下」这类语义概念,它就一定在指导机器人的行为。
但极智嘉研究团队的结论给这个直觉泼了一盆冷水——相关性不等于因果性。
研究发现,许多对物体或指令高度敏感的语言层表征,扮演的正是「解说员」——它对机械臂怎么动,几乎没有实际贡献。
真正驱动末端执行器姿态、夹爪开合与位移速度的「球员」,高度集中在动作生成链路深处的动作专家层。
为厘清作用路径,极智嘉团队形式化定义了一条概念属性链,一个特征要依次通过五道关卡:
Faithful(保真性) → Motor Aligned(运动对齐) → Verified(泛化验证) → Causal(因果可控) → Safe(闭环安全)
实验结果揭示了一个颠覆性的现象:语言层特征往往在「运动对齐」或「泛化验证」环节就从传导链上断开了!
名字听上去与运动有关,真去干预,物理动作却纹丝不动。只有动作专家层的特征,能完整走完全部五关。

这一发现的分量在于,它把「可解释」和「可控制」彻底拆开了。
不少可解释性工作停留在「给特征命名」,而 Gravity Control 坚持一条更严格的标准:一个特征有没有控制权,不应该看它叫什么,而更应该看干预之后动作有没有按预期响应。

基于上述发现,极智嘉构建了全新的 Gravity Control 模型。
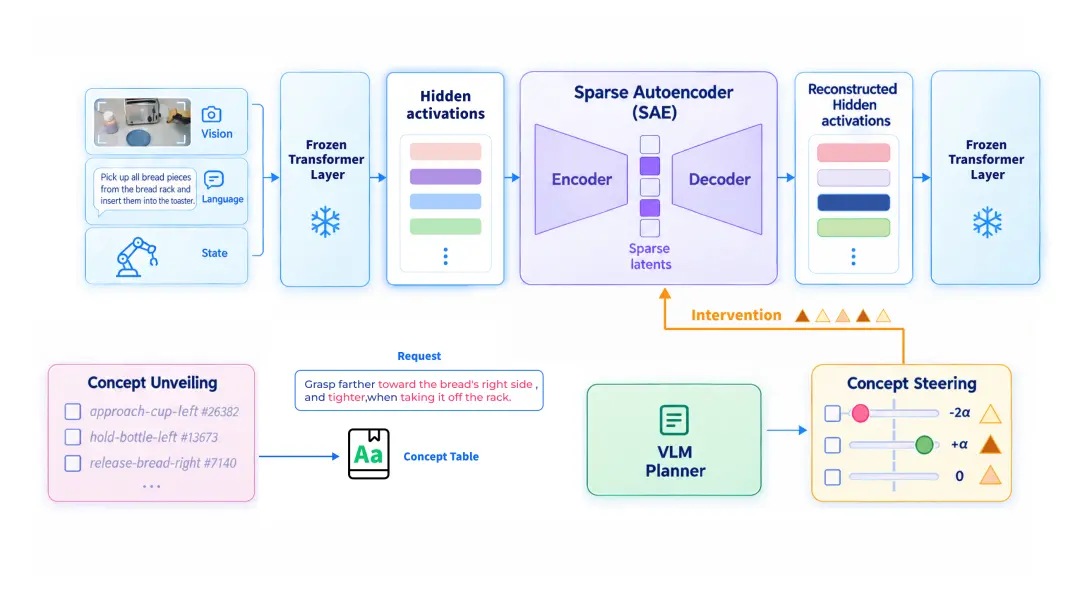
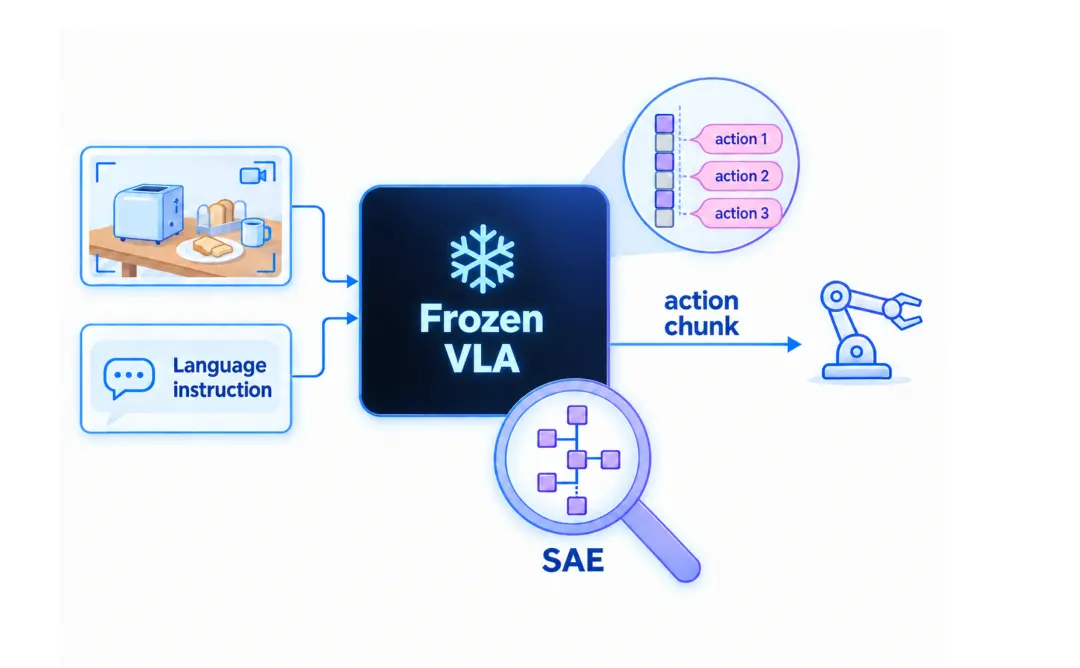
Gravity Control 模型框架总览
它的工作方式可以概括为精妙的三步:
第一步,拆(稀疏特征发现)。在冻结原始模型骨干的前提下,于残差流中引入 Top-K SAE(稀疏自编码器)等模块,把高维隐藏激活做稀疏分解,提取出一个个具有人类可解释语义的 Latent Feature。
第二步,推(定向因果干预)。对已完成语义标注的特征做定向因果干预(放大或抑制),再观察位置、旋转、夹爪等动作通道的真实物理响应。
第三步,筛(特异性评估)。引入干预特异性评估,只保留方向一致、剂量响应单调、影响集中在目标动作上的特征。通俗地说:调深度就只动深度,不能顺手把手腕也拧了。通过这三步的,才是真正可用的控制手柄。
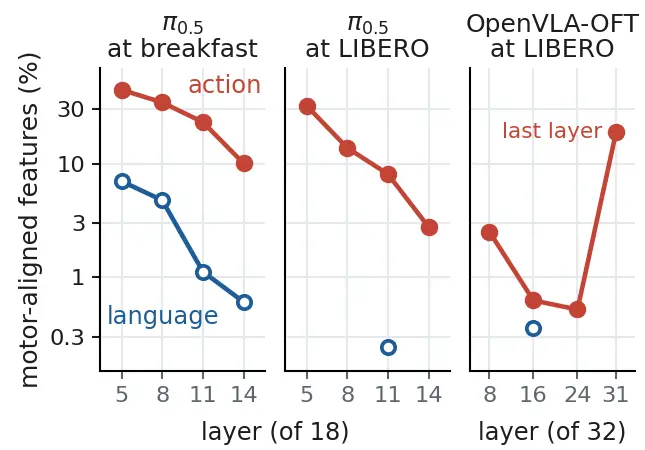
π0.5 与 OpenVLA-OFT 在不同层插入 SAE 后得到的可用特征数量比例区别
相较于过去业内只能通过特征激活对模型做被动「读出」,Gravity Control 真正打通了 Interpretability → Intervention → Control 的完整闭环。
这,就是用白盒化、可解释的思路来做因果干预。
找到了控制手柄之后,还有一个更具工程意义的问题:人怎么用最方便?
当然是说人话了!
传统端到端模型,只接受「把面包放进盘子」这样的宏观任务级指令。
但宏观指令并不天然提供对抓取深度、手腕角度等局部动作的稳定控制。
而 Gravity Control 会基于已建立的概念控制表,搭建一条语言引导的动作调节链路。
当机器人出现偏差,操作人员发出一句自然语言提示,外部 VLM 规划器无需重新规划整条轨迹,而是检索概念表中的特征词表,直接对原始模型内部激活做在线调节。
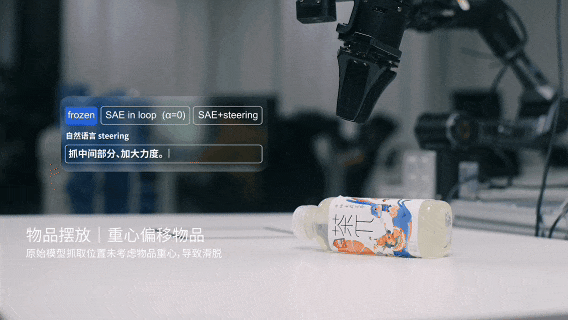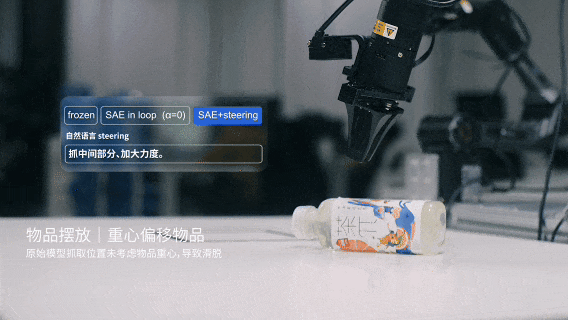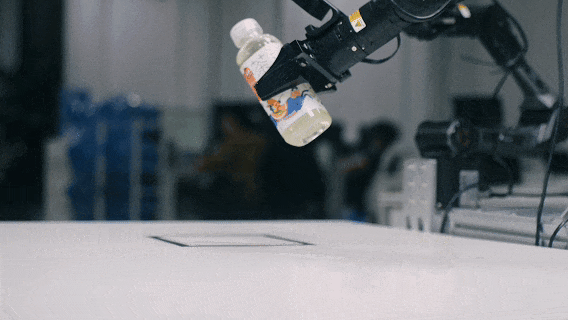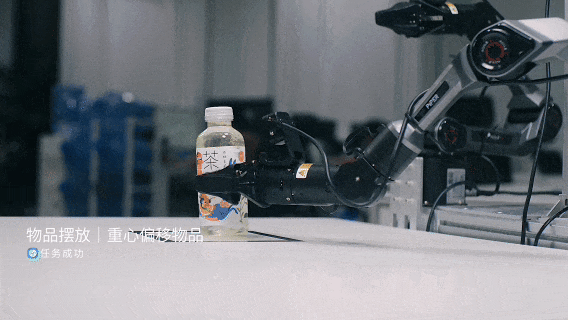
与此同时,系统引入了闭环门控,为干预程度设置上限,确保调节只作用于特定几何自由度,不会因为「用力过猛」引发灾难性的动作发散。
换言之,上一步骤的调整,不会影响到原本就能准确完成的下一步动作。
让机器人根据自然语言指令执行任务,已经是多种 VLA 模型具备的能力。
Gravity Control 最关键的进步是:当机器人已经具备完成任务的基础能力,却在执行中出现偏差时,如何把「抓得更深一点」这样的纠偏提示,转化为模型内部可验证、可约束的动作调节,在不更新原始策略权重的前提下修正偏差。
把视线拉到当前百家争鸣的全球具身智能赛道,会发现一个有趣的现象——
绝大多数头部玩家的主战场,是「让机器人会得更多」;
而「已经会的事做偏了怎么办」,至今仍是一块少有人系统攻克的硬骨头。
第一类:能力派——不断外推「会做什么」的边界
这一派代表了当前具身大模型的主流叙事。
Figure AI 在 2026 年初推出 Helix 02,随后展示了机器人在完全自主控制下连续跑满 8 小时班次的能力;其 Index 预训练将零样本成功率从约 9% 提升至 56%。
谷歌 DeepMind 发布的 Gemini Robotics 2 与 RT 系列,主打全身控制与多机协作。
英伟达开源了 30 亿参数的 Isaac GR00T,提供面向不同机器人的微调工作流;
Skild AI 则以「一个大脑控制任意机器人」为目标疯狂吸金。
这些工作共同把能力边界向显著拓展。
但当具体部署中出现局部偏差,主流的修复手段仍然是「黑盒模式」:回到数据,重新微调——以 GR00T 为例,其标准落地路径本身就是「基础模型 + 场景微调」。
第二类:数据派——用海量真实部署换可靠性
这一派,以特斯拉 Optimus 最有代表性。
马斯克曾坦言,工厂里还没有 Optimus 在做真正有用的工作,直到近期产量提升,精细操作依然是难题。
他们高度依赖庞大的人类遥操作团队,一旦遇到新环境表现不佳,做法就是「堆数据」重新训练。
同样的,Agility Robotics 的 Digit 通过累计超 6.5 万小时的运行将数据反哺模型;
Apptronik 建立巨大测试场专门采集数据。
这条路有效,但极其昂贵——可靠性的提升以「月」为单位,以「万小时」计。
第三类:纠错派——探索「失败恢复」的新范式
这是与 Gravity Control 愿景最接近的领域。
Physical Intelligence 的 π0.6 提出了 RECAP 方法,把示教、专家纠正与自主经验结合进强化学习,是「从错误中学习」的标杆。但其逻辑是「纠正 → 回收数据 → 再训练」,纠错依然发生在训练回路里。
1X Technologies 的 NEO 采用「Expert Mode」:遇到不会的任务由远程人类专家 VR 接管,本质是「人替机器人干」。
学术界(如斯坦福、伯克利等校)开始尝试通过 VLA 内部表征直接引导机器人行为,证明了「不改权重也能调行为」在技术上可行。
这样一看,极智嘉 Gravity Control 的领先性与独特生态位就非常清晰了。
它实现了四个「同时做到」——
1.零权重更新、零新增数据:相比训练回路纠错,将纠偏周期从「天/周」压缩到「一句话」。
2.完整的因果验证体系:通过概念属性链 + 特异性评估,把学术界「能调」的探索,推进到了「可控且安全」的工程落地标准。
3.自然语言接口与闭环门控:不需要操作员戴上 VR 手把手示范,同时有剂量上限兜住安全边界。
4.真机 OOD 任务的量级提升:单项成功率从 5% → 95% 的跃升,在公开披露的同类运行时干预成果中极其罕见。
更值得注意的是,这项技术的问题定义来自真实的产业作业,而非实验室。
目前,极智嘉的业务已覆盖了 40 多个国家、超过 1700 个项目,其面对的是仓储拣选、多 SKU、光照变化等高频场景中的极致可靠性要求。
在具身智能从 Demo 走向生产力的阶段,Gravity 框架补上的,正是解决「落地部署后迭代成本高昂」这块拼图。
这套技术不仅成绩亮眼,更实在的一点是,它完全不绑定特定的底层模型。
目前,它已在 π0.5、OpenVLA-OFT 等代表性 VLA 架构、LIBERO 仿真基准以及物理机器人平台上完成评估。
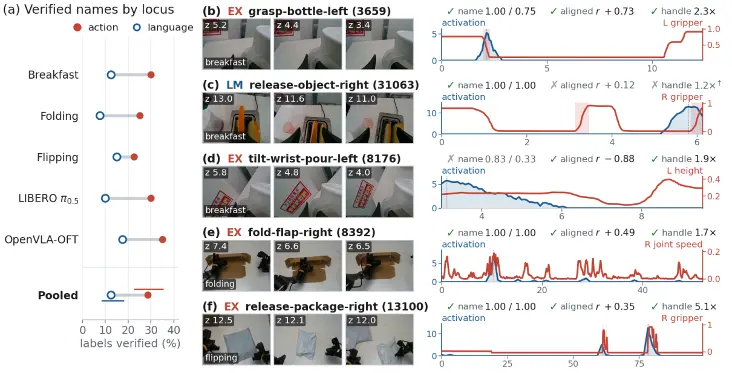
概念命名与动作因果控制相脱节 Naming and Control Come Apart 现象
看一眼实测数据,就知道这有多大的提升——在真实的物理机器人 OOD 任务中,在完全不更新原始策略权重、不新增示教数据的前提下,Gravity Control 将横放面包等分布外失败任务的整体成功率从 17.5% 跃升至 87.5%。
特别是前面提到的「横放面包」测试,成功率从 5% 提升到了 95%。
利用自然语言在线纠偏真实机器人的完整工作流
如果沿用补采数据、重新微调的办法来争取同样的提升,还得投入多少训练算力和迭代时间?而这次纠偏,是在不更新原始策略权重的前提下实现的。
当然,也得客观看待,这套方案不是什么「无中生有」的魔法。它的定位很明确:是「纠偏」而不是「启蒙」。
前提是机器人本身得具备这项基础技能,只是因为现场的一点变化(比如东西放歪了)导致动作跑偏了,它才能把偏掉的动作给「拉回来」。
想靠它直接教会机器人一门全新的手艺是不现实的。
但如果你在一线做过真实的商业部署,就会深有体会:恰恰就是这种「明明会干,但换个姿势就死活干不好」的微小偏差,才是每天在现场最耗费人力的无底洞。
能把这个问题低成本地解决掉,本身就已经解决了一大半的落地难题。
回到真实的柔性制造或仓储现场,Gravity Control 的价值会被放得无限大。
一个工作站每天面对成百上千种 SKU,摆放随机、包装各异。哪怕只有 1% 的动作跑偏,落到日均数千次抓取上,也是数十次人工介入。对客户而言,真正的成本在部署之后的每一天。
Gravity Control 指向的,是两层更长期的系统价值:
第一层,自动纠错闭环。
未来,Gravity Control 可以接入上层的 Agent 或 AI 原生系统套件。由系统直接充当「监工」,实时检测(Detect)任务状态 → 诊断(Diagnose)动作偏离 → 主动调用 Gravity Control 纠正(Correct)。
第二层,经验沉淀与复用。
一次成功的纠偏绝非「阅后即焚」。系统可以记录当时的任务阶段、场景状态、被调用的 Control Handle 以及干预剂量,把它沉淀为可复用的 Skill。
从纠错到 Skill,再到自进化——Gravity Control 为具身系统走向自主纠错与能力积累,提供了一条清晰的工程路径。
现在,具身智能的能力曲线仍在快速上扬,但真实世界不会只奖励「会做」,它给你一个更棘手的问题:「做错了怎么办?」
Gravity Control 给出的回答是:当模型已经具备基础能力时,就不必每次都回到昂贵的数据工厂。
只要找到真正掌握控制权的内部特征,用一句自然语言在推理阶段精准调节,就能用闭环门控守住安全边界,再把每一次成功纠偏沉淀为经验。
对研究者而言,这证明了「概念可解释 ≠ 行为可控制」的实证;而对于产业而言,这意味着一笔实实在在的账:机器人在现场部署后的运维和微调成本,终于有希望降下来了。它不再是个需要人天天盯着的娇贵设备。
分布外复杂操作任务的的成功率从 5% 拔高到 95%,可能只是一盘前菜。真正让人兴奋的是,给机器人「纠错」这件原本极其昂贵、费时又像开盲盒一样的事,终于变成了一种看得懂、管得住、还能不断积累的能力。
怎么让具身智能从酷炫的 Demo 变成真正好用的生产力工具?在这个问题上,极智嘉已经率先交出了答卷。
编辑:Aeneas 马可