新智元报道
新智元报道

给AI几张网站截图,它已经能快速生成一个「看起来很像」的网页。但真正操作起来呢?在商品页加入商品后,购物车会不会更新;切换页面后,刚才的状态还能不能保留?
UI2App关注的正是这个问题:不给功能说明、不给点击轨迹或交互演示,只给静态UI截图,模型能否自行推断并实现其中隐含的应用行为?我们把这种能力称为Interaction Inference,即「交互推断」。
论文:https://arxiv.org/abs/2607.06306v2
项目主页:https://chenmancm169.github.io/UI2App-ProjectPage/
代码:https://github.com/chenmancm169/UI2App
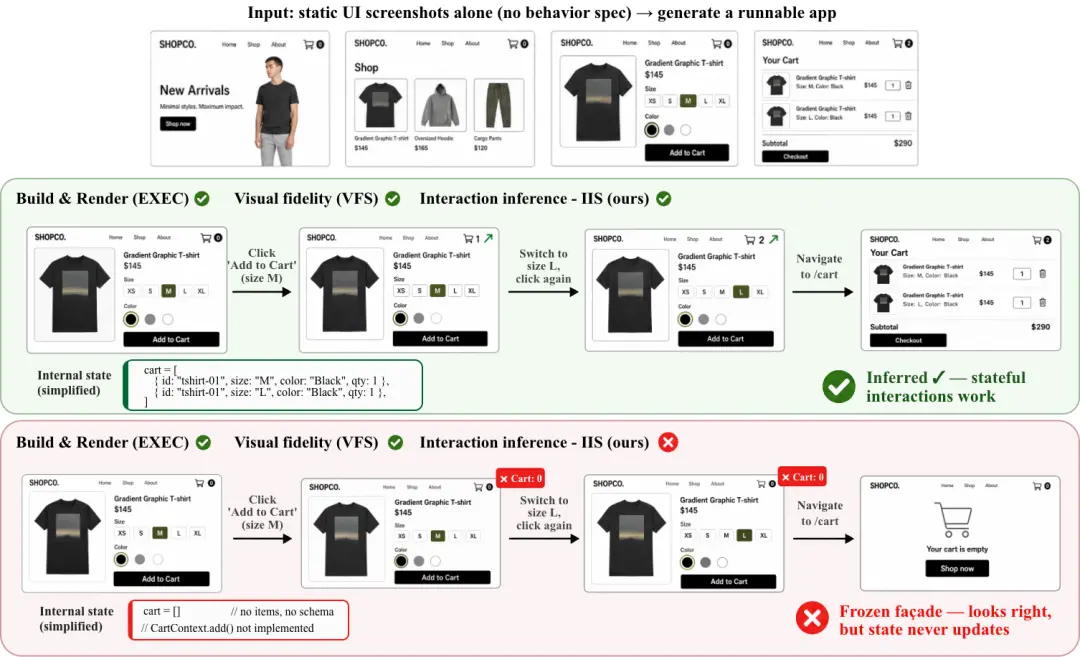
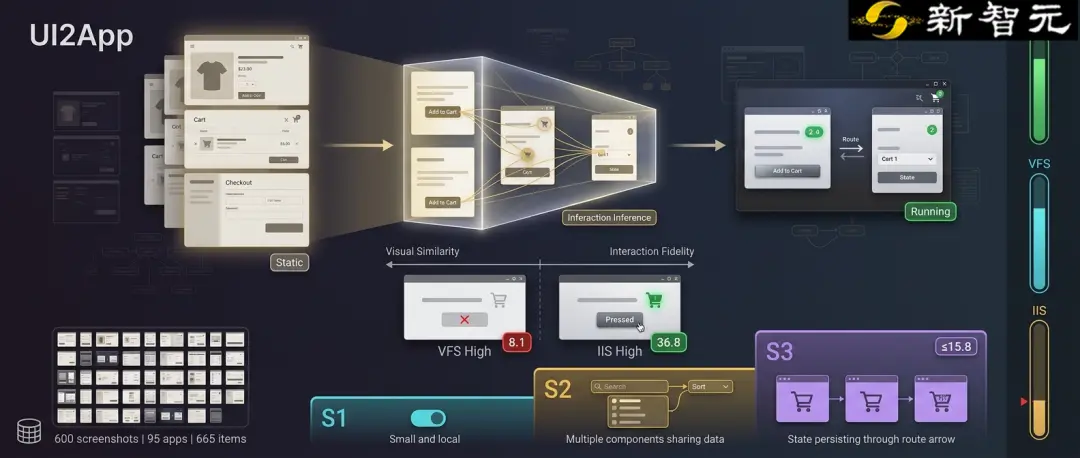
论文Figure 1:同一组截图、同一操作序列下,视觉还原更高并不保证购物车状态逻辑被正确实现。
一个很现实的需求是:看到一个喜欢的产品界面,希望AI能直接做出一个可以运行、可以交互的类似应用。
对没有产品或开发背景的用户来说,截图、设计稿或参考产品本身就是更自然的表达方式;他们关心的不只是页面像不像,还包括按钮能不能用、数据会不会联动,以及切换页面后状态能不能保持。
这正是现有评测之间缺少的一环:Screenshot-to-Code评测大多关注视觉相似度,部分交互式生成任务则会提供显式的行为指导。UI2App关注的是,只给静态截图时,模型能否自行推断其中隐含的应用行为,并把它实现出来。
UI2App包含600张截图,组成95组状态一致的多页面Web应用,每个任务包含3到14张截图,并形成665个「应用-交互类别」评测项。模型只看到静态截图,不获得操作轨迹或额外行为说明,需要据此生成可运行的多页面应用。
完成这项任务,需要模型理解UI结构和语义,推断截图暗含的交互,再把这些判断落实为共享组件、路由和跨页面协调的状态管理,最终生成一个可运行的React应用。
生成结果从三个维度评价:能否真正构建和运行(EXEC)、与截图有多像(VFS),以及截图暗含的交互能否被推断并实现(IIS)。
IIS会依据截图中可推断的交互,检查这些行为是否被覆盖、是否真正产生预期结果,以及相关状态能否在组件和页面之间正确保持。点击、筛选、购物车等交互不只要「有反应」,还要形成正确而一致的状态变化。
从按钮到购物车,状态作用范围决定交互复杂度
UI2App覆盖开关、展开/折叠、列表操作、数据增删改查、表单验证、通知反馈和跨页面状态7类常见交互,并按照状态作用范围区分复杂度:S1是局部UI状态,例如按钮、下拉框或标签页;S2涉及多个组件共享的数据状态,例如搜索、排序和CRUD;S3则要求状态跨路由持续存在,例如购物车、登录态或编辑中的内容。从局部按钮,到同一页面的数据联动,再到跨页面保留状态,这一划分对应不断增加的状态管理复杂度,也让分析不只停留在一个总分,而能进一步区分模型在局部UI、共享数据和跨页面状态上的表现。
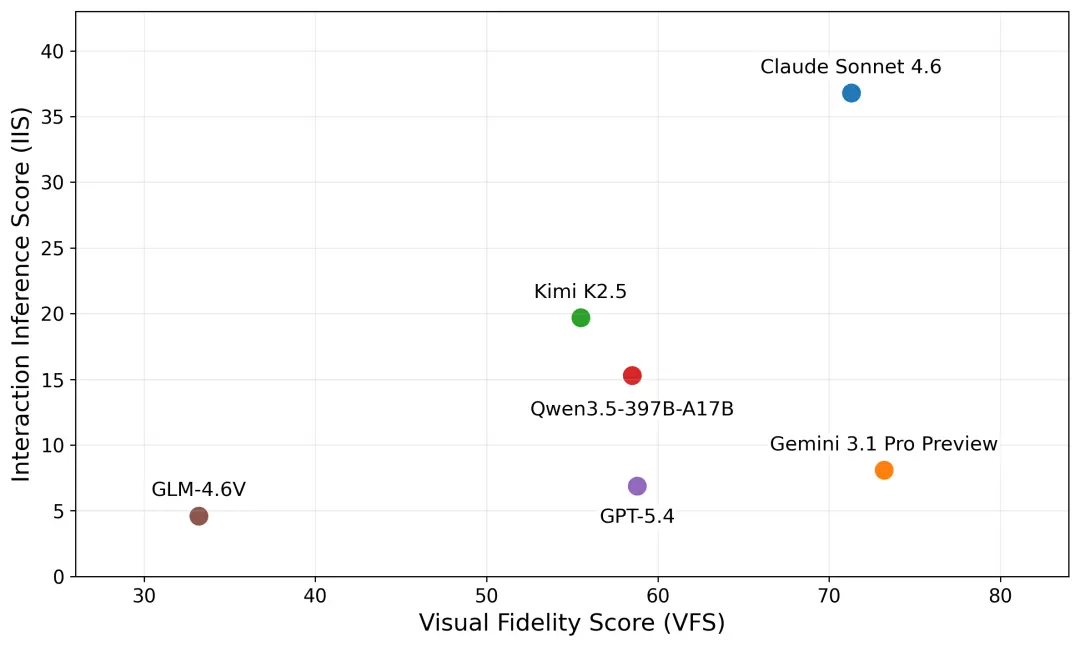
在这组评测中,VFS与IIS呈现出不同的模型排序。Gemini 3.1 Pro Preview以73.2的VFS拿到视觉还原第一,但IIS为8.1、排名第四;Claude Sonnet 4.6的VFS为71.3,略低于Gemini,但IIS达到36.8,也是当前评测中的最高值。
这说明至少在UI2App上,视觉还原分数不能直接代表交互推断表现。即使最高IIS也只有36.8/100,说明仅从静态截图推断并实现应用行为仍有较大提升空间;因此,只看视觉还原效果,可能会高估模型对应用交互的实际实现能力。
在最复杂的S3跨路由状态上,除表现最佳者外,其余参评模型得分都不超过3.5,最佳成绩也只有15.8/100。
这类交互的难点不只是给按钮绑定事件:系统还要推断哪些信息应该共享,并让状态在路由切换后继续存在。购物车、登录态或跨页面编辑,因此比局部按钮、下拉框更依赖完整而一致的状态管理。

当输入只有静态截图时,模型面对的并不只是视觉重建:它还要从多个界面状态中判断元素之间如何联动、一次操作会改变哪些数据,以及这些变化应该在何处继续生效。这里考察的是对应用行为的理解,而不只是对页面外观的还原。
UI2App把这层能力从视觉复刻中单独提出并量化,使截图驱动的应用生成能够同时比较「能否运行」「看起来多像」和「截图暗含的交互是否被推断并实现」。
它也把一个容易被视觉效果掩盖的问题变成了可测量的研究对象:模型能否仅从有限的视觉观察中推断应用行为,并把这种理解落实为真正可运行的交互。
由此,问题不再停留在「页面能否被复刻」,而进一步落到「应用行为能否从视觉线索中被推断并实现」,为更自主的Screenshot-to-App生成提供可比较的评测基础。
参考资料:
https://arxiv.org/abs/2607.06306v2
编辑:LRST