始终在线的AI代理不仅需要生成文本,还需解读视觉信息、在长时任务中推理,并可靠调用工具处理文档、应用和视频。NVIDIA Nemotron 3.5 Super VL正是为此设计的开放多模态模型,支持文本、图像、文档和视频输入,输出文本用于代理推理与工具调用。
模型概览
该模型采用混合专家架构,拥有1200亿总参数,每次激活120亿参数。它作为Nemotron 3系列中的高精度多模态执行模型,与Nemotron 3.5 Lightning和Nemotron 3 Ultra互补,专为企业定制化工作流设计。
核心特性
- 架构:120B参数MoE模型,每次激活12B参数
- 模态:文本、图像、文档、视频输入,文本输出
- 优化:C-RADIOv4视觉编码、混合Mamba-Transformer架构、多令牌预测(MTP)、NVFP4量化
- 部署目标:DGX Spark、1x GB10、B200、B300、RTX PRO 6000、H200及2x H100
使用SGLang快速部署
SGLang为该模型提供高性能服务层,支持连续批处理、前缀缓存、投机解码及OpenAI兼容API。
安装与启动
docker pull lmsysorg/sglang:v0.5.21
启动容器后运行以下命令:
sglang serve --model-path nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 --trust-remote-code --reasoning-parser nemotron_3 --speculative-algorithm EAGLE --speculative-num-steps 5 --speculative-eagle-topk 1 --speculative-num-draft-tokens 6 --port 8000
多令牌预测优化推理
模型内置MTP头,结合EAGLE投机解码可在RTX 6000 PRO上达到243.9 tok/s速度,特别适合长时代理任务。
多模态代理工作流
模型可处理截图、文档、界面和视频,支持客户服务、文档智能、企业生产力、视频理解及网页研究等场景,并可通过NVIDIA NeMo进行领域定制。
准确率与效率表现
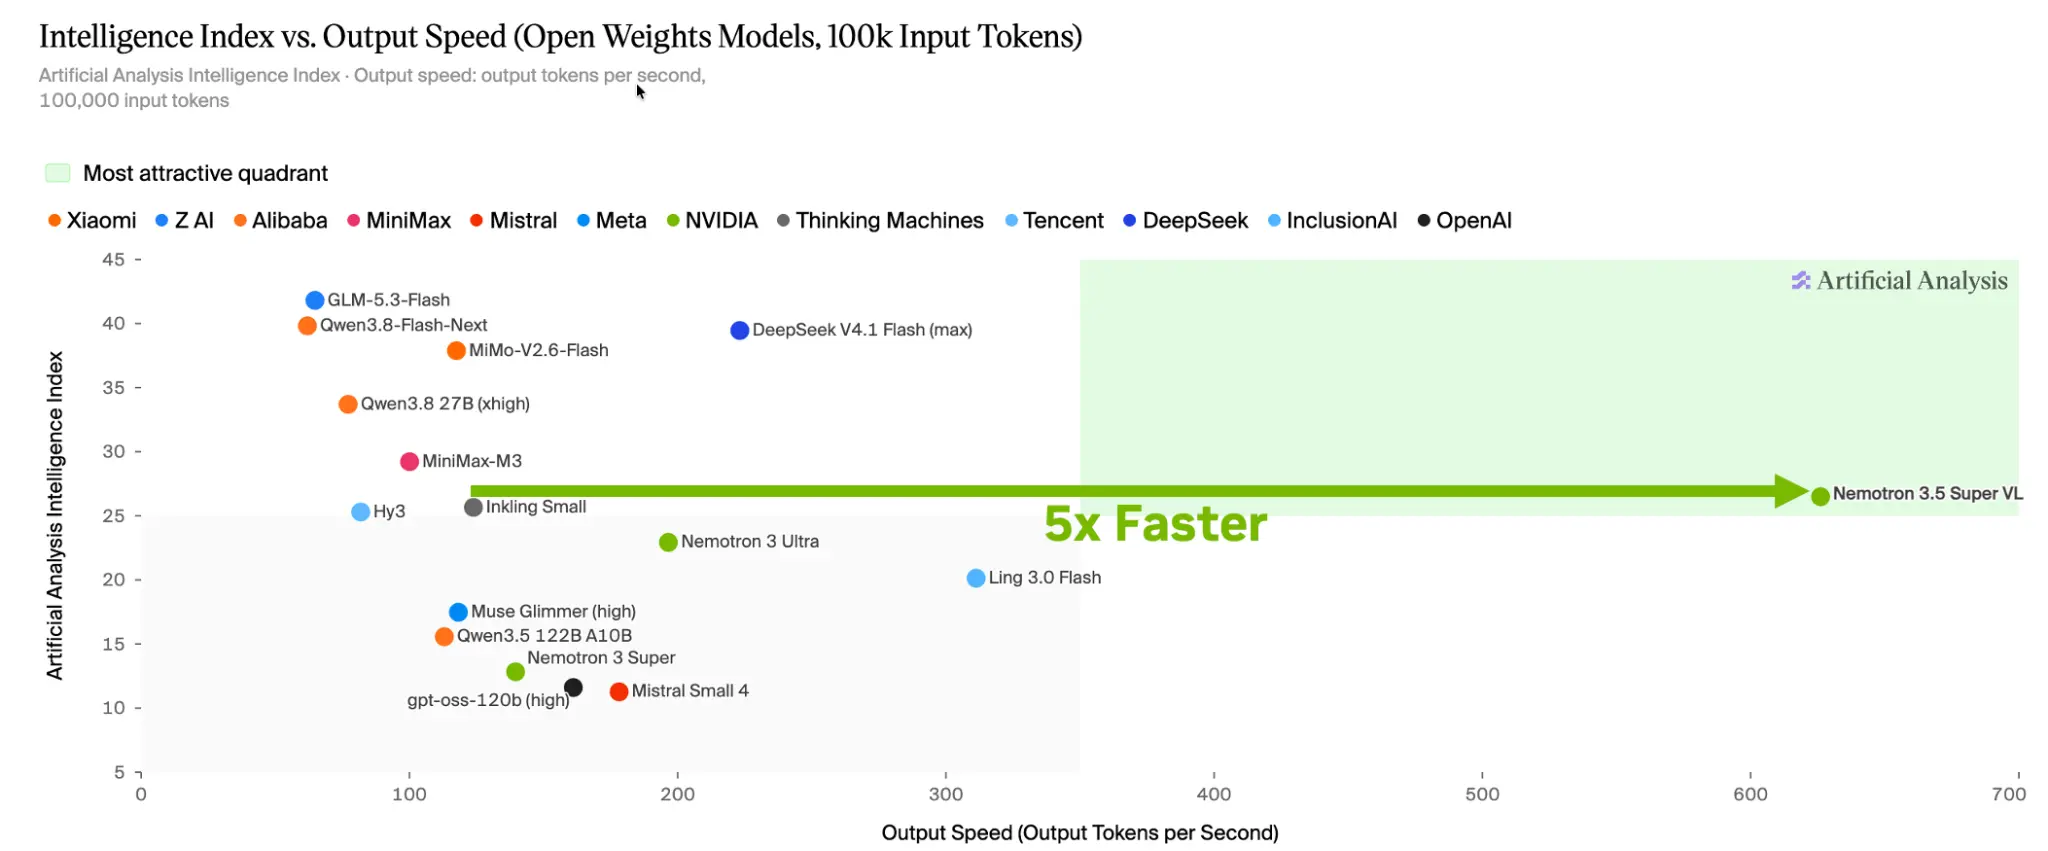
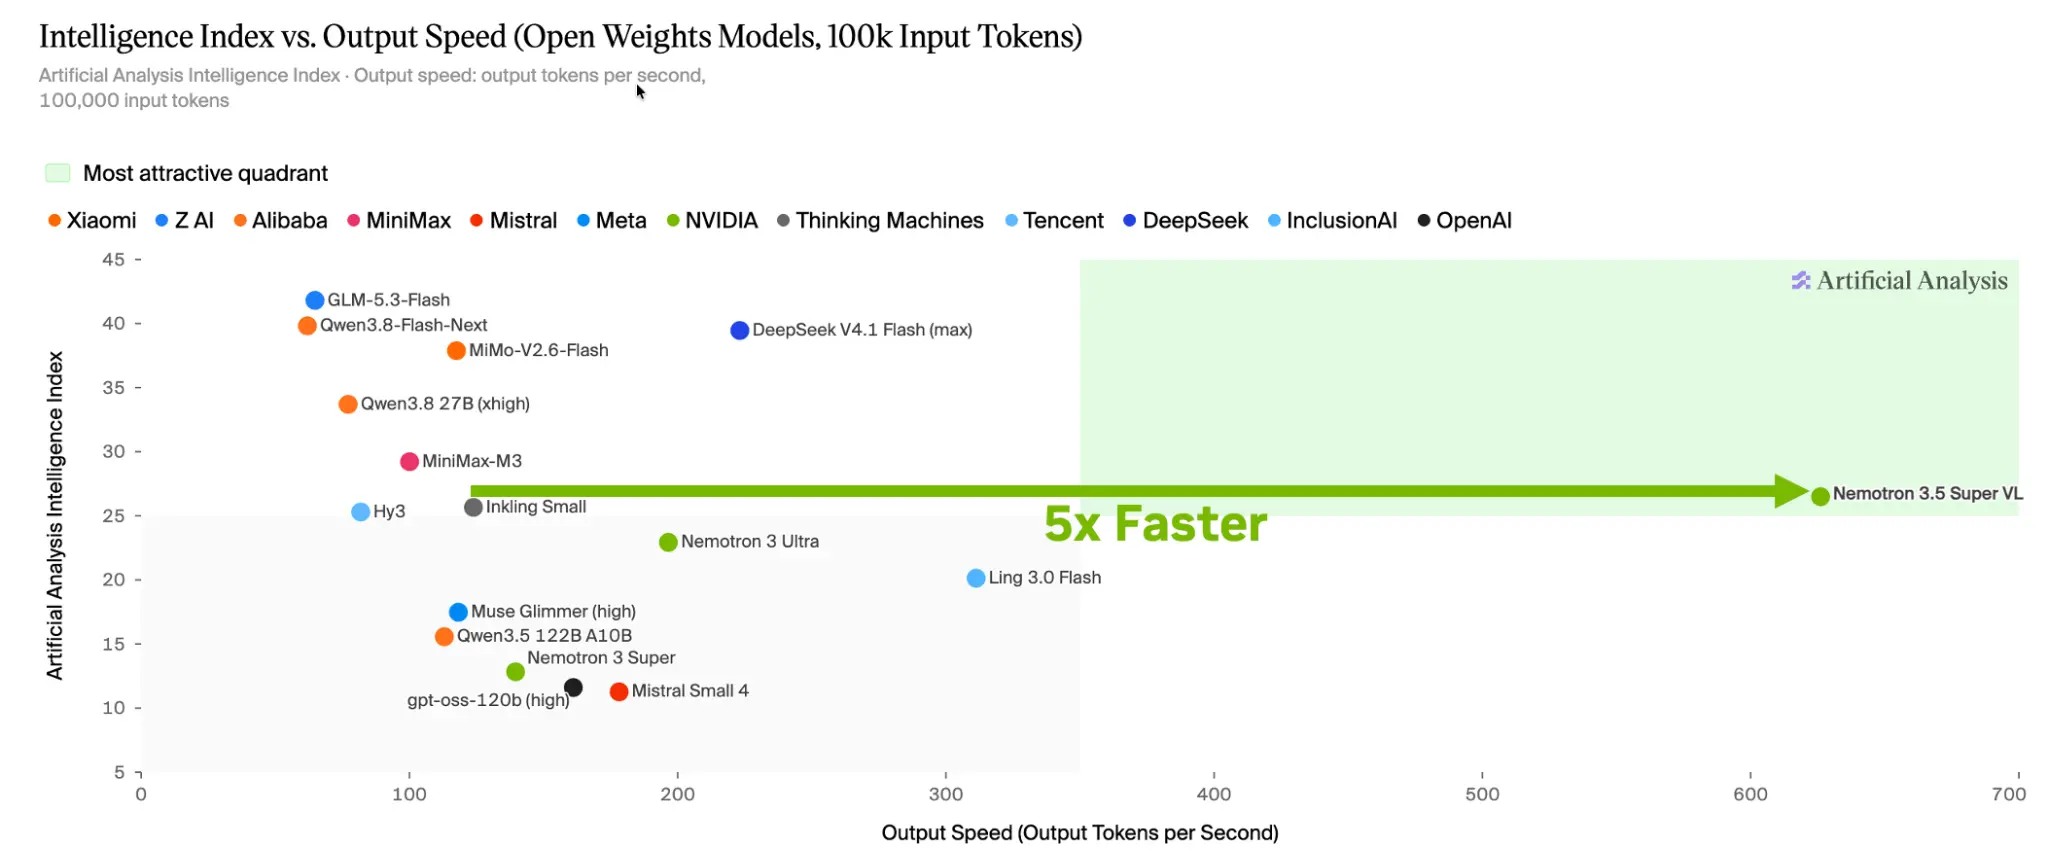
在单GPU上,Nemotron 3.5 Super VL在Artificial Analysis Intelligence Index代理任务中实现超过5倍吞吐提升。
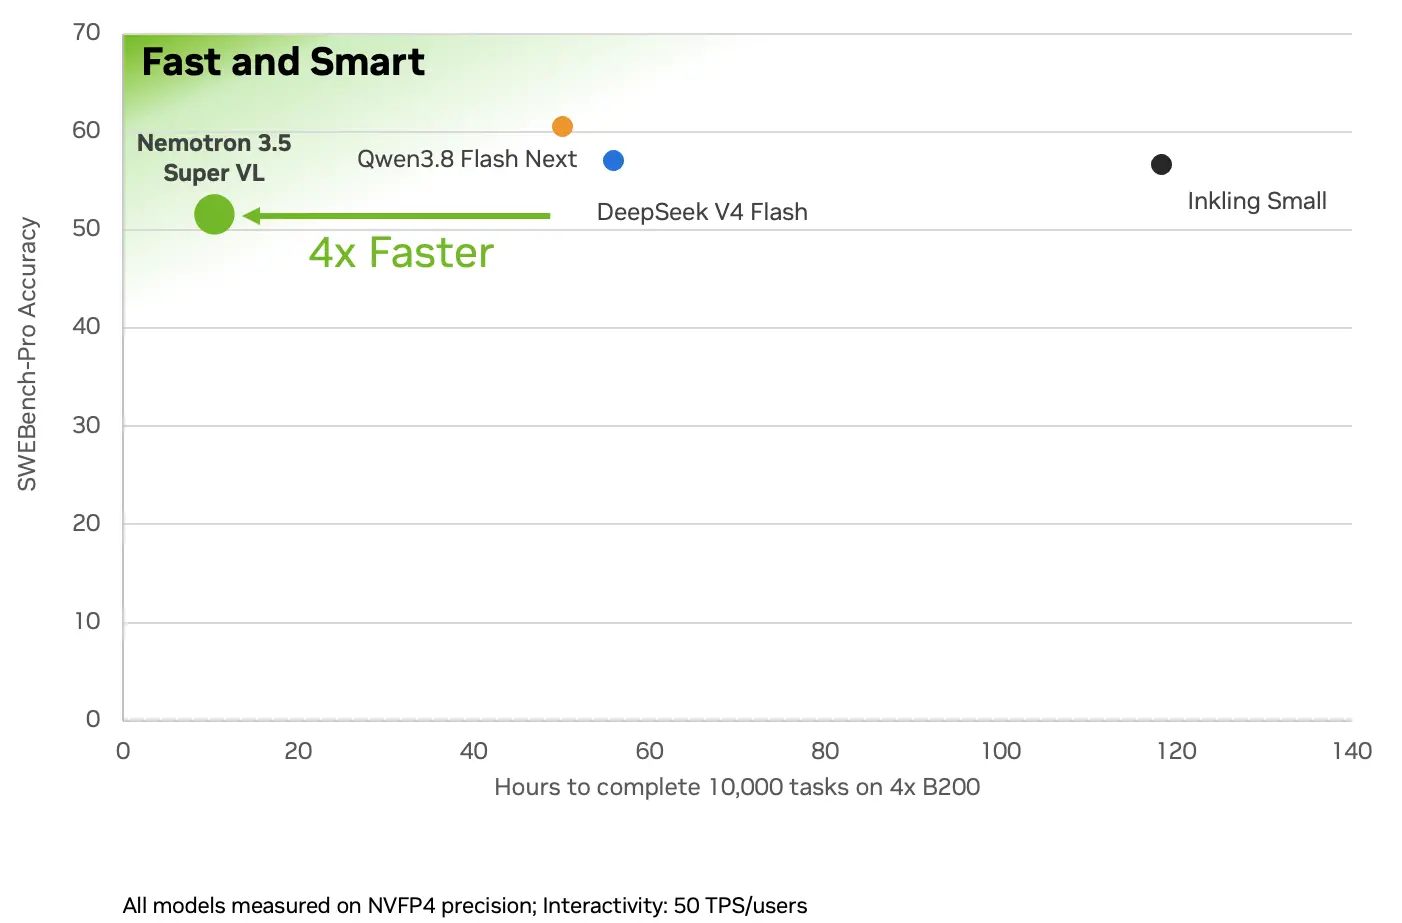
在SWE-bench Pro任务中,该模型完成10000个任务的时间比同类开放模型缩短4倍。
获取资源
从Hugging Face下载BF16或NVFP4权重,并参考SGLang cookbook快速上手。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接