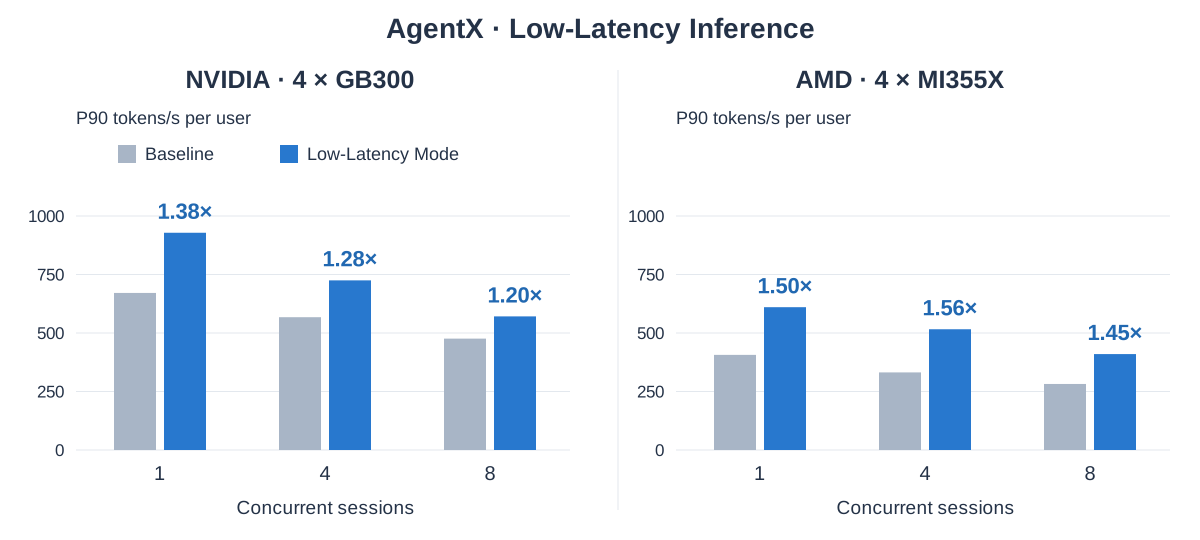
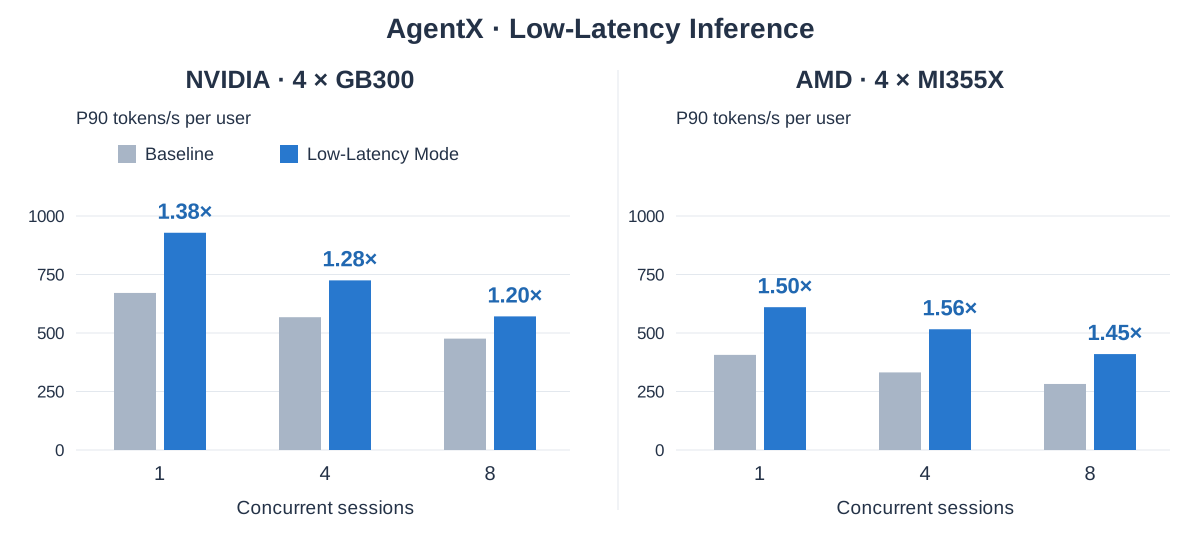
SGLang 低延迟模式专为特定模型、硬件和工作负载设计,通过插件框架引入专用内核,避免重复代码并显著降低延迟。
低延迟推理内核
NVIDIA 低延迟内核
在 NVIDIA GPU 上,插件通过重叠依赖内核与通信、针对小批量优化注意力、MoE 和草稿采样,显著降低延迟。相关内核位于 sgl-nvidia-mega 仓库。
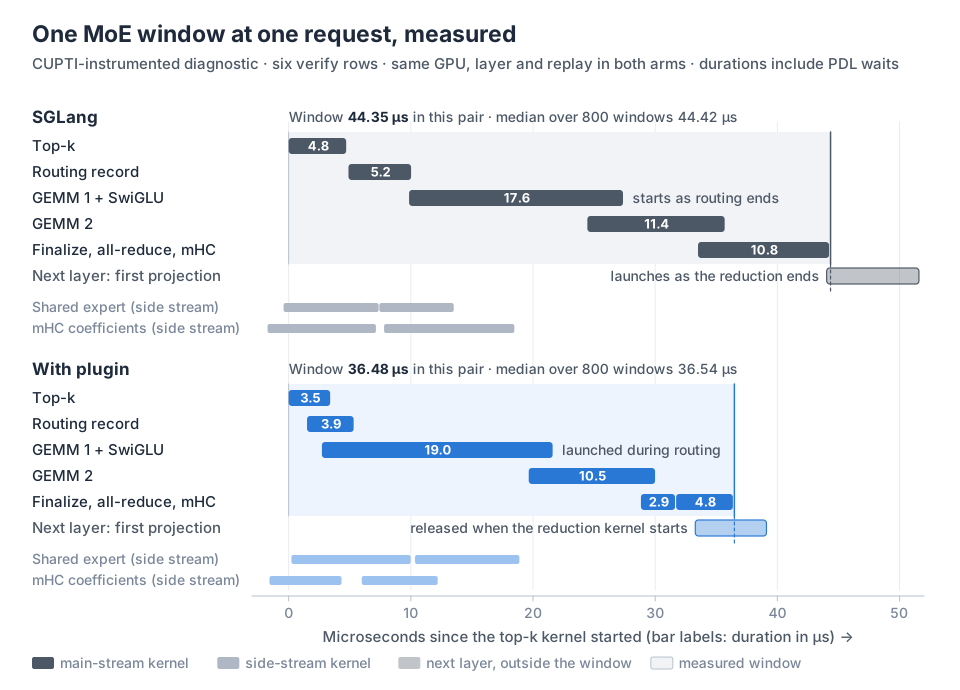
单请求场景下,DSpark 每步验证六个 token 行,插件将解码器层中位延迟从 96.8 µs 降至 68.4 µs,主要通过提前启动下一内核和跨 GPU 通信重叠实现。
低延迟专用优化
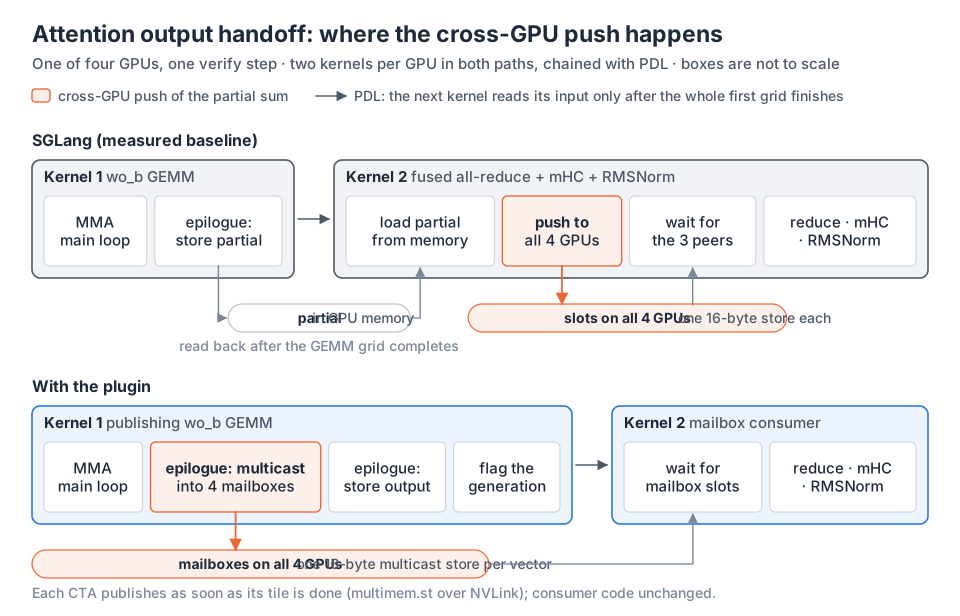
1. 使用 PDL 在输入就绪前启动下一内核;2. 将投影输出从 GEMM 尾声直接发布至 NVLink;3. 在路由完成前启动专家 GEMM;4. 将草稿采样合并为单内核。
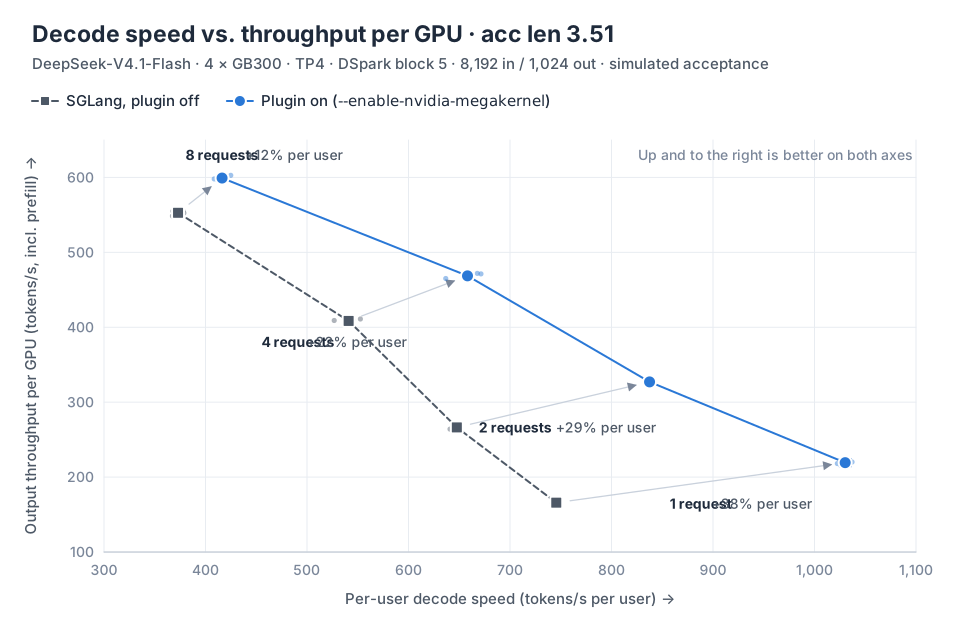
服务结果显示,8K 输入/1K 输出工作负载下,四张 GB300 GPU 上每用户解码速度提升 12–38%。
AMD 低延迟内核
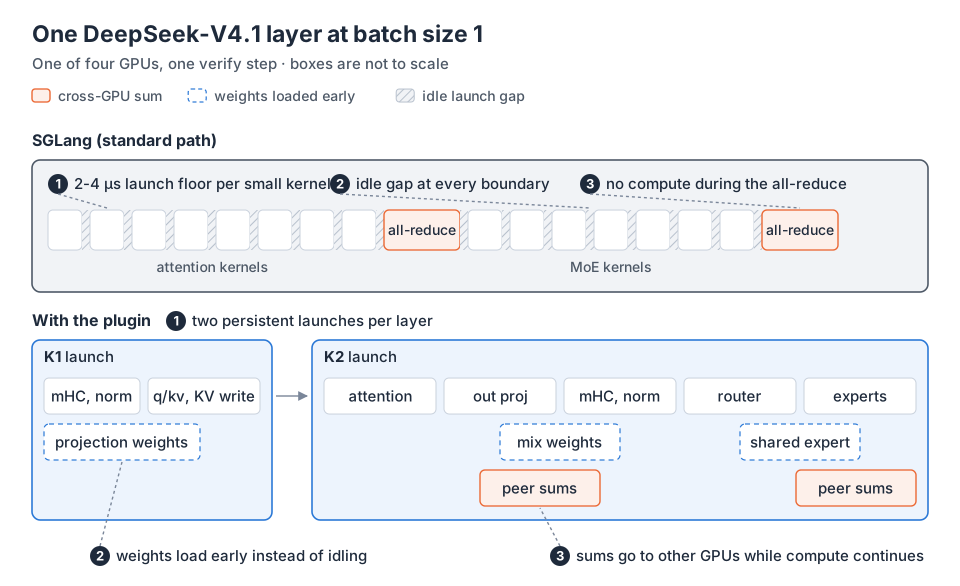
AMD 方案将解码器层计算与通信合并为少量持久内核,位于 sgl-amd-mono 仓库。标准路径存在数十个小内核、启动开销和两次全规约停顿,插件用两个 FlyDSL 启动替换,提前加载权重并在计算中重叠通信。
插件系统设计与集成
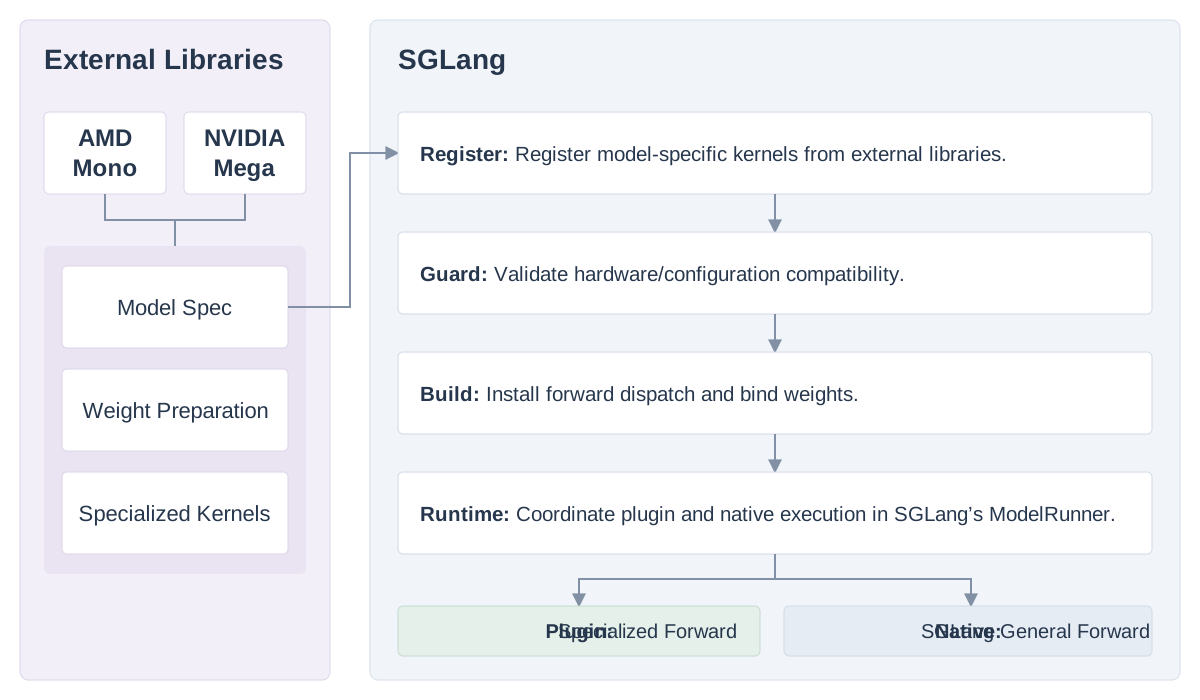
外部内核库向 SGLang 注册模型规范,系统验证配置、构建插件并分发支持步骤。
未来计划
团队将继续扩展更多模型与硬件支持,并优化多并发场景下的性能。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接