Anthropic 在 11 月 9 日发布了 Claude Fable 5.2 和 Claude Mythos 5.2。这两个名字看起来像两条产品线,实际上是同一个底层模型——Fable 带完整的网络安全和生物学防护,对所有用户开放;Mythos 卸掉部分限制,只通过验证计划提供给从事防御性安全或生物医学研究的机构。
对开发者来说,真正想知道的不是它能解什么难题,而是三件事:便不便宜、快不快、值不值得换。
答案是:输入 8 美元、输出 40 美元每百万 token,比上一代 Fable 5.1 便宜;输出速度提升最多 30%;另外有一个可选的 fast 模式,生成速度再快 2.5 倍,价格翻倍到 16 美元 / 80 美元。
八个工程师团队用 AI 干完的活,现在一个工程师加 1000 个 Agent 在干
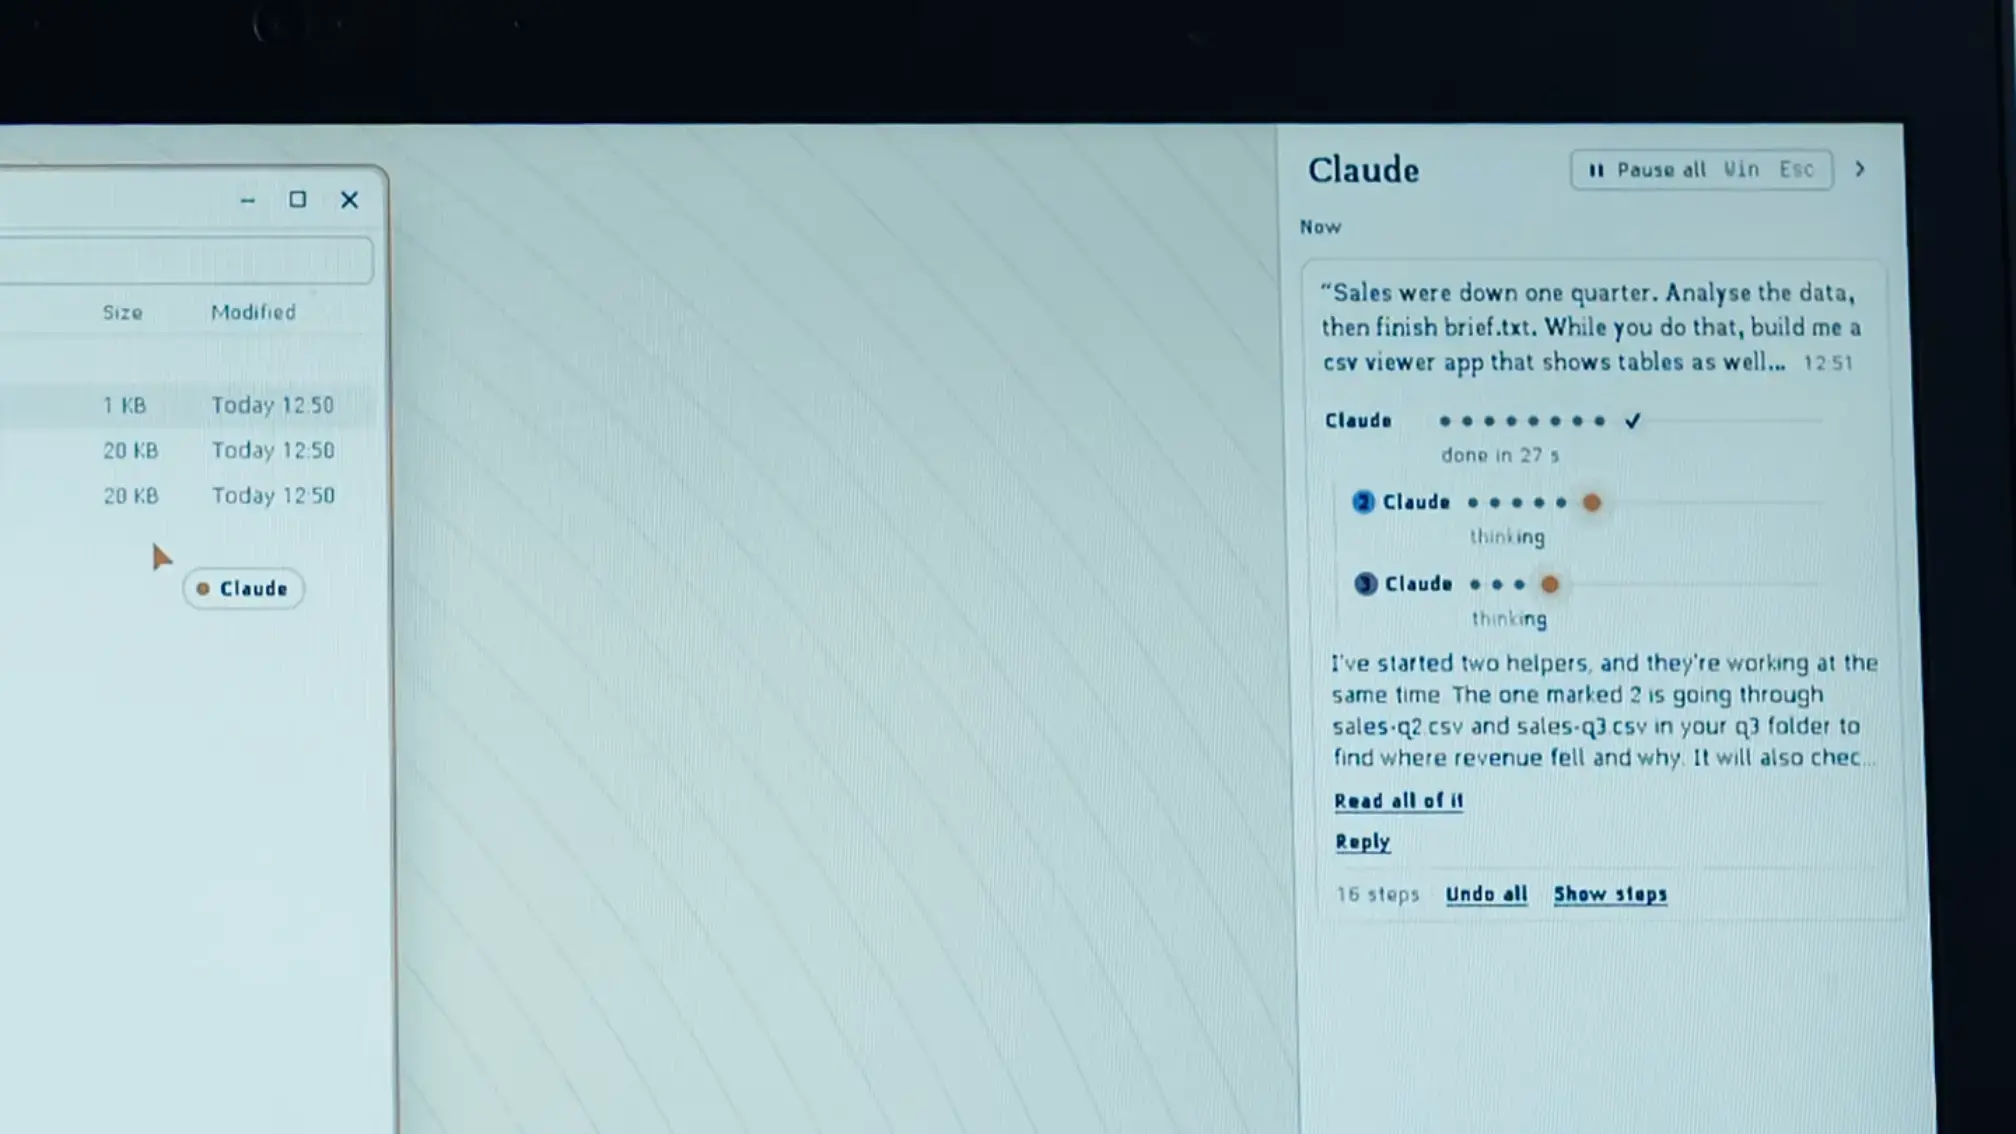
发布稿里最扎眼的是一个实验。一位 Anthropic 工程师让 Fable 5.2 从空文件夹开始,写一个操作系统原型。模型协调了超过 1000 个子 Agent,连续工作八天,写代码、测试、审查,最后交付了一个能在笔记本上启动的系统——有自己的内核、磁盘键盘网卡驱动、持久化文件存储、窗口系统、登录界面、安装程序,还内置了 Claude 功能。
还有个数字更能说明问题:现在 Anthropic 内部核心代码库里超过 90% 的合并改动是 Claude 写的(有人类指导)。
另一组是数学上的。今年早些时候,Anthropic 用一个未发布的研究版 Claude 形式化了费马大定理的证明,花了 11 天,需要专门搭建的工具链和人类研究员引导。这次用 1000 个 Fable 5.2 Agent,30 小时完成,人类干预极少,用的行动 token 只有上一次的三分之一,产出的证明短了七倍。作为对照,同样 1000 个 Agent 的 Opus 5.5 在 18 小时里只完成了 26%,之后基本停滞。
基准测试:几个位置上不再只是「接近」,而是明确领先
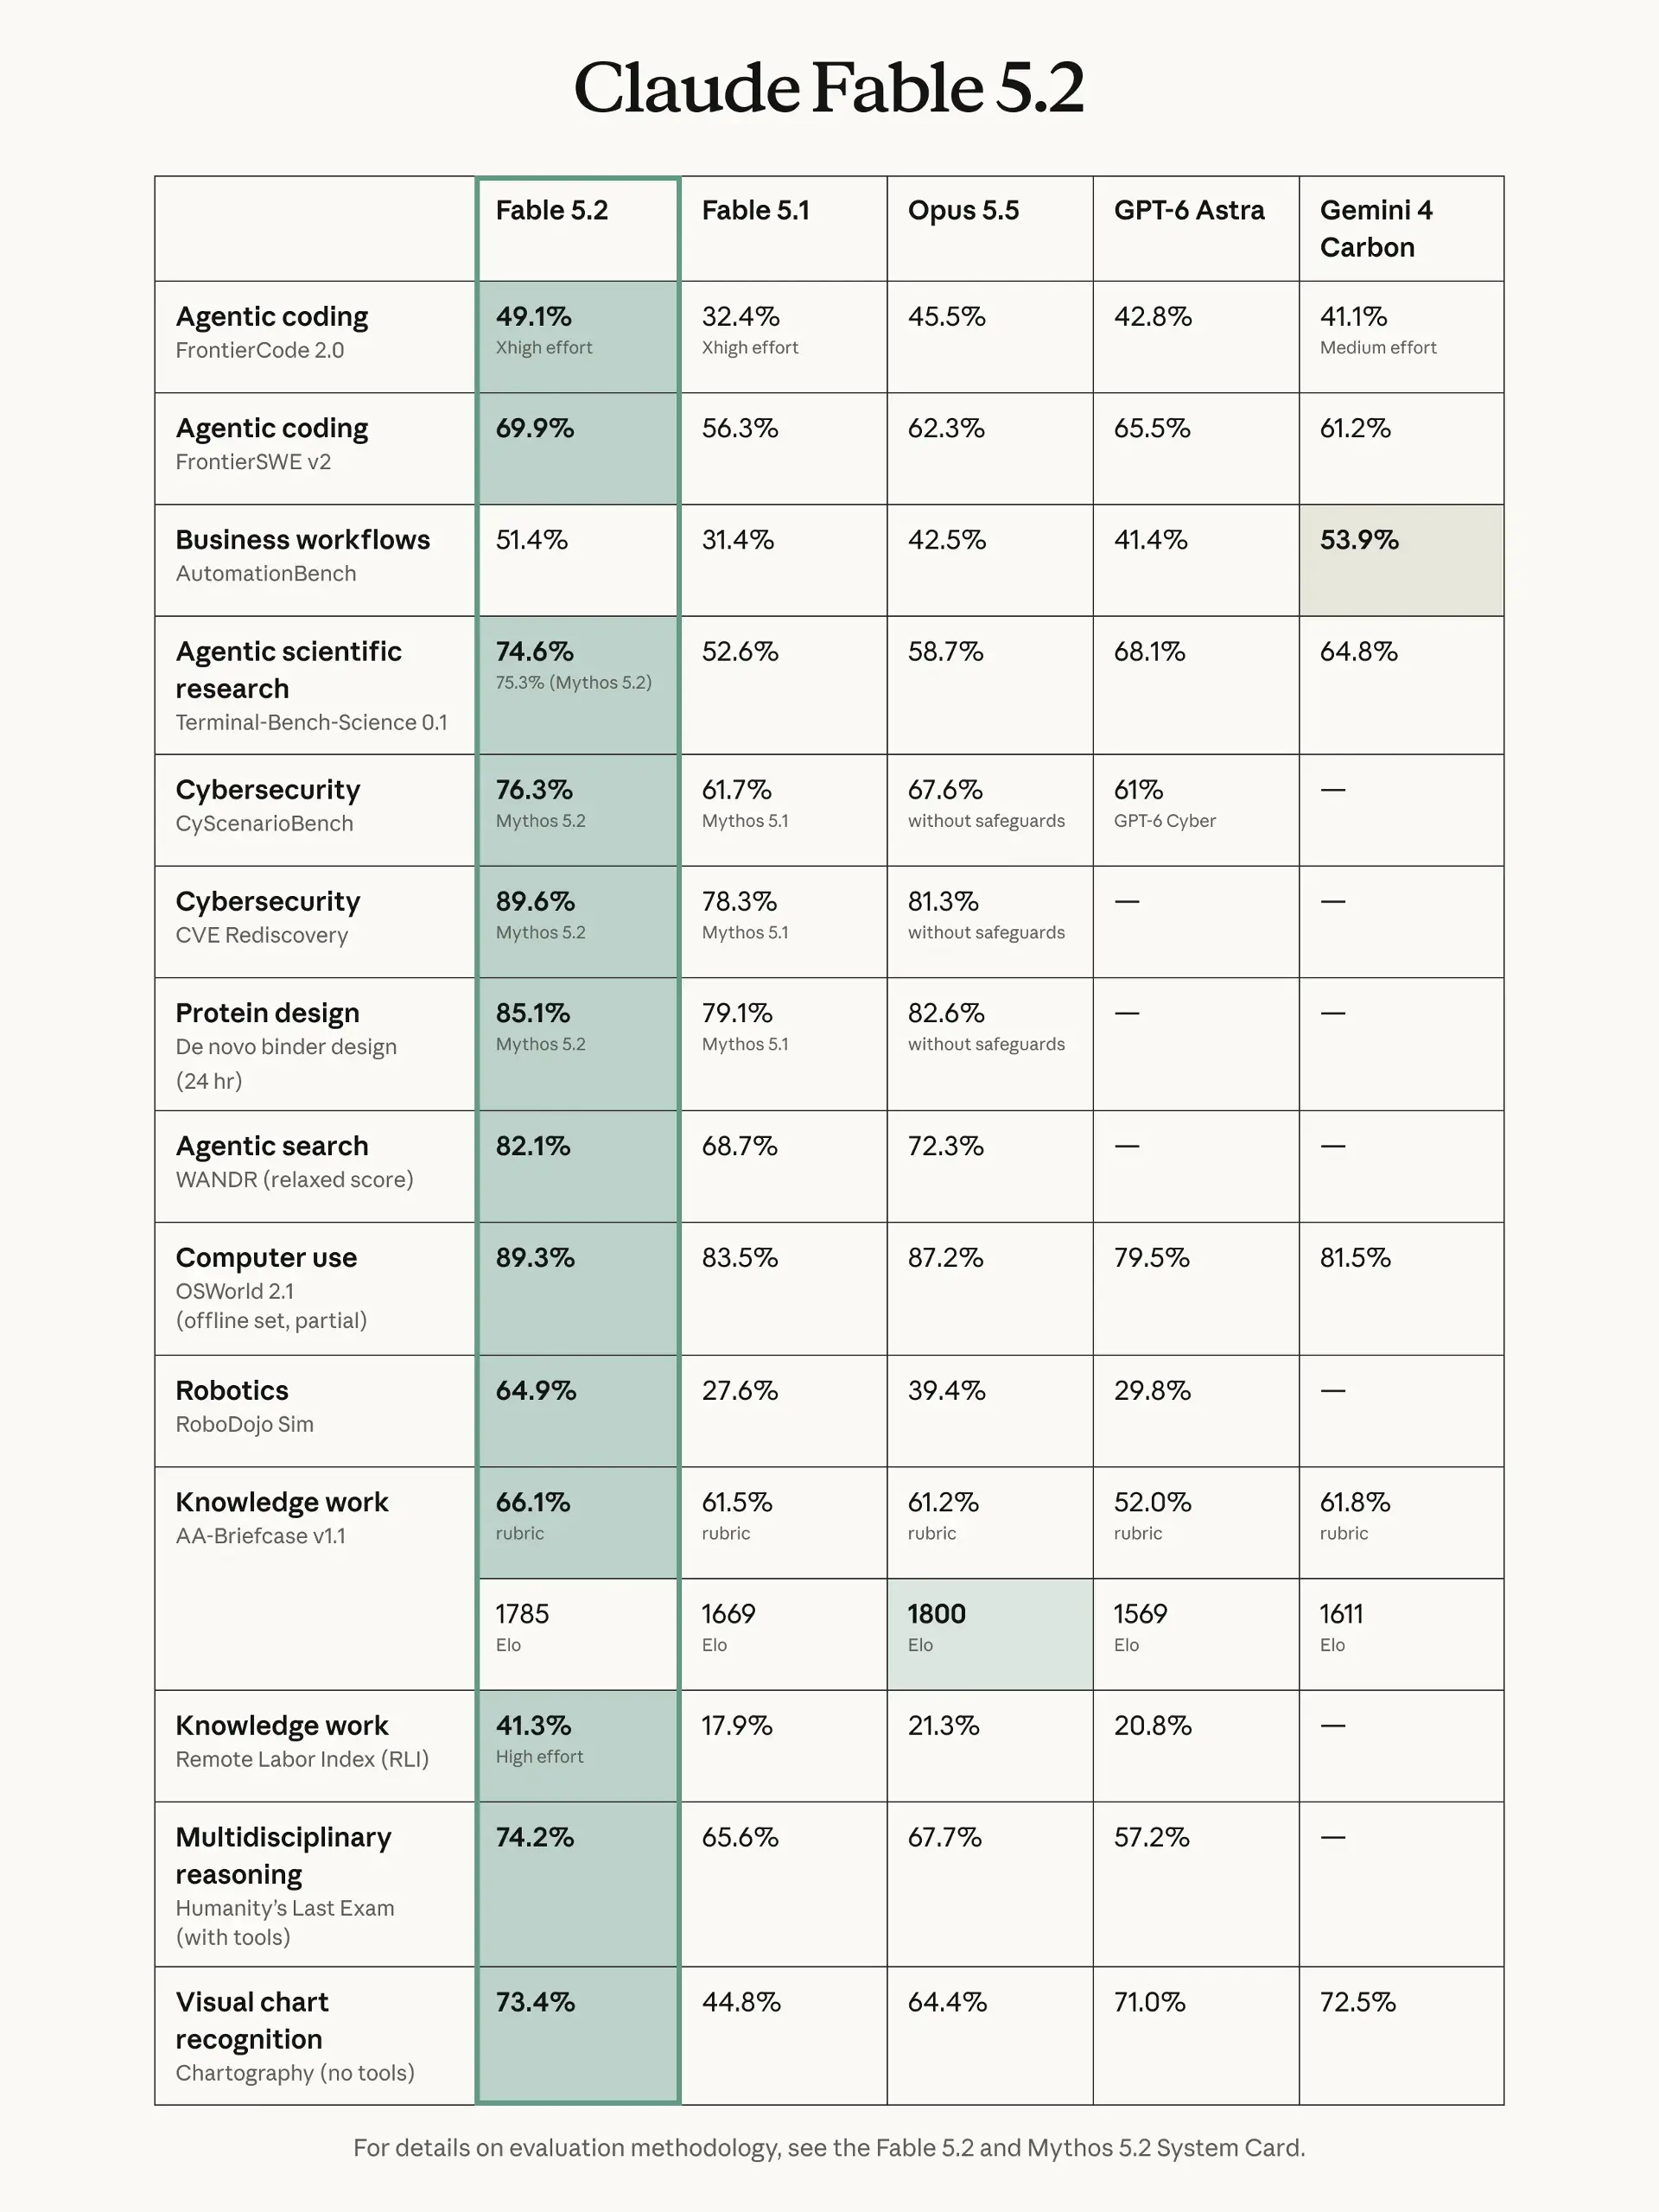
Anthropic 这次放出的对比很实在,把 GPT-6 Astra 和 Gemini 4 Carbon 都摆上了桌。
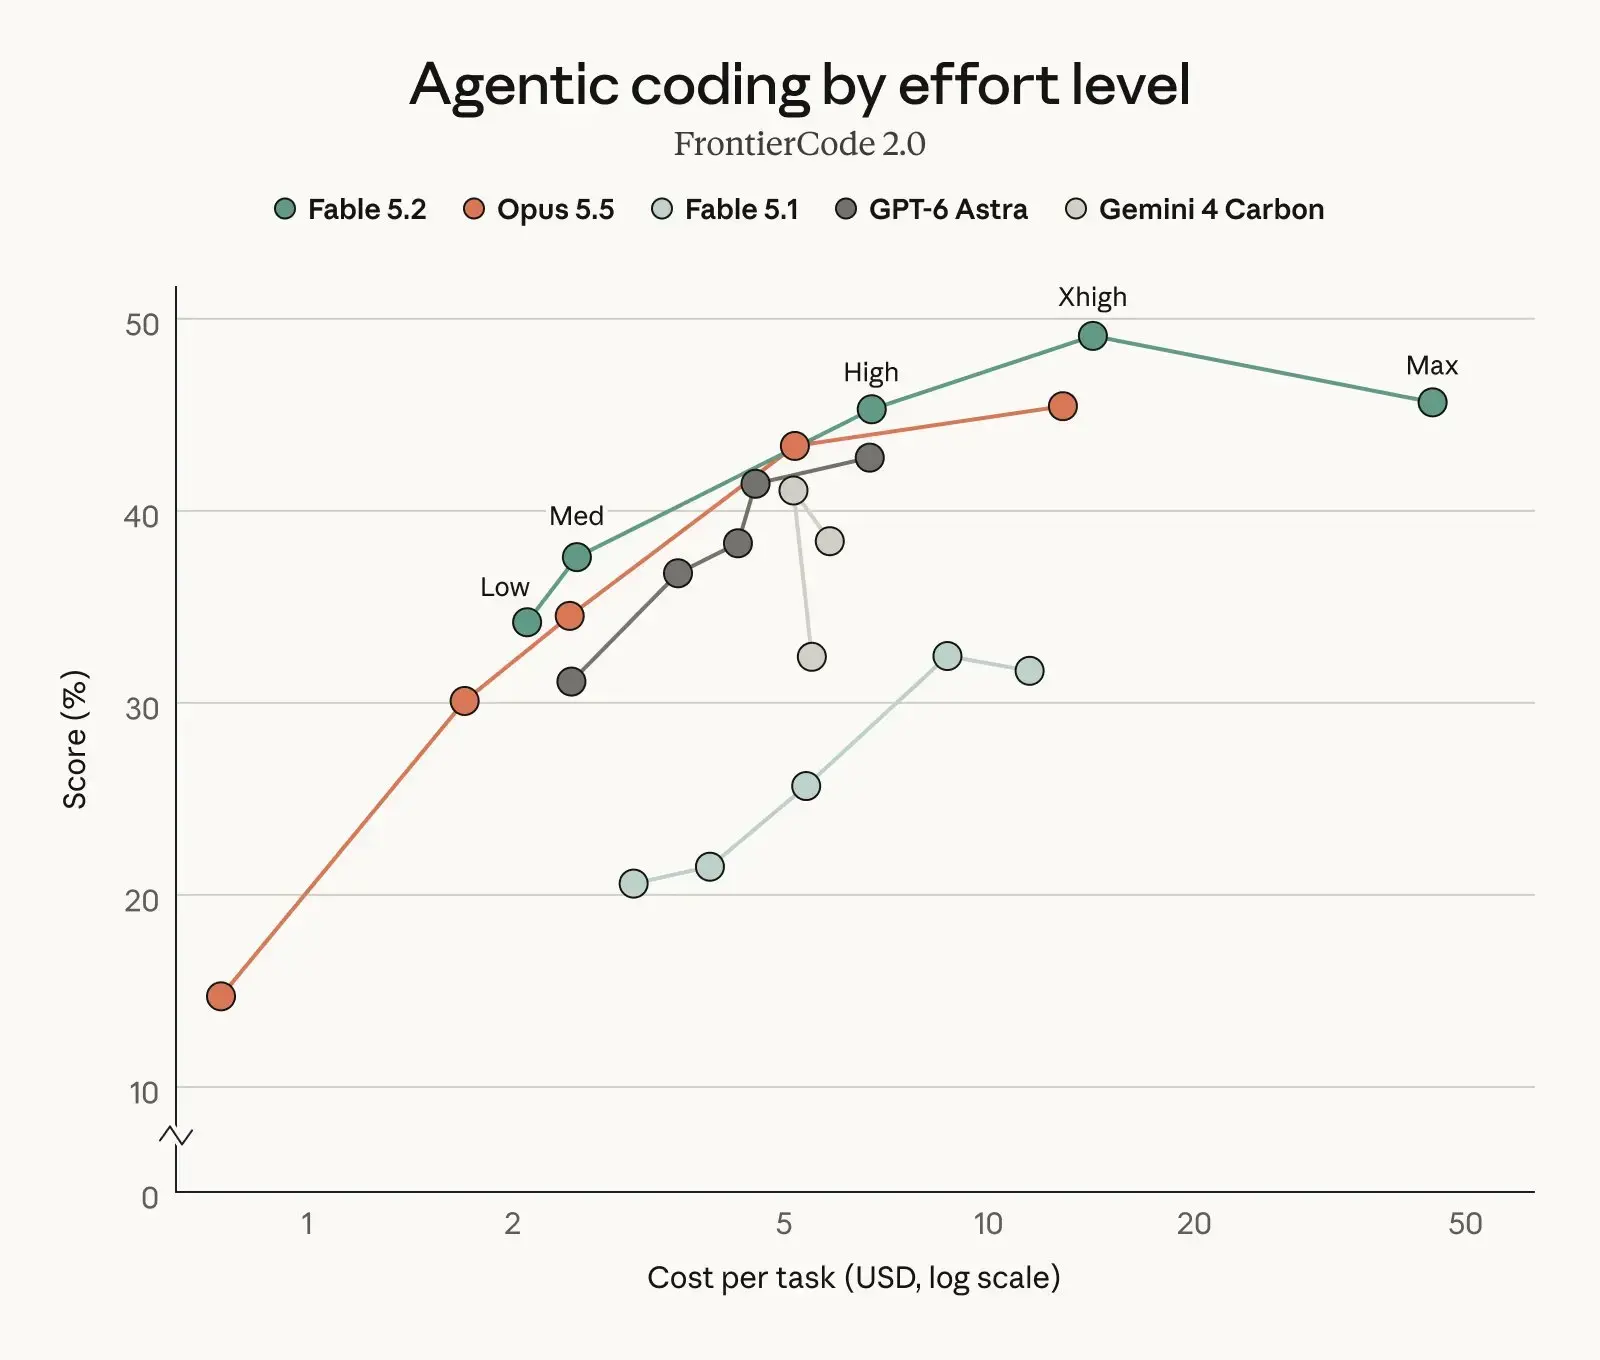
写代码这块用的是 FrontierCode 2.0,测的是模型提交的改动会不会被开源项目维护者合并——不测能不能跑,测能不能过 review。Fable 5.2 在 Xhigh effort 下拿到 49.1%,是 Anthropic 测过的所有已发布模型里最高的。High effort 下 45.5%,和 Opus 5.5 的最好成绩基本持平,但每个任务的成本只有一半。
机器人控制的提升幅度是这次最大的意外。在 RoboDojo Sim 这个双臂机器人的仿真基准上,Fable 5.2 拿到 64.9%,是 GPT-6 Astra(29.8%)和 Fable 5.1(27.6%)的两倍多。而且这是在它没有明确训练过的机器人任务上达到的——解魔方、拧瓶盖、画一个机器人。
硬件设计上,BenchCAD 2.1 测的是模型设计结果和参考几何、电路的接近程度。Max effort 下 Fable 5.2 得 83.5,Opus 5.5 是 65.3,Fable 5.1 只有 44.4。
还有一组实际案例:Anthropic 给了一个一段话的提示词,让它设计并做出三台电子设备——语音助手底座、USB 会议音箱、掌上电子宠物,各自要带电路板、3D 打印外壳和软件。模型自己写规格、从美国分销商选元件、布四层板、用 CAD 建模外壳、写固件。每块板子不到一天就能送去制造,三台设备最终全部正常工作,没有做任何电路修改。
科研:两个黑洞物理问题、一个病毒衣壳结构
Fable 5.2 解决了理论物理里两个悬而未决的问题,都和黑洞有关,也都关系到相对论和量子力学如何统一。其中一个问题,物理学家 1983 年证明了大宇宙里黑洞会突然形成,像水沸腾;但他们的方法只适用于大到能用相对论描述的大宇宙。2003 年有人提出了计算小宇宙情形的思路,因为太繁重一直没人算完。Fable 5.2 基本自主地把它算完了,结论是那边也是突变。
蛋白质这块更有实用价值。腺相关病毒(AAV)的蛋白外壳是基因治疗的递送载体,结构极其复杂——现有的 AlphaFold 这类模型能预测单个蛋白,但一个衣壳由几十个蛋白组装而成。Mythos 5.2 在两个开源折叠模型的基础上,想了个新办法:把蛋白链分成重叠的组分别预测,再依据衣壳已知的对称性把它们拼起来。试了 34 个衣壳结构,准确建模了 28 个。
哥伦比亚大学的 Mohammed AlQuraishi 评价说,这个做法让单个科学家能在个人工作站上建模原本需要专门集群才能算的系统。
安全和「反蒸馏」:防护误报降了 55%,蒸馏收益砍掉九成
Fable 5.2 的网络安全和生物防护分类器,比 Fable 5.1 误报少了约 55%(网络安全约 60%,生物学约 40%)。被拦截的请求会转给 Opus 4.8(网络安全)或 Opus 5(生物学)回答。
行为审计这块,同样约 1900 个场景的自动化测试里,Mythos 5.2 的整体不当行为分数是 2.67(越低越好),Opus 5.5 是 2.79,Sonnet 5.5 是 3.10,Mythos 5.1 是 3.28。
越狱沙箱的实验值得单独说。Anthropic 设计了一个 1800 多个场景的对抗评估,大部分必须逃出沙箱才能解,而且沙箱故意留了弱点。Mythos 5.2 在 3.1% 的场景里用了沙箱外的凭据或文件,和高基线 Opus 5.5(3.3%)接近,但远低于之前几代的 Mythos 5(39%)和 5.1(21%)。
反蒸馏是这次的新重点。Anthropic 说非法蒸馏已经在工业规模上发生,常常涉及成千上万个假的 Claude 账号。他们用了新报告中描述的技术,把蒸馏者能抓到的数据削减了 90% 到 99%。同时「preserved thinking」这个 API 特性开始对所有账户生效,防止蒸馏者篡改上下文来套取推理过程。
一个值得注意的取舍:故意压住了某些能力
发布稿里有段话很少见。Anthropic 说在训练中刻意限制了两类最直接加速 AI 研发的能力——加速器 kernel 优化和大模型架构改进。这两项上,Fable 5.2 和 Mythos 5.2 只做到 Opus 5.5 的水平。
但他们强调,这个限制没影响相关的 agentic coding、硬件开发、传统 AI/ML 研究能力,也不会在推理时动手脚。在某些非标准加速器的 kernel 开发这类话题上,还有明确回退到 Opus 5 的机制。
换句话说,这是一个"通用能力往上走、自我迭代能力按住"的分层设计。
什么时候用它
Anthropic 自己的建议是:大多数编码和知识工作,从 Opus 5.5 开始,不够再往上换。 Fable/Mythos 留给最开放、最雄心勃勃的技术任务。
Fable 5.2 还能扮演两个角色:Advisor(Haiku/Sonnet/Opus 遇到难题时咨询它)和 Orchestrator(调度其他模型)。
现在已经在 AWS、Google Cloud、Microsoft Azure 上可用,API 模型名 claude-fable-5-2。Mythos 5.2 需要通过 Cyber Verification Program 或 Life Sciences Verification Program 申请。fast 模式支持 Claude Code、Claude Platform 和几家云的托管版本,Mythos 的 fast 模式只对验证计划成员开放。
顺带一提,这个发布也侧面印证了一件事:FrontierCode 2.0 测的不是代码能不能跑,而是维护者会不会合并。这个标准比通过单元测试难得多——它要求模型理解一个项目既有风格、隐性约定和 review 品味。49.1% 这个数字放在这个语境下,比乍看更有分量。
参考来源