Mistral 把 Mistral Large 4(内部代号 Le Chonk)的权重开源出来了:1 万亿参数、原生多模态、开源权重里编码能力最强。这是到目前为止开放权重阵营里体量最大的一批模型,而且是从零开始在欧洲的基础设施上进行训练。
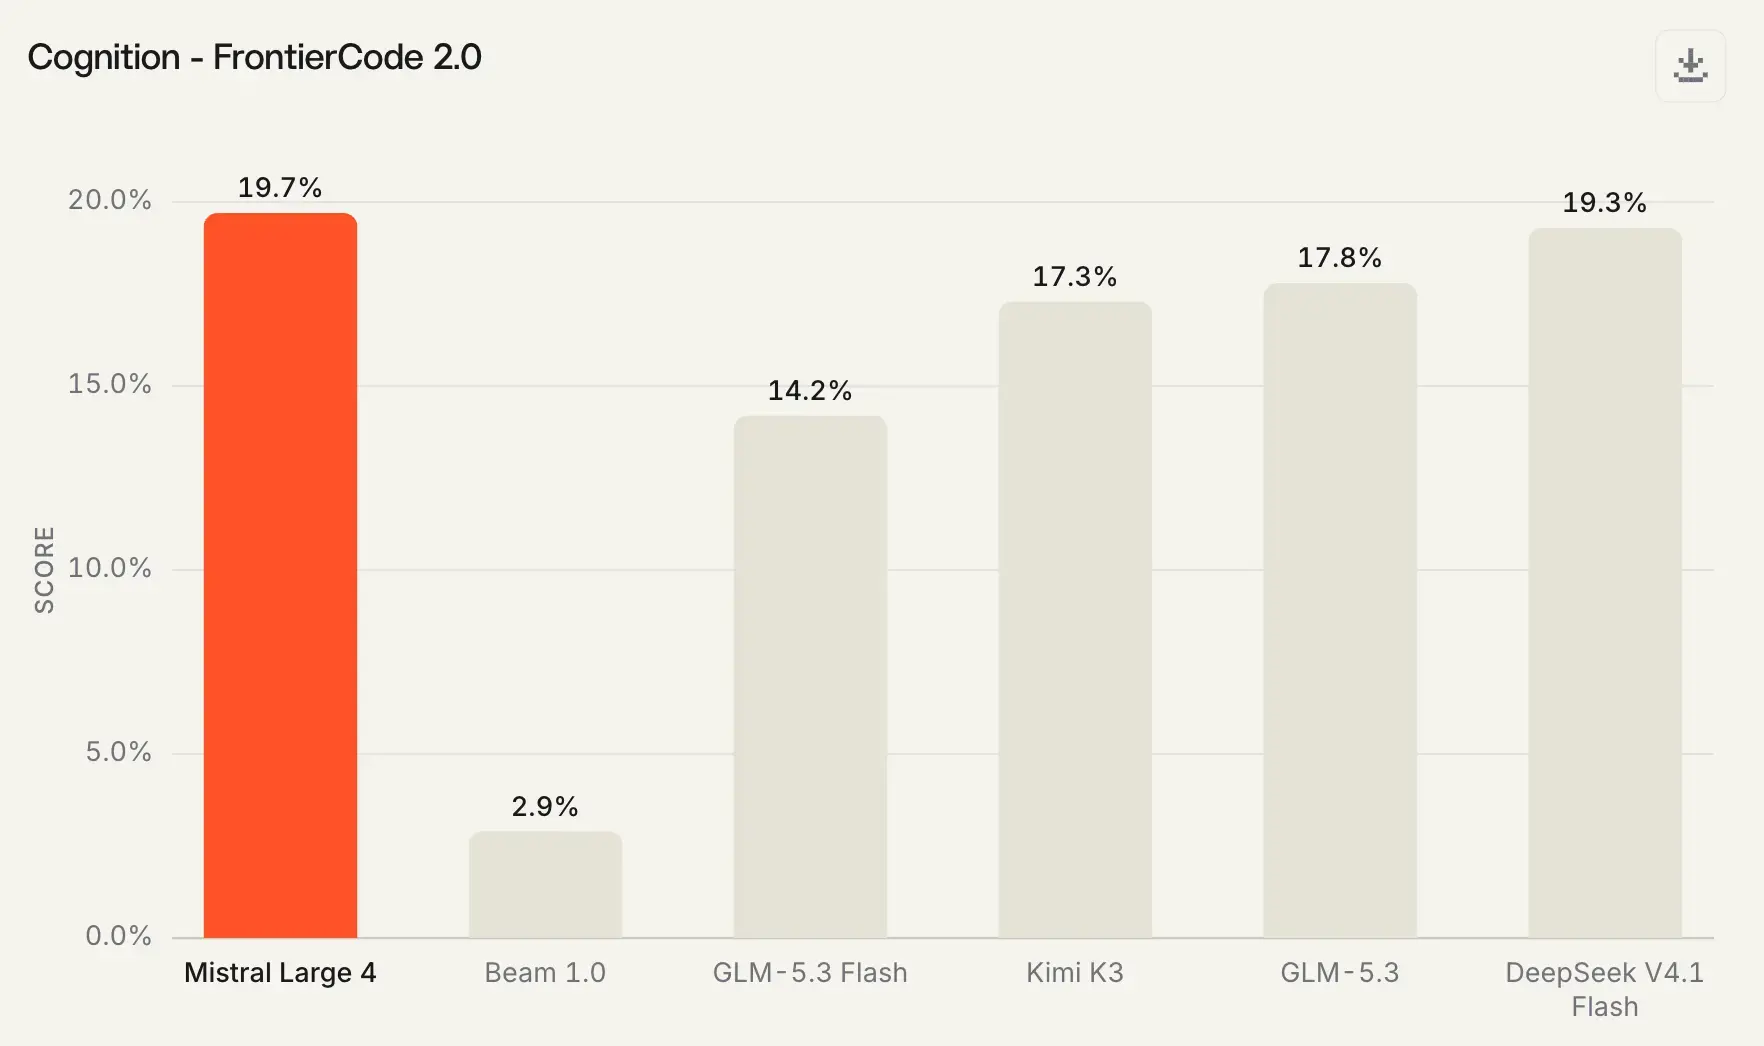
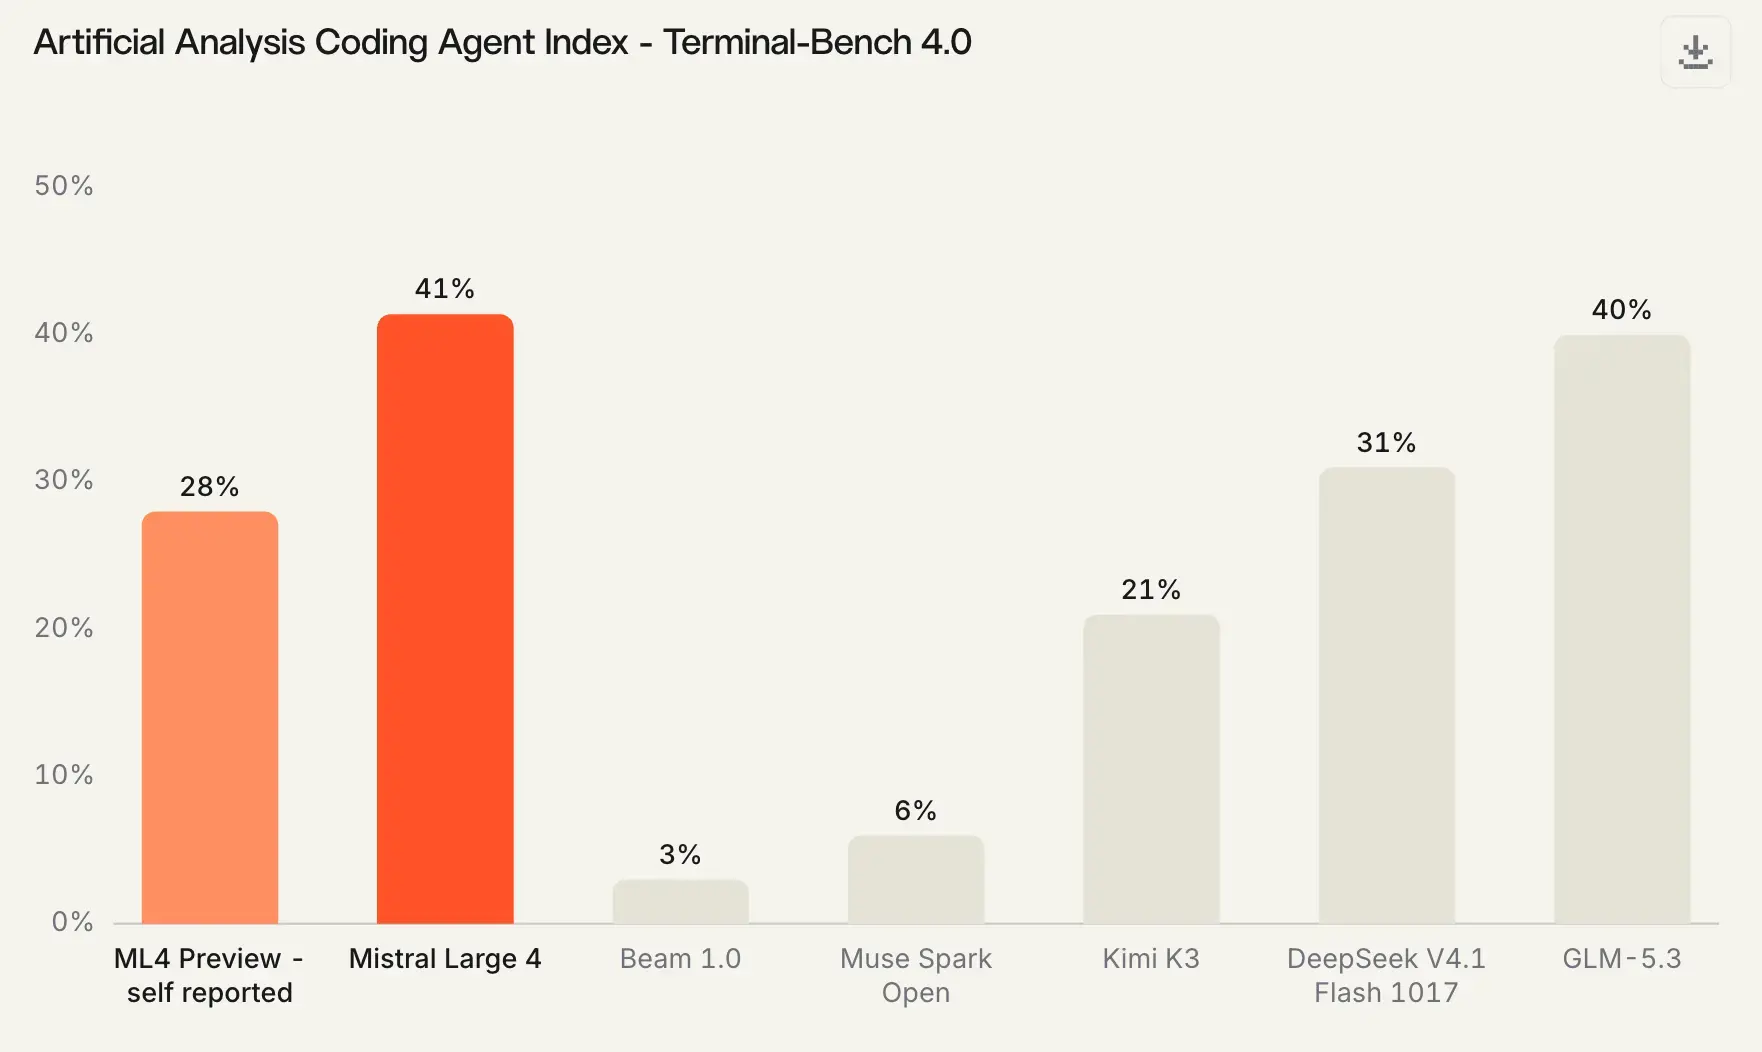
先看它凭什么说自己是第一。Cognition 的私有基准 FrontierCode 2.0 测的是端到端代码质量和"仓库维护者会不会合并这个改动",Mistral Large 4 拿 19.7%,比其他开源权重模型都高。Artificial Analysis 的 Coding Agent Index 上它 48%,和领先的 GLM-5.3 基本打平——但平均每个任务少用 47% 的 token。Terminal-Bench 4.0 上从预览版提升 13 个百分点到 41%,开源权重里领先,同时输出 token 少了 30%。
这三个数字放在一起才是重点:不是单纯刷分,而是在同等分数下把成本压下来了。Anthropic 那边刚用 Opus 5.5 演示过同样的路子——缓存成本才是账单大头,token 效率比跑分更能决定实际花多少钱。
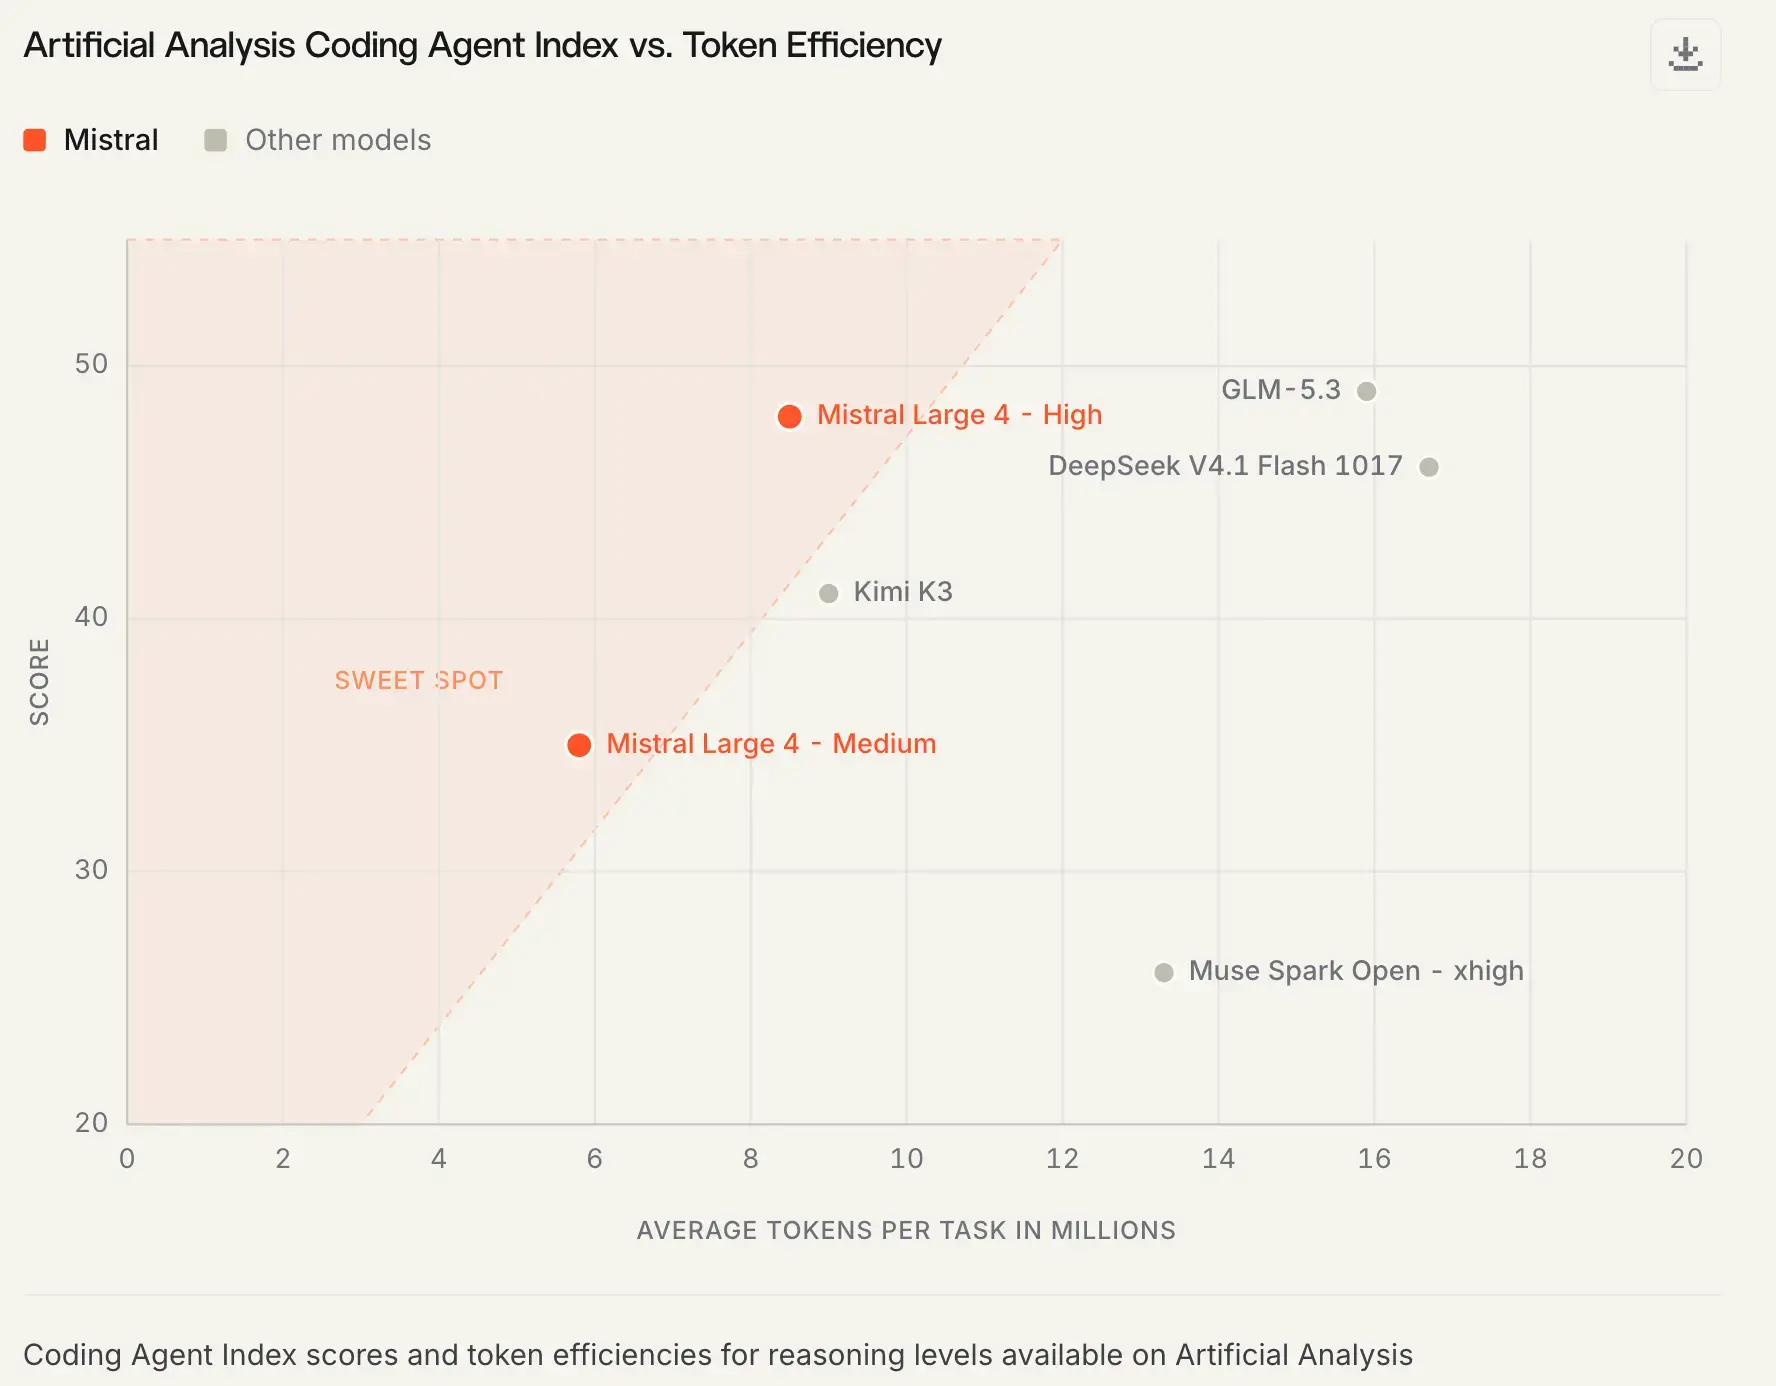
推理效率的提升来自把 RL 又续了三周。官方说法是"收益还在加速,看不到饱和迹象"。为了让开发者自己权衡性能与成本,模型给了三档推理模式:简单任务、中等、以及需要高精度彻底推理的最难场景。
安全这块是它的另一个主打,而且做得很具体。Artificial Analysis Cyber Index 上 51%,测的是在代码库里发现漏洞、复现验证、再打补丁且不破坏既有功能。Mistral 特意强调:做这些正当防御任务时不会做多余的拒绝。对比数据也给了——在 JailbreakBench、StrongREJECT、AgentHarm 这些越狱类提示上的平均拒绝率 96.6%,比预览版的 95% 还高。
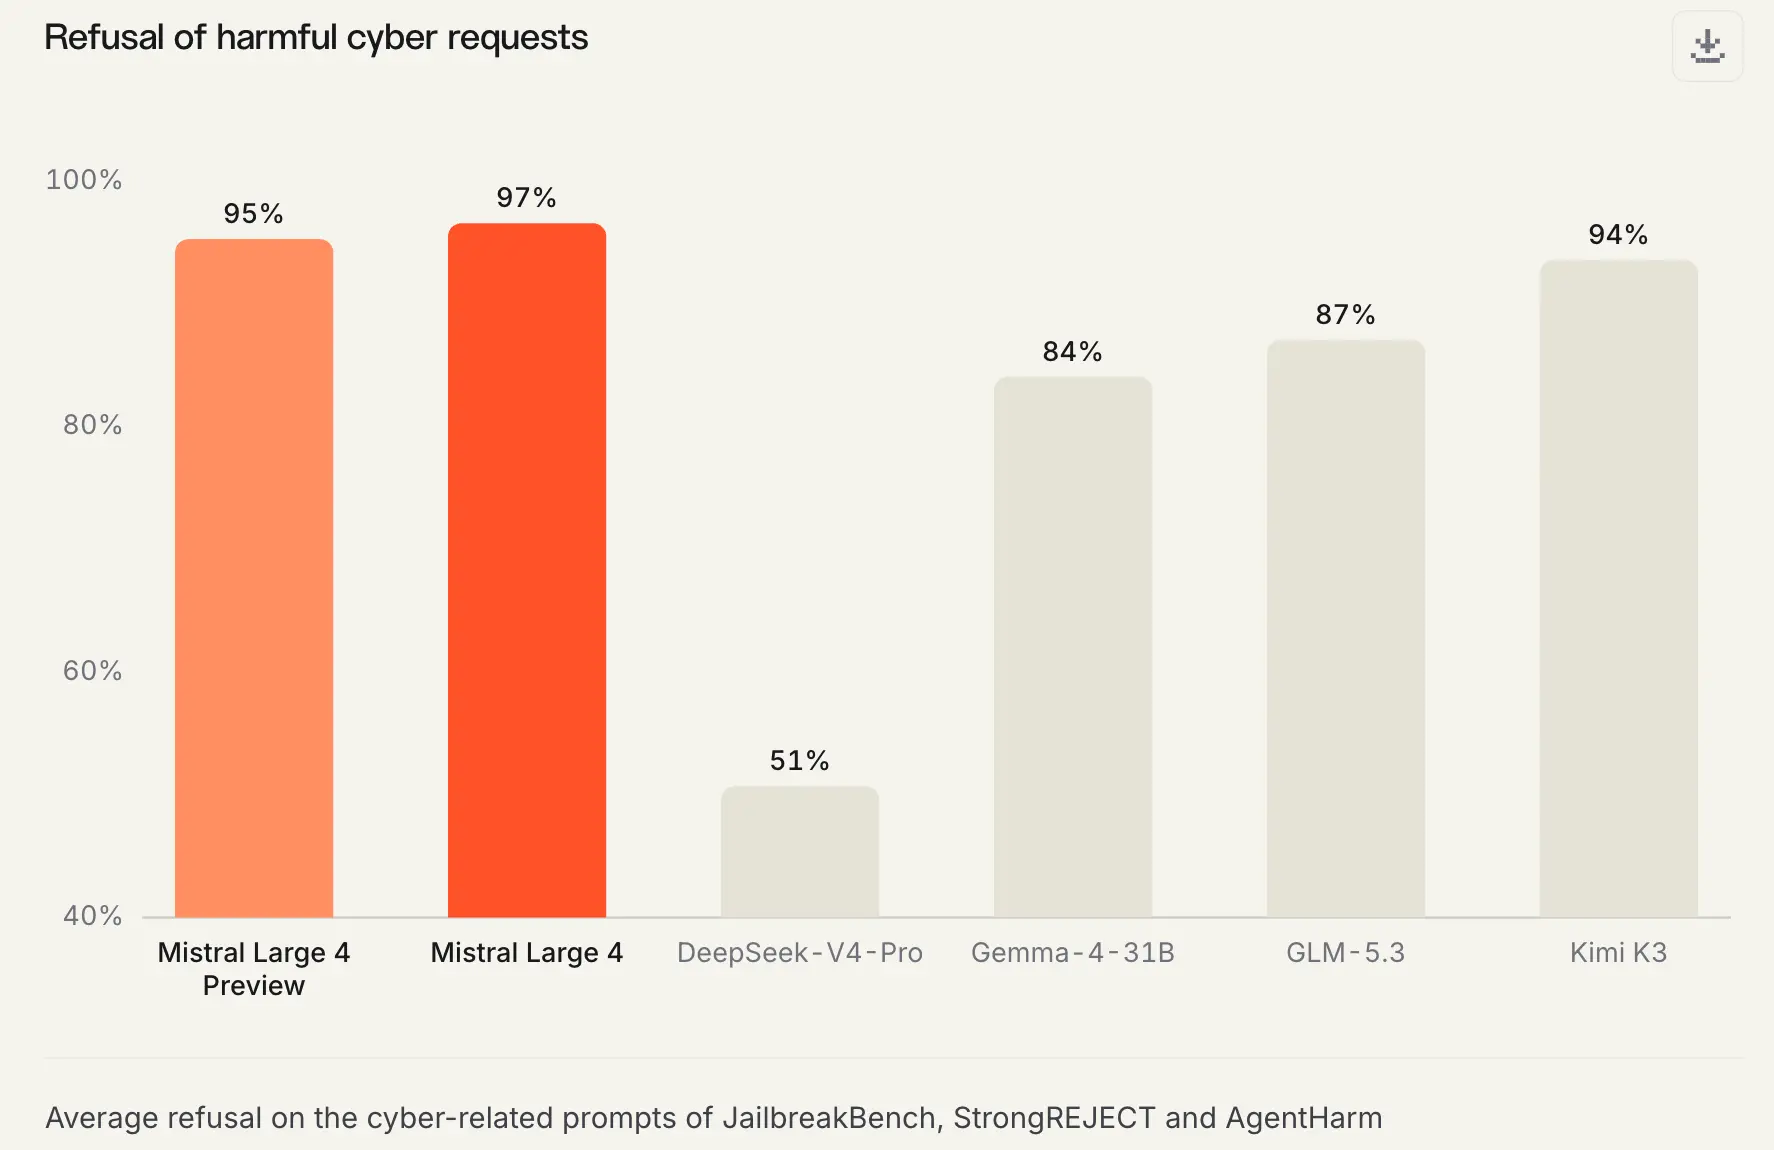
有意思的是这背后的取舍写得挺坦诚:"我们观察到模型会拒绝针对线上目标的黑盒攻击,但也看到了被用来发起真实攻击的潜在风险。我们正在相应修改护栏。"同时他们给 Orange Cyberdefense 这类企业设计伙伴开了专门版本的预览权限——针对渗透测试、漏洞评估、红队优化的变体,但需要严格审查和合同约束,测试仅限自有或明确授权的环境。
背书阵容很说明这条产品线的战略定位:Booz Allen、Cisco、Cloudflare、CrowdStrike、Elastic、ENISA、Fortinet、NVIDIA、Orange Cyberdefense、Rubrik、Zscaler——几乎全是网络安全和主权云方向的。他们说得很直白:开放权重的安全模型能让企业把模型跑在自己控制的基础设施上,也让研究者能审视模型行为、包括它会怎么被滥用。
其他榜单也顺手给了:金融场景的 Finch 分数 73.3%(开源第二,仅次于 Kimi K3),网页浏览 BrowseComp 84.5%,防提示注入 97%。
许可值得单独说。用的是 Mistral Ecosystem Open-Weight license,一份改过的 MIT:可以免费使用、修改、微调、商用,只有一条限制——做模型即服务(MaaS)生意的公司,商用前必须单独找 Mistral 拿商业许可。这跟 Llama 系许可的做法类似,是想在"开放"和"不养大自己的云竞争对手"之间卡个位置。
定价 $0.70 输入 / $0.07 缓存输入 / $2.10 输出每百万 token。权重可以从 Hugging Face 下载,用 vLLM 或 SGLang 自部署;也可以用 Microsoft Foundry(首个上架的云厂商)、NVIDIA NIM 容器或 OpenRouter。
最后留意一点:官方说 Mistral Large 4 会成为下一代专用模型的基础,完整技术报告随后发布——按经验,这类报告的细节才真正能验证那些效率数字。
参考来源