AI 生成内容越来越难以识别,但并未阻止维基百科对此进行清理。
2023 年 12 月,几个维基编辑在 Discord 上聊天,发现彼此都见过同一类文章:满篇"作为……的见证"(stands as a testament)、"丰富的文化遗产",结尾必定带个结论段,或者干脆来一节叫"这为什么重要"。这是 2023 到 2024 年初 ChatGPT 的招牌文风,在维基百科里出现得极其反常——也正因为反常,好认得出奇。Ellia Lebleu 那时候决定建一个正式项目来处理它,WikiProject AI Cleanup 就这么来了。

现在不好认了。Lebleu 在 IEEE Spectrum 的访谈里说,到了 2025 年,AI 写作的痕迹从显眼的陈词滥调变成了更隐蔽的结构特征:偏爱"三段式"(rule of three)、消极平行结构("不是 X,而是 Y")这类句式。单独一条不足以定罪,累积起来才有意义。他们还会看文章之外的行为证据——一个人五分钟内产出五篇各几千字的文章,基本可以怀疑是模型代笔。
比文风更麻烦的是引用。Lebleu 说伪造或误导性引用已经是最大的担忧之一。早期 AI 会凭空捏造一条完全不存在的引用,随着 RAG 让模型能找到真实来源,纯幻觉少了很多;但更常见也更阴险的情况是:引用是真的,内容却被写错了——来源确实存在,却根本不支持文中的论断。她说这种"引用存在但论证不成立"的情况极其普遍。
那到底还有多少 AI 内容在流进来?Lebleu 和 AI 检测公司 Pangram 合作估算。她先拿 ChatGPT 出现之前的维基内容做校准,发现 Pangram 零误报,所以那个数字是"非常保守的下界"。结果是:2025 年底约 20% 的新文章和草稿被判为 AI 生成,到 2026 年初降到 15% 到 16%。但她补了一句很诚实的话——现在说不清这是禁令起效了,还是模型变强、检测器没跟上,两种解释都成立。
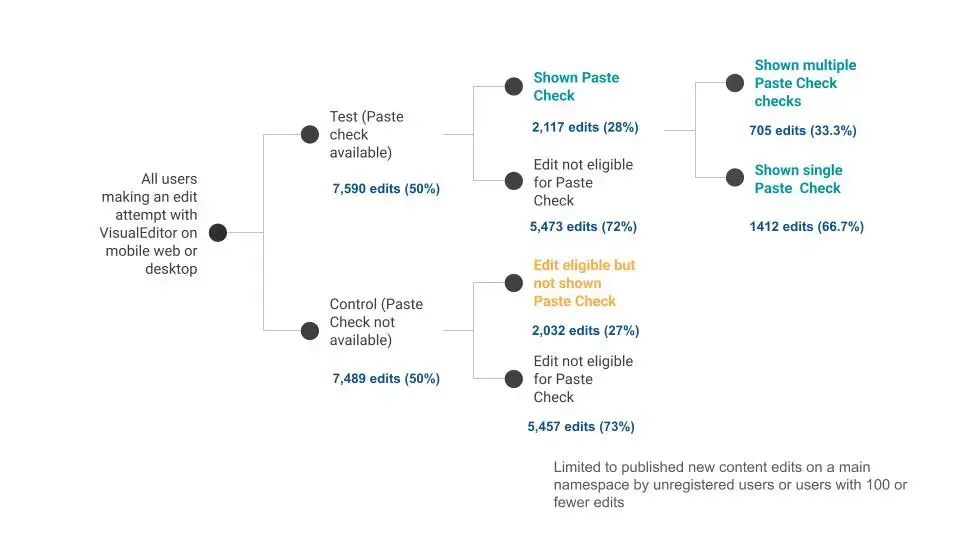
维基百科也在用 AI 对付 AI。项目里另一位编辑做了个 AI 引用核验器,逐页扫描条目里的来源,核查它们是否真支持对应论断。它本身就是模型,不能保证每次判对,但用来在规模化场景里过滤明显问题是个不错的起点。维基媒体基金会则在开发 Paste Check,能标记直接从某些 AI 聊天机器人粘过来的文本。
2026 年 3 月起,英文维基百科的 WP:LLM 指南已经明令禁止用大语言模型生成或改写正文(翻译和基础文字编辑有有限豁免)。但按官方项目页的说法,2022 到 2026 年之间插进来的大量 AI 文本仍然堆在那里——这就是这个项目至今还在运转的原因。
模型端的拒答也在起作用。Lebleu 观察到 Claude 有时会直接回"我不能写维基百科条目,这违反维基百科的政策"。她认为如果主流 AI 公司都实现这类提示词拒答,帮助会很大——但她也清楚边界在哪:开源权重模型仍能被改掉限制绕过去,真正受益的是那些用商业模型、又不太懂技术的普通用户。
参考来源