谷歌旗下 AI 公司 DeepMind 宣布推出 Genie 4,世界模型这条线又往前走了一格。最实质的进步不是画质,是声音——Genie 4 是原生多模态的,画面、音乐、环境声、对话可以同时生成。你在模拟里推倒一块石头,它不只是画出来,还会响。
技术上它基于 Gemini 家族:Gemini Omni 负责让模拟锚定真实世界的样貌和物理行为,其它 Gemini 模型提供维持场景连贯性所需的推理。你设一个事件,Genie 4 就往下推演——世界怎么反应、听起来什么样、里面的人怎么移动、反应和说话。官方演示里,一个中年人在湖心浮台上吹萨克斯,风、水声、乐器的呼吸起伏都是模型自己生成的,没有贴音轨。
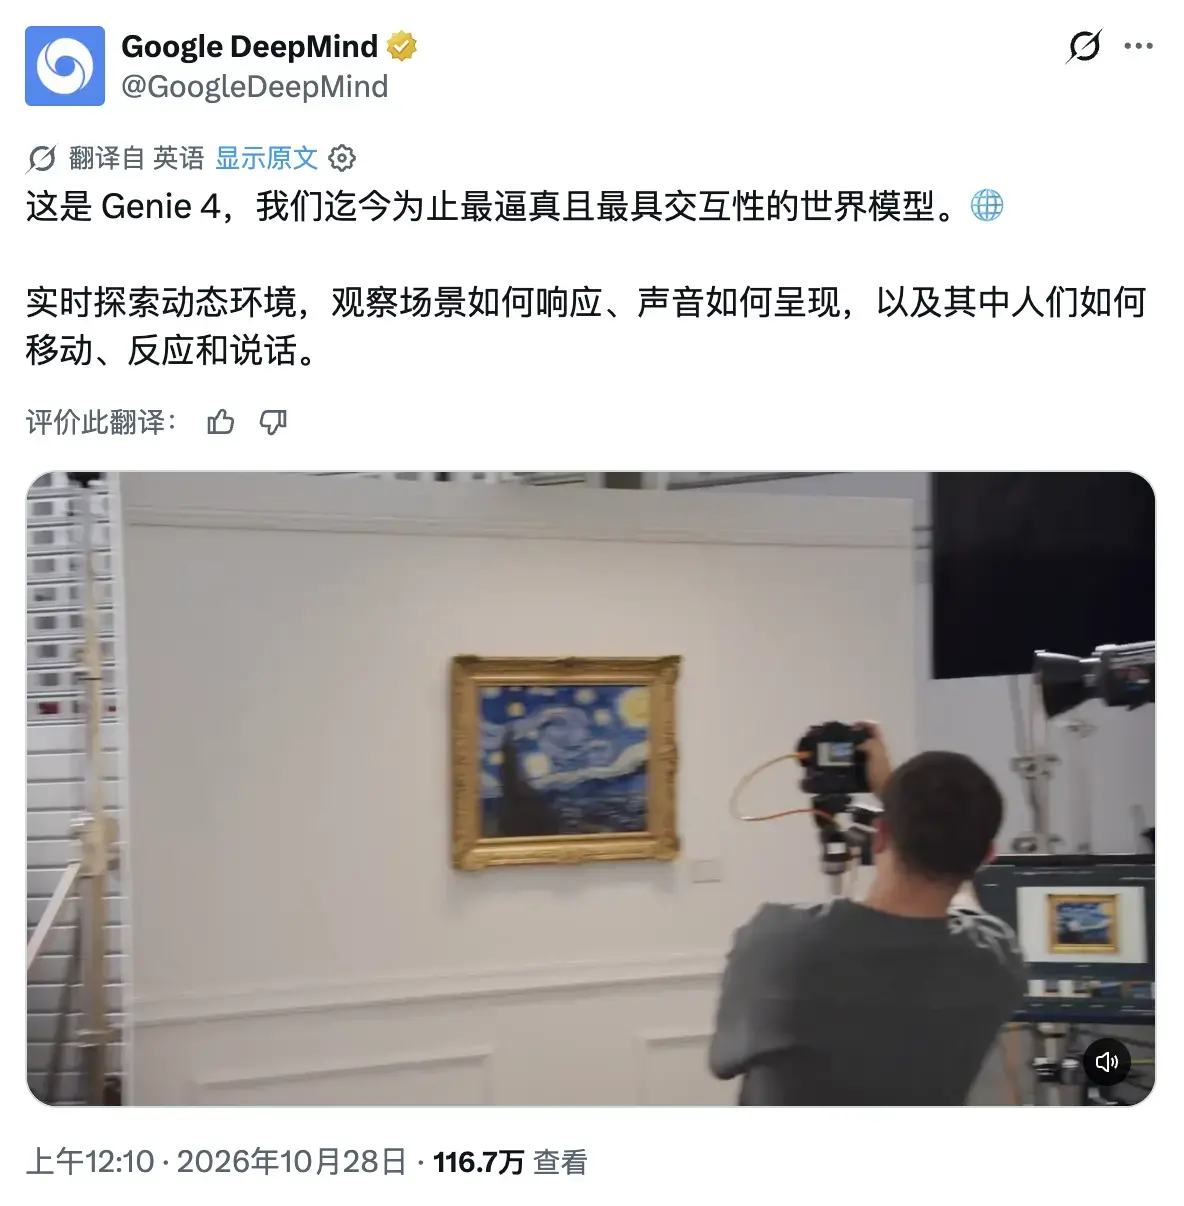
交互方式也变了。以前生个世界出来只能看,现在能用自然语言实时改——换天气、移镜头、塞进一个新的人或物,Gemini 会把你的指令按上下文适配到当前场景里。你不操作的间隙,它还会自己盯着场景往前走,不让世界停下来。用户用键盘控制镜头移动,用文本 prompt 引导剧情。
DeepMind 把它放在 AGI 的语境里说:"理解和模拟世界是构建 AGI 的关键一环。"落地的用法是两个方向:给机器人、给 agent 造训练环境,以及做交互式内容。
Genie 4现在处于研究预览阶段,先给受信任的测试者,之后从 Google AI Ultra 订阅者的 Project Genie 开始开放,再加 Gemini API 和 AI Studio 的早期合作伙伴。有个细节值得留意——所有生成的视频和音频都会带 SynthID 隐形水印。
限制也写在明面上了:Genie 4 还是早期研究,能在短会话内维持连贯环境,但视觉细节和物体恒存性会随时间漂移,尤其是场景变复杂的时候。换句话说,它现在更像一个惊人的演示沙盒,"能用的世界模型"还差一步。
参考来源