这几天我的日常开发基本都交给了 Claude Code 里的 Sonnet 5.5:修 bug、加接口、改前端页面、跨文件重构,都是真实项目里的活。用下来最大的感受就一个字:强。
- 又快又好:响应快,写出来的代码基本一次能用,很少需要返工;
- 从不掉链子:任务交出去,它能自己一路做完,没遇到过做到一半停住、原地绕圈的情况;
- 非常抗用:高强度连着用一整天,额度依然够用,比 Kimi 抗用多了,不用一边写代码一边心疼额度。
更让我意外的是,Sonnet 5.5 在 Claude Code 里只是第三档的模型,上面还有更强的两档。
同样的活,我之前也交给过月之暗面的 Kimi K3.1 Pro 和 OpenAI 的 GPT-6.1 Sol,对比下来差距很明显。但这个结论和很多榜单并不吻合。三款模型都能在某张榜上找到自己的第一名,彼此差距也就几个百分点。问题在于,写代码不是考试:模型回得快不快、中途会不会停下来绕圈、要不要我一遍遍推它往前走,这些决定日常体验的东西,跑分一项都不统计。
这篇文章就聊两件事:榜单上到底看得出什么,以及榜单之外,三款模型真正拉开差距的地方。
一、一张表看懂:三款模型评分对比
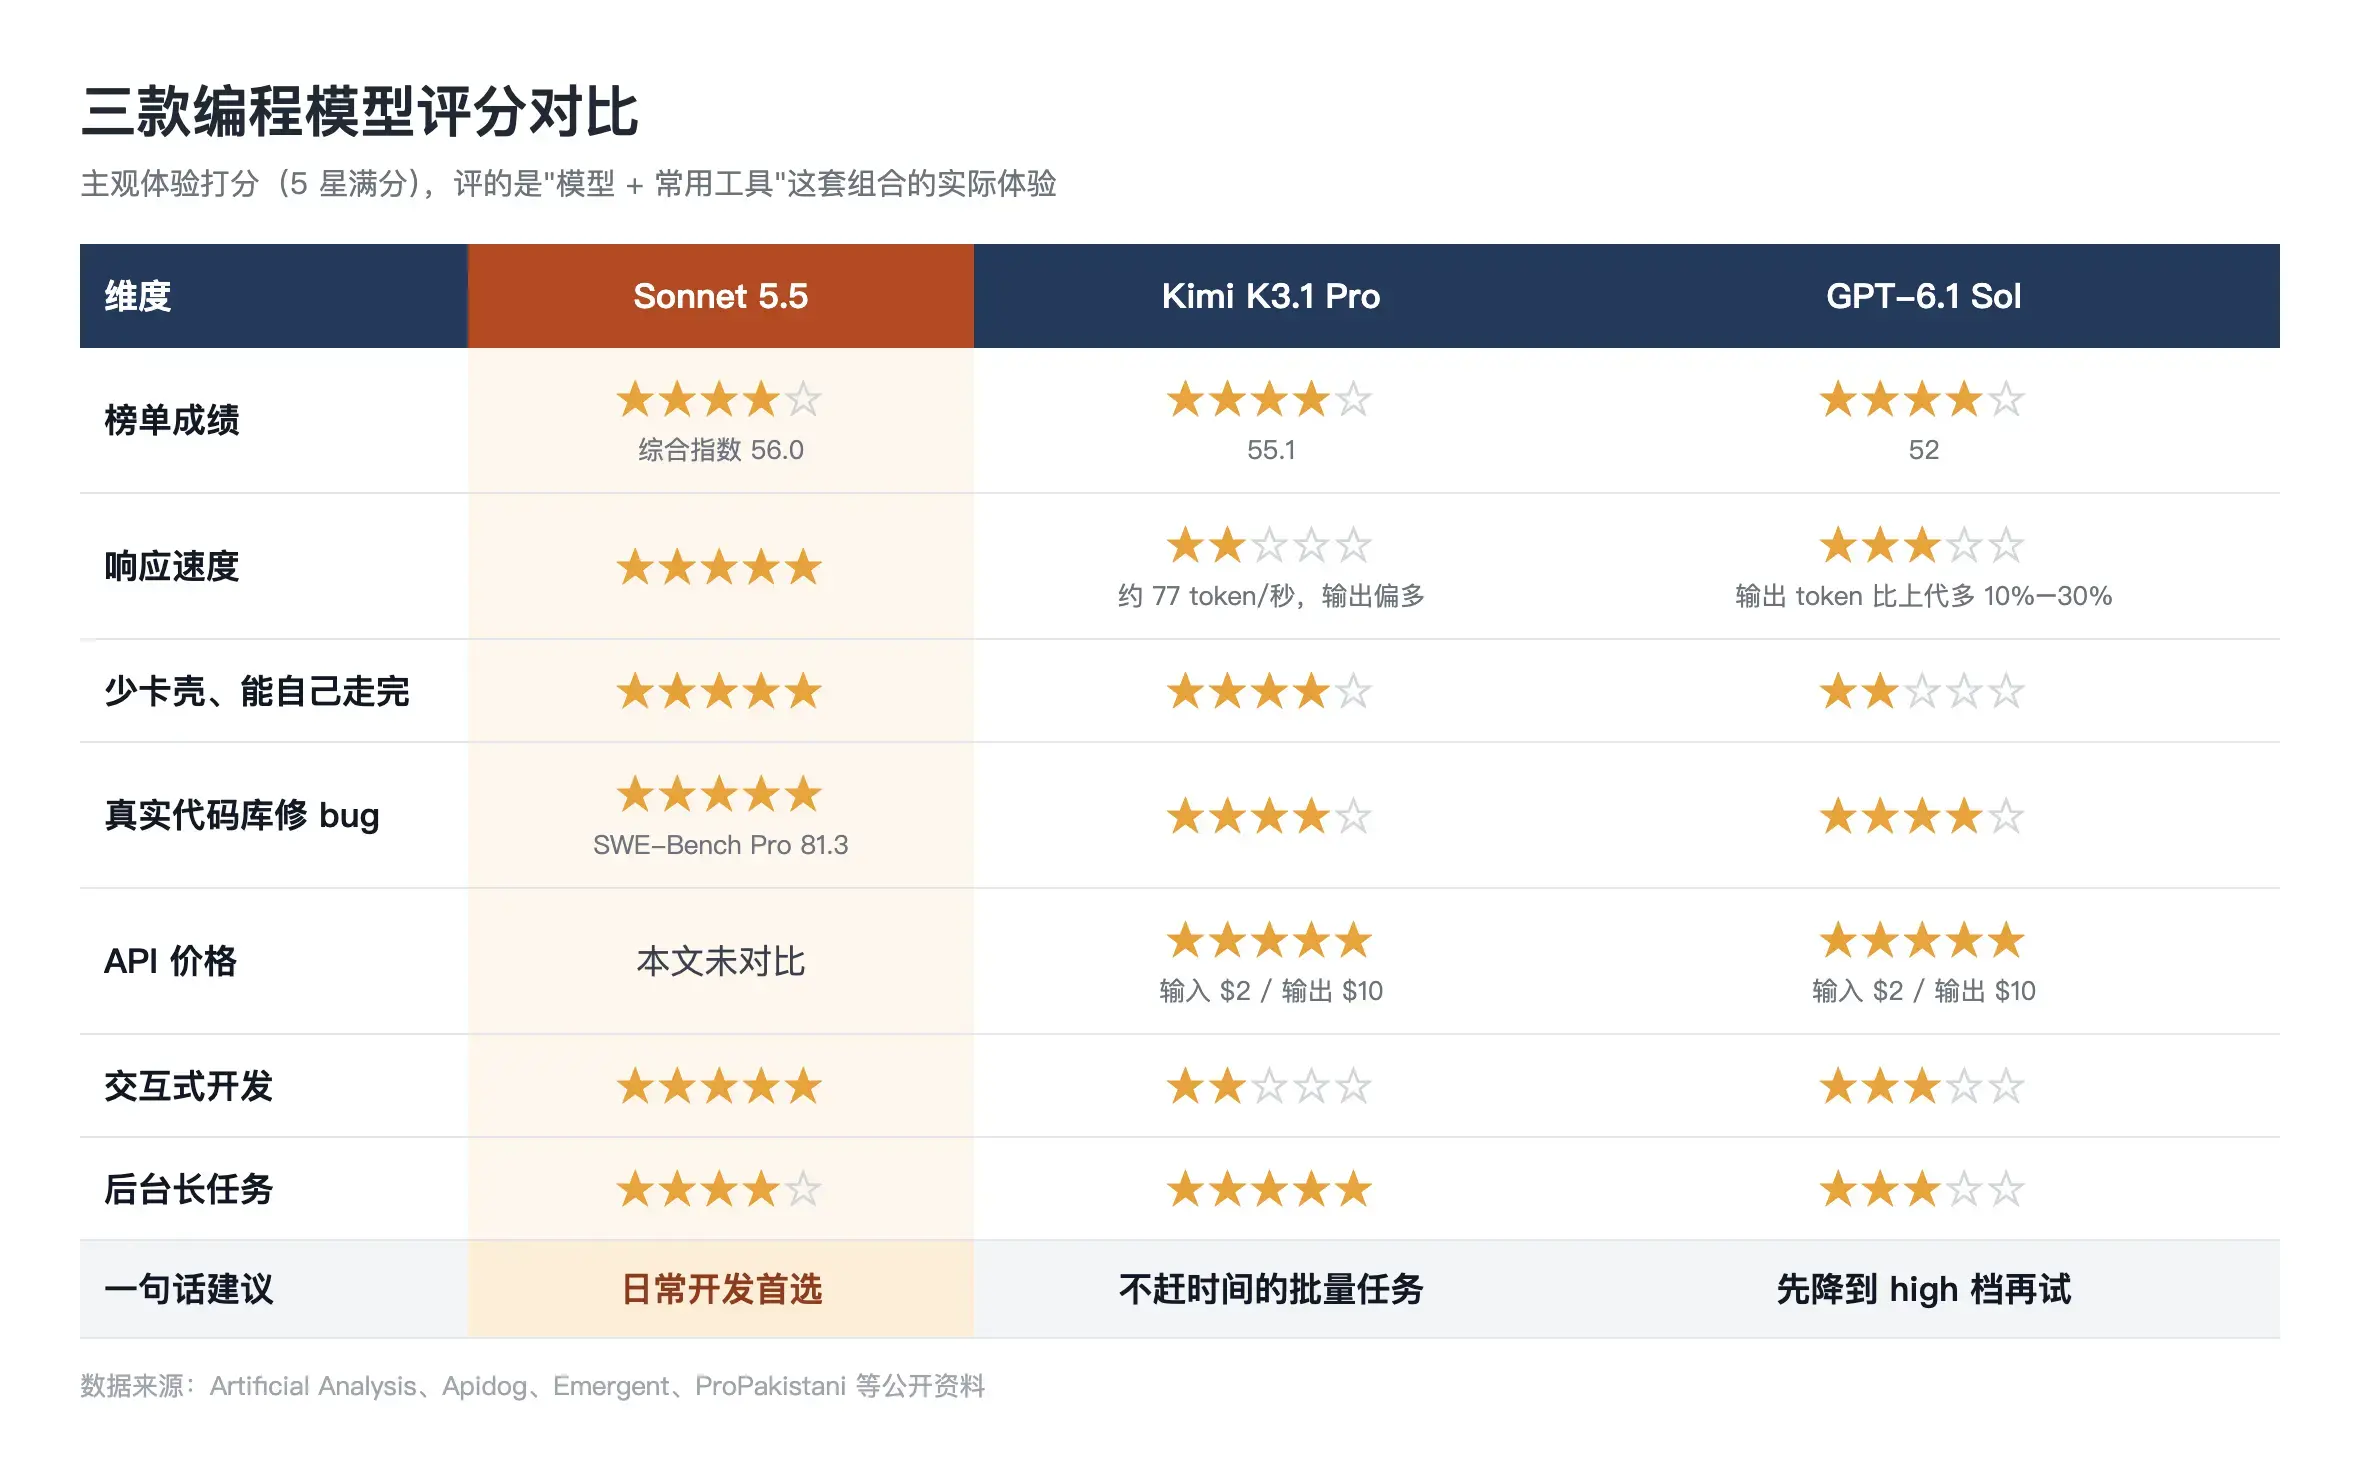
先把结论汇总成一张表,后面再逐项展开。需要说明的是,这是基于我自己项目的主观打分(5 星满分),评的是 "模型 + 我常用的工具" 这套组合的实际体验,不是严格的测评:
三款都搞不定的难题,再交给 Opus 5.5(SWE-Bench Pro 89.9)。
二、先看榜单:每家都能挑出一张对自己有利的
想横向比较三款模型,能用的公共标尺其实不多。三家都测过的,基本只有 Terminal-Bench 4.0(考察终端环境下的编程任务)。可即便是同一项测试,不同来源报出的数字也相差悬殊:
- tbench.ai 公开榜(10 月 6 日):Sonnet 5.5 61.8%,Kimi K3.1 Pro 未上榜,GPT-6.1 Sol 58.2%
- Artificial Analysis 独立测试:Sonnet 5.5 63.6%,Kimi K3.1 Pro 67.2%,GPT-6.1 Sol 无数据
- 厂商自报:Sonnet 5.5 70.6%(max 档),Kimi K3.1 Pro 65.7%,GPT-6.1 Sol 无数据
同一个 Sonnet 5.5,从 61.8% 到 70.6%,差了将近 9 个点。原因并不神秘:推理档位不同、Agent 脚手架不同、超时和重试策略不同,分数自然对不上。厂商自报的数字通常是 "最佳条件下的上限",第三方测试更接近普通用户能拿到的水平,两者混在一起比较没有意义。
再看各家主推的 "招牌成绩",会发现它们几乎不重叠:
- Sonnet 5.5 主打 SWE-Bench Pro,成绩 81.3;
- GPT-6.1 Sol 主打 DeepSWE v1.1,成绩 75.2%;
- Kimi K3.1 Pro 主打 SWE-Marathon,成绩 51.7。
三项测试题目不同、规则不同,数字之间无法直接换算。综合智力指数上,三者也挤在一起:Sonnet 5.5 为 56.0,Kimi K3.1 Pro 为 55.1,GPT-6.1 Sol 为 52。
所以单看分数,三款模型就是同一梯队,"谁更强" 取决于你翻开哪一张榜。真正拉开差距的东西,要到分数外面去找。
三、Kimi K3.1 Pro:答卷漂亮,但交卷太慢
Kimi 给我最直接的感受就是慢,而且这不只是主观印象。Artificial Analysis 测得它的输出速度大约每秒 77 个 token,低于平均水平;更麻烦的是,它完成同样的任务往往要输出更多内容。
这两点叠在一起,等待时间就不是线性增加了。简单算一笔账:一次回复如果要写 3000 个 token,按每秒 77 个算就是近 40 秒;如果因为 "话多" 实际写了 4500 个,就接近一分钟。Agent 模式下一个任务要来回几十轮,这些等待会一层层累加起来。
这个毛病上一代 K3 就有。有团队拿自家代码库做过实测:K3 的产出质量和 Opus 4.8 处于同一档次,成本只有四分之一,但平均每个任务要跑四十多分钟。
Kimi 的优势同样明显,就是便宜:API 输入每百万 token 2 美元,输出 10 美元。所以它适合什么场景也很清楚:
- 适合:批量跑的后台任务、夜间自动化、对时效不敏感的长任务,让它慢慢跑,性价比很高;
- 不适合:边写边改、频繁追问的交互式开发,等上一两分钟才回一句,节奏全被打断。
四、GPT-6.1 Sol:价格诱人,却总在半路停下
GPT-6.1 Sol 的定价和 Kimi 完全一样,输入 2 美元、输出 10 美元。OpenAI 给它的卖点是 "接近旗舰 Astra 的能力,五分之一的价格",纸面上相当有吸引力。
我实际用下来最头疼的是卡壳:任务做到一半停住,或者在同一个问题上来回绕圈子,得我反复提示 "继续"" 别改那个文件 ""按刚才的方案往下做",它才肯往前走。公开数据也能对上这种体感:它比上一代多消耗 10%–30% 的输出 token,速度明显变慢。
有一个调整值得试试。有评测发现,GPT-6.1 Sol 的编程成绩在 high 档最好,max 档反而更差。推理开得越深,越容易想太多、改太多。如果你习惯一律开最高档,不妨降一档再跑几天。
不过就算调到最合适的档位,在我的项目里它还是不如 Sonnet 顺手。
五、Sonnet 5.5:分数不是最高,干活最省心
Sonnet 5.5 在 Anthropic 的产品线里定位于 Opus 之下,主打更快、更便宜,面向的就是修 bug、小步快跑这类日常活。恰恰是这些 "不起眼" 的活,它做得最稳。
我体会最深的有三点:
- 快,而且不卡:交互式开发时,响应速度和连贯性都比另外两款好。给它一个任务,它基本能自己走完,很少需要我推着走。
- 读得懂真实代码库:它的 SWE-Bench Pro 成绩是 81.3。这项测试考的就是在真实开源仓库里定位并修复问题,和我每天做的事情最接近,也是我觉得参考价值最高的一项。
- 和工具配合默契:搭配 Claude Code 使用时,读代码、拆任务、改文件、跑命令一气呵成。实际体验里,工具链的作用一点不比模型本身小:同一个模型,接在好用的 Agent 框架上和裸调 API,完全是两种体验。这一点下一节单独展开。
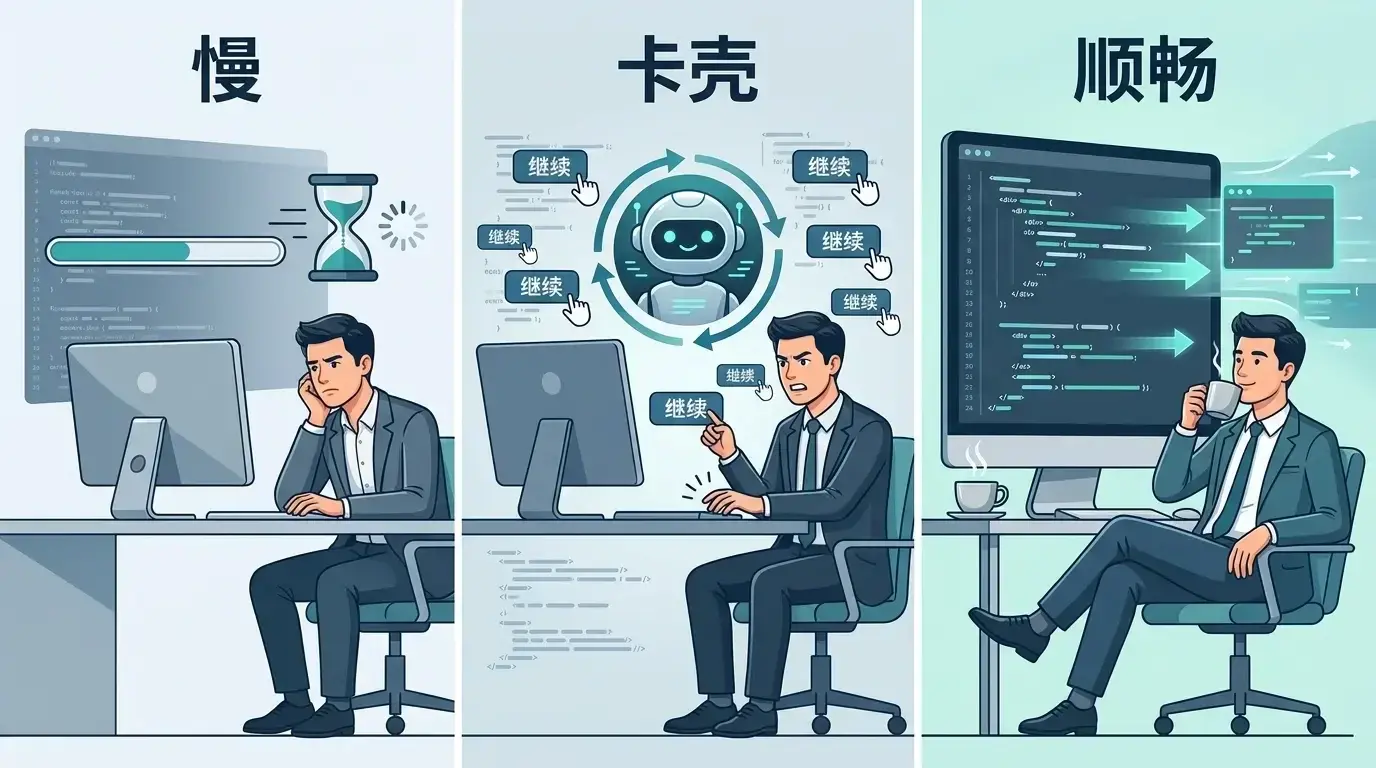
说到底,跑分衡量的是 "最后做没做对",而开发者每天在意的是另外两件事:多久能做完,中间要我操多少心。在这两件事上,Sonnet 5.5 的优势非常明显。
六、好用的不只是模型:Claude Code 占了多少功劳
说到这里得先承认一点:我说的 "Sonnet 5.5 好用",准确地讲是 Sonnet 5.5 + Claude Code 这套组合好用,两者很难完全拆开。
可以这样理解两者的分工:
- 模型决定 "能不能想对":理解需求、读懂代码、写出正确的修改;
- 工具决定 "怎么干活":怎么搜索和读取代码库、怎么把大任务拆成小步、什么时候自己跑测试验证、什么时候停下来问你、出错之后怎么重试。
所以前面说的 "GPT 总卡壳""Kimi 太慢 ",有一部分可能出在工具层,不全是模型本身的问题。拿卡壳来说,Agent 框架的提示词、工具调用格式、上下文管理方式如果和模型的习惯不匹配,模型就更容易原地打转;再看速度,工具每一轮塞给模型多少上下文、一个任务要来回多少轮,都会直接影响总耗时。
第一节的跑分其实已经说明了这一点:同一个 Sonnet 5.5,在 Terminal-Bench 4.0 上从 61.8% 到 70.6%,差距里就有 Agent 脚手架不同的因素。同一个模型换一套工具框架,成绩差上几个百分点很正常。
想分清到底是谁的功劳,可以做两个小实验:
- 固定工具,换模型:像 Kimi 这类提供了兼容接口的模型,可以直接接进 Claude Code,和 Sonnet 在同一个工具里跑同样的任务;
- 固定模型,换工具:同一个任务分别在 Codex 和 Claude Code 里跑,看工具本身能带来多大差别。
这样比出来的结果,比 "各用各家的工具" 公平得多。我这篇文章的体验结论也应该这么看:它反映的是我日常用的那套组合,而不是三个模型在完全相同条件下的高下。
七、别忘了还有 Opus 5.5
如果 Sonnet 已经够用,Opus 5.5 就是另一个档次了。按 Anthropic 公布的数据,Opus 5.5 的 SWE-Bench Pro 成绩是 89.9,比 Sonnet 5.5 高出 8.6 分。
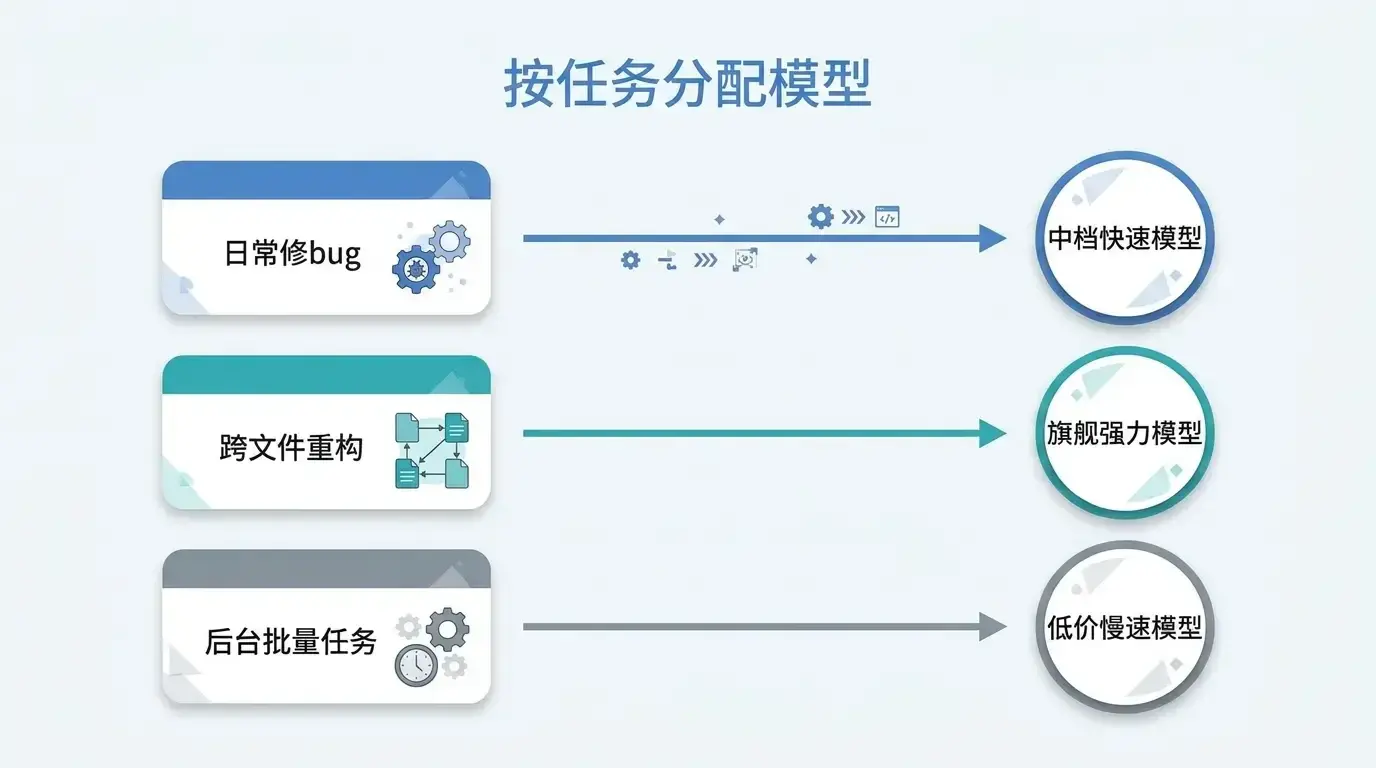
代价是更贵,订阅额度也消耗得更快。所以我现在的分工是:
- 日常开发用 Sonnet 5.5:写接口、修 bug、改页面、补单测,速度和质量都够;
- 难题切到 Opus 5.5:跨多个模块的重构、排查半天找不到原因的 bug、需要通盘考虑的架构调整;
- 后台批量任务可以考虑 Kimi:不着急的长任务交给便宜的模型慢慢跑。
这样既省额度,关键时刻的质量也不打折扣。
八、怎么判断哪个模型适合你:一份自测清单
我的结论来自我的项目和我的使用习惯,换个技术栈、换种工作方式,结果可能完全不同。与其参考别人的排名,不如花半天时间自己测一轮。我的做法是:
- 挑 3~5 个真实任务:从最近的需求和 bug 里挑,难度有高有低,最好包含一个跨文件的改动。别用 "写个贪吃蛇" 这种玩具题。
- 固定变量:同一个任务、同一份初始代码、同一个 Agent 工具,只换模型;推理档位也记下来,必要时 high 和 max 各跑一次。条件允许的话,再固定模型换一次工具,看看差距有多少来自工具。
- 记录四个指标:
- 从开始到完成的总耗时(墙钟时间,不是 token 速度);
- 中途需要你介入、提醒的次数;
- 最终改动能否直接合并,还要返工多少;
- 这个任务实际花了多少钱或多少订阅额度。
- 关注最差情况:一个模型十次里有一次把代码改崩,往往比平均分低几个点更让人头疼。
几轮下来,哪个模型最适合你,心里自然就有数了。
总结
跑分告诉你一个模型的上限,日常体验告诉你它好不好用。在后一点上,Sonnet 5.5 对我来说明显胜出:又快又好,从不掉链子,还很抗用,而它在 Claude Code 里还只是第三档。也别忘了,这份体验里有不小一部分来自 Claude Code:选模型的时候,最好连工具一起选。
当然,没有放之四海皆准的答案。也有不少开发者更喜欢 Codex 里的 GPT,觉得它改动更保守、多文件重构时风格更一致;Kimi 的低价和长任务能力,对能接受等待的团队同样很有吸引力。模型迭代这么快,今天的排名下个月就可能洗牌,最靠谱的办法永远是:拿你自己项目里的真实任务,三个都跑一遍。
数据来源
- Terminal-Bench 4.0 公开榜整理(CodingFleet)
- Kimi K3.1 Pro 编程性能与 Artificial Analysis 数据(SmartScope)
- Claude Sonnet 5.5 跑分(Apidog)
- GPT-6.1 Sol 跑分(Emergent)
- GPT-6.1 Sol 发布与定价(ProPakistani)
- Kimi K3 速度实测(Superconductor)