Cloudflare 昨天公开了一起租户隔离事故:8 月 27 日到 9 月 9 日期间,Workers AI 平台上的 GLM-5.3 模型(@cf/zai-org/glm-5.3)会把其他客户的请求数据混进响应里,总共 155 次,全部发生在超长上下文的 prompt 上。9 月 8 日安全研究员 Gadi Evron(Knostic 公司)通过 HackerOne 报告了这个跨请求 KV cache 暴露问题,Cloudflare 9 月 9 日下架模型修复,之后恢复。
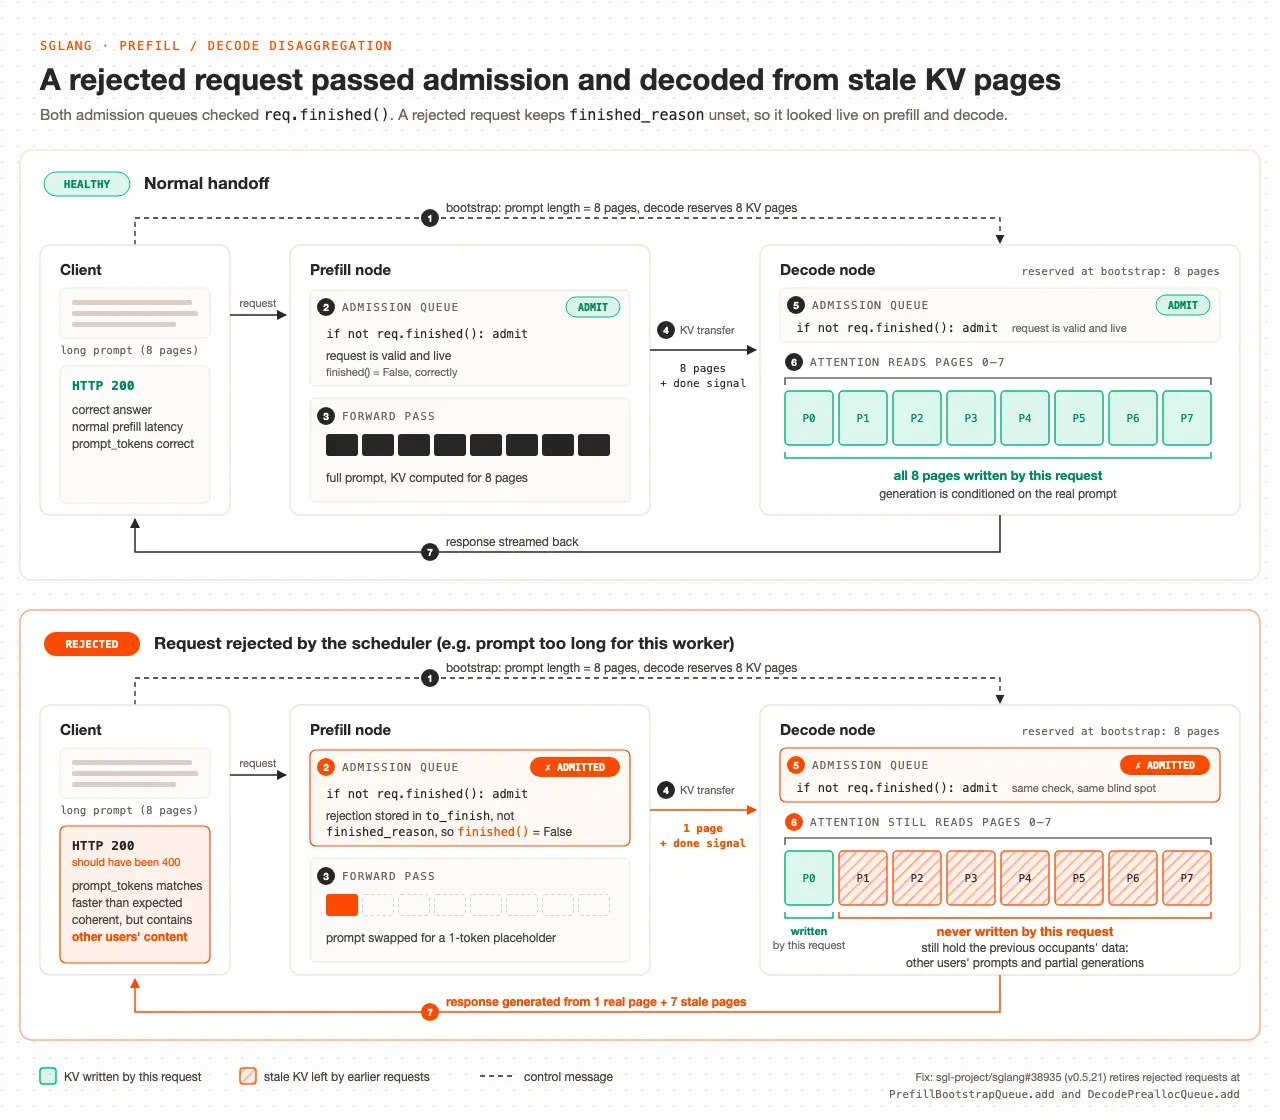
根因是两个问题叠加。第一,配置不匹配:Cloudflare 用开源的 SGLang 推理引擎部署 GLM 5.3,模型宣传的上下文窗口是 1,048,576 token,但 GPU 上 KV cache 池实际只有 681,280 token——池子大小由 SGLang 启动时按剩余显存自动决定,跟模型的上下文长度配置是两套数字,没人保证它们相等。第二,SGLang 在 disaggregated prefill/decode 模式下处理"超池长"请求有 bug:超长请求被标记为 rejected 后,代码路径把 prompt 换成一 token 占位符继续"排空",但 prefill 和 decode 的准入队列检查的是 finished 而非 rejected,导致被拒请求仍被当作存活请求,把不完整的 KV cache 交给下一轮。
值得注意的细节:这个 bug 7 月 6 日就有人在 SGLang 的 issue #30233 报过了,Cloudflare 调查时才发现,且他们从 v0.5.10 起就一直在向 SGLang 团队反馈这类问题。也就是说,推理引擎里"池子比上下文小"导致的拒绝路径隐患,悬了很久才被一次真实安全事故逼出来。
修复也分两层:Cloudflare 把 GLM 5.3 的配置调回和 GLM 5.2 一致,让 prefill KV 池扩大到约 204 万 token(约为上下文的 2 倍);同时 SGLang 在 v0.5.21 里把拒绝路径改安全了——请求不再走"finished"判断,而是正确识别 rejected 并中止。Cloudflare 还补了关键的测试缺口:之前只验证长上下文的 HTTP 响应码和引擎性能,没有验证模型输出连贯性,现在会在任何 disaggregated 部署前直接核对 KV 池大小和上下文长度。
155 次受影响响应、无恶意利用证据、GLM-5.3 是唯一受影响模型——这是 Cloudflare 给出的完整事故边界。配合 SGLang 同天发布的协调披露,这起事件对推理基础设施的启示很直接:当引擎的池子大小与模型的上下文配置解耦时,靠"看起来够用"的测试是不够的,配置漂移迟早要出事。
参考来源