DeepSeek 和华为的关系,已经远远超出了「芯片供应商—大模型客户」的边界。两家中国公司正在做的,是一起重新定义「AI 芯片应该怎么设计」——而这对英伟达的冲击,比单纯的份额数字更深远。
先说合作的具体形态。据 The Information 报道,华为工程师长期驻点在 DeepSeek 公司,把大模型训练中的实际需求直接纳入芯片设计决策——模型计算任务怎么分配、处理器之间怎么传数据,这些底层细节会被写进计划明年年初推出的芯片设计里。这种「客户工程师住在供应商那里,一起设计下一代硬件」的深度绑定在中国科技史上前所未有。
双方合作的桥梁,是一个很多人可能没太注意的技术:TileLang。这是北大团队开源的编程语言,能在一定程度上平替英伟达的 CUDA 系统。华为向 DeepSeek 提供了「毫无保留的帮助」来适配 TileLang——DeepSeek 训练中的每一个 TileLang 算子,都已在昇腾上完成高性能实现。这一步的关键在于:CUDA 生态最深的护城河是代码迁移壁垒,而 TileLang 跨芯片运行的设计,正在撬开这道墙。当训练代码能轻松从英伟达迁到昇腾,CUDA 的粘性就被稀释了。
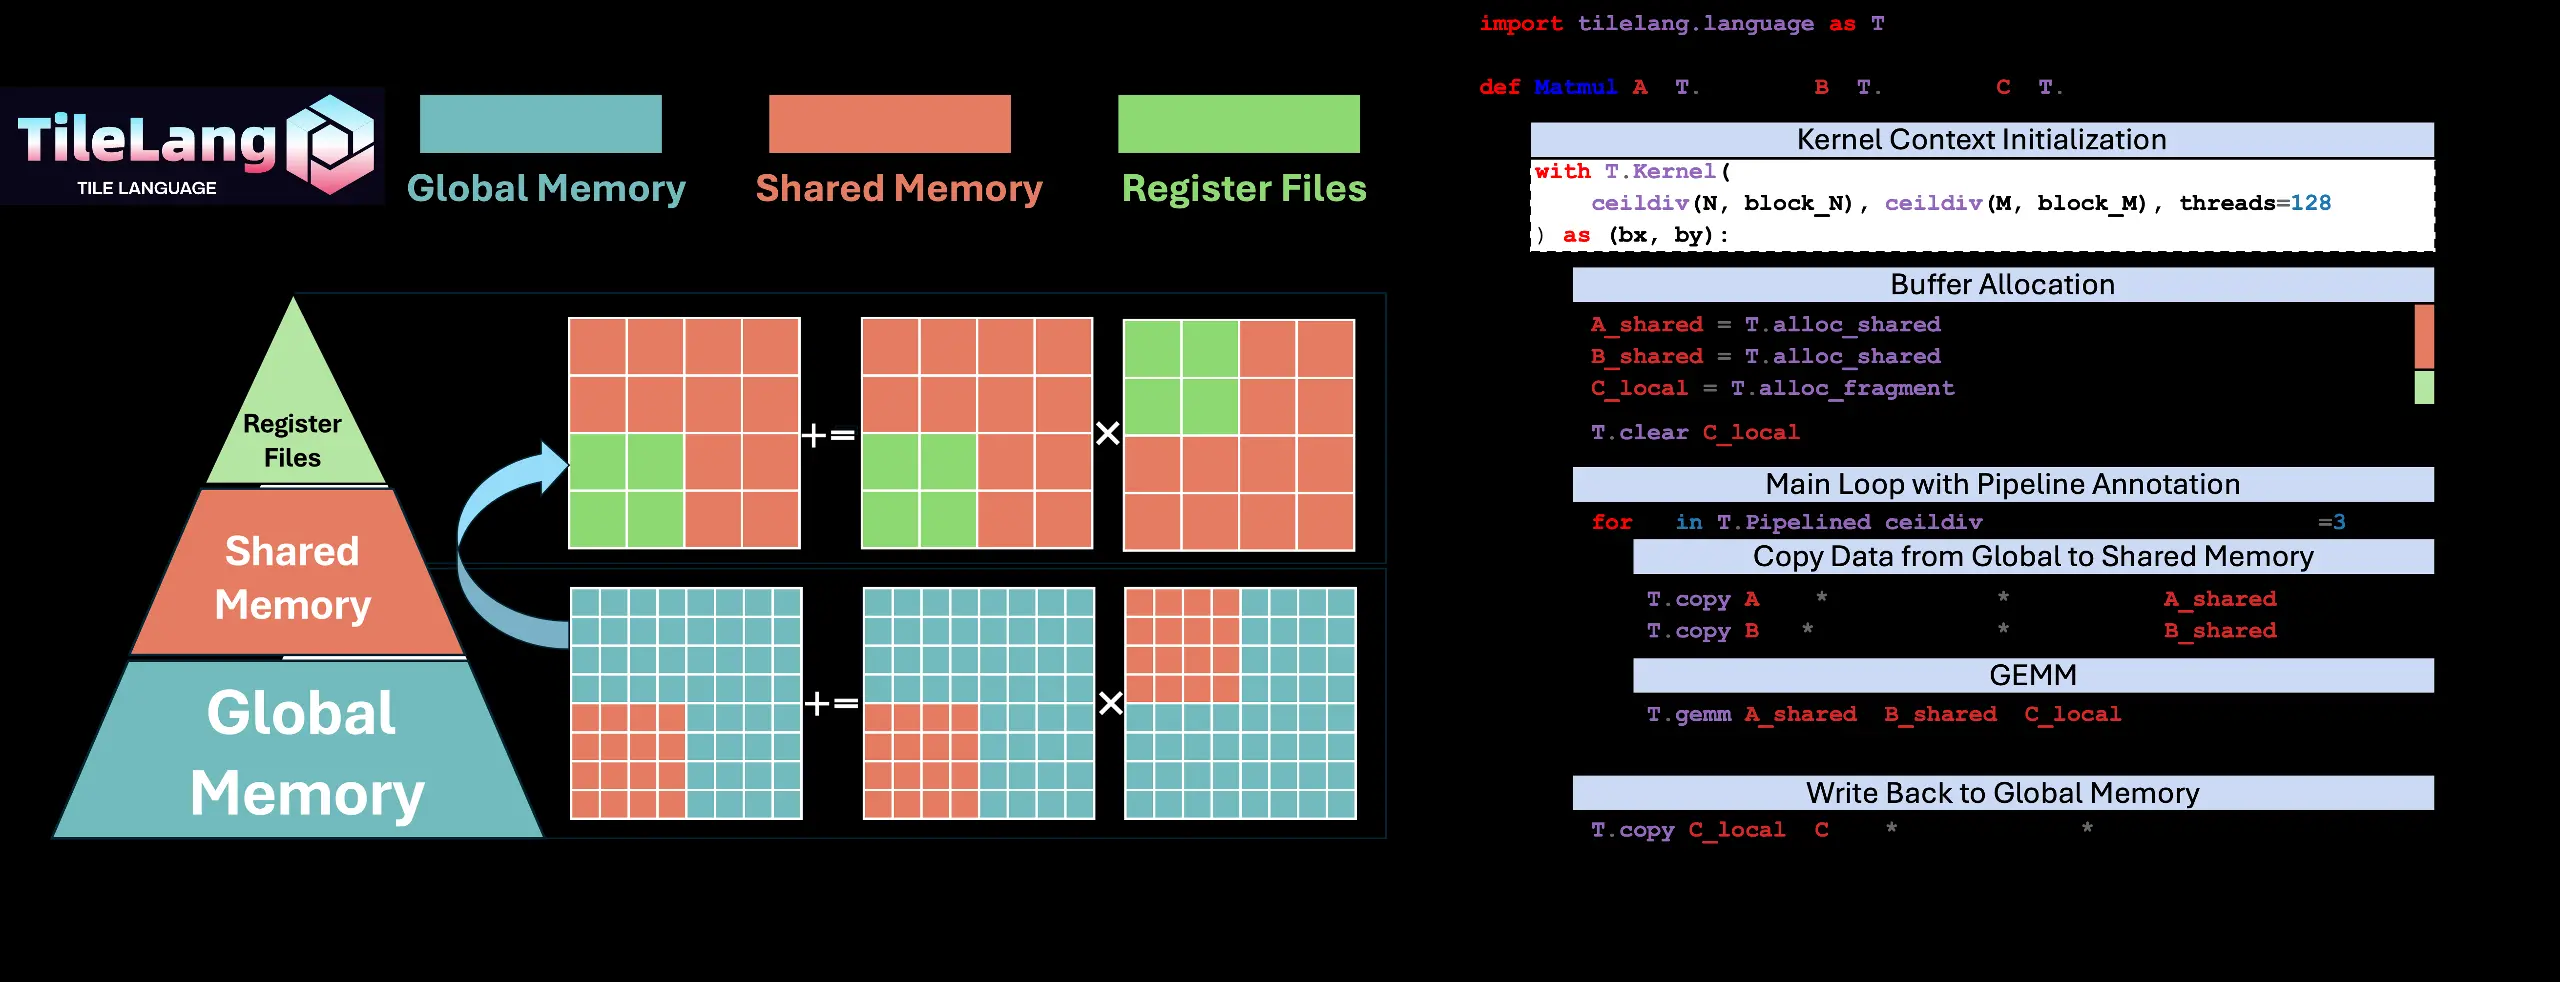
训练环节的切换已经在路上。DeepSeek 预计今年年底开始用华为昇腾 950DT 的万卡集群做预训练(据信是内蒙古的集群)——连续运行数周、数千到上万颗芯片协同,这对昇腾的算力、通信和稳定性是极限测试。一条提醒很现实:万卡集群里任何一颗芯片的延迟,都可能拖住整个集群的进度。
芯片产能的分配更说明问题。华为计划把 2027 年第一季度推出的昇腾 960DT 的大部分产能优先给 DeepSeek——其他中国 AI 大厂要么不买,要么想买但没货,只能拿上一代 950DT。也就是说,最先进的一代芯片,会始终优先满足 DeepSeek。华为轮值董事长徐直军也公开表态:今年旗舰 950DT 明年大规模投放市场,且产能无法覆盖国内需求,会限制海外销售。
市场的天平已经在动。IDC 数据显示,2026 年上半年英伟达在中国 AI 芯片市场份额已降至 34%,华为以 28% 紧随其后,差距缩到 6 个百分点。华为昇腾 910C 超节点已部署超 1000 套,还设计出最多可搭载 100 万颗 NPU 的架构——训练环节的国产化正在从测试走向大规模落地。
当然,性能差距是真实的。按今年的旗舰芯片对比,昇腾 950 系列的计算性能大约是英伟达 B300 系列的 1/7,预计到 2030 年单片代差才会缩小到 3-4 年。这不是「弯道超车」,而是「用工程和生态换时间」——用算法效率弥补硬件差距,用绑定关系锁定产能。
最耐人寻味的是 DeepSeek 的姿态。它并不拒绝获得英伟达芯片的机会,但华为的稳定供应让它多了一个选择——一个「走得慢一点,但能走得更久」的选择。对一个要在美国出口管制下长期训练前沿模型的公司来说,这个选择比任何单一芯片的性能都重要。当一家顶流模型公司愿意深度参与国产芯片的设计、适配和产能分配,这已经不是「国产替代」的故事,而是「需求方反向塑造供应链」的开端。
参考来源: