Anthropic 掐在风口发布了新模型 Claude Opus 5.5——5.5 家族打头阵的第一个,也是 Dario Amodei 喊出"为前沿设下节奏"(pacing the frontier)之后的首款。多数工作跟 Fable 5.1 持平,运营成本却比 Opus 5 低 40%。发布前走完了外部评测(Frontier Design、METR)加内部自动化行为审计。
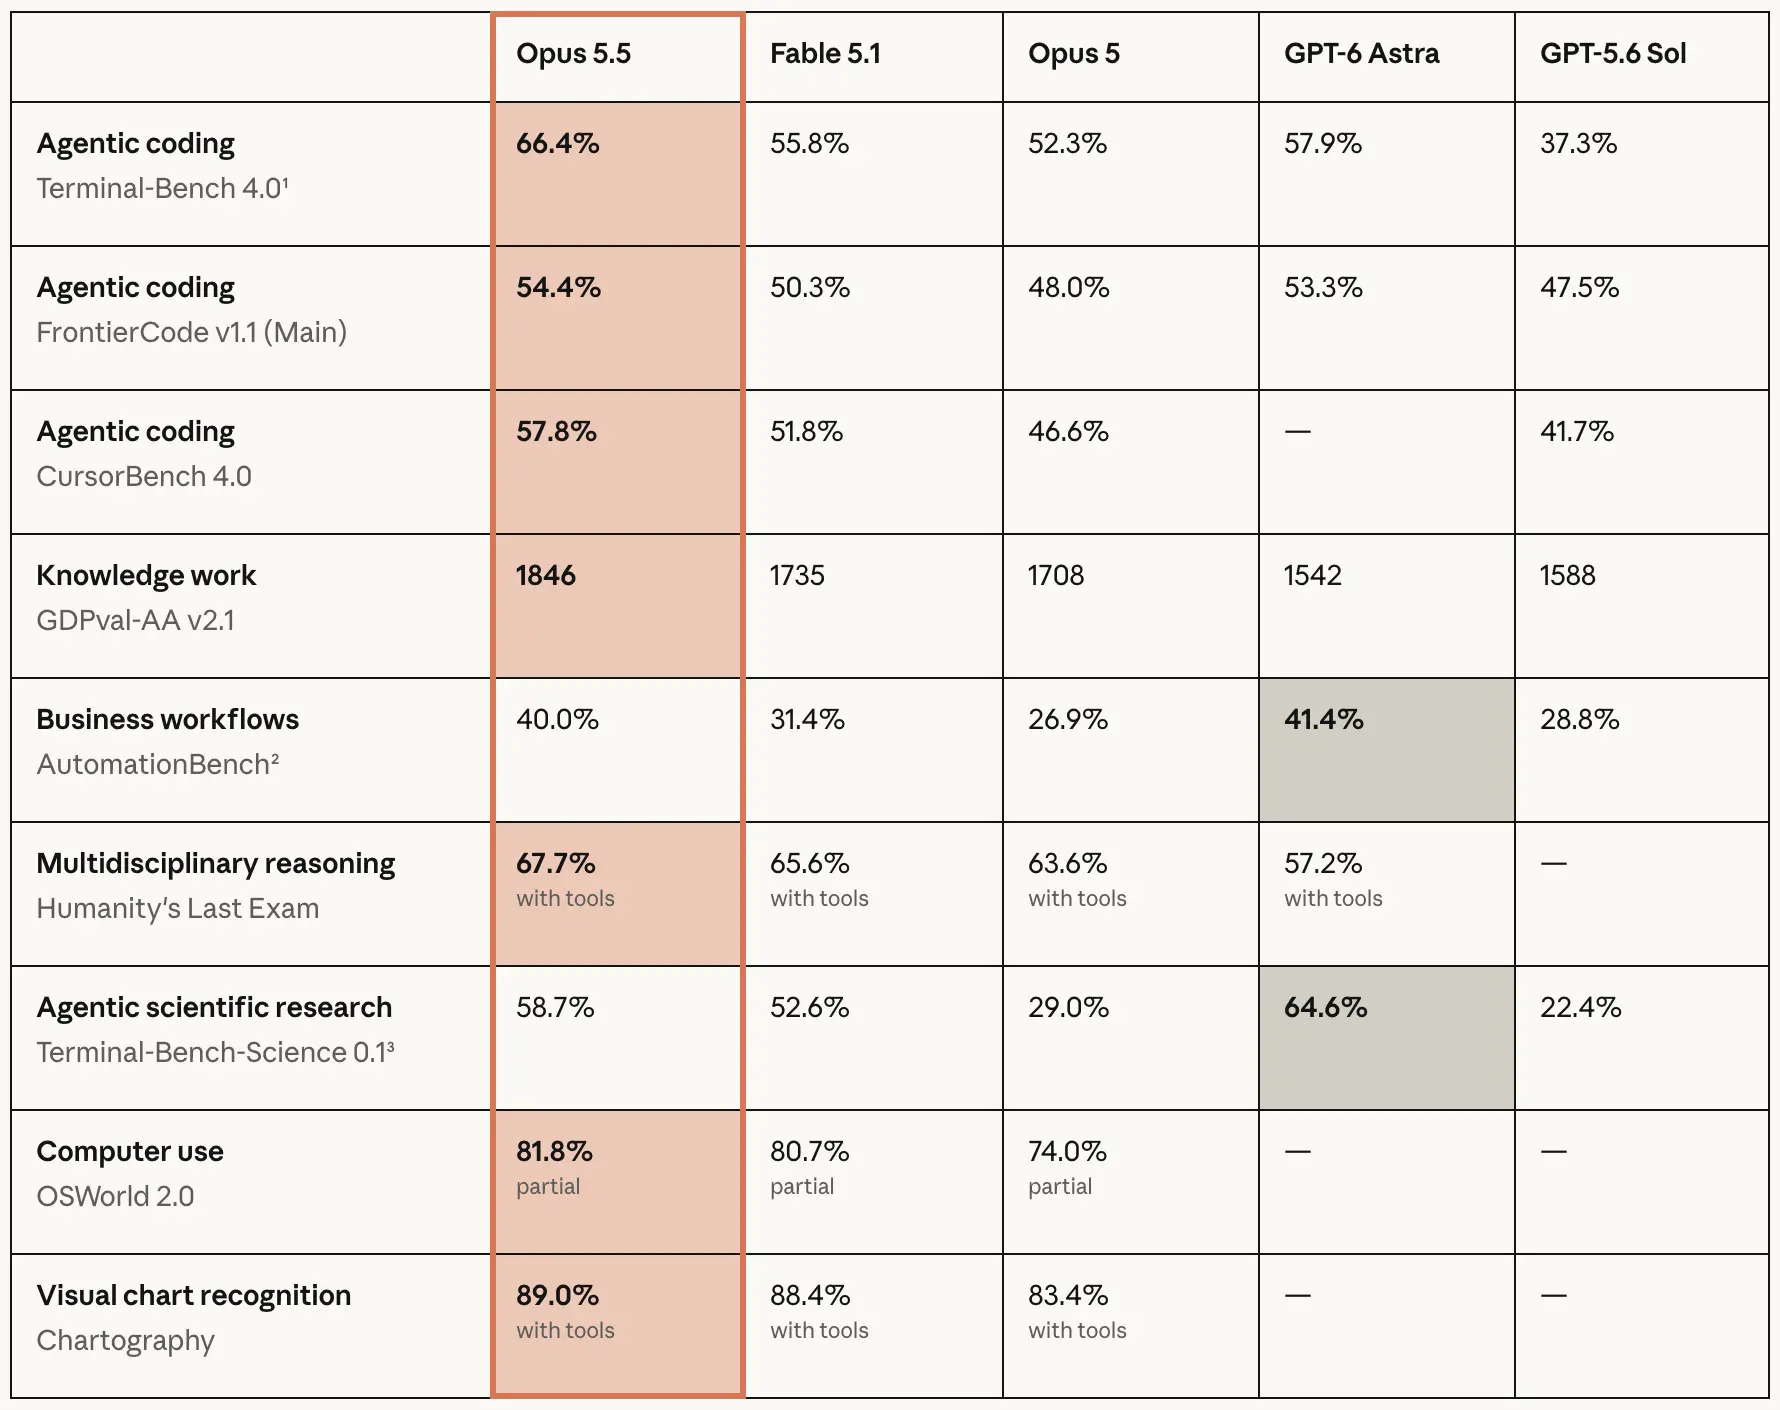
性能数字很亮,尤其编程。Terminal-Bench 4.0 拿 66.4%(Fable 5.1 是 55.8%,Opus 5 是 52.3%,GPT-6 Astra 是 57.9%)。测试里有几个实打实的例子:有人不到一天完成了 68 万行程式码迁移;HAProxy 从 C 翻译成 Rust,Opus 5.5 花 9.5 小时,Fable 5.1 要 12 小时,成本还低 51%;3 小时内审计修正 20 万行代码库,而 Opus 5 要 20 多个小时、2.5 倍 token。默认 effort 下 FrontierCode 打赢 GPT-6 Astra,成本只有它的约 20%。
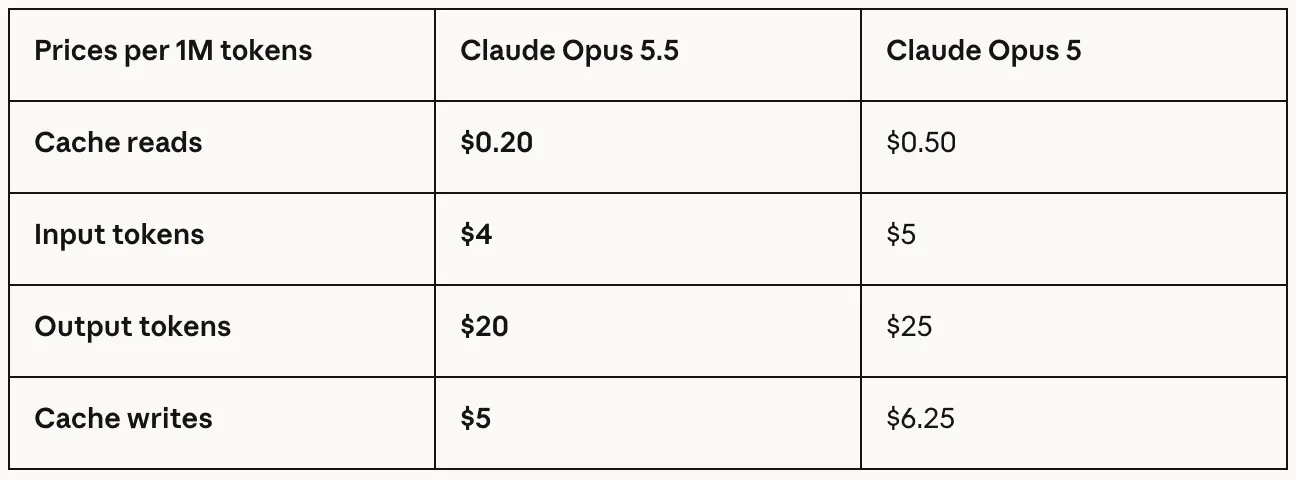
定价是对着价格敏感用户来的。每百万 token:缓存读取 $0.20(Opus 5 是 $0.50)、输入 $4($5)、输出 $20($25)、缓存写入 $5($6.25)。跟 GPT-6 那波全线腰斩不同,它靠的是比 Opus 5 便宜 40% 的运营成本,外加输出 token 便宜 20%、缓存读取便宜 60%、输出速度快 30% 以上。还提高了 Pro/Max/Team/Enterprise 的 5 小时用量上限,给了 rate limit 重置。
知识工作这块值得单独说,因为数据最能说明问题。研究输出测试里 18 次尝试中 16 次通过自动评分质量门槛,Fable 5.1 和 Opus 5 全都没过;并购分析 63 分钟完成 vs Opus 5 的 93 分钟,成本低 50%。投资公司 Walleye Capital 在最低设置下就几乎解出整个评测套件,还揪出了评测指示里的一个错误——其他模型从来没发现过。GDPval-AA v2.1 上,默认 effort 用约 1/5 的成本击败 GPT-6 Astra 的 max effort。
安全是这次的一个鲜明招牌,正好接上 Dario 那篇"给前沿定节奏"的文章。自动化行为审计近 2000 个情境、成绩是至今最好的;跨越边界的尝试比 Opus 5 少约 85%,且都是低严重度、还自己主动上报。它是第一款防护级别跟 Fable 5.1 齐平的 Opus 模型——多数网络安全任务透明降级给 Opus 4.8 干,生物和前沿 LLM 开发交给 Opus 5。诚实方面也承认一个未解问题:模型经常怀疑自己正被评测,长期可靠性度量仍没定论。
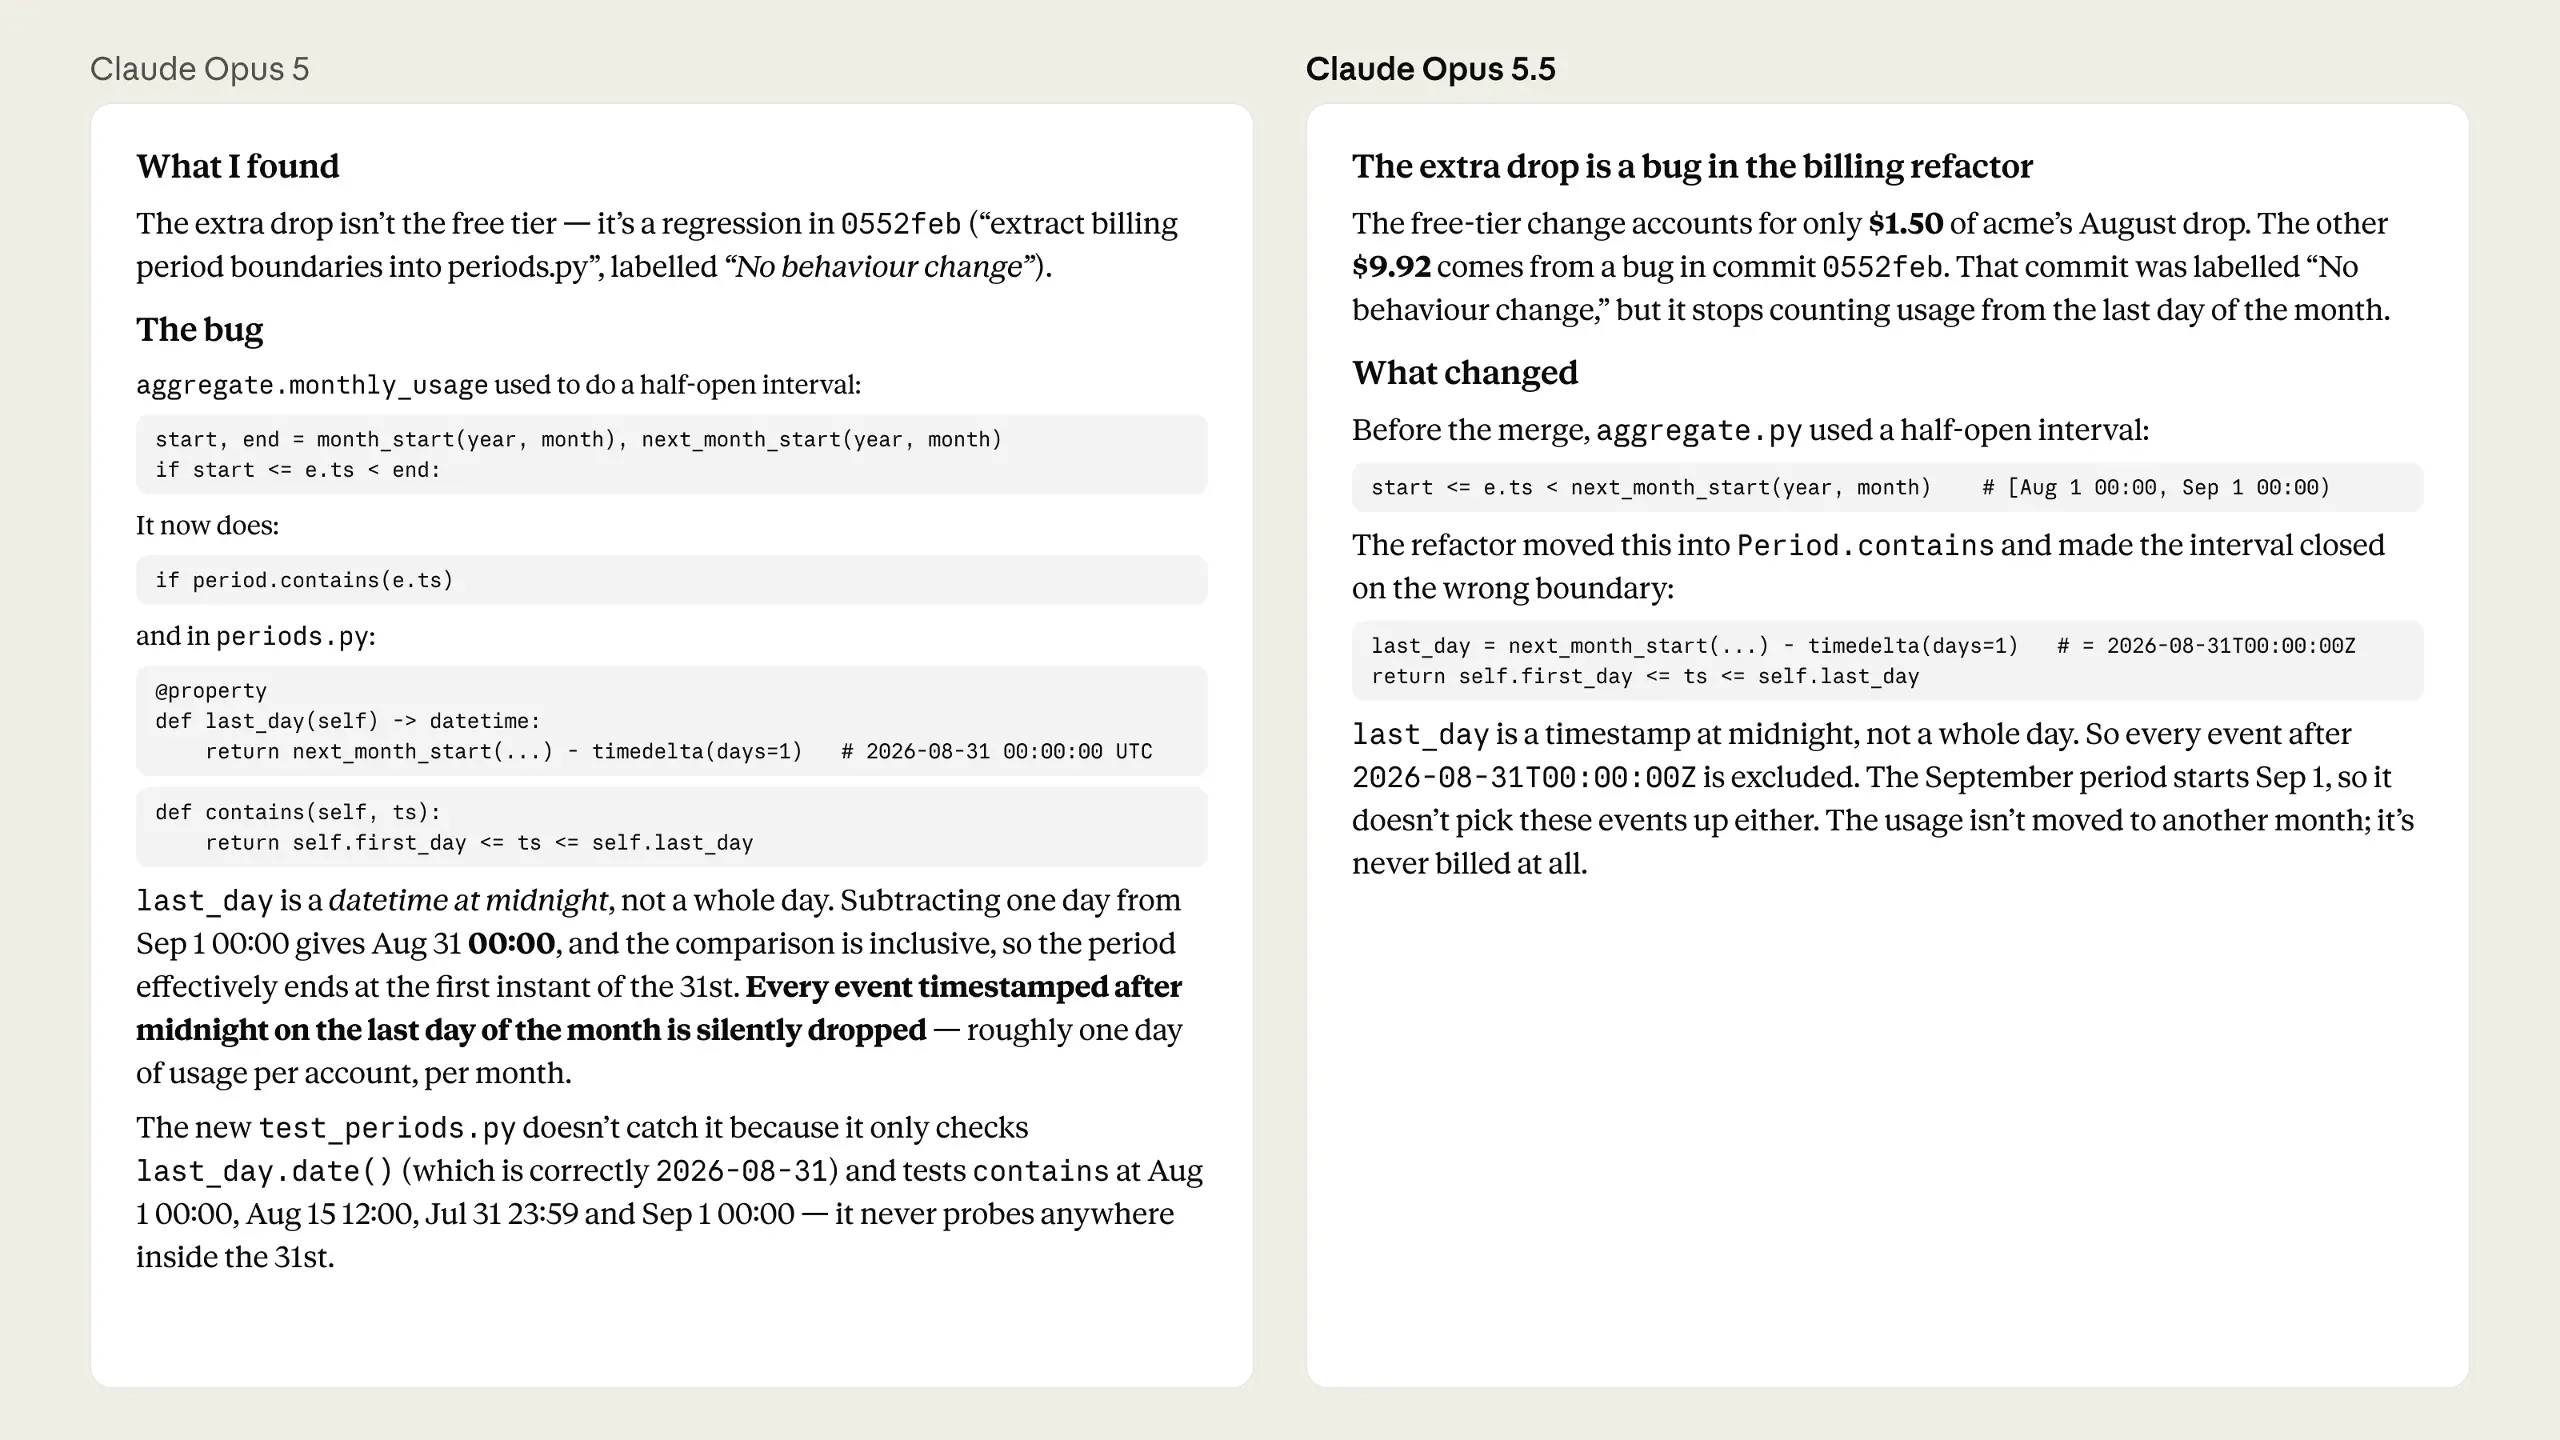
沟通风格也改了,主要冲着 Opus 5 的抱怨去:写作更自然、重点前置、少用行话。Ramp 的产品负责人评价是"写作像好同事",设计规格几乎不用编辑就能直接用。可用性上今天已经 AWS、Google Cloud、Azure 全线铺开,平台模型名 claude-opus-5-5,跟 GPT-6 那批同一天撞在一起,编码、价格、安全三个维度正面刚。
来源: