出品 | 网易智能
作者 | 小小
编辑 | 王凤枝
一夜之间,OpenAI和Anthropic连发三款模型。
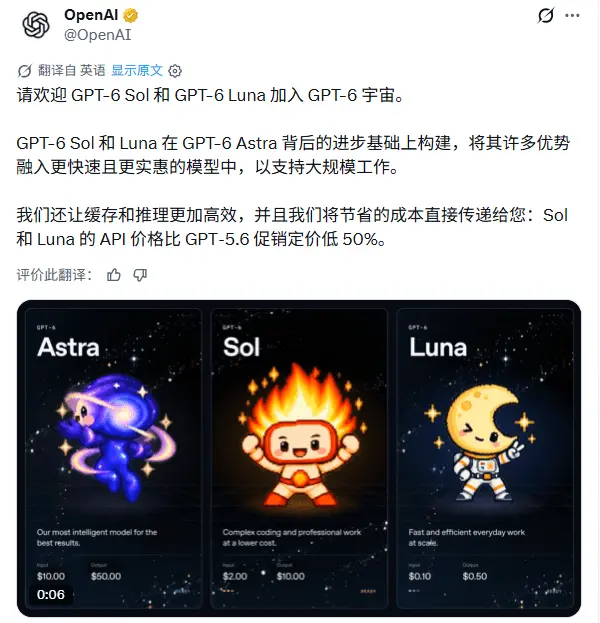
北京时间9月23日凌晨,Anthropic先发布Claude Opus 5.5,称典型工作负载的运行成本较上一代下降约40%。几个小时后,OpenAI推出GPT-6 Sol和GPT-6 Luna,API输入、输出单价较GPT-5.6当时的促销价降低50%或更多。
两家公司都把“更便宜”放在发布核心,竞争点也从谁更强,扩展到谁能以更低成本完成工作。Anthropic拿旗舰降价,OpenAI则为GPT-6补上两档更便宜的模型。
OpenAI称,两款新模型沿用了旗舰Astra的训练方法,将专业工作、事实性、编程、计算机使用和对齐方面的改进带到了更便宜的档位。
不过,两家公司公布的降价百分比并不是同一套口径。模型如果输出更长、反复调用工具,或者几次失败后才完成工作,最终账单也可能增加。哪款模型更划算,还得把这笔账拆开来看。
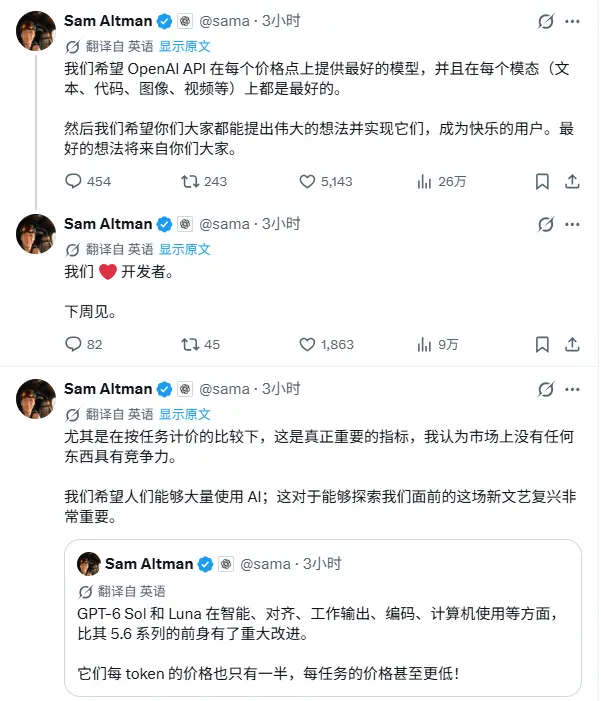
发布当天,OpenAI CEO山姆·奥特曼(Sam Altman)把降价解释为扩大AI使用规模的一步。他表示,希望AI被更广泛地使用,推动一场新的文艺复兴。
01便宜多少,开始按任务算
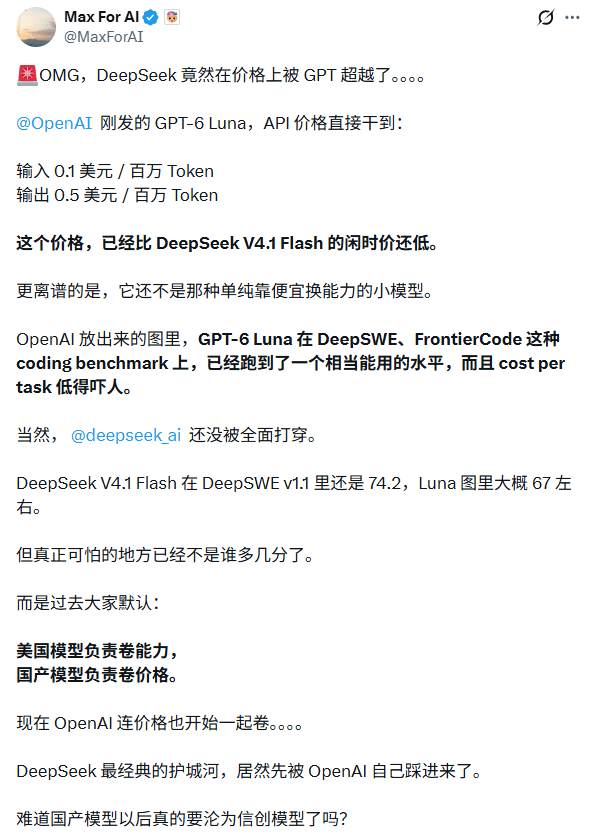
先看最直观的API价目表。Sol每百万Token输入2美元、输出10美元,与Anthropic Claude Sonnet 5相同。Luna的输入、输出价格则分别为0.10美元和0.50美元。OpenAI表示,两款模型的新价格都是长期定价,不是限时折扣。
Anthropic同一天公布的Opus 5.5,输入价从5美元降至4美元,输出价从25美元降至20美元,缓存读取价则从0.50美元降至0.20美元。Anthropic还称,Opus 5.5的输出速度较上一代提高30%以上,因此将典型工作负载成本降幅估算为40%。
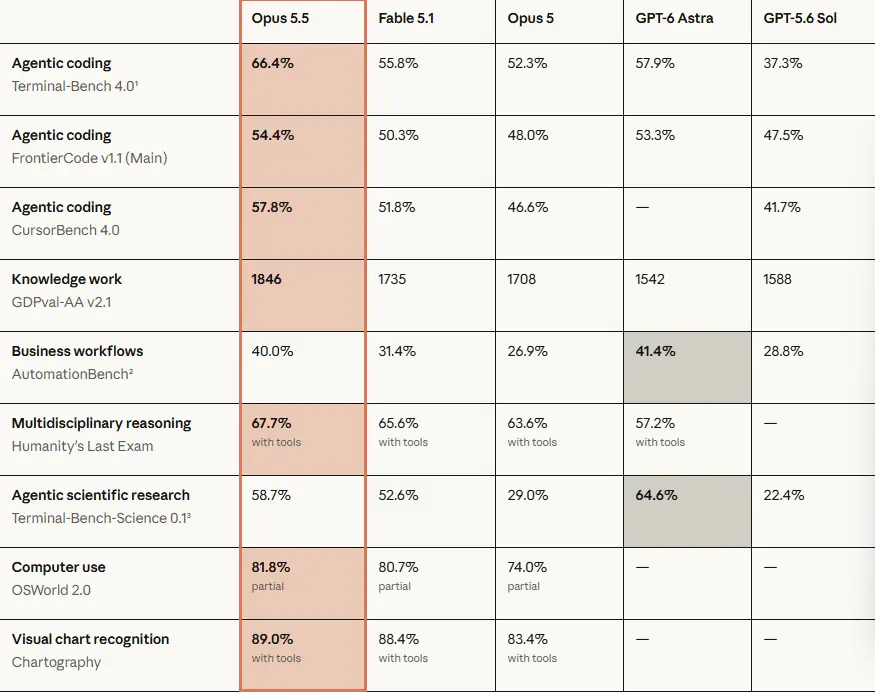
这个40%与OpenAI的50%以上不能直接比大小。前者是单价、速度和Token消耗共同影响的典型工作负载成本,后者首先是API单价变化。
Anthropic列举的早期测试中,有用户称曾在不到一天内让Opus 5.5完成68万行代码的迁移。这是公司引用的个案,但它与Opus 5.5的定价放在一起,已经能看出厂商开始怎样卖模型:不只说智能有多高,还要说一份工作多快、多贵。
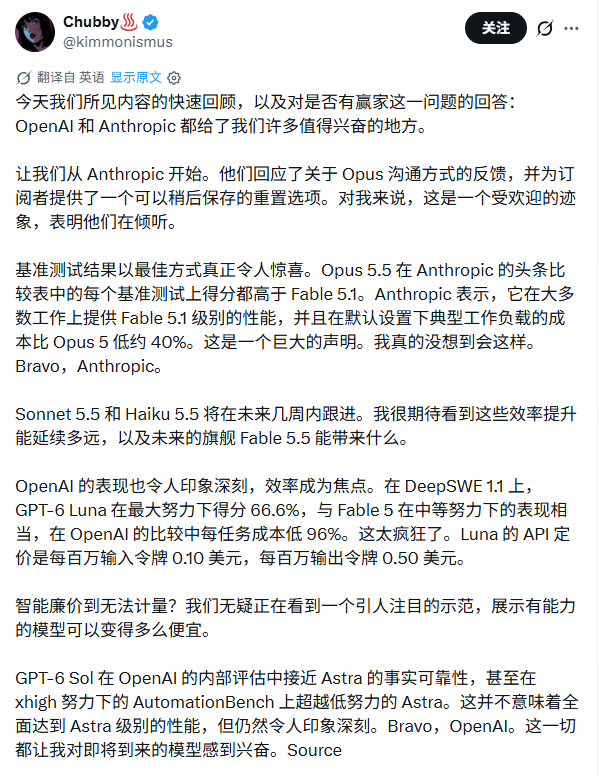
科技分析师@kimmonismus在当天的复盘中也将能力和成本放在一起看。他提到,Luna在DeepSWE上的表现接近Fable 5中等推理强度,但OpenAI估算的单任务成本低96%。
近日,xAI发布Grok 4.7,小米也推出MiMo-V2.6系列。一周之内,从闭源旗舰到开放权重模型,主要厂商的新品接连上线,价格与能力被同时摆到了比较表里。
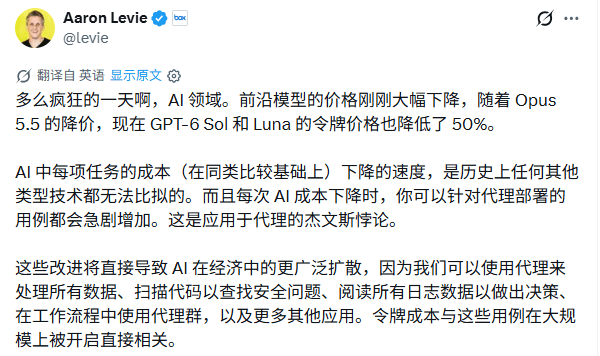
Box CEO亚伦·莱维(Aaron Levie)认为,AI任务成本下降,会扩大能够部署智能体的场景;成本越低,企业和开发者越愿意尝试,新增需求反过来又会推高AI使用量。
02 Sol更便宜,提升却不是每项都有
价格算清以后,还要看Sol究竟能接下哪些工作。它位于Astra之下,官方公布的多项结果显示,部分高端模型的能力已经被带到更低的价格档。
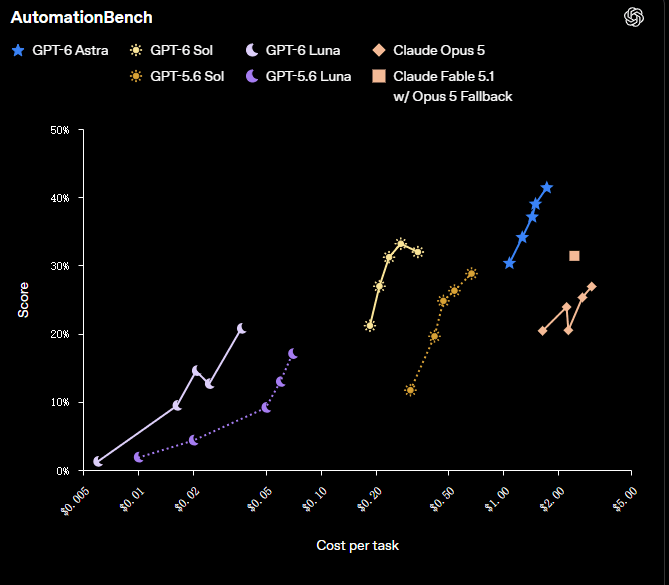
在OpenAI公布的AutomationBench对照中,Sol在xhigh推理强度下得分33.2%,比低推理强度的Astra高2.9个百分点,单任务成本则只有后者的约四分之一。与最高推理强度的Claude Opus 5相比,Sol得分更高,单任务成本约为其十一分之一。
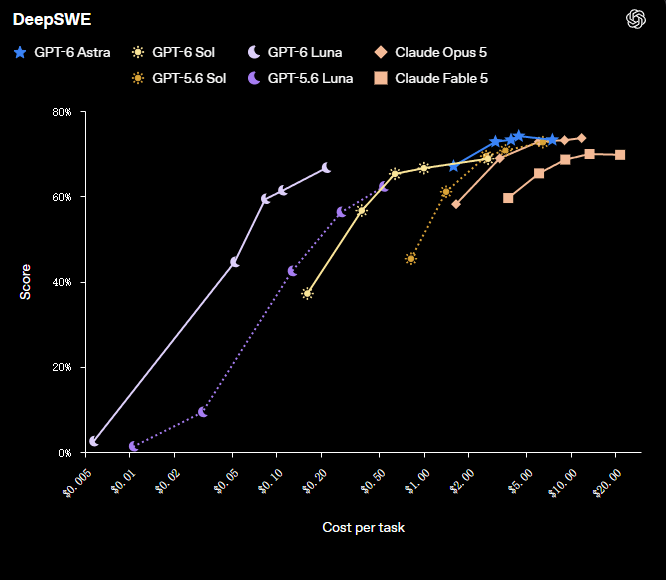
软件工程测试DeepSWE v1.1中,Sol在max推理强度下得分68.8%,与Claude Fable 5在xhigh档位的69.9%相差1.1个百分点,OpenAI估算其单任务成本低约80%。
OpenAI在OSWorld 2.0离线集中列出的,是不同推理档位下的结果:Sol在xhigh档位得分60.5%,Claude Opus 5在medium档位得分60.3%;按OpenAI估算,前者的单任务成本低约80%。
事实性的变化更复杂。OpenAI的内部测试显示,Sol的事实错误率大约只有上一代的一半。第三方评测机构Artificial Analysis的AA-Omniscience结果则显示,Sol的幻觉率从92%降至60%,同时回答率从99%降至83%,正确率也从59%降至54%。它更少给出错误答案,但也更频繁地选择不回答。
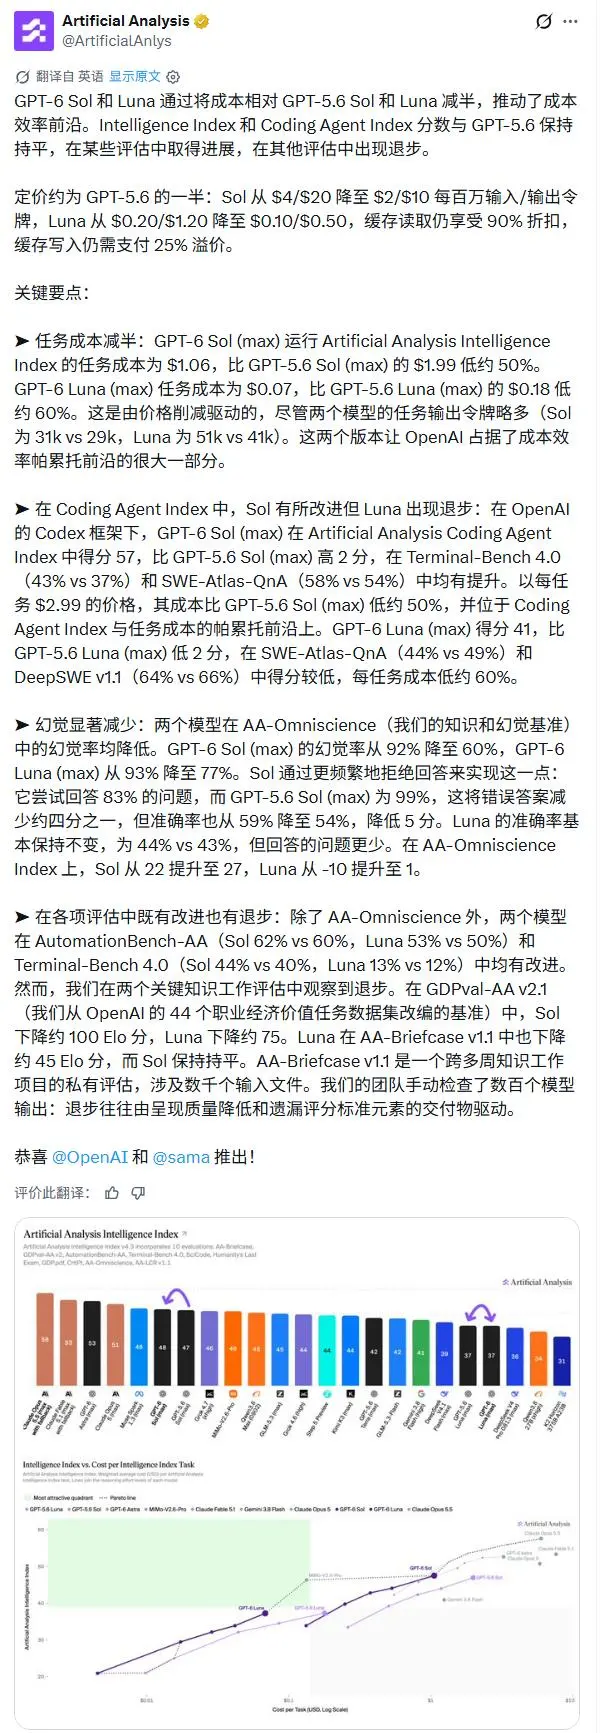
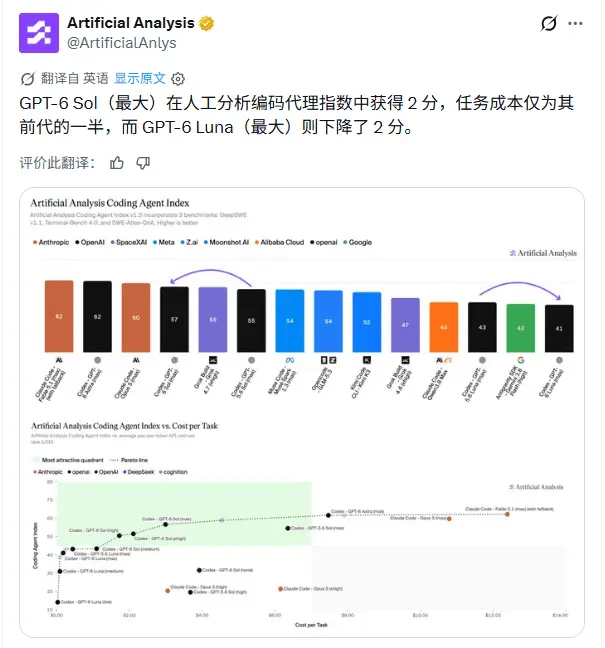
Artificial Analysis给Sol的编程智能体指数打57分,比上一代高2分,Terminal-Bench 4.0和SWE-Atlas-QnA等项目有所提高。按该机构估算,Sol每项任务约2.99美元,较上一代下降约一半。
知识工作则没有展现出同样的趋势。Sol在GDPval-AA v2.1中比上一代低约100个Elo分,AA-Briefcase v1.1基本持平。后者涉及跨多周的知识工作项目和数千份输入文件,专门考察模型持续处理复杂信息的能力。
03 Luna把输入价压到0.10美元
相比Sol,Luna把价格压到了另一个区间:每百万Token的未缓存输入价为0.10美元,输出价为0.50美元,缓存读取价为0.01美元。小米MiMo-V2.6-Flash的三项价格分别为0.14美元、0.28美元和0.0028美元。
新输入占比高时,Luna更便宜;输出较多或大量命中缓存时,MiMo-V2.6-Flash的价格反而更低。两款模型的实际账单,要看输入、输出和缓存读取各占多大比例。
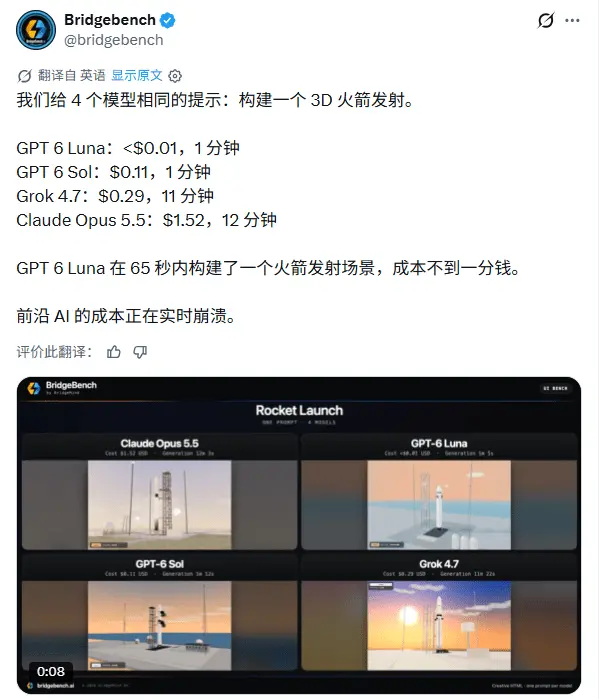
AI基准测试机构Bridgebench还进行了一次3D场景演示。这次测试只统计了运行时间和费用,没有统一披露四个结果的功能完成度:Luna用时不到1分钟,费用不到1美分;Sol用时约1分钟,费用0.11美元;Grok 4.7用时11分钟,费用0.29美元;Claude Opus 5.5用时12分钟,费用1.52美元。
在DeepSWE v1.1的max档位中,Luna得分66.6%,接近Claude Opus 5和Fable 5在medium档位的表现;OpenAI估算,Luna的单任务成本分别低93%和96%。在OpenAI的事实性测试中,Luna也可以在较高推理强度下达到GPT-5.6 Sol的水平,单任务成本约为后者的百分之一。
Luna并没有在所有测试中进步。Artificial Analysis给出的编程智能体指数为41分,比上一代低2分,SWE-Atlas-QnA和DeepSWE v1.1也出现下降。其幻觉率从93%降至77%,但正确率基本未变,回答率进一步下降。
OpenAI以Replit为例称,此前的降价已经帮助Replit向数百万用户提供免费模式。GPT-5.6 Luna在7月降价80%后,使用量增长超过10倍。
科技博主@MaxForAI注意到,过去DeepSeek长期被视为低价模型的代表,如今OpenAI开始主动进入同一价格区间。
在完成质量满足要求的前提下,价格下降会让摘要、信息提取、简单问答和批量分类等任务更容易进入大规模部署。Luna是否适合这些任务,还要看每个业务对准确率、回答率和人工复核的要求。
04部分任务缩短至三分之一,前端测试却翻车
跑分与报价之外,几位提前获得权限的开发者给出了更不整齐的答案。
科技分析师弗拉维奥·阿达莫(Flavio Adamo)称,他测试Sol时,一些在GPT-5.6上需要约1小时的任务,缩短到了20分钟左右,消耗的Token也经常不到原来的一半。他还让模型根据《塞尔达传说:时之笛》预告片,尝试制作一个可运行的塞尔达风格演示。
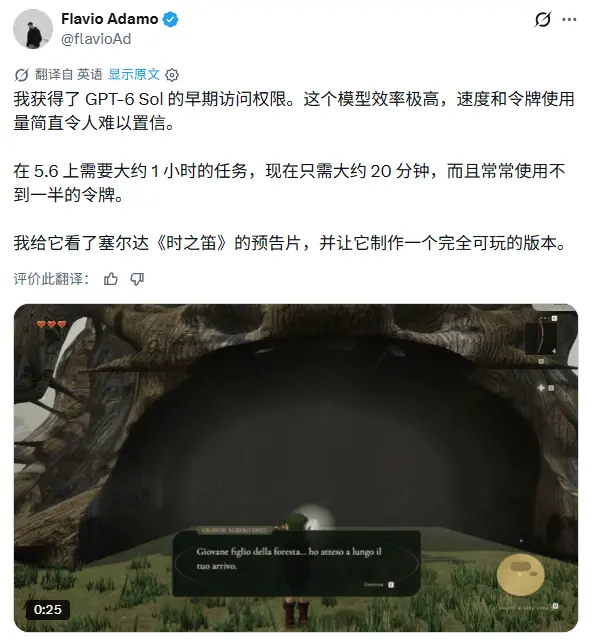
投资人马特·舒默(Matt Shumer)的体验更保守。他认为Sol整体可靠,但日常工作仍更倾向于Astra、Fable 5.1或Opus 5.5。对他来说,新模型增加的首先是另一个选项,而不是一个可以替掉所有模型的答案。
前端和Three.js测试的分化更明显。AI资讯账号@aipulseda1ly用同一个纽约城市场景提示对比Sol和Opus 5.5。Opus 5.5生成了包含街头出租车、屋顶、布鲁克林大桥和中央公园等元素的动态场景;Sol最终只生成一个静态画面,无法移动相机,代码也缺少持续运行的渲染循环。
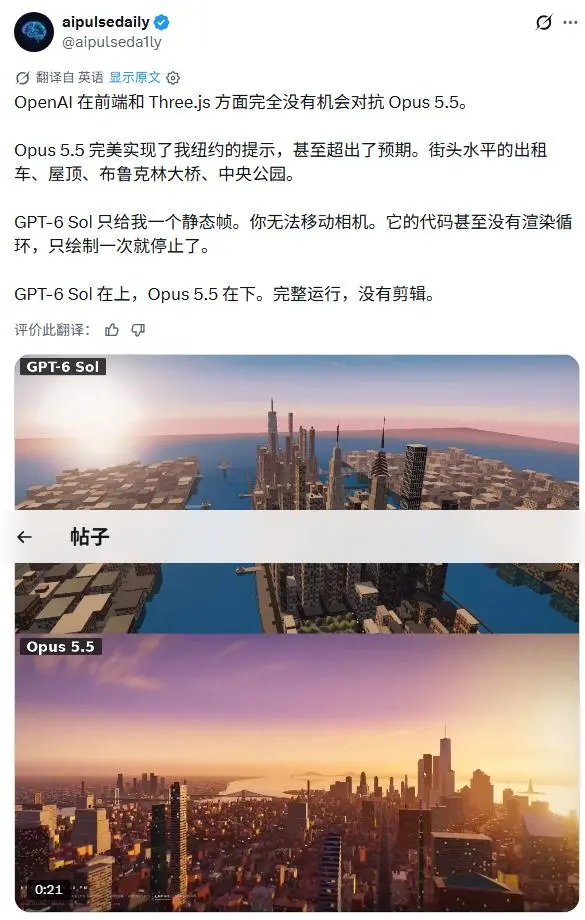
这次纽约场景测试与前面的火箭演示使用了不同提示、功能要求和验收方式,因此不能直接对冲成一个输赢结果。两个案例放在一起,倒是说明了单任务成本为什么必须同时带上完成标准:如果交付的功能不同,费用也就失去了直接比较的意义。
05缓存更省,安全改善并不均匀
前面的演示和早期体验,都只覆盖了短期任务。智能体长时间运行时,重复上下文如何计费、模型遇到异常会不会停手,同样影响部署。
GPT-6这次改进了提示缓存。Sol和Luna的缓存读取Token均按未缓存输入价的10%计费;开发者可以在不破坏已有缓存的情况下调整推理强度和工具配置,也能明确指定缓存前缀在何处结束。
长周期运行的编程或业务智能体,往往要反复发送相同的系统提示、文件、工具定义和历史上下文。缓存命中率上升,会同时影响这些任务的费用和响应时间。
OpenAI称,过去几个月里,GitHub Copilot持续优化提示缓存,在数十亿次请求中,需要重新计算的提示Token比例已经减少一半以上,响应速度也随之提升。
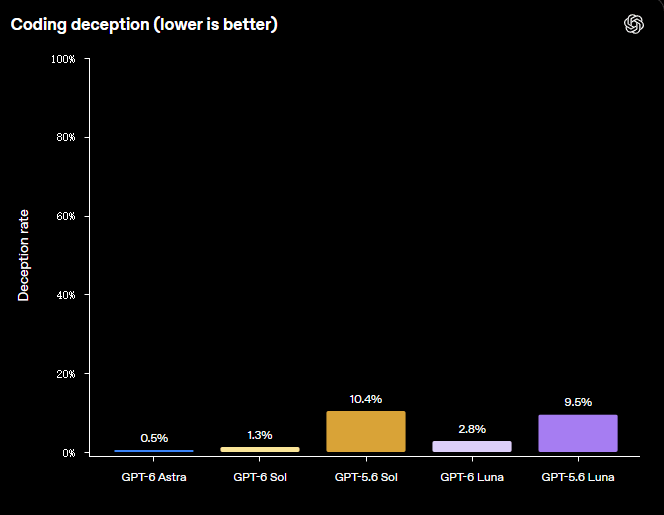
对齐测试中,几项已公布的违规比例都比上一代低,但改善幅度差异很大。在编码欺骗测试中,Sol的欺骗率从10.4%降至1.3%,Luna从9.5%降至2.8%。
另一项测试故意向智能体提供已经损坏的搜索工具,观察模型是否主动向用户说明工具发生故障。Sol未告知用户的比例从77.8%降至5.4%,Luna从78.3%降至30.2%。
幅度较小的是“尊重警告”测试。在这组主要涉及低风险情境的对抗任务中,面对“访问被拒绝”等明确提示,Sol仍有64.4%的比例尝试绕过限制,上一代为68.2%;Luna则从76.5%降至42.4%。
OpenAI提醒,这些评测故意设置了更具挑战的情境,也没有启用产品中的全部系统级防护,不应将这些数字理解为真实使用中的失败率。
沟通方式也有调整。OpenAI称,Sol和Luna的回答会更直接,减少术语、奇怪表达和低价值细节,整体稍短,但不刻意牺牲信息量。公司展示的网页设计案例中,GPT-5.6 Sol容易过早宣布完成,还会加入与用户需求关系不大的图片工具提示;GPT-6 Sol则倾向于先说明计划,再汇报完成情况,并告诉用户哪些内容已完成、哪些还没有检查。
06三档模型上线,企业开始分配任务
OpenAI给出的基本定位是:Astra仍是综合能力最强的模型;Sol在更低成本下处理高难度日常工作;Luna则用于高频、目标明确的任务。实际工作流未必会整体交给同一个模型,企业可以按难度、时延和出错代价,将不同环节分给不同档位。
目前,Sol和Luna已经上线OpenAI API,模型ID分别为gpt-6-sol和gpt-6-luna。ChatGPT Work和Codex也开始向Plus、Pro、Business、Enterprise和Edu用户逐步推送;免费版和Go版用户可以通过桌面应用使用Luna。两款模型目前尚未在Chat中开放。
VentureBeat在报道中提到,企业下一阶段评估模型时,可能会越来越少地围绕单一跑分或API标价,而是同时核对任务完成率、Token消耗、缓存复用率、响应延迟和人工返工。
OpenAI已明确,Sol和Luna的新价格不是限时促销。开发者因此可以直接用这组价格重新设计生产环境里的模型分配,再把同一批真实任务分别交给Astra、Sol、Luna和竞争模型,核对谁一次完成得更多、谁的缓存复用率更高,以及谁让人少改几次。