作者丨李秋悦
编辑丨吴 彤
传统MV拍摄,摄影机架在哪里,观众看到的就是哪个角度。现在用多台摄像机同时记录舞者动作,再重建出一个三维动态场景,镜头可以任意调换位置;从队形正面绕到侧面,穿过舞者之间,甚至换一个从未真正架设过的机位,重新观看刚才的表演。
今年10月,韩国SM娱乐创始人李秀满在新女团A2O LITE的出道活动上,展示了这项名为4D Gaussian Splatting(4DGS)的技术。
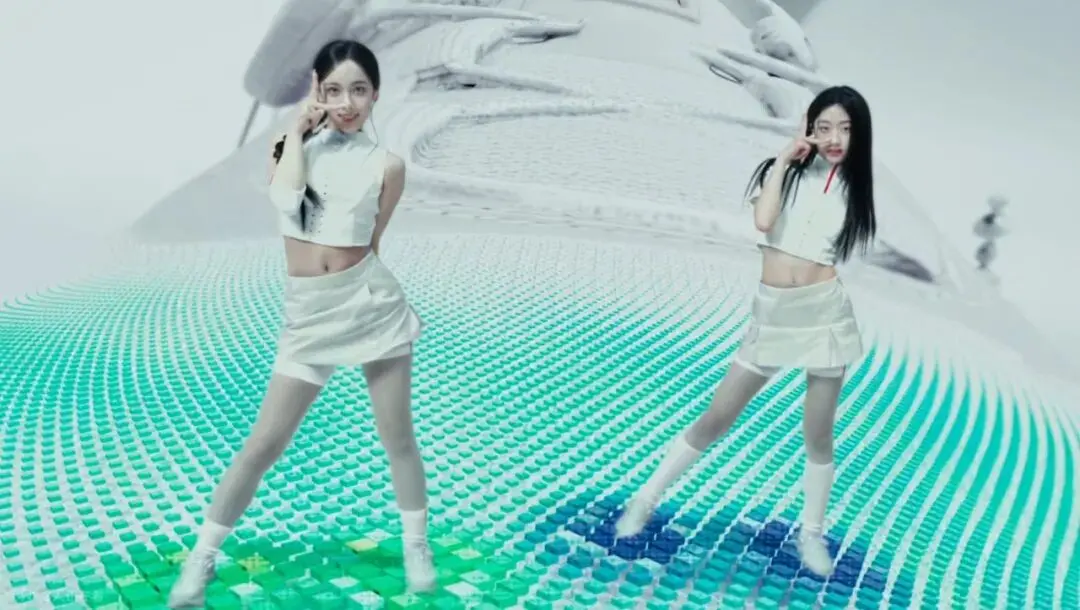
SM娱乐旗下女团A2O LITE 《NEON》运用4DV.ai的4DGS新技术
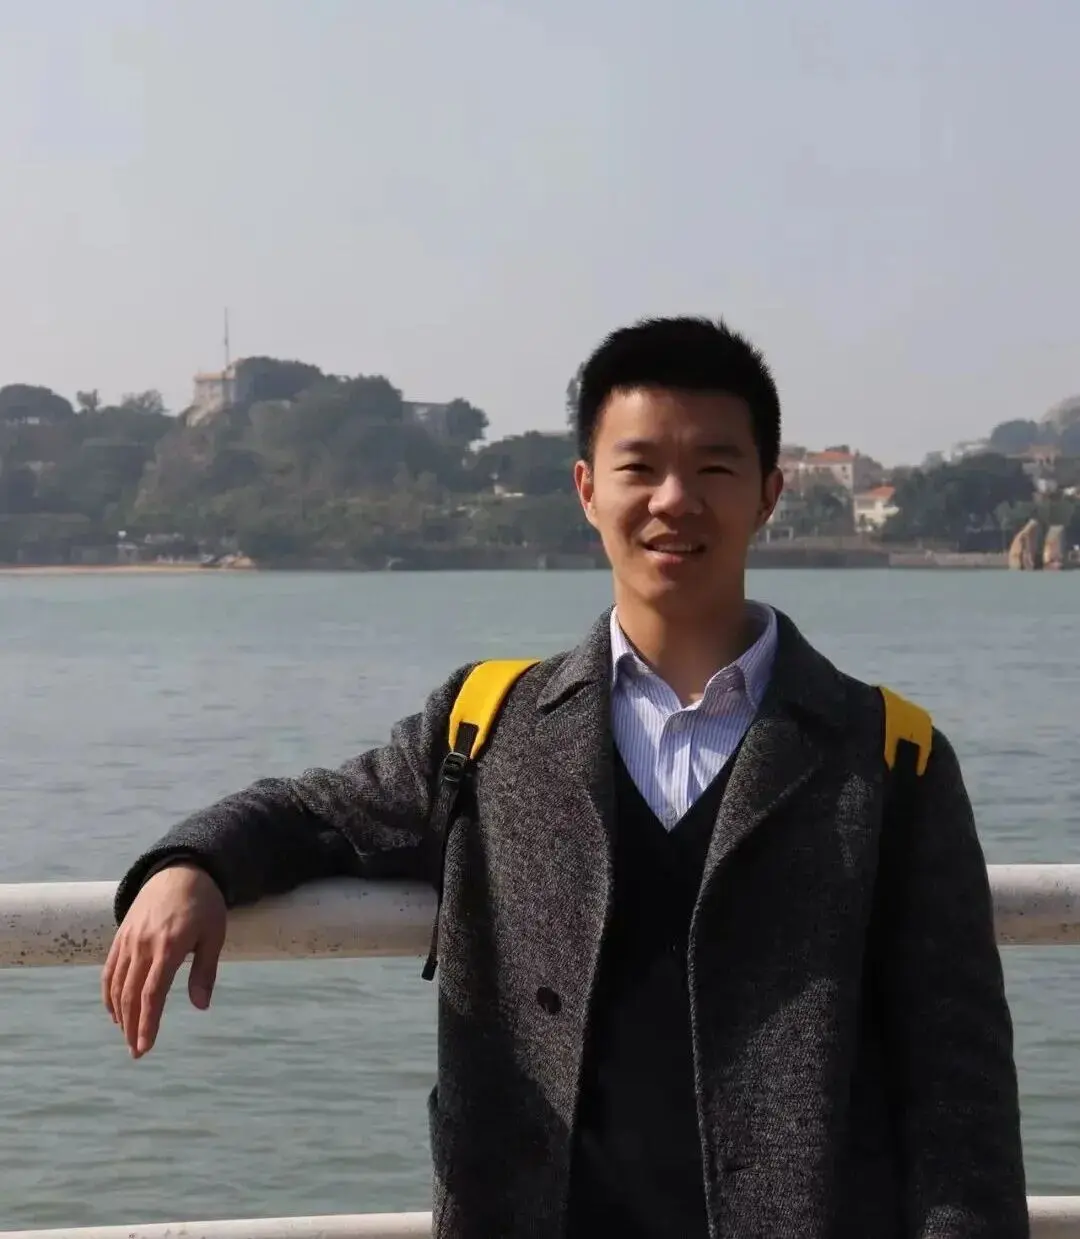
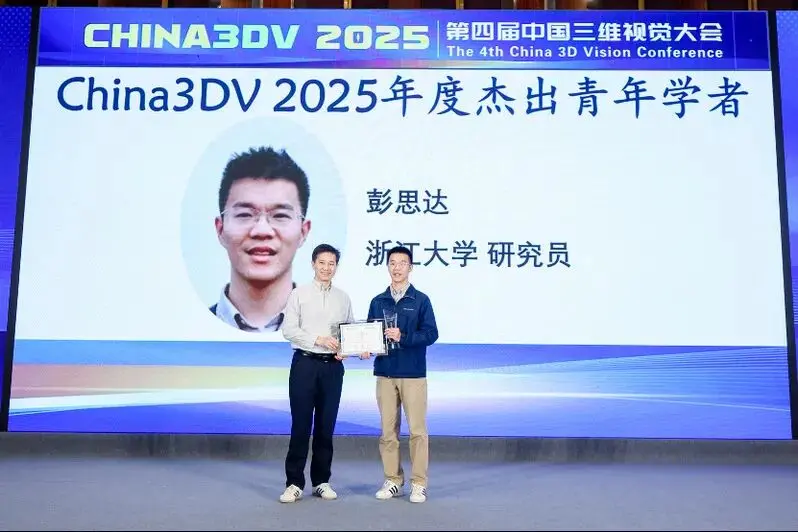
彭思达对这项技术很熟悉。六年前,彭思达师从浙大教授周晓巍读博,在浙大CAD&CG国家重点实验室的三维视觉研究团队ZJU3DV下研究的就是动态三维人体重建。很快他做的Neural Body入选CVPR 2021最佳论文候选,4K4D把动态场景的渲染推进到4K实时水平,FreeTimeGS把渲染质量推进到可落地的程度。实验室积累的技术后来被一家名为4DV.ai的创业公司采用,出现了在影视飓风的视频里。
技术走出了实验室,但彭思达没有继续留在这个赛道。
2023年博士毕业后,彭思达选择留校任教,入选浙江大学软件学院“百人计划”研究员,把研究对象从人体换成了街道。理想汽车找上门来,双方合作自动驾驶仿真系统,Street Gaussians被应用到了理想汽车的仿真系统中。
两年后,自动驾驶仿真技术逐渐收敛,彭思达又开始研究机器人导航。
从动态三维人体重建、自动驾驶仿真到具身智能,作为一个做了多年计算机视觉的研究者,彭思达反而认为视觉并不是智能的主角。对于像人一样思考、推理和规划,文本可能更重要;对于机器人学会操作,重要的是真正理解动作轨迹的因果性。
“到了具身领域,视觉模态仍然不是主角,动作模态才是主角。”
以下是AI科技评论与浙江大学软件学院“百人计划”研究员彭思达的对话,在不改变原意的基础上有所编辑。
01
端到端不是最优解
▎AI科技评论:你们最近10月份公开的SuperNav和ScaleNav两项工作,分别对应机器人导航的「大脑」和「小脑」。为什么你们要把导航拆成「大脑」和「小脑」?
彭思达:我们观察到一个现象。之前很多人希望训练一个端到端导航模型,也就是微调一个VLM,让它直接预测行动。但我们持续尝试以后发现,这样微调有两个问题。
第一,把VLM的能力变差了。VLM本来还可以做一些识别等任务,一旦要求它直接输出动作,它就变笨了。
第二,他们使用的VLM本身就不是那么聪明。我们试过一些3B或者4B模型,给它一张图片,问一些问题,发现它的空间推理能力很差。
但为什么要用这些模型?因为只有3B或者4B这种模型,才能微调得动,所以这就有点不那么本质。
▎AI科技评论:你认为VLM直接预测动作不够本质,甚至可能损害原有能力。那问题出在哪里?
彭思达:我个人的看法是大部分公司不具备训练出通用智能模型的能力,只有OpenAI这种基模公司才真正掌握了训练VLM的能力。
要给模型注入某种能力,一定不是微调,一定得在预训练过程中就有这样的过程。如果某个小团队以前从来没训练过这种模型,突然号称微调一下就获得了这种能力,我认为大概率是在某个小数据集上过拟合,实际上没有任何能力上的验证,也没有技术进步性。
▎AI科技评论: 你们最终选择了什么方案?
彭思达:我们认为导航最重要的是回归问题本身,怎么更好地做决策、交互,怎么在环境里面更好地移动。刚好Agentic System、Coding Agent这种架构出现以后,我们发现非常适合满足这个技术需求。
既然走Coding Agent路线,就以通用多模态大模型作为核心,让它负责整体规划、决策、推理。具体怎么在环境中执行,只需要给Coding Agent提供合适的工具,比如导航小脑。
SuperNav是做决策系统,决定接下来应该去哪,应该记住哪些东西,怎么规划导航路线。ScaleNav做的是导航小脑的事情,相当于大脑指定一个点,小脑负责怎么走过去。
▎AI科技评论:所以你更相信Agent路线?
彭思达:是的,我更相信通用多模态大模型+Agent这条路线。
端到端路线要让模型拥有很强的能力,模型肯定要很大。模型变大,最大的问题不是推理速度,而是通信速度。比如一个30B或者100B的模型,肯定不可能部署到本地机器人上,只能部署到服务器。虽然它在服务器上推理很快,但本地机器人上传图片观测到服务器,通信时间好歹得有一秒,这是短期的问题。真正操作东西的时候,肯定不能是一秒一次、一赫兹的水平,至少得是50赫兹。
所以端到端模型可以有这个能力,但因为实际交互频率,我觉得它打不过外挂底层交互工具这种形式。
▎AI科技评论:如果不让一个端到端大模型包办所有事情,那么一个通用智能体的感知、记忆、推理和行动应该怎么分工?
彭思达:感知、推理以及理解上下文基本上都可以交给VLM去做,记忆和行动是另外两个部分。
先说记忆,在空间里面不太好直接用图文去记,因为没有任何空间结构。而且现在SLAM工具非常成熟,用SLAM做一个基本结构化是没问题的。
所以记忆有两个层面:怎么构建记忆,可以用外部工具;理解记忆,还是用VLM本身。
其次是行动能力,也就是交互能力。机器人怎么跟外界直接交互,怎么预测Action。这个要求交互频率特别高,理想状态是50赫兹。所以这种情况下,最好也外包给一个小模型去做。
02
从元宇宙到具身智能
▎AI科技评论: 你是什么时候开始接触NeRF的?
彭思达: 2020年3月份,博士第二年下学期。当时我习惯每天看一下arXiv网站上的论文,看到了NeRF,发现技术上跟以前的方法区别很大,效果又特别好,非常有突破性。
▎AI科技评论: 后来为什么选择研究动态人体重建?之前好像不是做人体。
彭思达:2020年初,也就是NeRF出来的那年,我开始做动态人体重建。 我是一个很乖的学生,我老板(周晓巍)指哪儿我打哪儿。当时他跟华为有一个合作,一直在做人体建模相关的研究。
▎AI科技评论:华为为什么会关注动态人体?
彭思达: 动态人体和体积视频是等价的。他们要构建三维动态人体,也是为了放到VR眼镜里面看。
以前拍体积视频,要用128个相机,非常稠密。这个在好莱坞应用里面叫Live Stage,广泛应用于电影工业。华为希望把相机数量变得特别少,比如从64个相机变到4个相机。
后来我们做的Neural Body就是想解决非常稀疏视角下的问题,这在当时属于非常前沿的研究问题。
▎AI科技评论:Neural Body拿了CVPR 2021的最佳论文提名,你们当时是怎么找到突破点的?
彭思达: 我觉得是运气,当时的科研做法不是那么本质。本质的科研做法,一定是分析核心问题到底是什么,再从问题反推应该用哪些技术。
但我们当时的做法是,发现NeRF技术特别新潮,想赶紧把它用过来试一下。一用过来,确实就能解决问题,属于撞大运了。
▎AI科技评论: Neural Body做完以后,你们继续研究了AniNeRF、4K4D等工作。研究重点发生了什么变化?
彭思达: 三维数字人本质上等价于体积视频,我们做了三维数字人以后,一直贯彻研究风格,想做一套能够落地的系统。我们希望它能放在VR眼镜上,让更多用户观看,就需要从采集、重建、渲染、部署四个方面不断提升。
最直接的是渲染,比如Neural Body渲染很慢,大家戴上VR眼镜,是希望能以60 FPS去看的,所以得提升实时渲染能力。训练速度也是一样,用户采集重建的时候,我们希望普通用户能像拍照、拍视频一样录制内容,需要提升重建速度,这就是快速训练。
紧凑表示是另一个问题。如果一个体积视频要放到VR眼镜上,不可能像最早那种表征一样,需要几百GB或者几TB,这显然放不到VR眼镜上。我们把它压缩到一两百MB的程度,一切都是为了能落地到VR眼镜上,我们为此做了很多努力。
▎AI科技评论:后来这些技术真正进入了产业吗?
彭思达: 其实做得还挺好,最后也催生了一家创业公司,做体积视频的,叫4DV.ai。4DV.ai跟影视飓风合作很多,影视飓风有几期上百万观看量的视频提到过4K4D。但我没有参与4DV.ai,只是他们用了很多我们实验室的技术,特别是我博士中后期做的这些东西。
▎AI科技评论:既然体积视频已经有了一些应用,为什么后来又转向自动驾驶?
彭思达: 博士毕业之前,更多是我的博士生导师指哪儿我打哪儿,没想过到底有哪些具体应用。等我真正工作以后,对这方面的思考越来越深。我觉得体积视频确实有用,但应用面不广,顶多在影视或者VR里面用一用,这两个行业总体市场价值并不大。
自动驾驶,听起来想象空间就非常大,过去也是我们学计算机视觉的主要就业需求池。这也是后面转向自动驾驶领域的仿真系统最主要的原因。
▎AI科技评论:说到学计算机视觉,前段时间听到一个观点,认为视觉对智能能力的提升相当有限。
彭思达:首先这里智能有很多层次的定义。
最高层次的智能,是像人一样思考、推理、规划;也有一些比较低级的智能,比如操作。这种操作是不过脑子的、本能的智能,也可以叫本体智能。我不知道怎么定义这个词,大概就是这两类智能。
▎AI科技评论:现在大家讨论的通用智能,属于哪一种?
彭思达:现在大家讲通用智能,更多指第一种。真正像人一样思考,像人一样推理、决策、规划,这种肯定跟视觉没关系。文本本来就是最紧凑的一种信息。比如我们看侦探小说,或者各种书本知识,文字就是最好的推理、决策、规划的载体。在文字上做模型学习,肯定能更好地接触到这种智能。
但如果想从视觉里面学习,就非常冗余。我们看各种视频,视频里也不会莫名其妙体现出推理、规划、决策能力。所以从视觉去学习这些信息,基本是南辕北辙。
▎AI科技评论:那视觉对于动作智能又有什么作用?
彭思达:视觉是一个重要部分,但我觉得不是最重要的。
这种动作智能,是跟环境做交互的智能。视觉只是一个输入,不是最关键的部分。最关键的是把动作轨迹采集下来以后,怎么从动作轨迹里面学习动作智能。
视觉不管是在第一种高级的规划、推理智能里面,还是后面的动作智能里面,更多像一个外挂,或者说挂件。比如文本智能学好了以后,我再把视觉加进去,让它能够从视觉里面做规划、推理。
第二种动作智能,是先从动作轨迹里面学会怎么操作,理解动作本身以后,再把视觉加进去,让它能从视觉里面推理动作。但动作智能这里不是那么容易,因为很多时候,人操作东西跟视觉是紧耦合在一起的。
所以第一种文本智能,确实可以完全脱离视觉而存在,它自己就能做自己的事情。但第二种动作智能,确实一开始就得把视觉信息加进去,让它学会怎么从视觉里面推理出动作。不过,视觉模态还不是主角,动作模态才是主角。
03
在具身领域的新征程
▎AI科技评论:2023年,你博士毕业留校在浙大软件学院任教,是怎么进入自动驾驶领域的?
彭思达:我原来做的是三维人体重建,一下跳到一个跟先前技术链路区别很大的方向不太现实,就做了城市重建。底层都是重建技术,从人体到城市,切换起来还挺丝滑的。只需要把输入数据换一下,改一下特定问题。对我们整体积累的技术栈来说,并没有构成太大挑战,点云重建、构建可微、可渲染的三维表征等技术都是完全可复用的。
刚好那时候有一些自动驾驶公司找我们合作,我们就发现了自动驾驶仿真系统这个需求。
▎AI科技评论:最早是理想汽车找到你们?大概是什么时候?
彭思达:对,一开始是理想找我们。2023年下半年,就是我工作的那个下半年。我们当时做了一篇工作叫Street Gaussians,那篇工作应用到了理想汽车的自动驾驶仿真系统里面。后来因为这方面做得比较出名,也有很多的智驾公司找我们合作。
自动驾驶公司跟高校的产学研合作一直非常紧密,智驾的很多技术都是高校实验室提出来,再在智驾领域放大。我们和理想是典型的校企合作方式,他们规定好要研究哪些体技术需求,给我们提供计算资源、数据资源,我们就找学生去做。
▎AI科技评论:Street Gaussians和后来做的StreetCrafter,分别解决什么问题?
彭思达:Street Gaussians本身是在解决场景表征建模的问题,也就是如何在计算机里面表达动态街景。在Street Gaussians之前,没有一个工作能很好地把动态场景重建出来,甚至在计算机里面,都没有一个很好的表达方式。
我们发现,Street Gaussians虽然完成了重建,但如果视角偏移比较大,渲染质量就会比较差。所以StreetCrafter希望利用扩散生成模型引入视频生成先验来解决这个问题。
▎AI科技评论:为什么智驾公司需要把真实道路重建成仿真环境,而不是直接通过路测来验证算法?
彭思达:路测有很多问题。
第一是成本,比如我要测试一万次,如果在真实世界测一万次,成本就很高。第二是复现,比如某个版本的算法在路上出现了问题,我必须保证在一模一样的情况下,能够重新复现这个问题,来确认新版算法有没有解决它。
这都是真实世界存在的问题,但仿真不会有这些问题。因为仿真是在电脑里面跑,成本很低,遇到问题也完全可以复现出来。
▎AI科技评论:从实际合作经验看,高保真仿真距离大规模工业应用,最大的阻碍是什么?
彭思达:高保真仿真已经被工业界大规模使用了。如果要更广泛地应用,关键还是三维资产怎么重建,怎么规模化重建。比如车厂随便就能积累几千万公里的数据,怎么把这几千万公里的场景都重建成一个仿真环境。怎么鲁棒、快速地重建,还是比较麻烦的。
所以近两年,我的很多研究都在推进这方面,包括一系列工作,像InfiniDepth、InfiniSplat v1/v2/v3等就是不断往这方面推进。
▎AI科技评论: 做了两年多自动驾驶仿真以后,你为什么开始考虑转向具身智能?
彭思达: 最主要的原因是,我们前面已经发生过一次研究转向。刚工作的时候,我从体积视频转到了自动驾驶仿真。做了两年多,自动驾驶方面研究慢慢进入平台期,大家没那么强调自动驾驶技术了,自动驾驶仿真技术也在收敛了。
现在自动驾驶仿真技术方案,基本就是前馈高斯。数据堆上去,通过前馈高斯得到比较好的初始化高斯,再通过视频生成模型补全未观测区域,形成智驾仿真的方案。
这方面做好以后,我们肯定希望Move On,看看更有挑战的领域,所以今年年初开始想做一些机器人相关研究。
▎AI科技评论: 那为什么没有直接转向机器人操作,而是先从机器人导航切入?
彭思达: 每一次切入都得小心翼翼。如果一下子变化太多,我觉得很容易出问题。还是得对实验室学生负责,当然也是对自己负责。一旦切得太大,自己什么都不懂,学生做不出东西,我也做不出东西。
所以我们每次都是逐步切换,我本来做自动驾驶仿真,对自动驾驶、移动机器人就很熟悉。机器人导航本质上也是移动机器人,所以我们原来就很熟悉,就往这方面切。
▎AI科技评论: 你们最早做的Habitat-GS,就是把原来面向自动驾驶的仿真技术迁移到移动机器人上?
彭思达: 这是很简单的一次切换。原先我们做的是自动驾驶场景仿真器,Habitat-GS是做面向移动机器人的仿真器。这个仿真器里面可以放底盘、轮臂机器人、机械狗等各种机器人,本质上还是做仿真。这是我们开始做移动导航方面的第一个工作。
▎AI科技评论: 机器人仿真和自动驾驶仿真最大的区别是什么?
彭思达: 我觉得更多还是应用上的区别。机器人仿真需要支持更复杂的地形,也要直接支持移动机器人的各种任务。自动驾驶没有那么复杂的导航需求,沿着GPS路线往前开就行了。
但是移动机器人跟人一样,需要有像人一样的移动能力。比如你让它帮你拿杯水,它得知道怎么找到这杯水。这样一来,仿真器里面就需要构建类似的评测环境和指令。所以跟自动驾驶最大的不同,是更复杂的指令任务,以及与之对应的更复杂环境。
▎AI科技评论: 仿真环境除了用于测试,还能帮助机器人学习和提升智能能力,目前后者最大的技术瓶颈是什么?
彭思达:我个人觉得最重要的是强化学习技术。这里面又涉及很多问题,比如机器人跟三维世界模型交互时,反馈是很稀疏的,导致RL优化没那么好。但如果有一个全方面可微的世界模型,就能更好地保证RL收敛。
▎AI科技评论: 目前有比较成熟的解决方案吗?
彭思达: 目前还没有。不过最近有一篇比较火的工作叫SuperMimic,是一种比较好的尝试。以前英伟达做的SONIC用的是传统仿真器,这种在RL训练的时候,反馈很稀疏。SuperMimic引入了一个可微世界模型,能够很好地求解人形机器人和地形交互时的梯度。这种梯度不像传统仿真器,只有接触的时候才有梯度,而是在所有情况下都有连续梯度,这样就能很好地指引RL训练。
但它的世界模型还比较初步,只是建模人形机器人和平地的一种世界模型,不能做“Contact-Rich”那种复杂交互的世界模型。
04
三维重建不是空间智能
▎AI科技评论:在你的研究体系中,是怎么定义空间智能的?
彭思达:空间智能概念很宽泛,我认为只要是在三维空间中的智能,都叫空间智能。比如机器人就是一种典型的空间智能应用,机器人需要在三维空间里面做推理、交互、决策,当然自动驾驶也是。
▎AI科技评论:空间智能跟你过去研究的三维重建有什么区别?
彭思达:三维重建不是空间智能,关键在于怎么定义智能。我对智能的定义,标准比较高,智能一定是像人一样去思考。三维重建不涉及像人一样思考。
区别在于,三维重建只是把一些图片观测转成三维空间中的数字环境。空间智能研究的是这些智能体在三维环境里面怎么做推理、决策和交互。
▎AI科技评论:你之前在一些公开对话中谈到,未来的智能体不一定需要显式构建三维结构。你怎么看显式三维表示和直接从视频中学习空间规律这两条路线?
彭思达:我觉得这里最本质的问题,是智能体怎么在空间中做推理、决策、交互。
人做推理、决策、交互时,并没有用到显式三维几何。我们是在自己脑海里面构建出一种很模糊的场景状态,比如我要抓起那杯水,我构建出这种很模糊的状态,就能抓它了。
但学习空间规律,如果是通过训练学习,那需要显式三维结构。
所以这里有两个部分,真正做推理、决策、交互时不需要,但在学习时需要。因为我们得真正抓过这个杯子,才能知道这个感觉。
▎AI科技评论:机器人进入陌生环境以后,需要怎么探索、理解和记住周围空间?你之前提到过类似人类心灵地图的空间记忆。
彭思达:我们很快还会推出一篇新工作,叫SuperNav 1.5。之前的SuperNav没有用心灵地图,用的是比较朴素的图文长上下文记忆。跟普通VLM一样,把原来见过的图片存在记忆里面,把描述存在记忆里面,然后去索引。
SuperNav 1.5则利用SLAM设计了一种心灵地图。现在SLAM非常成熟,机器人在探索过程中可以不断建图,慢慢就有一个基本地图。此外,我们又在这个地图上标记一些关键点,让它知道每个区域有哪些东西,这样就能记住这些空间了。
▎AI科技评论:当前导航系统如果要走向能够长期自主行动的通用空间智能体,瓶颈在哪里?
彭思达:如果只有移动,我觉得技术瓶颈可能是怎么构建非常大规模的空间记忆。比如人在一个办公楼工作过以后,很莫名其妙地就能把一整栋楼记下来。但现在导航机器人没有这个能力,每次还得非常慢地重新推理一遍。
不过这在应用上可能也不是那么大的问题,在学术上倒挺有意思。我很好奇人的大脑机制如何运行,使其能很自然地记住自己走过的地方。
05
后记
彭思达有一个习惯,遇到不懂的东西,就每天磨一点。
刚开始读一篇论文,他也可能完全看不懂,甚至需要把论文背下来。但只要每天反复读、反复敲代码,一两周后,原本陌生的概念就会突然变得熟悉。这个过程,他从读博一直延续到现在。研究具身智能时,面对一堆全新的知识,他还是每天学一点,直到慢慢建立起自己的认知。
彭思达从中得到了一种“微快乐”,学会一个新东西,就开心一点,然后继续学下去。
这种研究习惯被总结成了一份开源手册,在GitHub上斩获超1.5万颗星。博士毕业前后,彭思达开始在GitHub上维护这个名为Learning Research的项目,把自己做科研的经验整理下来。从如何入门科研、寻找重要问题,到设计实验、写论文、做学术报告,几乎把一名博士生需要经历的环节都拆解了一遍。
过去八年,彭思达的研究对象从动态人体一路延伸到城市街景,最近又转向机器人导航。方向在变,但他对研究的追求一直很明确,要做Top-down研究。
先想清楚要做出一个什么样的产品或系统,再从应用出发,一层层拆解问题,直到最基础的技术环节。
成为导师后,彭思达曾一度太在意帮学生发论文,反而偏离了解决问题本身。直到后来,他重新回到一线,亲自拆解问题、设计技术流程和分析实验现象,再带着学生一起做,才找回自己最享受的科研状态。
聊到最后,彭思达说:“自己最舒服的状态,还是作为一名一线科研人员去做研究。”
这也是彭思达身上最有意思的地方:既有把知识一点点磨透的耐心,又有把复杂问题拆解成一条条技术路线的探索欲。对他来说,科研不完全是一场追逐成果的竞赛,更像是不断认识新事物的过程。
学会一个新东西,就有一点“微快乐”;然后,再去学下一个。
欢迎添加作者李秋悦微信 lqy4605 ,最近关注世界模型、物理AI~
雷峰网 雷峰网