「刚才是谁说,打算种花?」
对人来说,回想一下刚才的对话和场景,往往就能回答。但对一个看过数小时视频的 AI 来说,这个问题并不简单:它可能找到了花、找到了几个人的名字,也找到了关于种植的讨论,却依然无法确定,究竟是谁提出了这个计划。
线索找到了,关系却没有记住。
这揭示了多模态智能体长期记忆面临的一个关键问题:记忆不应该只是对过去信息的简单存储,更应该理解经历中的人物、物体、行为与事件之间的关联。
尤其当 AI 助手开始长期陪伴用户,记忆的价值就不再局限于回答某一个问题。它还需要逐渐理解用户是谁、做过什么、关注什么、有什么偏好,并将每一次交互中的新经历与已有记忆联系起来,在持续使用中不断积累、修正和沉淀,最终形成真正个性化的记忆。这也是智能体实现持续学习与自我进化(RSI)的重要基础。
围绕这一问题,来自浙江大学与联想集团的研究团队合作提出 EM²Mem(Event-Centric Multimodal Memory),以事件为中心构建多模态长期记忆。它不再孤立地保存视频画面、语音对话和文本信息,而是在记忆构建阶段,就将同一事件中的人物、物体、行为和时间线索关联起来,让 AI 不仅能找到发生过什么,还能理解事情与谁有关、前后经历如何衔接。
核心思路是:以事件组织经历,以关联沉淀记忆,以持续积累支持多模态智能体持续学习与个性化。
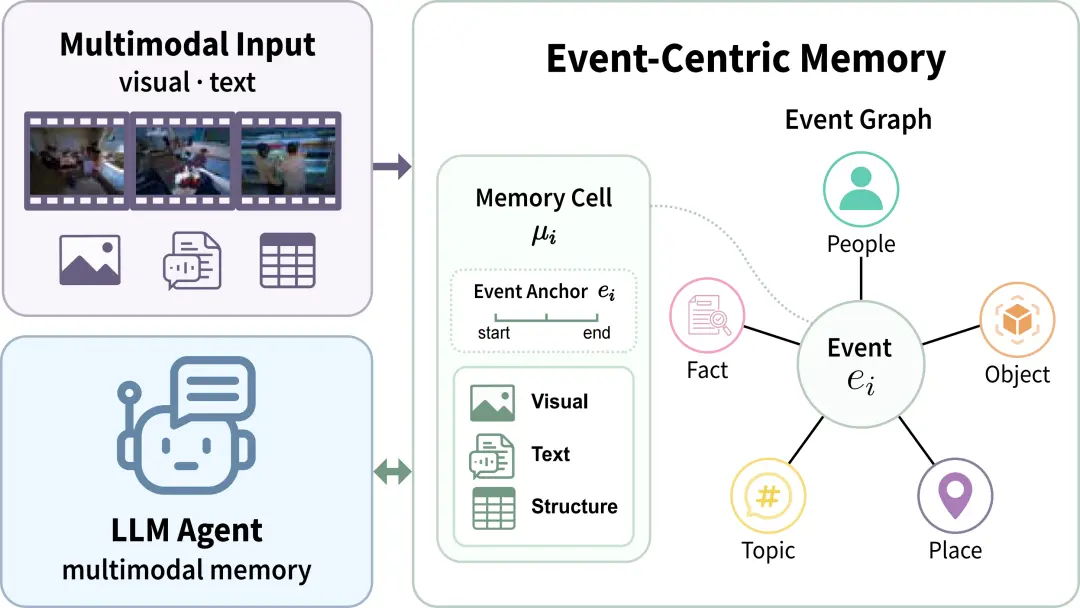
图 1|EM²Mem 以事件为中心构建多模态长期记忆。
-
论文:EM²Mem: Event-Centric Multimodal Memory for Large Language Models
-
会议:EMNLP 2026 Findings
-
论文链接:https://arxiv.org/abs/2609.00551
-
代码已整合至:https://github.com/zjunlp/LightMem-Ego
01|为什么搜到相关内容,还不等于记住?
长视频中的证据,往往既零散,又跨模态。
一个人的名字可能出现在对话里;他拿着什么,需要看画面;某项任务是否完成,又要结合前后几段经历才能判断。用户提出的问题,却通常是完整的:「谁提出了这个计划?」「这件事后来怎么样了?」「我平时到办公室后会做什么?」
不少已有方法会将视频处理成描述、转写、关键帧或图谱事实,分别存储,再在提问时检索相关内容。这样做能找到线索,但模型还需要临时判断:这些线索说的是不是同一件事?谁和谁有关?先后顺序是什么?
论文将这一瓶颈概括为 retrieve-then-align:先检索,再对齐。
如果某条证据单独看不够相关,它甚至可能在检索阶段就被过滤掉,失去与另一条线索共同解释问题的机会。
EM²Mem 调整了这个顺序:align-then-retrieve,先对齐,再检索。把组织证据的工作提前到记忆构建阶段,让后续问答可以直接围绕事件展开。
02|给一段经历建立事件档案
可以把 EM²Mem 中的事件记忆单元,理解为一份带有时间地址的事件档案。
系统先将长视频划分为较短的基础片段,论文采用的典型粒度是 30 秒。每个片段对应一个事件锚点,记录其身份和起止时间,并把相关证据挂接到同一个地址下。
这个锚点提供了共同索引:画面和对话由此能够指向同一段经历,而不是只因为关键词相似才在回答时被拼到一起。
第一层:记清当时发生了什么
每个事件单元保留关键帧、视觉描述、对话转写,以及动作、物体、话题、场景、实体等结构化字段。比如一段围绕花艺计划的讨论,既记录谁说了什么,也保留画面中的花和花瓶。
第二层:保留前因后果
仅看 30 秒,有时不足以理解整件事。EM²Mem 因此构建 3 分钟、10 分钟、1 小时等多尺度上下文,将更长时间范围的文本和视觉摘要关联回基础事件,让局部细节与较长的叙事保持连接。
第三层:连接不同经历,积累长期规律
情节图连接具体事件中的人物、物体、地点、话题和时间关系,语义图进一步组织习惯、偏好、日常规律和稳定关系。这些高层信息仍然链接到支持它们的事件,便于回溯依据。
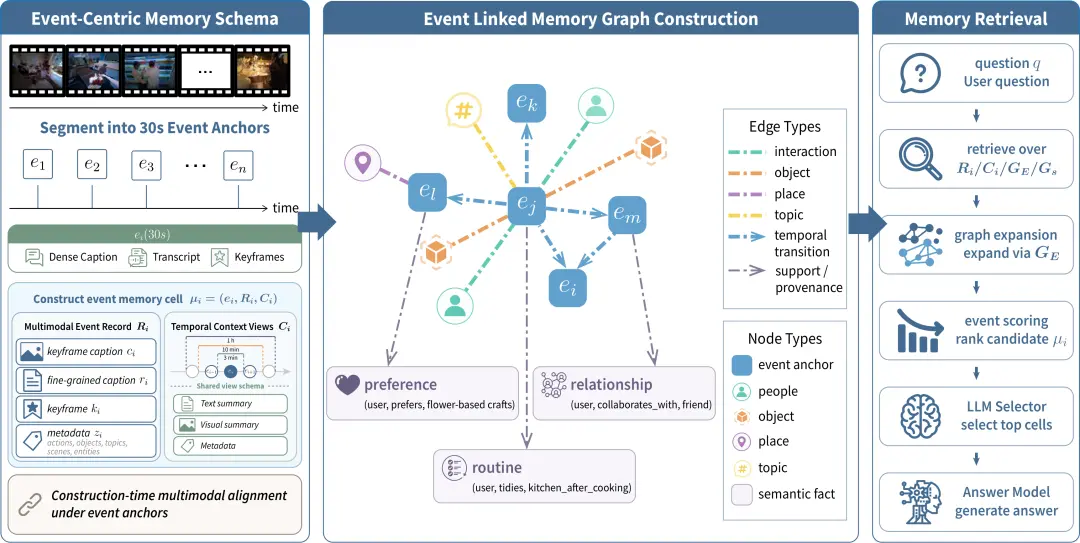
图 2|从左到右:构建事件记忆单元,以情节图和语义图连接经历,再根据问题检索、扩展和筛选证据。手机阅读可放大查看。
当问题到来时,系统先定位相关事件,再沿时间或实体关系补充线索,经由选择器保留必要证据,形成一份紧凑的回答上下文。对于需要视觉核验的问题,还可以加入少量关键帧。
这使得模型能够在回答时同时获得:发生了什么、与谁有关,以及证据来自哪里。
03|一个案例:到底是谁打算种花?
论文用一个多人讨论案例,展示了两种记忆组织方式的区别。
问题是:谁打算种花(Who plans to grow flowers)?
讨论中同时出现了花、花瓶、手工制作,以及不同参与者的发言。WorldMM 检索到了与花有关的多个片段,但人物与计划之间的关联仍然不够明确,最终将答案误判为 Tasha。
其中,Tasha 相关片段里出现了 planning,与问题中的 plans 语义接近,却没有明确说明种花计划属于谁。这种局部语义匹配可能干扰了模型对计划归属的判断,让相关片段中的人物被误当作计划的提出者。
EM²Mem 则在构建记忆时保留了 Katrina 与相关计划、物体及时间上下文之间的关联。进一步读取相关事件后,系统能够结合她关于种植周期的讨论,以及后续「我们也可以种」的表述,区分其他人的相关发言,得到正确答案 Katrina。
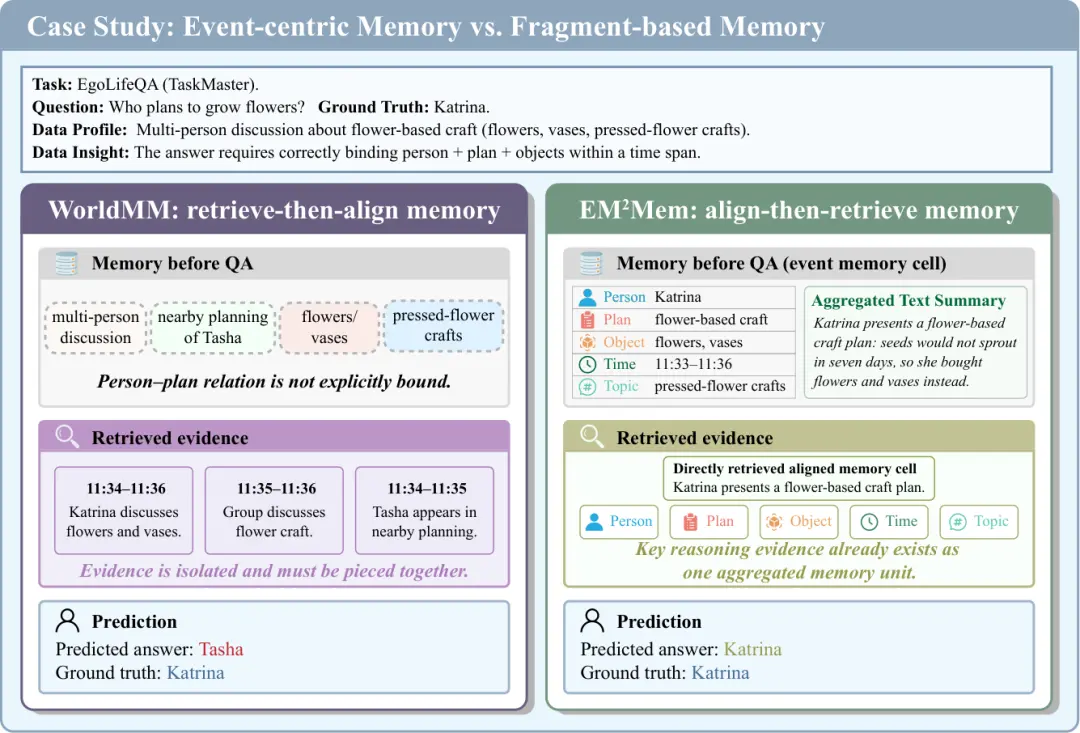
图 3|同样围绕花找到线索,关键差别在于能否保留人物与计划之间的关联。该图展示论文中的定性案例。
这个案例把论文的动机说得很直观:面对多人、多物体、多时间片段,检索内容的相关性之外,还需要记忆组织保留事件内部的关系。
04|实验:答得更准,证据也定位得更好
研究在三个长视频选择题问答基准上评估 EM²Mem,覆盖第一视角日常经历、超长第一视角推理和开放领域长视频理解。
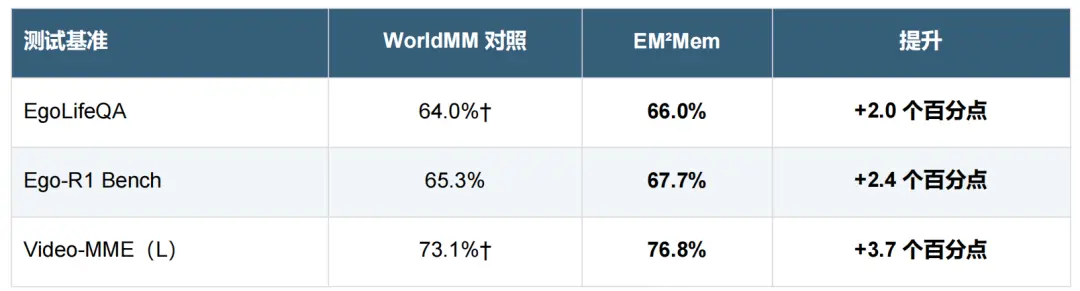
† 为论文在与 EM²Mem 相同评测设置下复现的 WorldMM 结果;Ego-R1 Bench 对照采用 WorldMM 原文报告结果。WorldMM 原文在 EgoLifeQA 和 Video-MME(L)上的平均准确率分别为 65.6% 和 76.6%。
除了最终答案,论文还检查了系统是否找到了对应的证据片段。
在严格的 30 秒事件级证据召回评估中,只有命中标注的事件片段才算正确。EM²Mem 的 Top-5 召回率达到 30.8%,比 WorldMM 五轮迭代检索的 23.8% 高出 7.0 个百分点;Top-1 召回率也达到 23.0%。
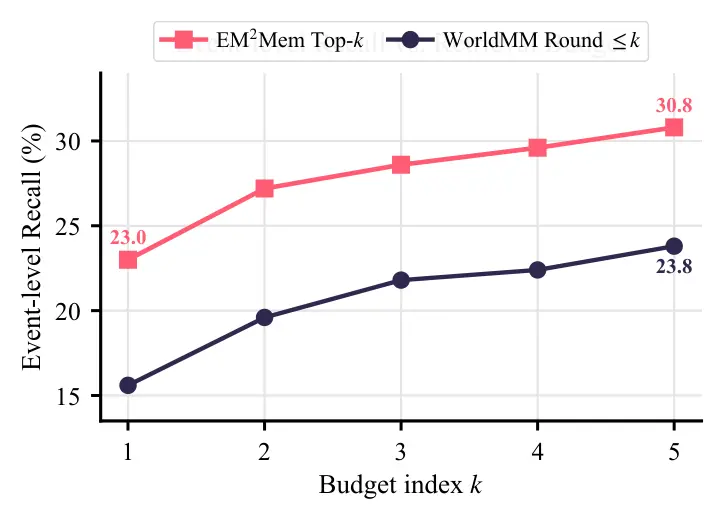
图 4|事件级证据召回。横轴对 EM²Mem 表示返回的 Top-k 事件数,对 WorldMM 表示最多 k 轮检索,两者是不同的预算口径。
这项结果表明,事件记忆更容易被准确取回,也让准确率之外的记忆质量变得可检查。
05|结构化信息与提前对齐为何有效
性能提升来自哪里?论文进一步比较了两件事:视觉信息以什么形式进入记忆,以及多模态信息何时完成对齐。
在 EgoLifeQA 前 250 道题的分析实验中,研究比较了原始帧、扁平化描述和结构化事件字段。结果显示,结构化事件字段 + 构建时对齐的组合达到最高的 71.2% 准确率;同样使用结构化字段、但在检索时才融合证据,准确率为 68.0%。
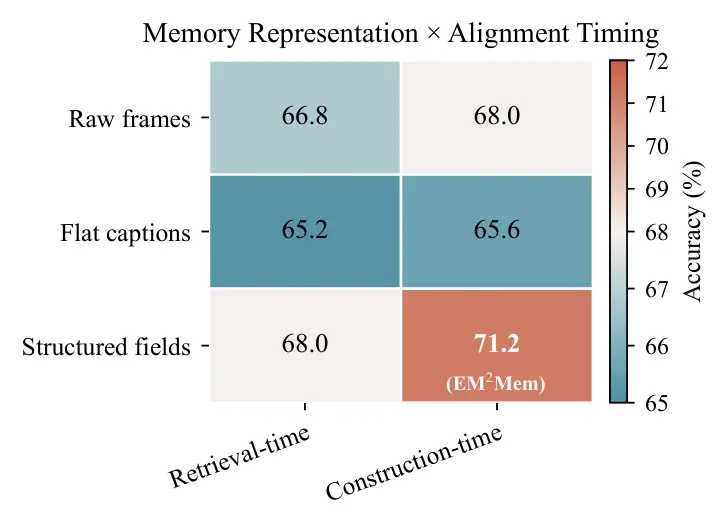
图 5|结构化事件字段与构建时对齐相结合,得到这组分析实验中的最佳结果。此处评测的是前 250 道题子集,与上文完整基准结果不同。
结构化字段将人物、动作、物体等线索显式保留下来,提前对齐则让这些线索在检索之前就具有共同的事件归属。两者结合,使多模态观察更容易转化为可检索、可用于回答的证据。
06|把整理工作提前,让反复问答更轻
在 EgoLifeQA 的推理效率对比中,EM²Mem 相比 WorldMM:
-
单次问答平均耗时从 459.00 秒降至 98.21 秒,约加速 4.67 倍。
-
评测中推理阶段的总 token 用量从 42.03M 降至 15.27M,减少 63.66%。
这些收益来自已经组织好的事件记忆:提问时可以读取、筛选相关证据,减少临时整理多模态线索的工作。
更重要的是,记忆构建一次,后续查询就可以持续复用。随着提问次数增加,构建开销被逐步分摊,较低的单次查询成本会进一步转化为端到端的优势。在论文的 EgoLifeQA 评测中,计入记忆构建与 500 次问答后,端到端总耗时从 WorldMM 的 318,210 秒降至 105,160 秒,约加速 3.03 倍。
附录进一步分析了查询次数与累计成本的关系。按论文实际评测执行流程估算,约 24 次查询即可摊平额外的构建时间。按输入与输出 token 等权计数,约 536 次查询后,包含构建阶段的总 token 用量也开始低于 WorldMM。继续复用同一份记忆时,端到端平均每次查询的耗时和 token 用量都能进一步体现 EM²Mem 的优势。
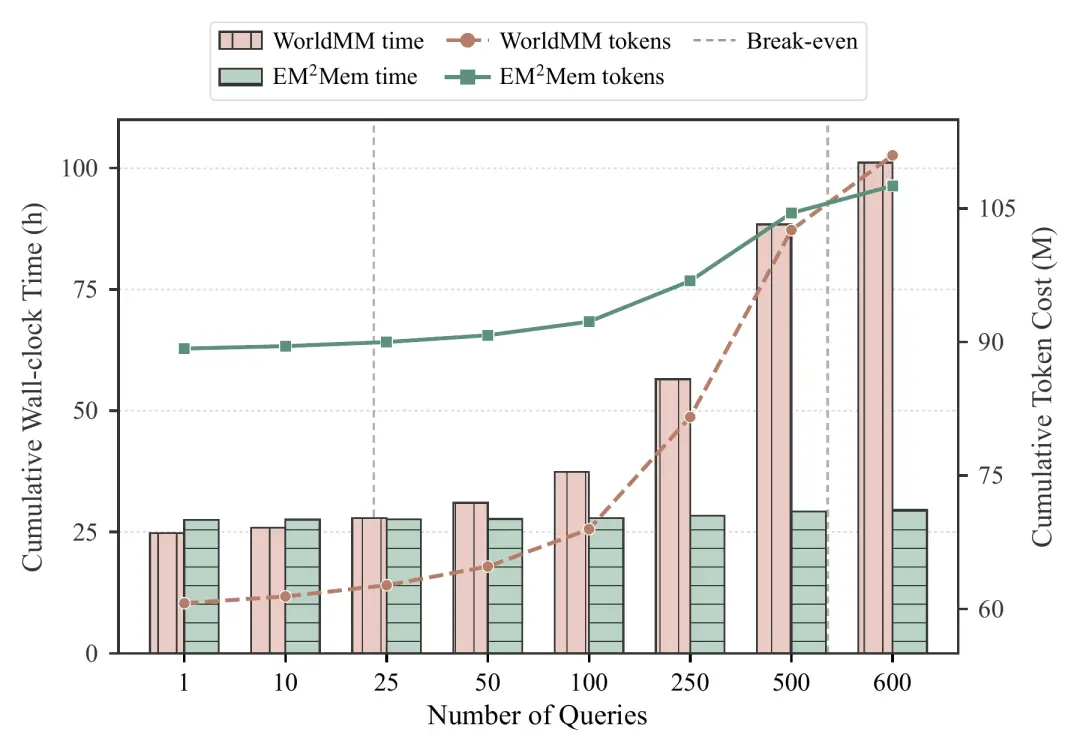
图 6|包含记忆构建与后续问答的累计开销。柱状图对应总耗时,折线对应总 token 用量,竖向虚线标示两种成本各自的交点。超过相应交点后,EM²Mem 的累计开销及均摊到每次查询的开销均低于 WorldMM。耗时采用论文的实际评测执行流程口径,token 按数量等权统计。
这也契合长期记忆的使用方式。个人经历、视频档案或企业知识通常会被多次查询,提前组织好的事件记忆能够在持续使用中发挥价值。遇到需要确认颜色、小物体等视觉细节的问题时,系统还可以回到关键帧核验。
从记忆研究到应用:
多模态智能体记忆系统 LightMem-Ego
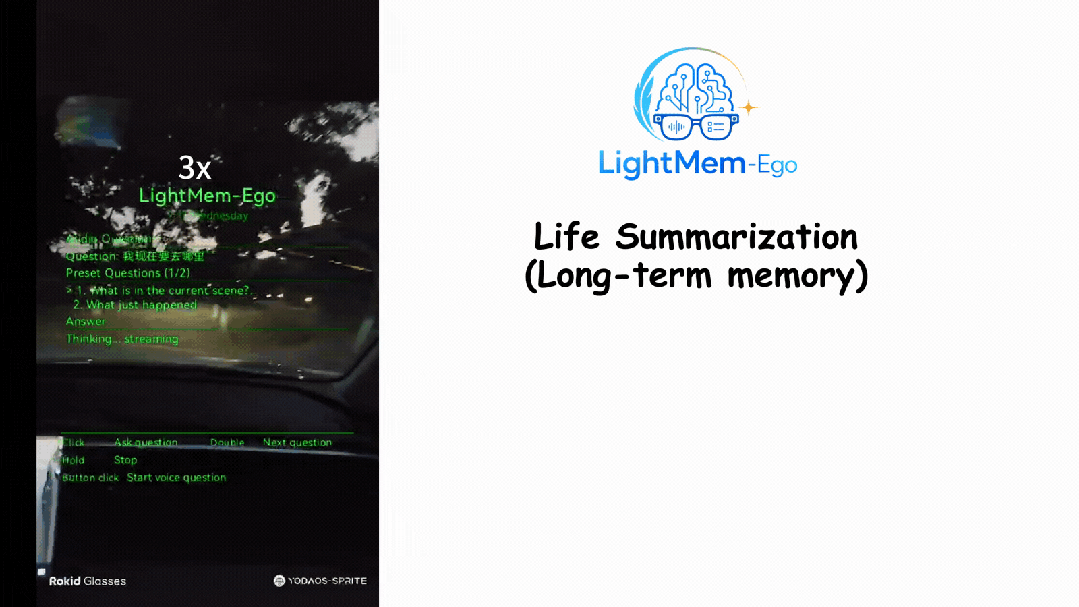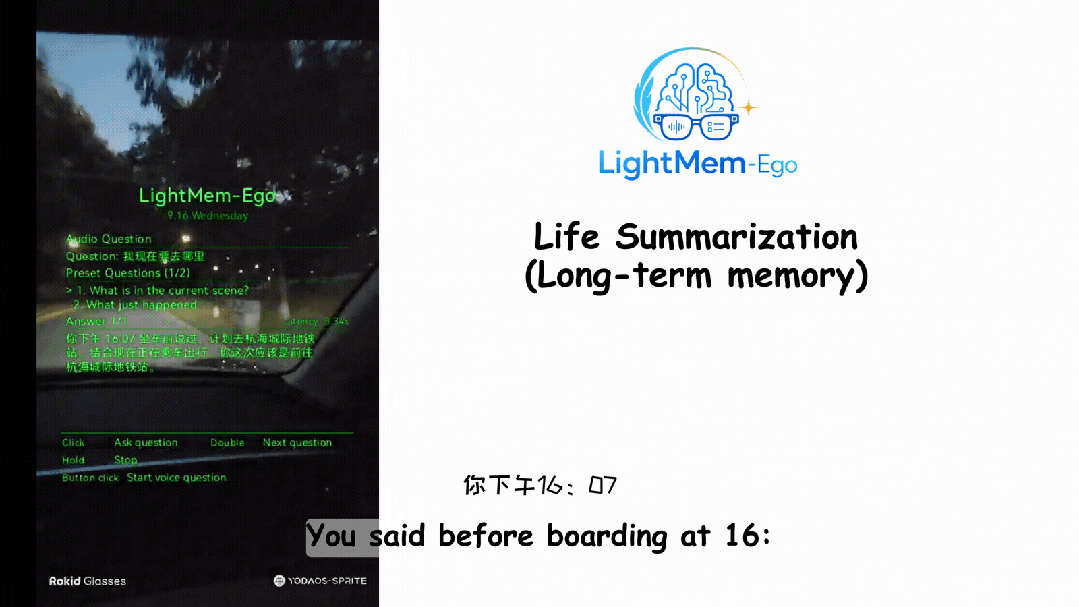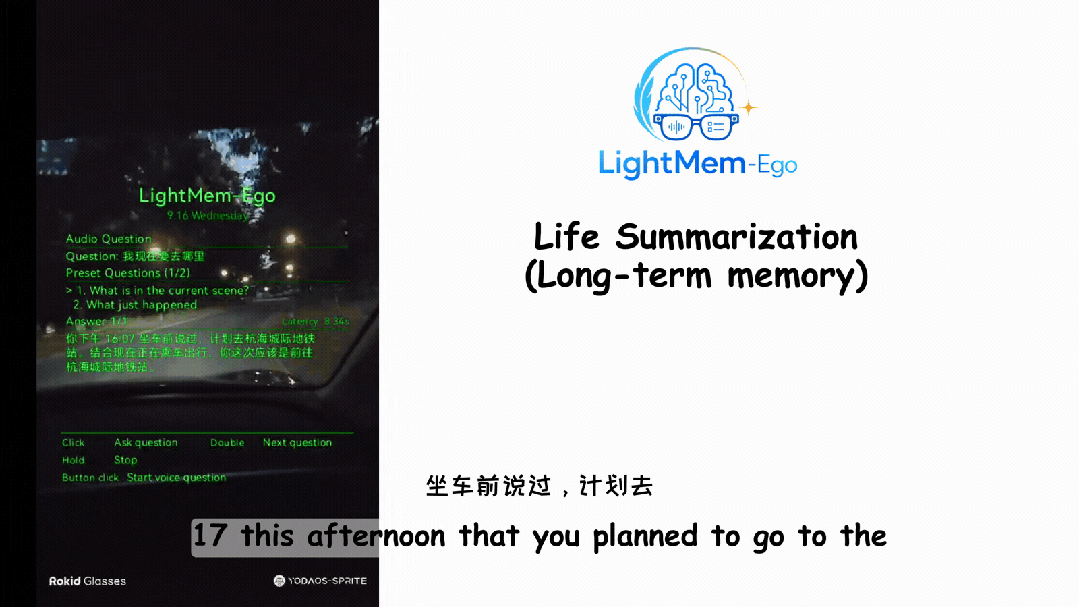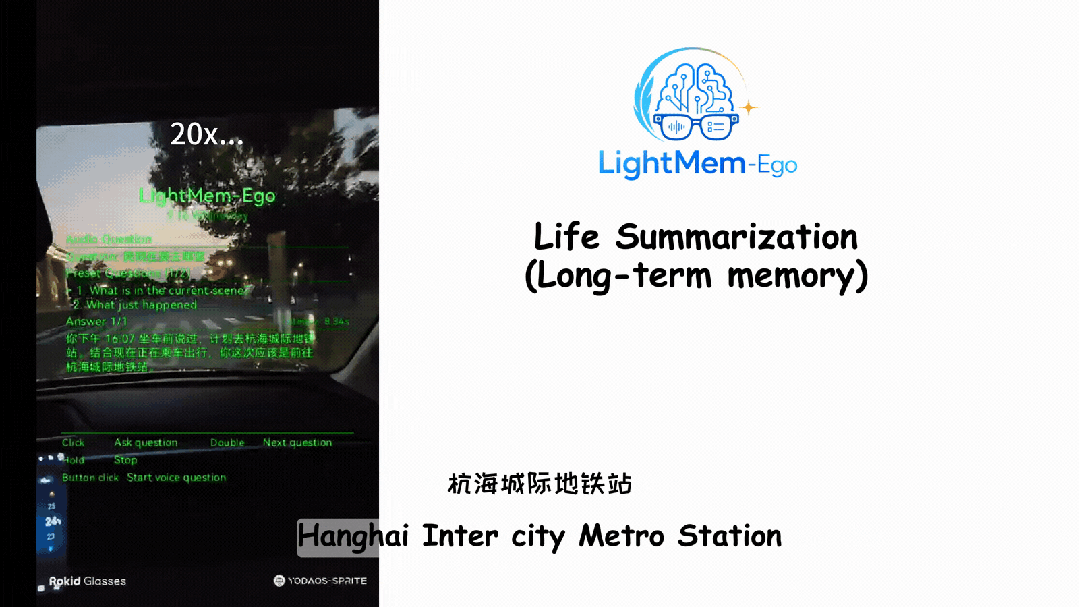
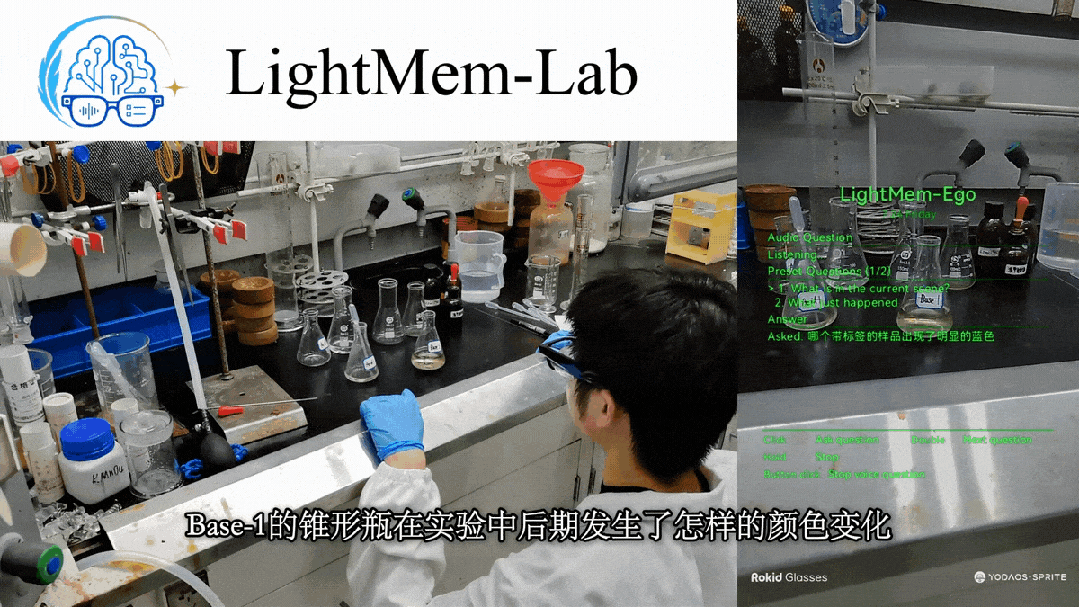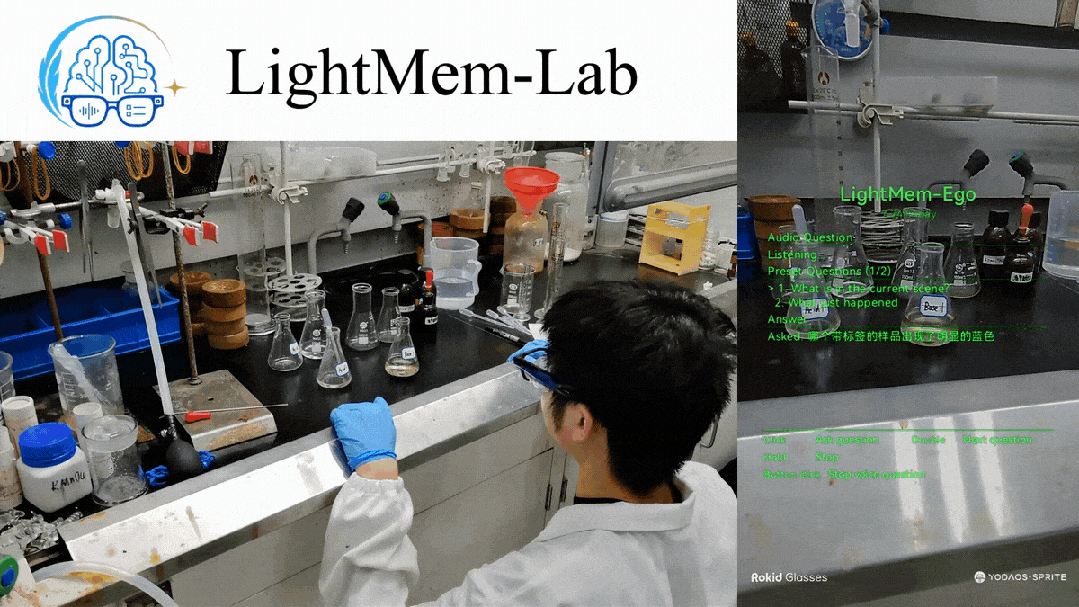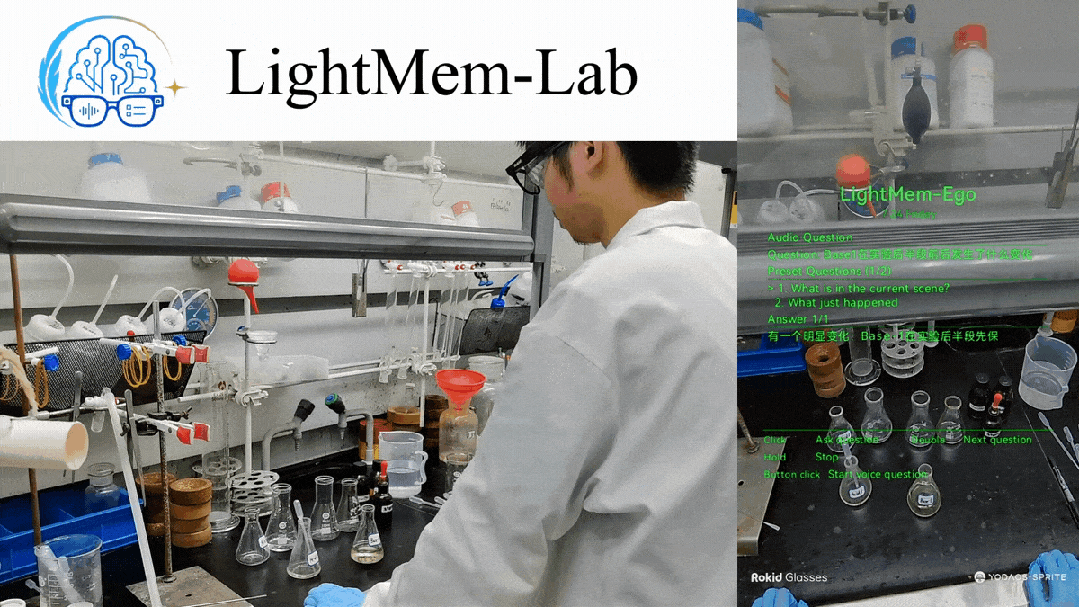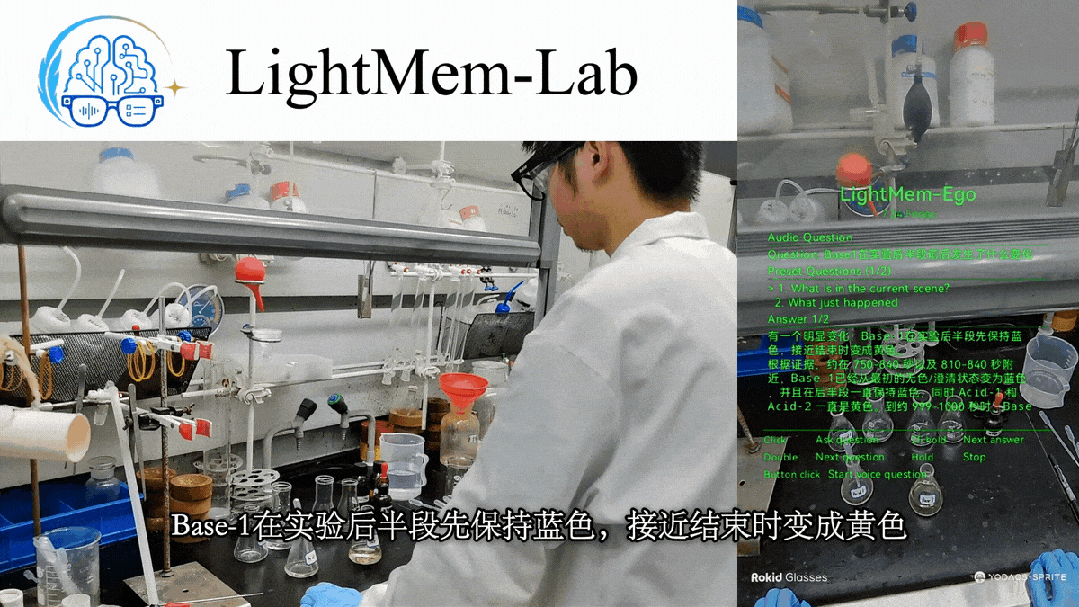
基于 EM²Mem,团队进一步搭建了多模态智能体记忆系统 LightMem-Ego,并提供了 2 个应用案例,让多模态长期记忆走进日常生活与科研工作。
个人生活助手:让 AI 记住生活中的点点滴滴。通过手机和智能眼镜记录日常经历,AI 可以帮助用户找回随手放置的物品、回顾过去的对话、整理生活笔记,打造个性化助理。
科学实验室助手:让 AI 记住实验过程。通过持续记录实验过程中的视频、操作和对话,AI 可以帮助科研人员回溯实验步骤、查找关键操作与实验现象,整理实验记录,为科学实验工作提供帮助。
-
LightMem-Ego 技术报告:https://arxiv.org/abs/2607.11487
-
查看系统技术细节:https://github.com/zjunlp/LightMem-Ego
LightMem-Ego 由陈毅俊、肖博艺、赵一先、何溢、夏浩庭、郭响宇、徐步强等同学共同开发。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com