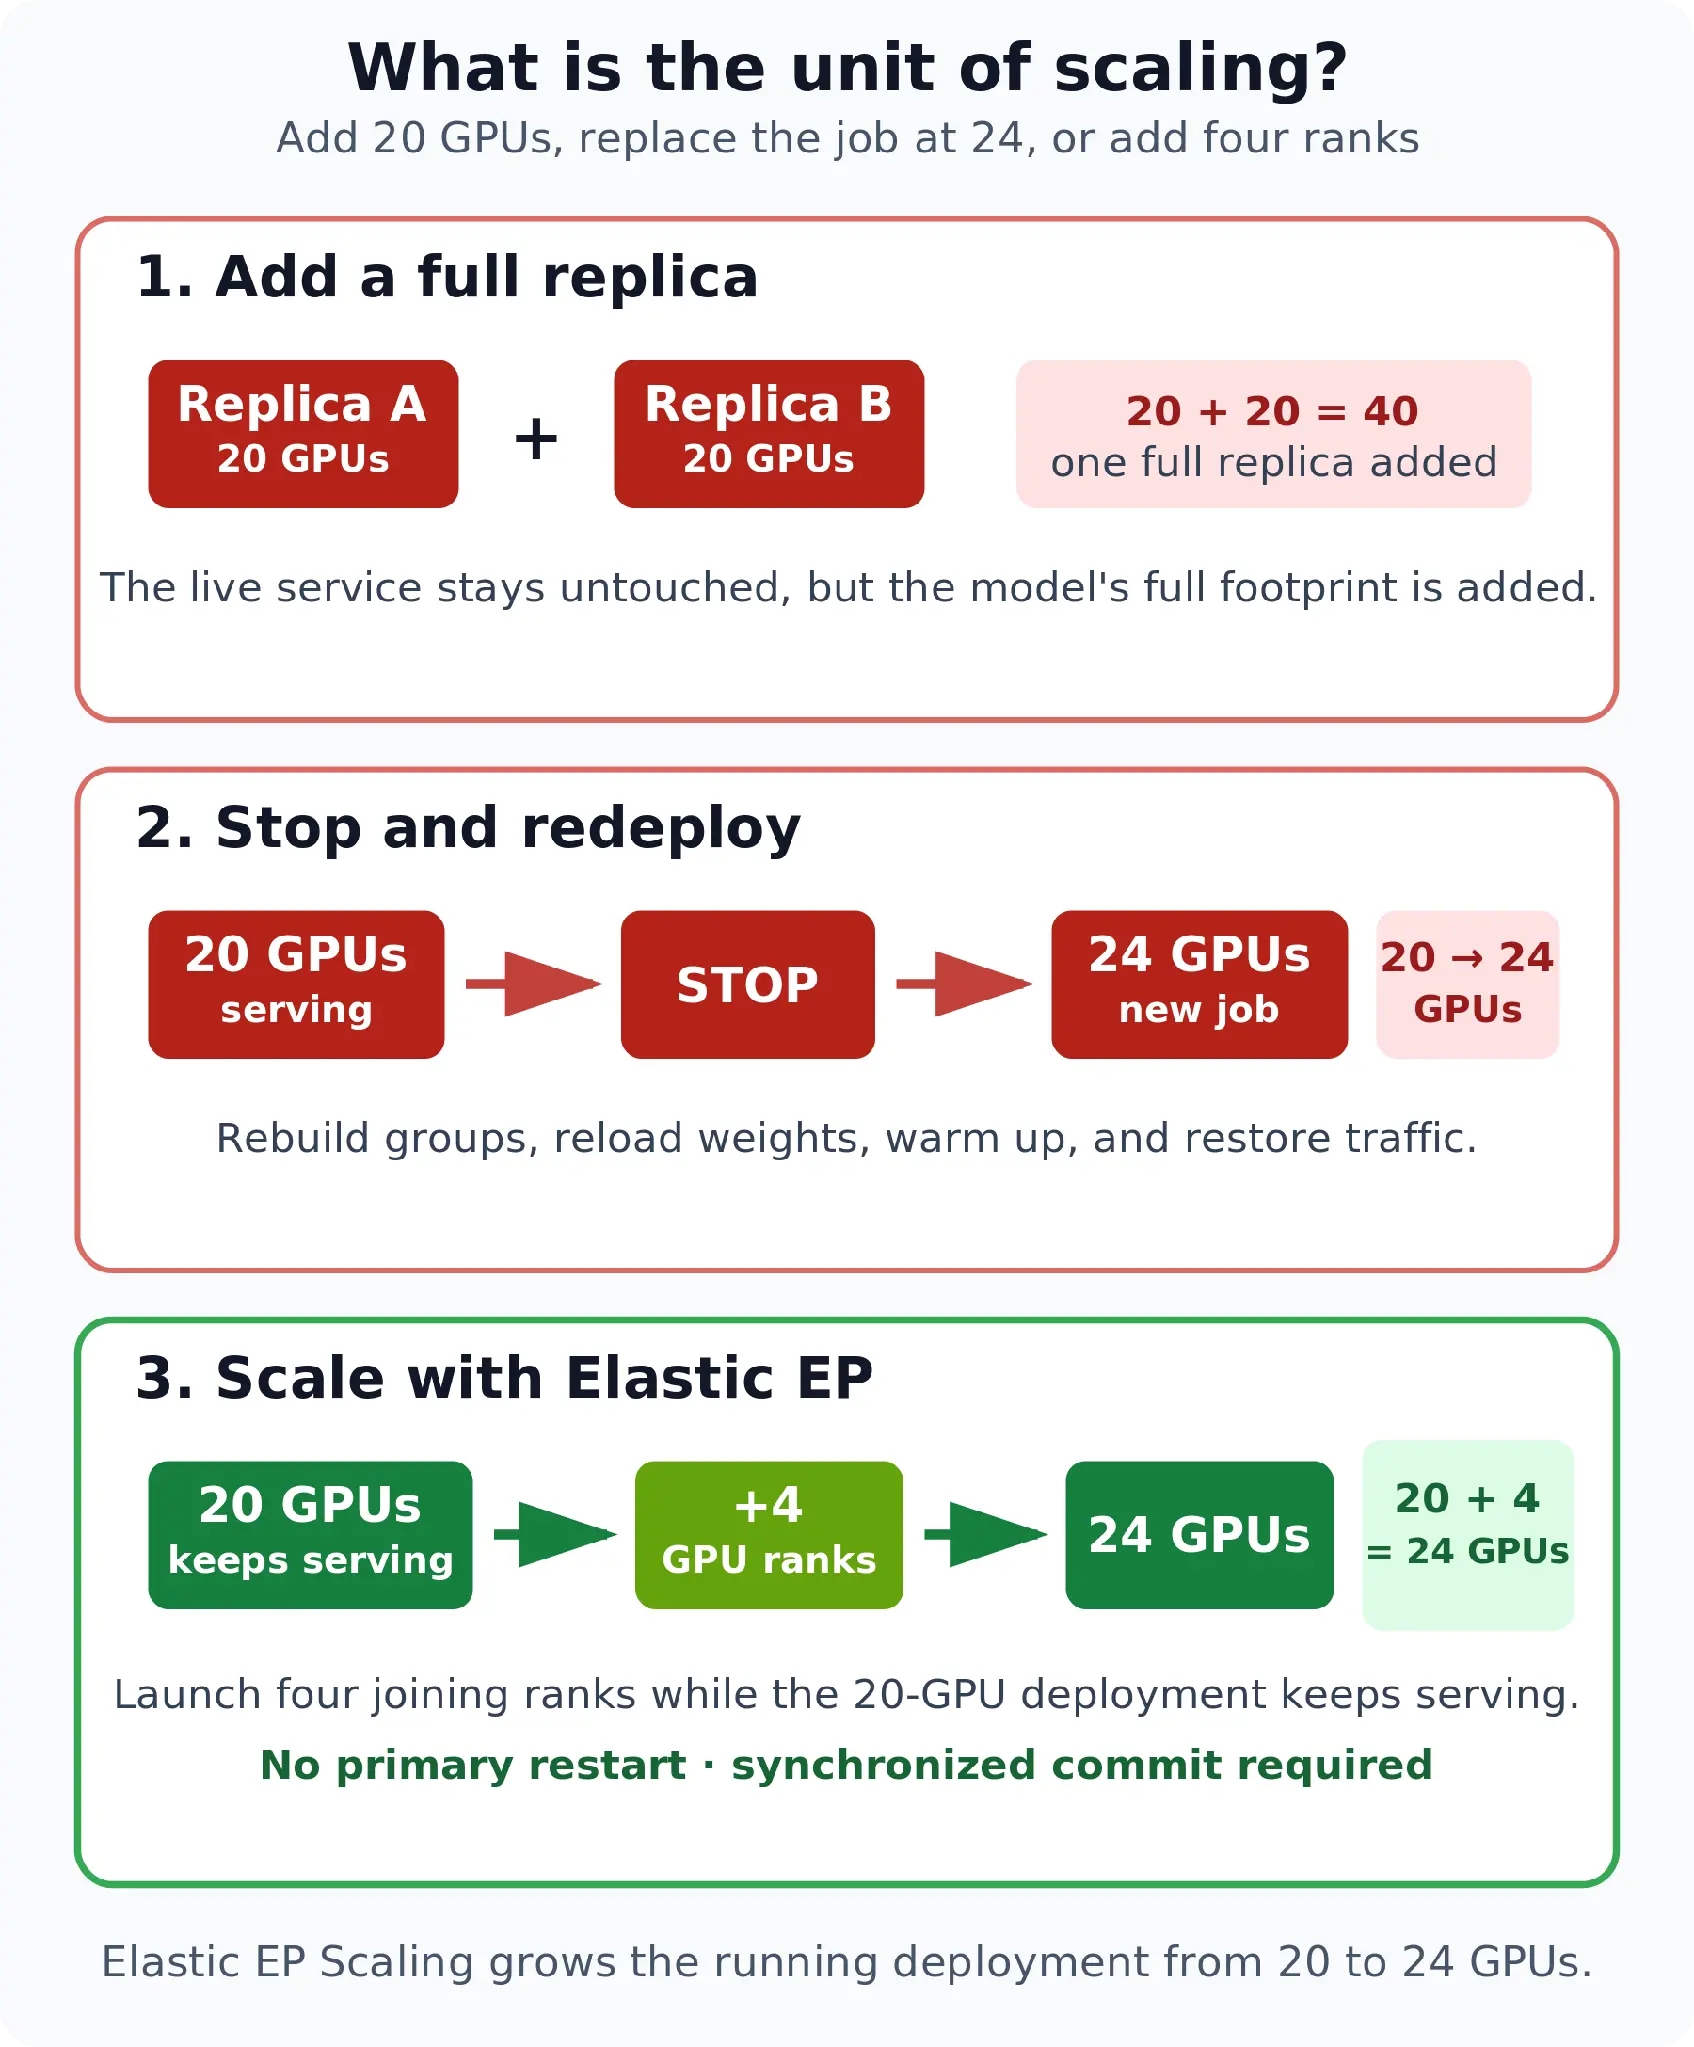
线上推理服务的负载会不断变化,系统必须在吞吐和延迟目标不被破坏的前提下调整容量。对于大型 Mixture-of-Experts (MoE) 模型,传统选择主要有两种:一种是水平扩容,即增加一个完整模型副本;另一种是垂直扩容,即以更宽的 expert-parallel 拓扑重启部署。
水平扩容的好处是当前服务不中断,但代价是需要再放下一整份模型。垂直扩容可以用更小的增量达到目标拓扑,却必须重建分布式状态、重新加载模型并完成预热。SGLang 这次提出的 Elastic EP scale-up 则走第三条路:在运行中的 MoE 部署里直接加入新的 GPU ranks。
在文中的示例中,一个 20-GPU 部署无需替换现有作业,也无需新建完整 20-GPU 副本,而是直接增加 4 个 ranks,扩展到 24 GPUs。
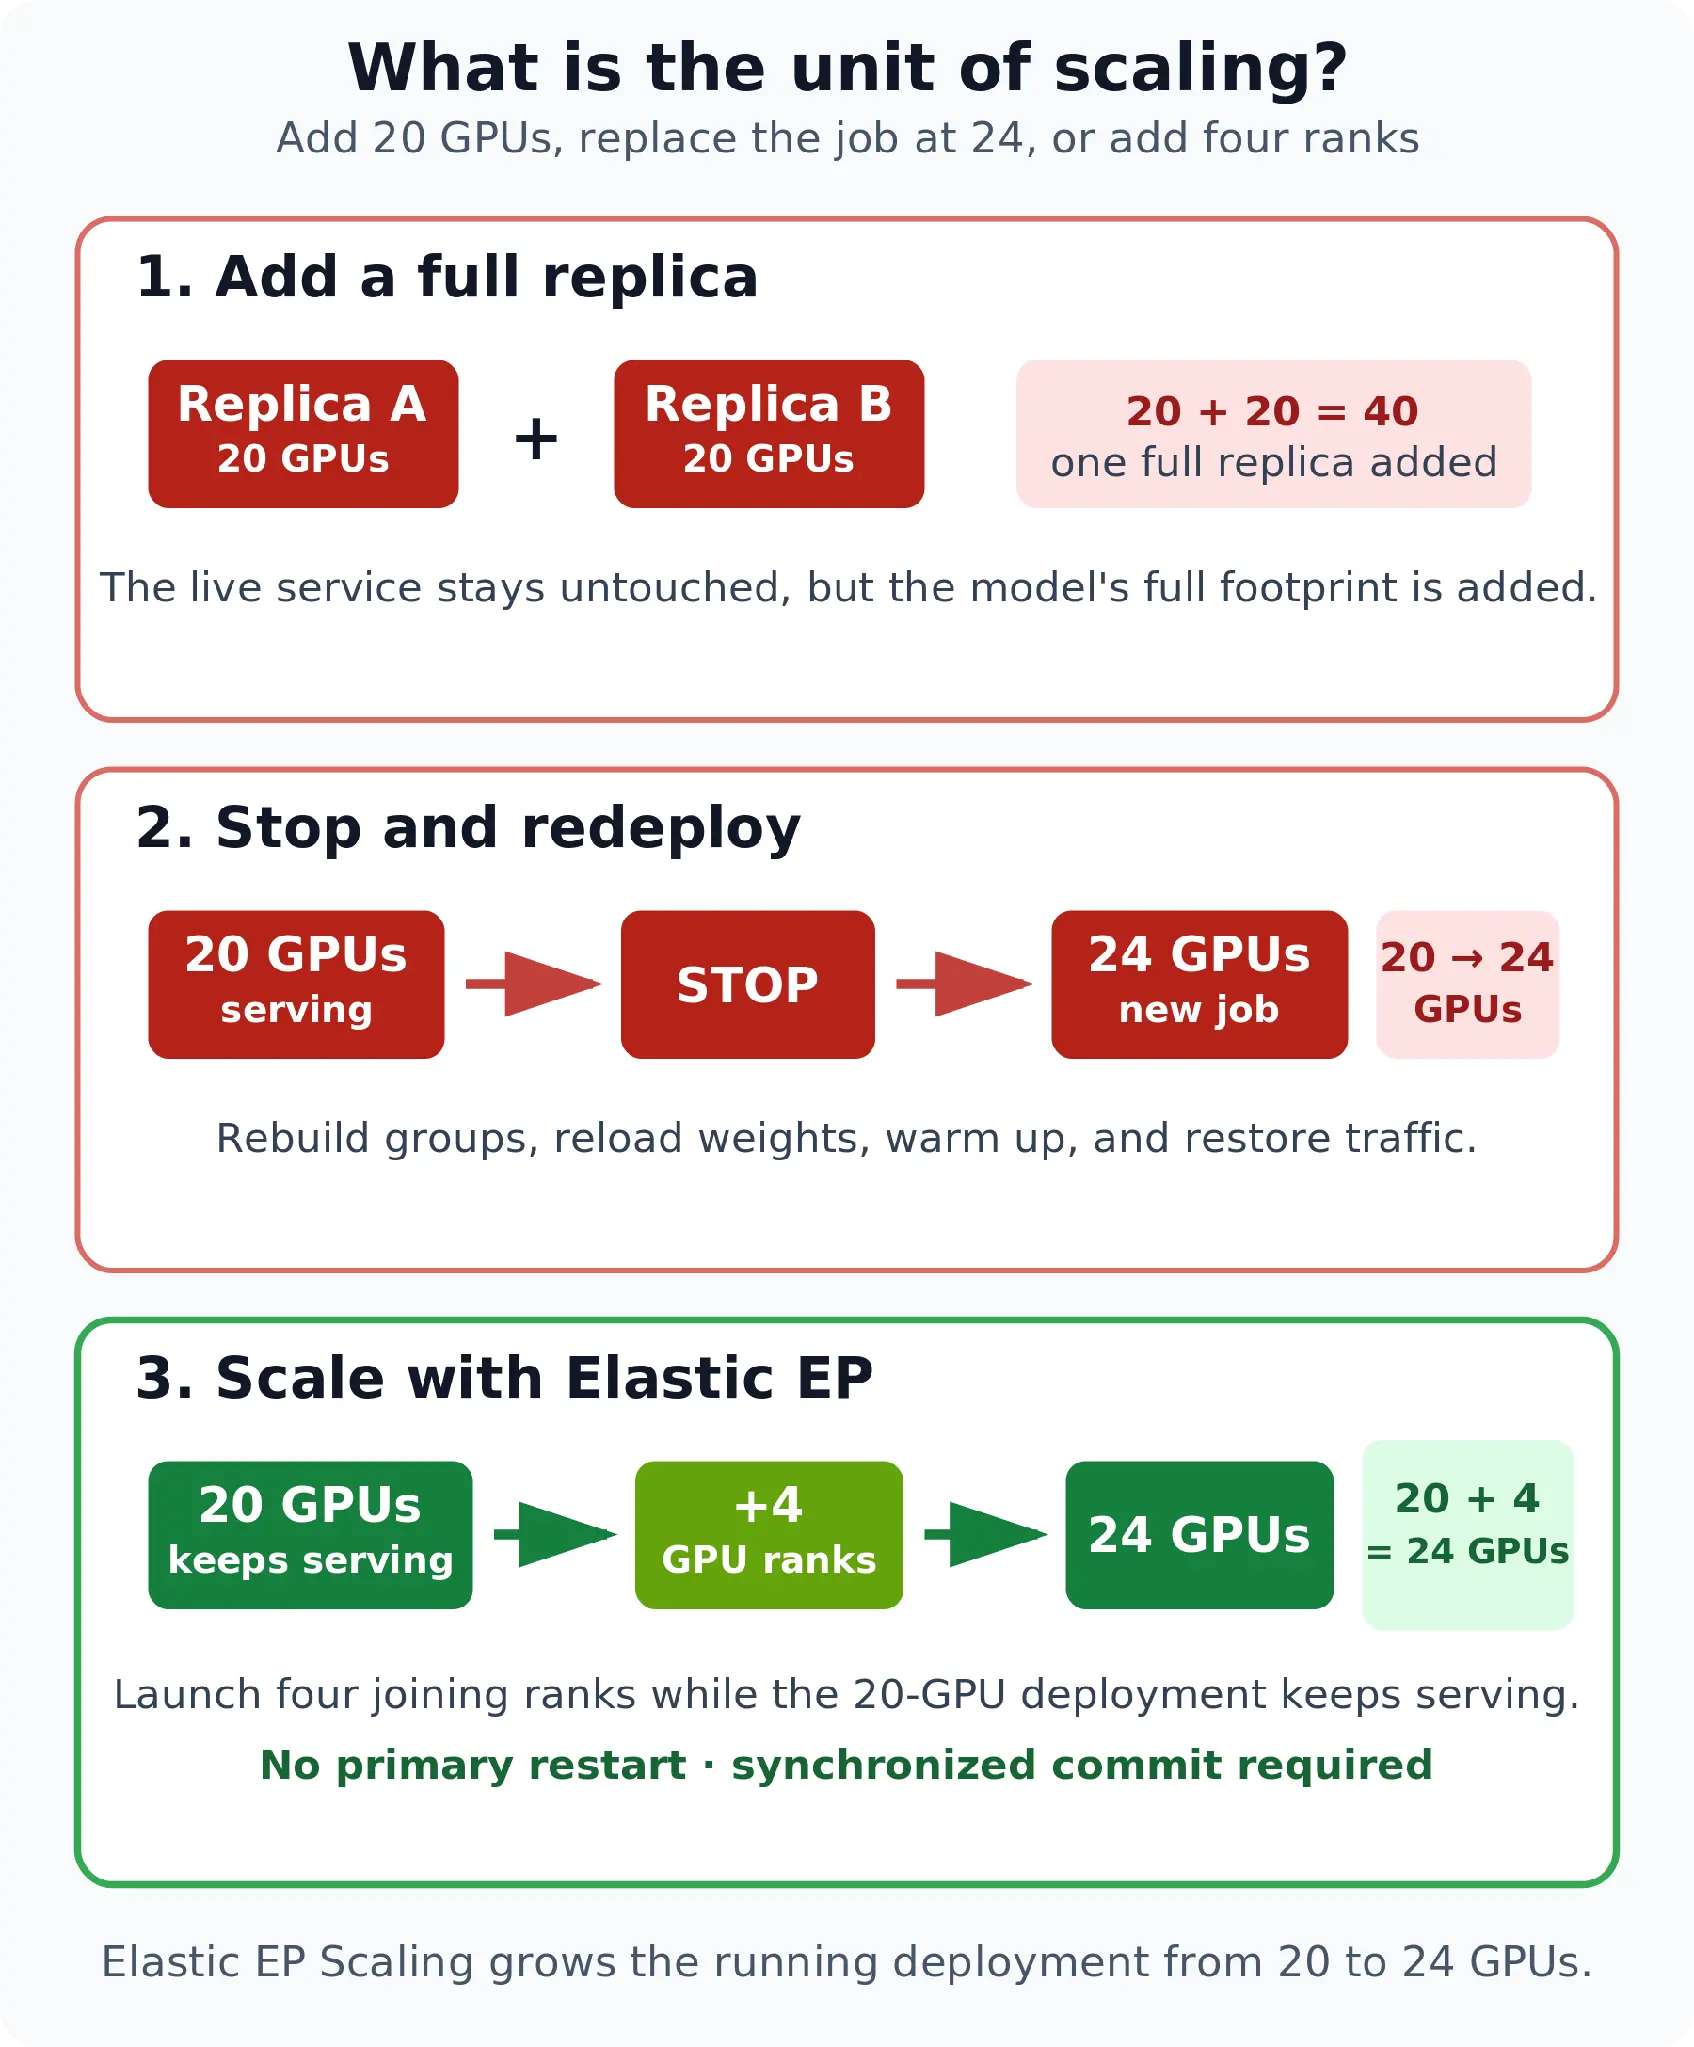
图 1:20→24 GPU 的示意对比。Elastic EP Scaling 在运行中的部署上增加 4 个 ranks,而不是分配另一个 20-GPU 副本或整体替换作业。
核心结论
- Elastic EP scale-up 允许 MoE 模型以更细粒度增加 GPU,无需部署完整副本,也无需重启当前服务。
max_ep_size定义部署可扩展到的最大 EP 拓扑。系统在启动时预留元数据和通信缓冲区容量,但额外 GPU ranks 只有在需要时才启动。- 在报告的对比中,Elastic EP Scaling 到达首个完成请求的速度比重启快 5.3×–8.2×。
扩容机制如何复用故障恢复能力
在每一次 MoE forward 中,token activations 会被发送到拥有被选中 experts 的 ranks,随后 expert 输出再返回源 ranks。SGLang 此前的大规模 EP 工作已经说明,expert dispatch 路径对于高并发、长上下文服务至关重要。在采用 Data Parallel (DP) attention 时,每个逻辑 DP worker 都维护自己的调度器和 KV cache,而 expert layers 则跨 EP 拓扑通信。
运行时扩容直接建立在 SGLang 的 Elastic EP failure-recovery 机制之上。二者都依赖 active/inactive membership、Mooncake Process Group (Mooncake PG) admission,以及 forward 结束时的 transition hook。区别在于:故障恢复是把某个 rank 放回既有 slot 和原 process groups;扩容则是激活 active_ranks 向量里为最大规模预留的尾部空 slot,并接纳新加入的 ranks。
这一设计受到一个关键约束影响:启动时创建的 process groups 是静态的。因此,原始 ranks 和每个新加入的 group 都必须保留固定的 Tensor Parallel (TP) 与 bootstrap groups;在它们之上,Mooncake WORLD 和逻辑 EP membership 才会继续增长。
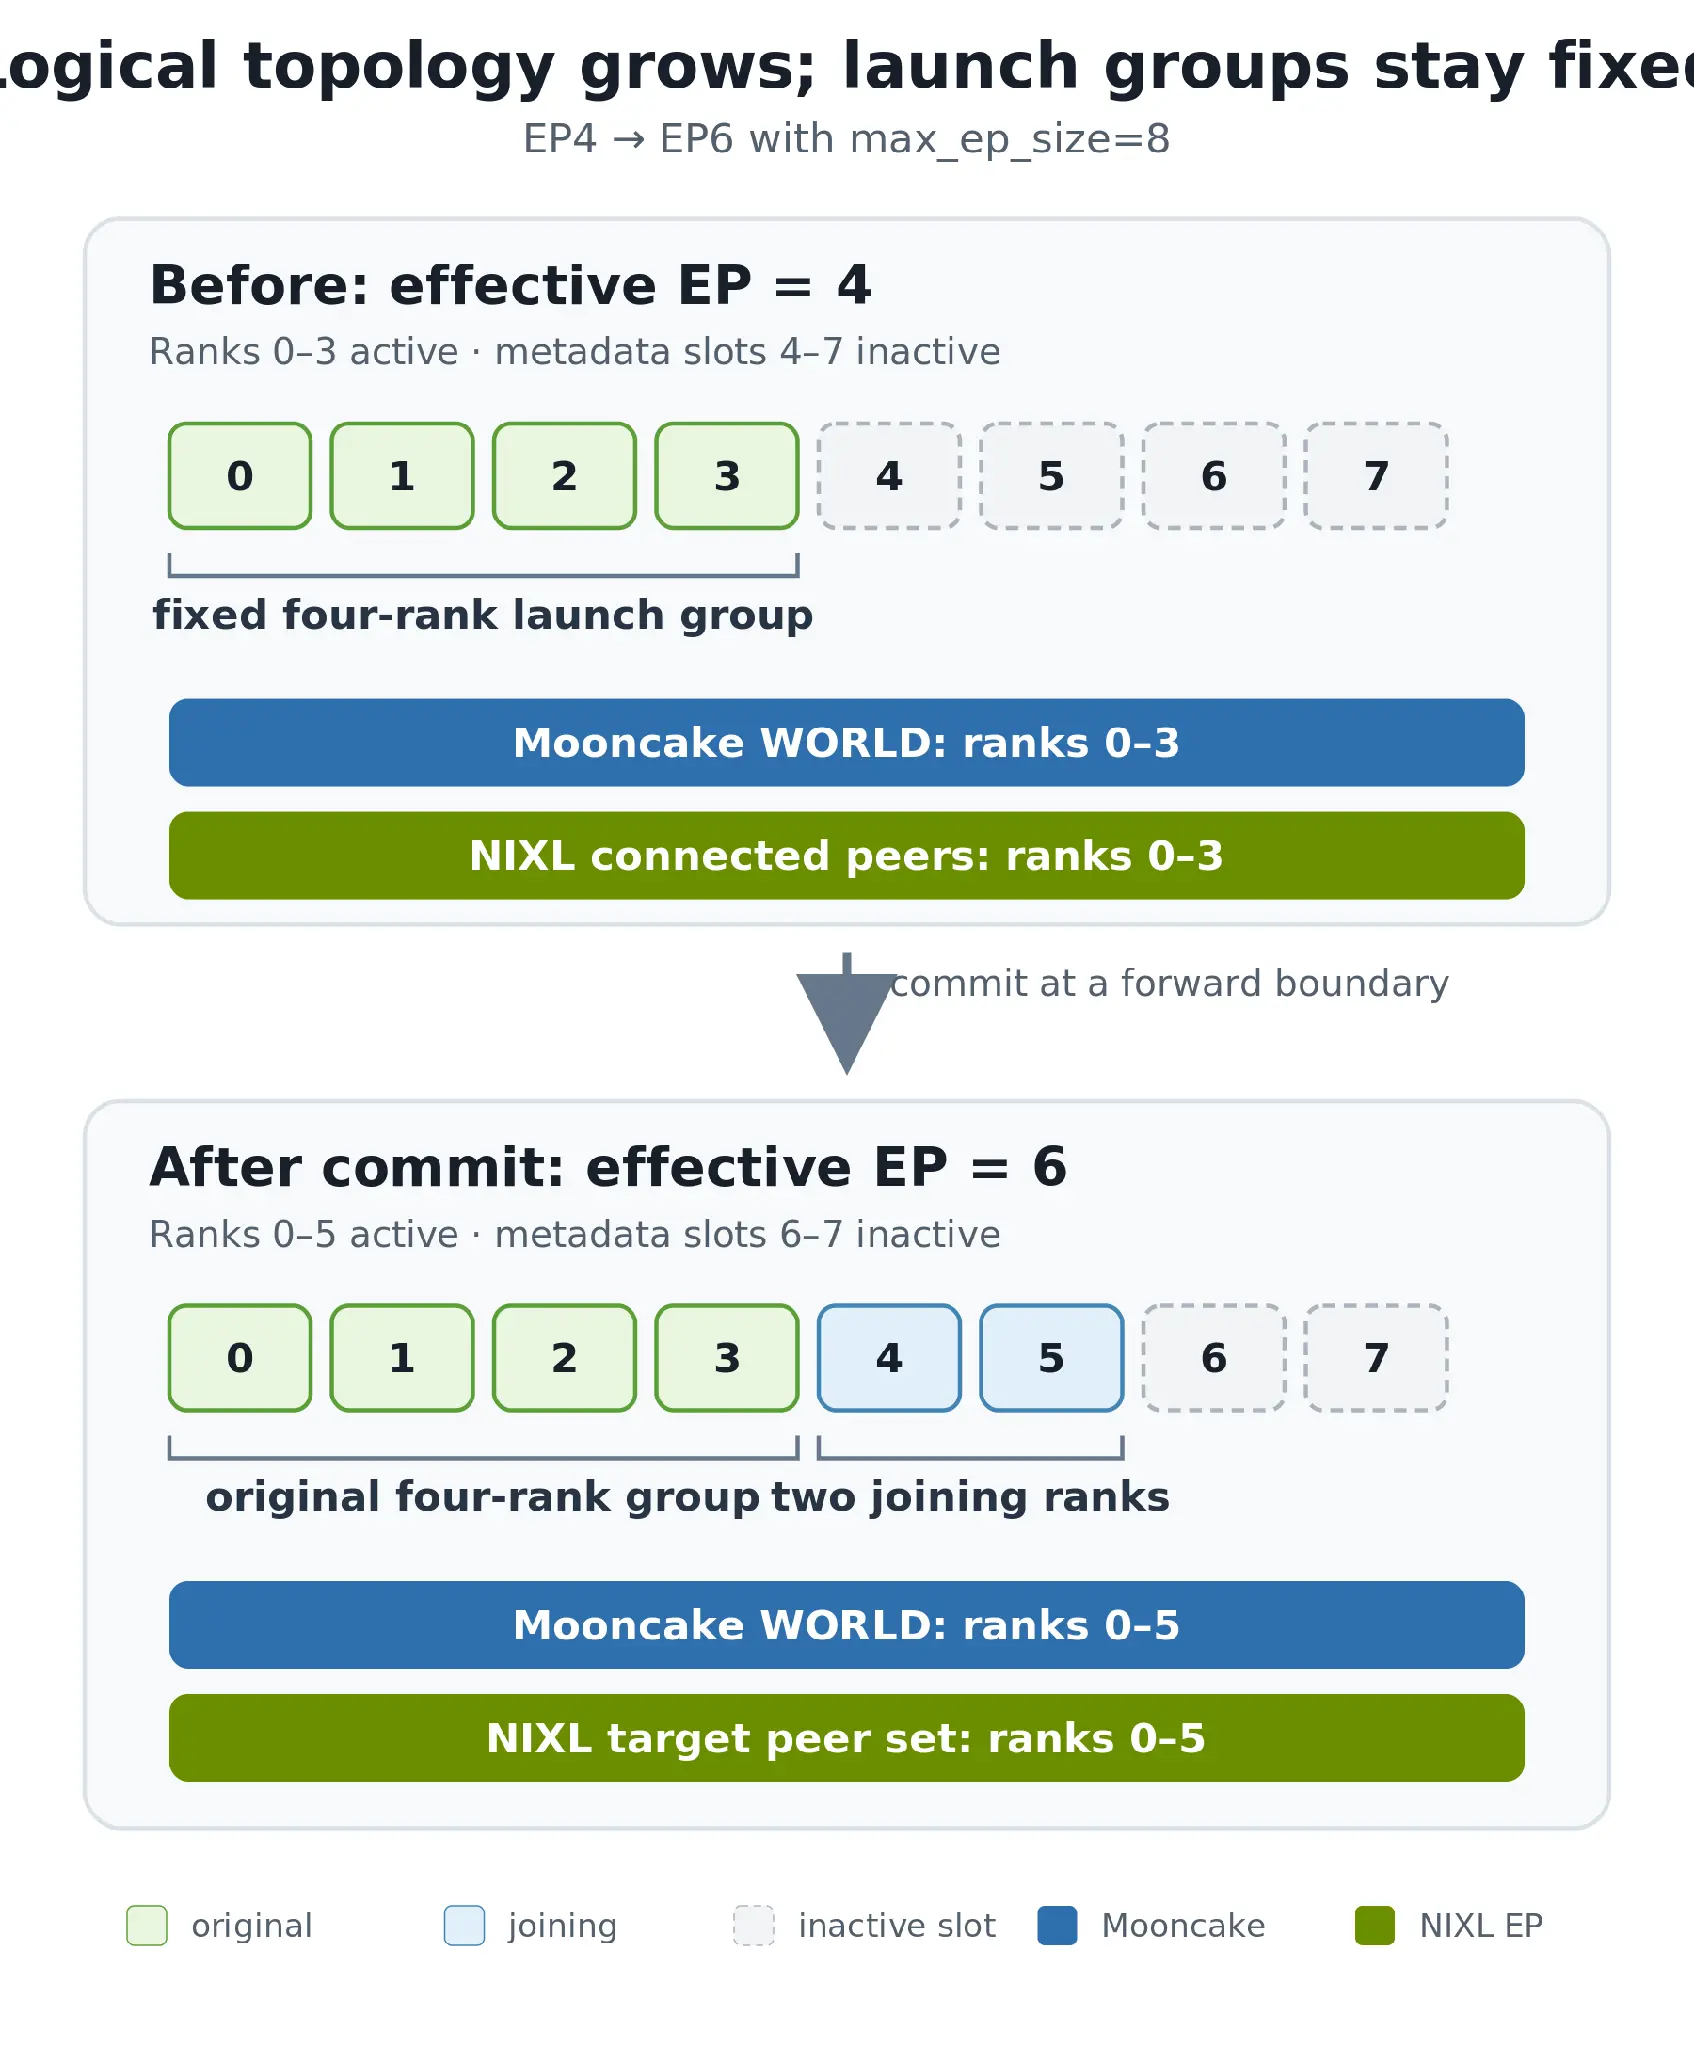
图 2:EP4→EP6 时,原始 4-rank launch group 保持不变,2 个新 ranks 被接纳进 Mooncake WORLD,同时 NIXL 的目标 peer 集合扩展。
一个逻辑部署,三层协同
1. SGLang 负责 serving control plane
SGLang 会等待请求加入的 ranks,分别追踪 pending_ep_size 与 effective_ep_size,在一次 forward 结束时安装目标 expert 和 DP 状态,并且只有在 commit 之后才暴露新的 scheduler slots。
2. Mooncake PG 负责弹性 membership 与同步
Mooncake PG 的可扩展 WORLD 负责接纳 joiners,并提供覆盖现有 ranks 与新 ranks 的 barrier。SGLang 还使用 Mooncake PG 的 collectives 和 P2P,在扩容之后协调 EPLB。
3. NIXL 提供 expert data plane
NIXL EP 在每一次 MoE forward 中负责分发 token activations 并合并 expert 输出。SGLang 的集成位于 NIXL dispatcher。随着 EP group 扩大,NIXL 会保留既有 peer 连接:例如 EP4→EP6 时,原始 ranks 保留已有连接,同时新增 ranks 4 和 5;新加入的 ranks 则连接到 EP6 的 peer 集合。
SGLang 会在启动时根据 max_ep_size 配置 NIXL 元数据和 RDMA buffers,但初始阶段只连接 active ranks。连接仍然是惰性完成的,因此第一次更宽拓扑的 dispatch 可能包含部分连接建立开销。
max_ep_size 应设置为部署预计会达到的最大拓扑。上限越高,active GPUs 上预留的通信缓冲区内存越多,可用于 KV cache 的内存就越少。
运行中的 EP group 如何变大
SGLang 的在线扩容流程可以概括为四步:
- 预留上限。 Primary 通过
max_ep_size分配元数据和通信缓冲区容量。inactive slots 不会启动进程,也不会占用 GPU。 - 启动 joining ranks。 外部 orchestrator 分配 GPU 并启动新 ranks,与此同时现有 EP group 继续提供服务。
- 接纳并提交。 SGLang 等待完整的目标 rank 范围,扩展 Mooncake
WORLD,安装目标 active-rank、expert、DP 和 NIXL 状态,并同步所有 ranks。如果启用了 CUDA graphs,各 ranks 会在提交新规模前重新捕获图。只有这之后,commit_scale()才会推进 effective size。 - 路由与重平衡。 Data Parallel Controller 暴露新的逻辑 workers。NIXL 执行第一次更宽范围的 expert dispatch,随后 EPLB 可以重新分配 experts。
需要注意的是,当 joining ranks 进入 Mooncake WORLD 后,目前还不支持自动回滚;如果 finalization 阶段失败,可能需要重启部署。
扩容切换的实测结果
作者在 8×H100 上使用 DeepSeek-V3-Lite FP8 对比了 Elastic EP Scaling 与重启方案。Elastic EP Scaling 场景下,新加入的 ranks 在后台初始化,现有部署继续服务;重启方案的计时则从源部署被终止之前开始。
在多次 Elastic 运行中,每一次 transition 都成功完成,并通过了扩容后的 GSM8K 验证。图 3 展示了 Elastic 的平均耗时,并与使用相同 CUDA-graph capture range 的重启基线对比。
测试终点是 readiness 之后发出的短 canary 请求。Elastic readiness 以 /is_scaling_elastic_ep 返回目标规模的 serving_expanded 为准;重启 readiness 则以 /health_generate 返回 HTTP 200 为准。Elastic canary 定向到新的逻辑 DP rank,重启方案使用 round-robin routing。
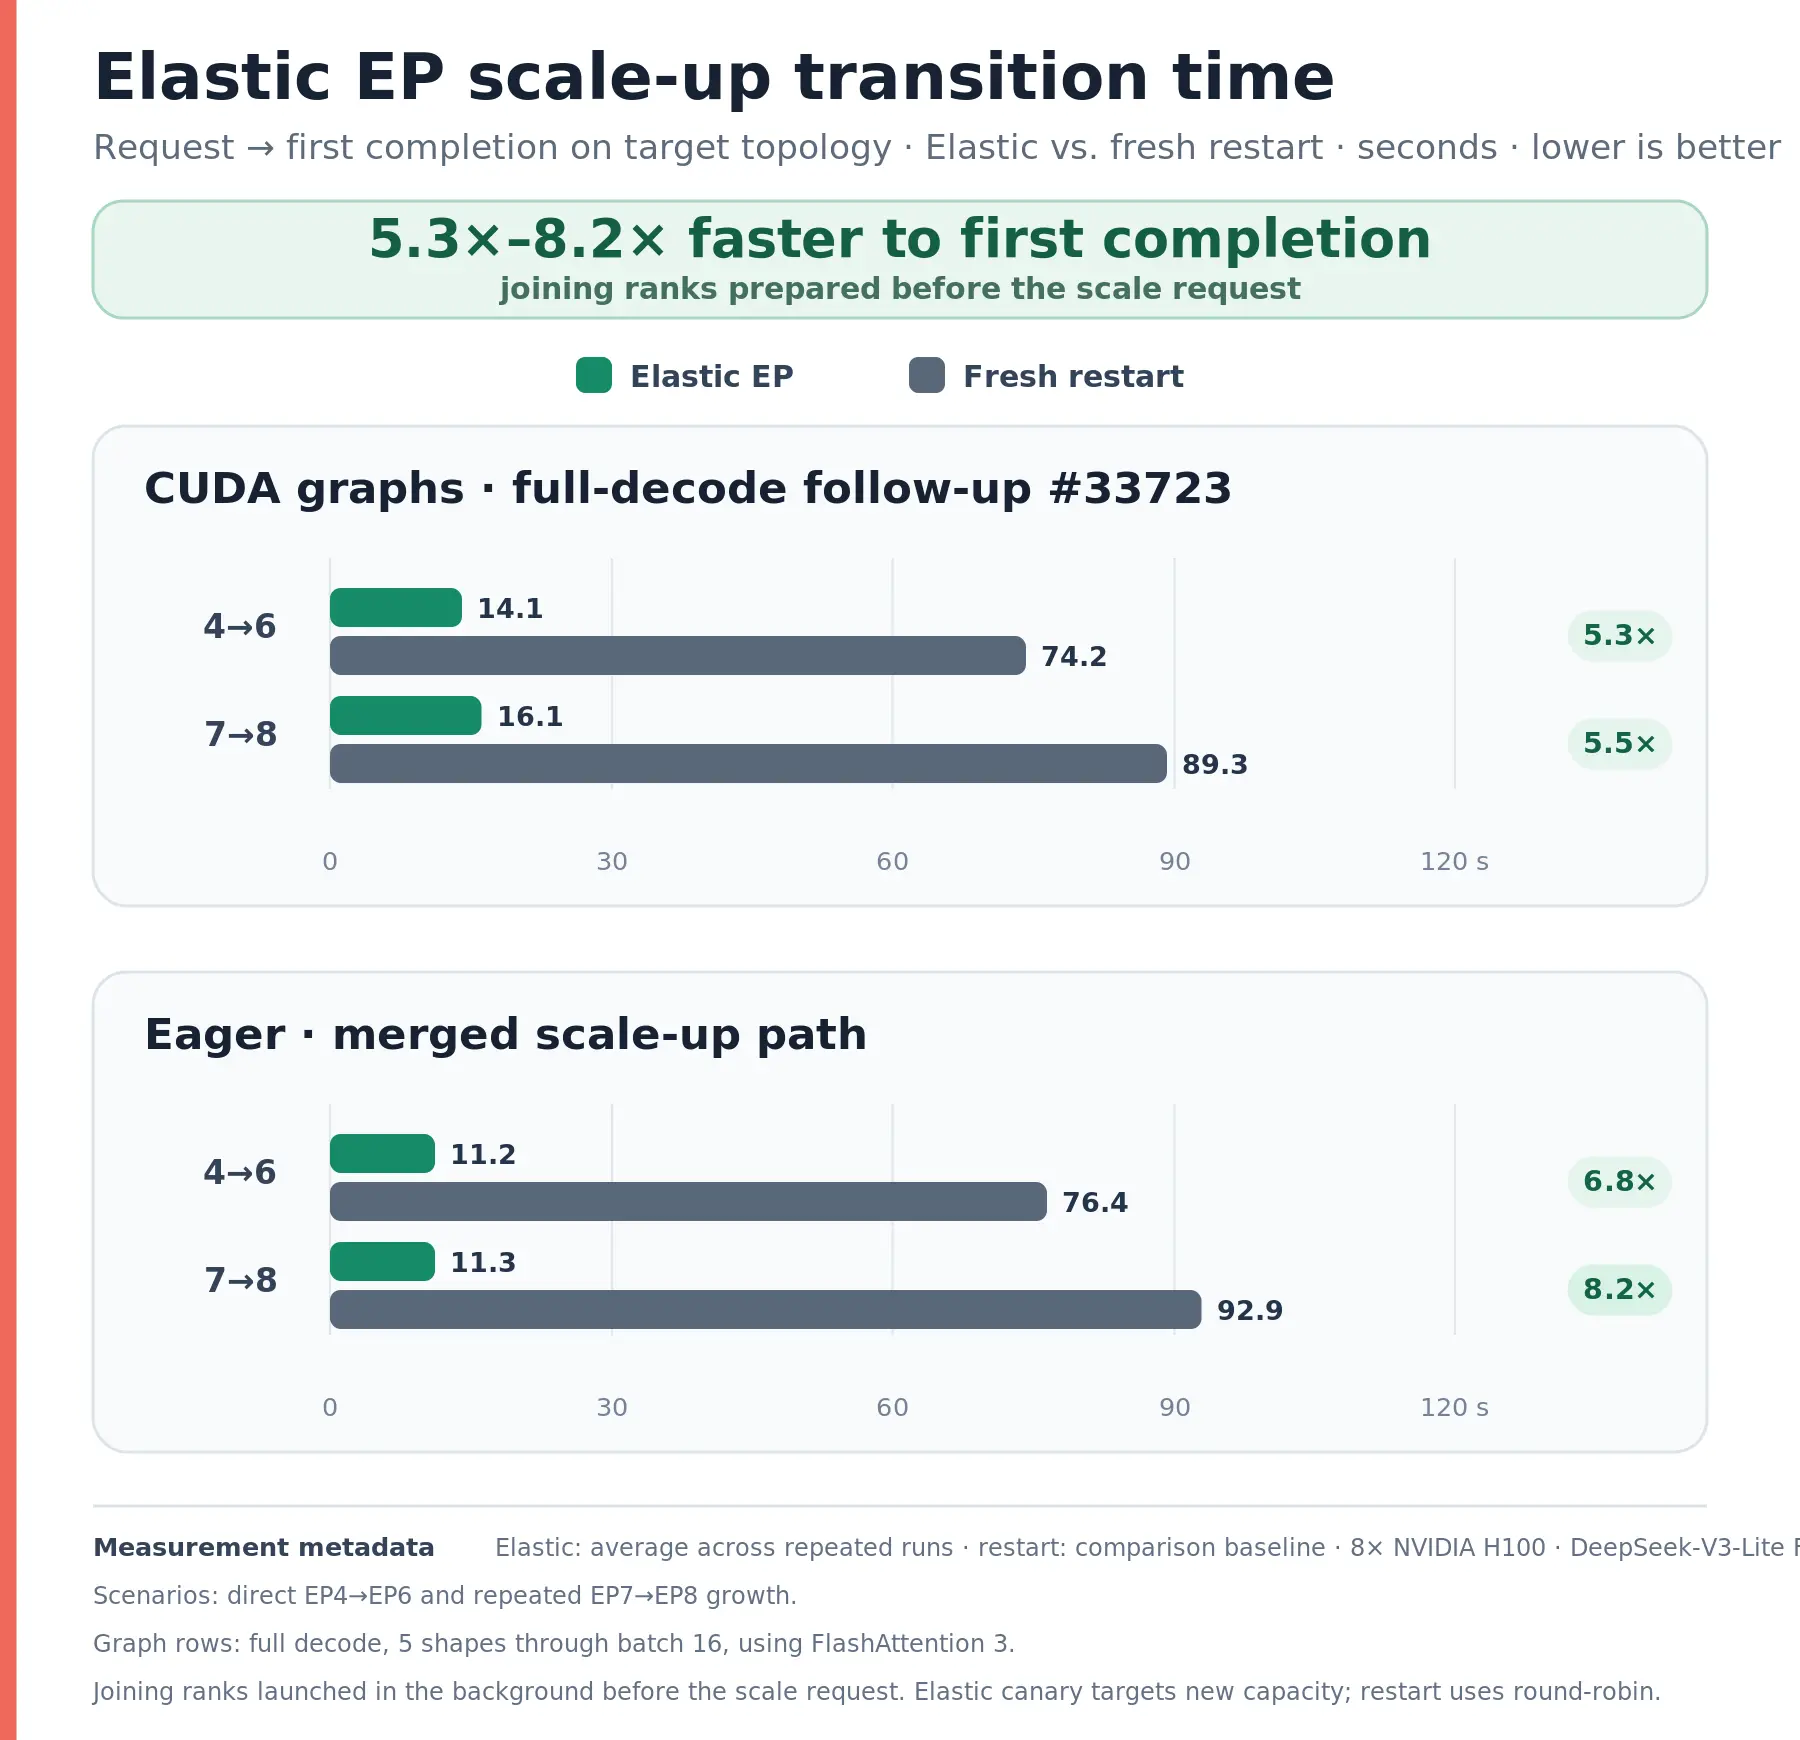
图 3:从扩容或重启请求发起,到目标拓扑上首个请求完成的时间。Elastic 柱状图为多次运行均值;restart 柱状图为对比基线。CUDA-graph 行捕获了 batch 16 以内的 5 个 full-decode shapes。
拓扑切换期间,token delivery 会暂停。图 3 的统计范围覆盖从 scale request 到扩展部署上首个请求完成的全过程,也包含第一次使用时可能发生的连接建立开销。总体来看,Elastic EP Scaling 到达首个完成请求的速度比重启快 5.3×–8.2×。
路线图与当前状态
| 阶段 | 能力 | 截至 2026 年 10 月 4 日状态 |
|---|---|---|
| 1/N | Runtime eager EP scale-up | 已合并,PR #30164 |
| 2/N | Scale-up 后 EPLB | 已合并,PR #30553 |
| 3/N | Full-decode CUDA graph recapture | 已合并,PR #33723 |
| 4/N | 按 DP-attention shard 粒度扩容 | 已合并,PR #33728 |
| Later | Scale-down 与 grow-back | 评审中,PR #33111 |
| Later | Fully idle progress | 计划中 |
| Later | Recovery after scale-up | 计划中 |
Scale-up 后的 EPLB
扩容提交后,SGLang 会在扩展后的拓扑上恢复已有 EPLB reshuffle,让新接纳的 ranks 也能分配到 experts。
CUDA graph recapture
在 EP4 捕获的 graph 包含与拓扑相关的状态,无法原样在 EP6 上重放。最初的扩容路径支持 eager execution;随着 PR #33723 合并,SGLang 现在也能在 commit 之前为扩展后的拓扑重新捕获 full-decode CUDA graphs。不过,prefill 和 piecewise recapture 仍未支持。
在使用 256 个 GSM8K examples、50 个 request threads 的多次运行中,扩容后的平均输出吞吐如下:
| Transition | Eager | Full-decode CUDA graph |
|---|---|---|
| EP4→EP6 | 371 tok/s | 1,241 tok/s |
| EP7→EP8 | 358 tok/s | 1,120 tok/s |
在该设置下,full-decode CUDA graphs 的平均输出吞吐比 eager execution 高 3.1×–3.3×。
Multi-rank DP-attention shards
已合并的布局最初将一个物理 EP rank 映射到一个逻辑 DP worker。后续 PR #33728 允许一个 DP-attention replica 跨越 attention TP × attention CP 个物理 ranks,其中 CP 表示 Context Parallelism。例如在 TP2、CP1 配置下,加入 ranks 4–5 会把 DP2/EP4 扩展为 DP3/EP6;再加入 ranks 6–7,则达到 DP4/EP8。API 仍然以物理 EP units 表达目标规模。
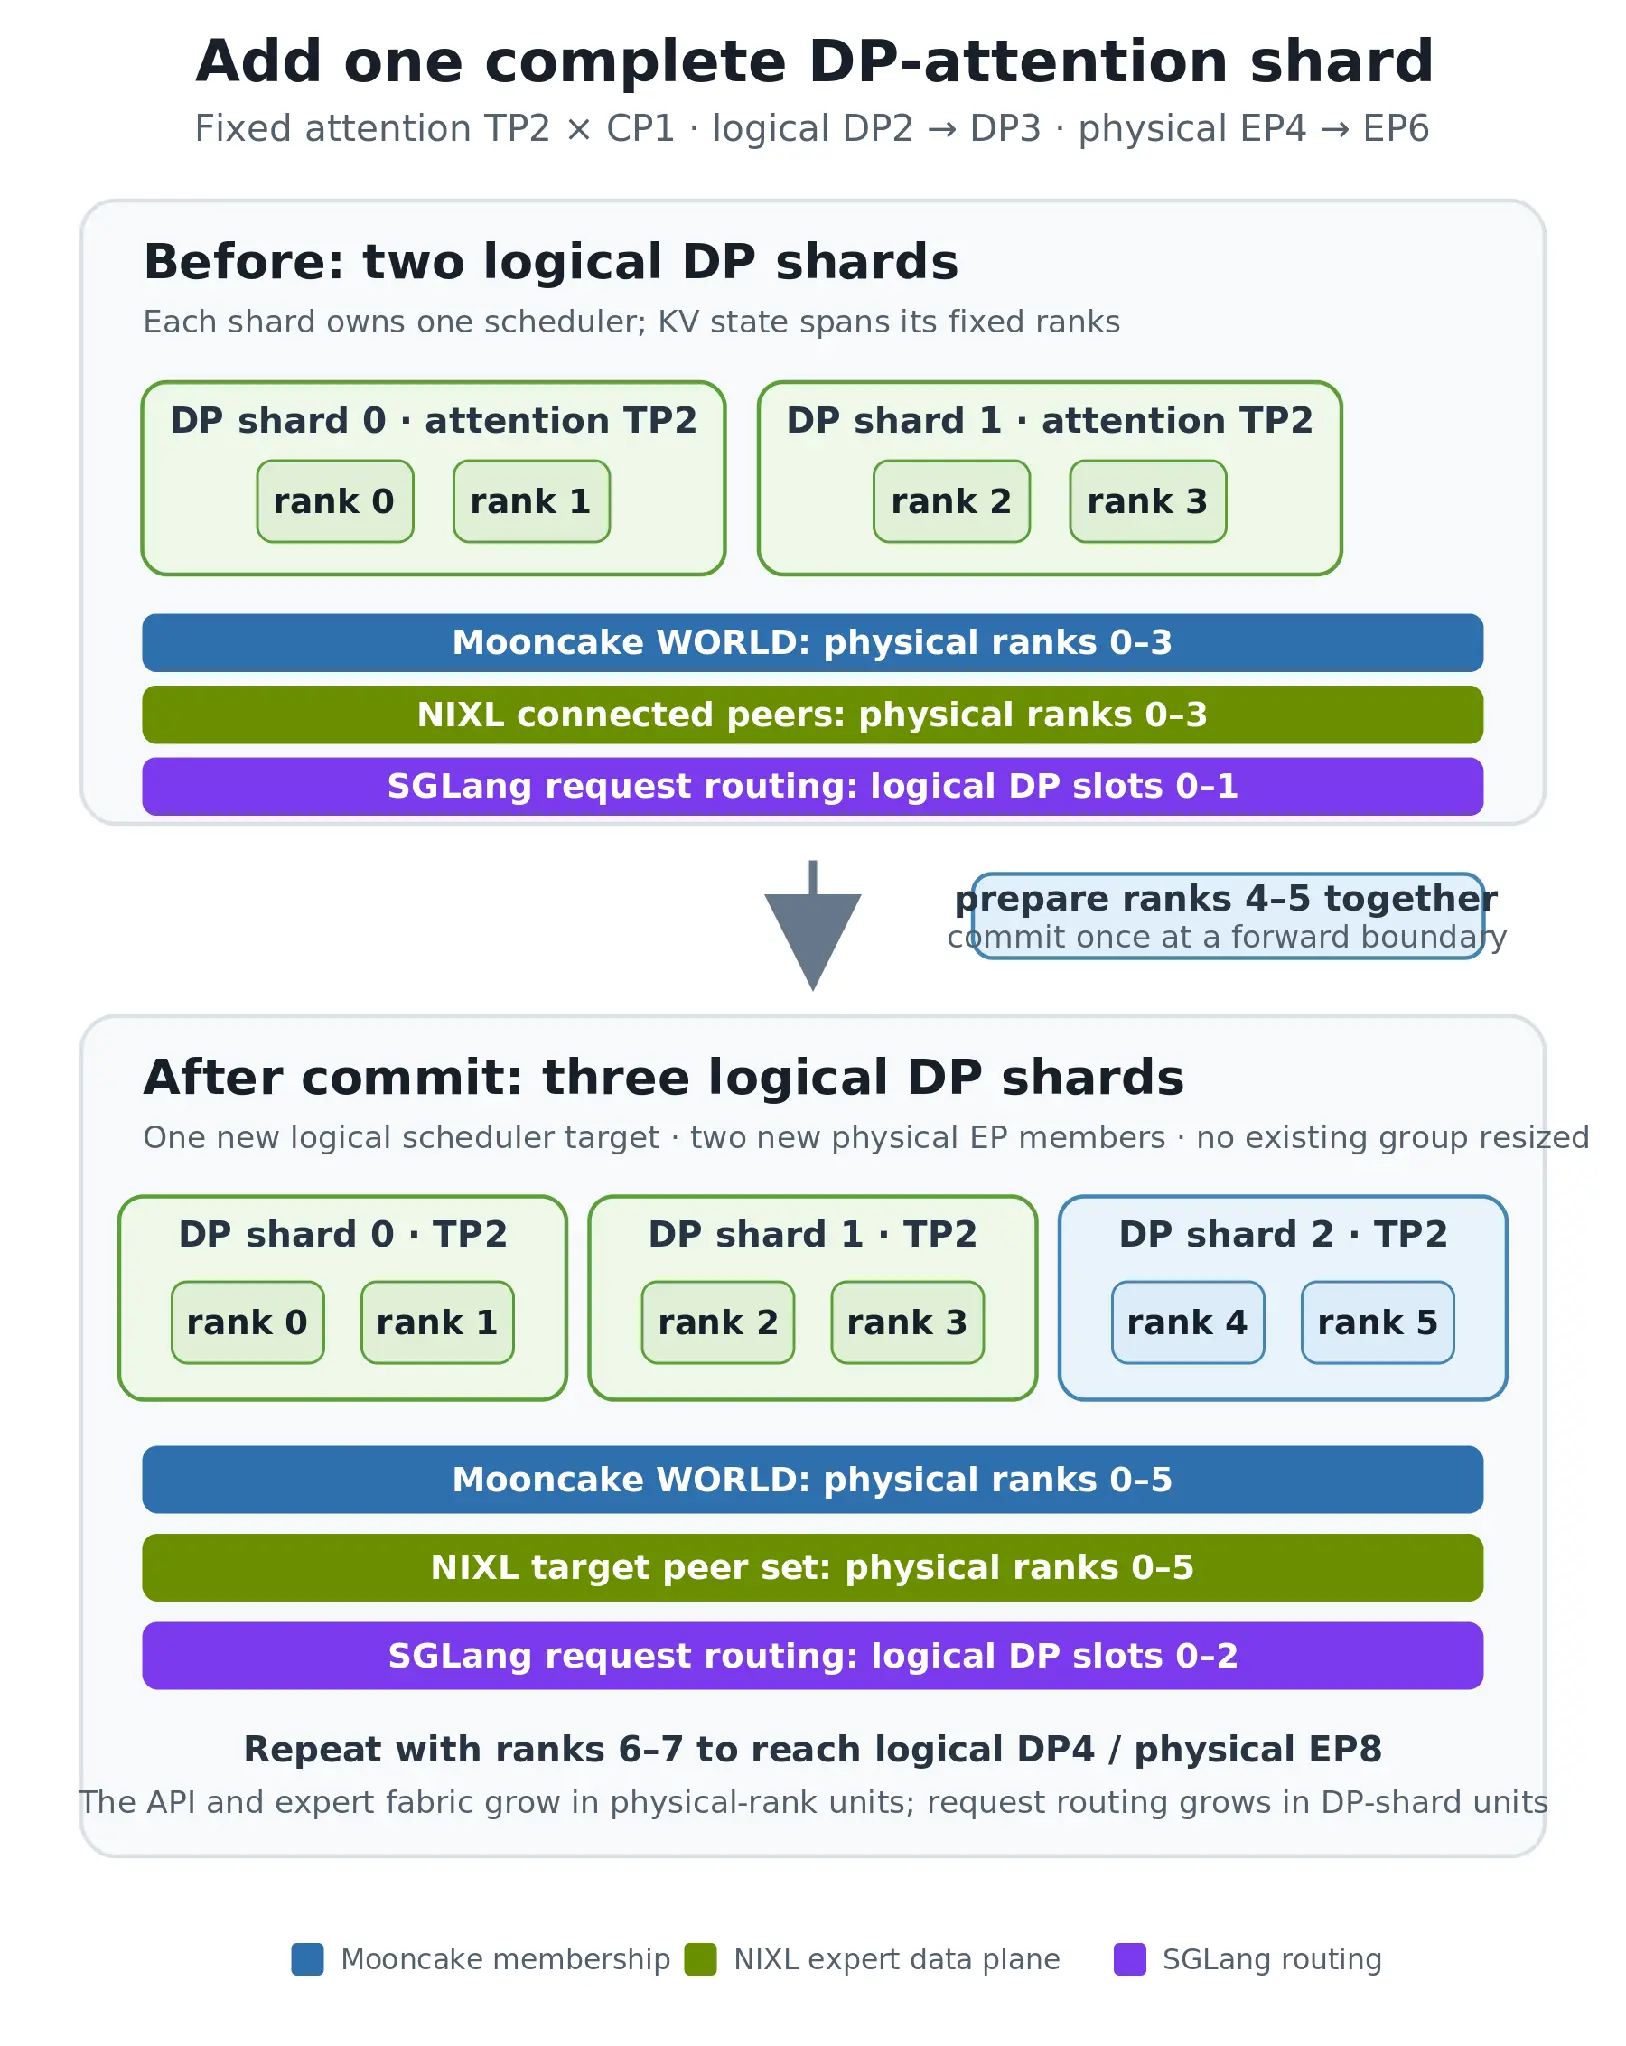
图 4:增加一个 TP2/CP1 DP-attention shard,可将 DP2/EP4 扩展为 DP3/EP6。
总结
Elastic Expert Parallelism Scaling 让 SGLang 的 MoE 推理部署具备了更接近云原生服务的弹性:容量可以按 ranks 细粒度增长,而不是在完整副本和全量重启之间二选一。它的关键在于把 SGLang 的控制面、Mooncake PG 的弹性 membership,以及 NIXL 的 expert data plane 组合起来,在运行时安全地扩大 EP 拓扑。
现阶段,这一能力已经覆盖 eager scale-up、扩容后 EPLB、full-decode CUDA graph recapture,以及 DP-attention shard 粒度扩容。后续 scale-down、grow-back、fully idle progress 和扩容后的恢复能力,将进一步补齐完整弹性推理生命周期。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接