新智元报道
新智元报道

老黄又给具身智能打了一针鸡血。
GTC柏林大会上,英伟达官宣扩展Isaac机器人开发平台,模型、数据、仿真工具和计算系统一起上阵。
老黄甚至直接放话,机器人的「ChatGPT时刻」越来越近了。
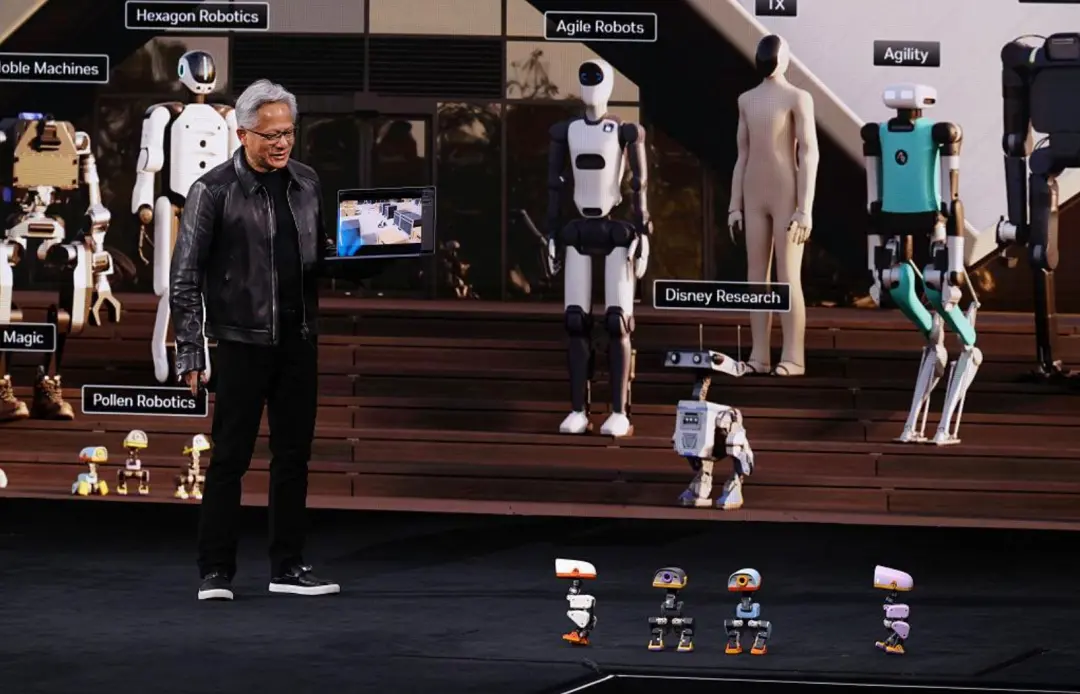
可问题来了,机器人到底哪天才能真正上岗?
人们盯着灵巧手和机械腿,研发团队还得盯着另一块屏幕:训练任务,怎么又停下来了?
GPU已经备好,数据还在路上。模型等着更新,原始视频还没处理完。等一轮训练好不容易跑起来,多机同步结果的时候,直接又堵死了。
AI很忙,算力却未必一直在有效干活。
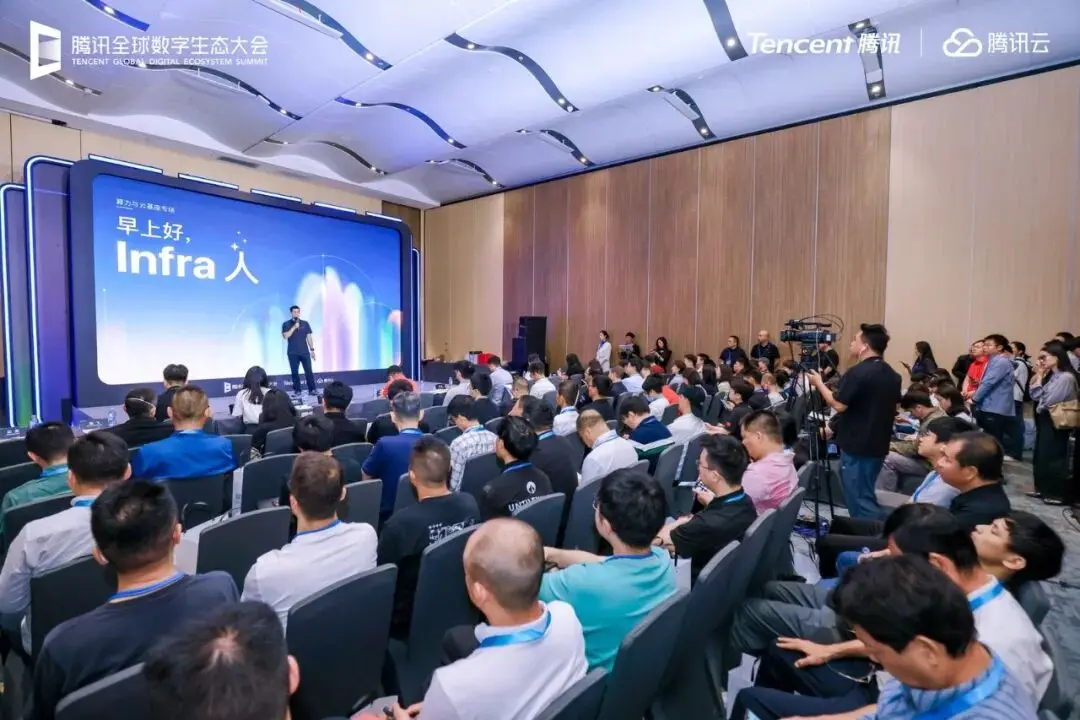
就在10月29日至30日,2026腾讯全球数字生态大会在深圳开幕。
在算力与云基座专场,做世界模型、具身大模型和家庭机器人的公司,摆出了各自的探索,也摊开了背后的基础设施需求。
腾讯云副总裁李力在现场说,「没有Infra的AI,就是浮沙之上筑高墙」。
在他看来,AI的智能和决策中枢,终究要回到云上。过去几十年互联网的发展,走的就是这条路:从个人电脑上的单点,走向分层的分布式体系。AI也一样——没人能把最强大的AI一直塞在自己的电脑里,它最终要回归到云上成熟的计算、存储、网络体系当中。
Agent正在加速上云。腾讯云在现场发布全新品牌Agent Hosting,将面向不同场景的云端Agent产品汇聚为一个产品家族,服务个人、开发者和企业,让团队使用有序、投入有据,把复杂的准备做在背后。
李力在致辞中谈到,腾讯云已经做了不少Agent云上托管的尝试。这些探索着眼于如何让Agent在云上稳定运行,让Agent体系及其管理像互联网一样实现工业化。
而具身智能,对云上AI Infra的依赖更深。计算、存储、网络这三项Infra的经典话题,在具身智能这里有了新的命题:
-
计算,决定算力能不能稳定、高效地跑起来;
-
存储,决定海量数据能不能及时喂进训练;
-
网络,决定大规模集群能不能协同好。
本次生态大会上,三家具身智能公司的落地实践,计算、存储两大模块的产品与方案,以及HCCL和AI Link提供的集群通信与网络传输能力,共同呈现了这份「三科合卷」—— 腾讯云AI Infra在具身智能领域的最佳实践。
给AI一张图片,它就能把画面扩展成一个可交互的空间。
按下WASD,可以控制方向、切换视角;用自然语言,也能实时驱动其中的变化。
这是Manifold AI流形空间,带到现场的世界模型成果之一。
在机器人方向,团队也在探索一种更直观的学习方式:让机器人看一次人类示范,再尝试完成新任务。
流形空间创始人、CEO武伟以系鞋带为例,介绍了通过一次示教进行推理的探索。部署中产生的反馈,还能回流用于模型持续改进。
这样的模型,背后是一轮又一轮的大规模训练。
而流形空间选择的,是在国产算力上训。
武伟介绍,双方从算子和基础设施层面联合优化,用了约两周,将相关训练性能提升近3倍。目前,由512颗国产芯片组成的算力集群实现了稳定训练,下一步将持续扩容。
在他看来,过去这类优化大多只能靠团队自己摸索;和腾讯云一起从算子层、Infra层往上调,才让团队对国产算力有了信心。
流形空间的故事,其实说出了很多具身团队都要过的两道坎。
第一道,算力怎么选。如今,越来越多团队在寻求多元化的算力,也在推进国产算力的适配和采用。可换一种芯片,不是换个插头那么简单:框架要兼容,算子要适配,性能还得反复调优。不少团队迁完才发现,模型「能跑,但跑不快」。
第二道,算力怎么用好。算力是一笔不小的投入,多机训练时却常有资源空转;数据处理、仿真、训练的需求此起彼伏,固定配置的集群不是闲置,就是排队。
而具身智能,恰恰把这两道坎都放大了。
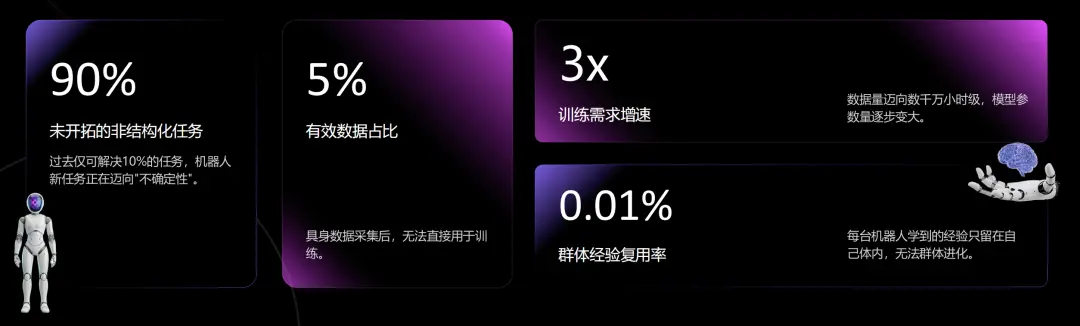
大会现场,腾讯云异构计算产品副总监黄阳给了一组数字:现在的机器人只能完成约10%的结构化任务,剩下90%的非结构化任务还没法替代;单一客户的数据量,已经从几十万小时涨到几千万小时,训练需求增长3倍以上;上万台机器人各自试错,群体经验的复用率只有0.01%。
用他的话说,本体的尺度,装不下智能的尺度。所以,具身大脑得长在云上。
黄阳给腾讯云的定位也很干脆:不碰你的算法,只接管你不想管的调度。为此,腾讯云搭起了三大算力底座。
数据底座,把原始数据变成训练集。
采集上来的原始数据,只有约5%能直接用于训练,其余都要先清洗处理。这一层由HAI DataFlow和数据万象承接。
客户自己的算子,可以打包成镜像接进来,业务逻辑不用重写;没有算子,就用数据万象提供的腾讯云自研算子。环境部署、步骤衔接、CPU和GPU怎么配,都交给云,团队只管提交任务、拿结果。
训仿底座,对付的正是流形空间碰到的那两道坎。
所谓算子,可以理解成模型计算里的基本工序。某道工序没适配好,硬件再强也难充分发挥。再加上框架兼容、集群通信和运行稳定性,每个环节都会拖慢进度。腾讯云在这里分三步走:
-
迁得快:HCC多芯算力配合AI算子优化Agent,把模型从原方案迁到国产芯片,迁移速度提升2倍。一家头部具身模型团队的VLA训练任务,两周内完成到国产芯片的迁移,开箱吞吐提升约30%,叠加HyperAcc加速后提升约52%;
-
训得快:HyperAcc训练加速套件一行代码开启,在国产芯片千卡规模实测中,性能提升至少22%;
-
跑得稳:HyperTrace在训练前预检整个集群,训练中旁路采集和监控,停训排障减少91%。
强化学习仿真也跑在同一套底座上,企业保留自己的仿真环境和奖励设计。
推理底座,打通具身应用的「最后一米」。
机器人和它要接触的对象,往往就在一米之内,任务要在百毫秒级完成。
高性能应用服务HAI推出的算力背包,把算力和模型打包在一起,机器人通过订阅接入,用API或SDK调用,不用自己采购和运维算力。AI可信集群拿到了信通院认证,提供全链路加密,数据全程在客户自己手里。
企业专注教会机器人,云负责把算力用好。
算力的问题解决了,下一个瓶颈紧跟着出现:数据。
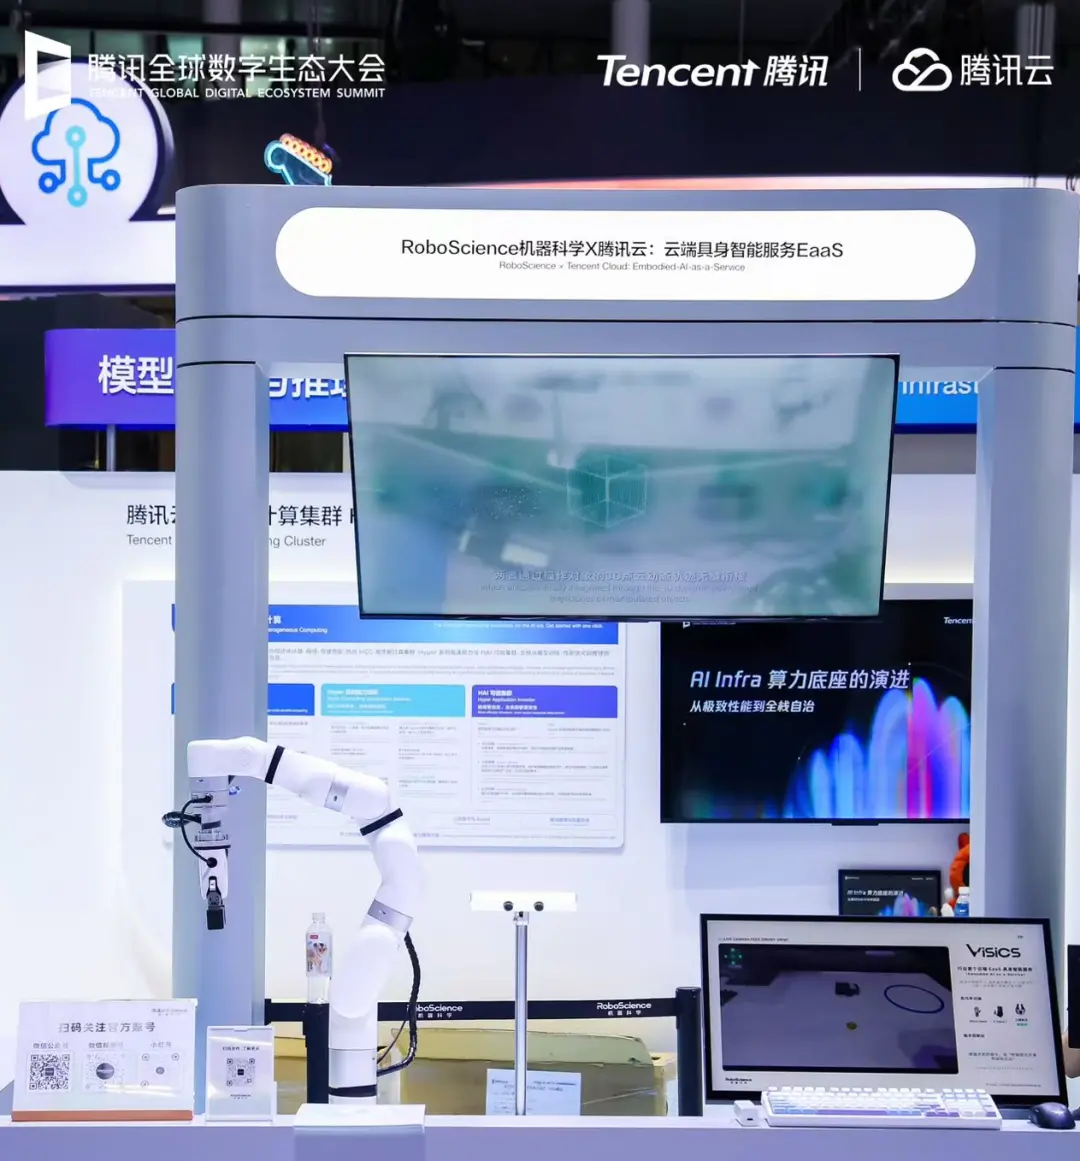
RoboScience机器科学自研具身大模型Visics,每周新增数十万小时的仿真与视频数据。视频、图像、3D点云、真机回流,格式五花八门;北京、南京两地还各有标注集群。
做家庭机器人的元点Zeroth,则是另一种烦恼:机器人7×24小时在线,视频、语音和传感器日志源源不断,其中大量是重复的无效动作,团队内部管这叫「dirty data」。
一个是数据太杂,一个是高价值数据太难找,指向的却是同一个痛点。
在算法、算力、数据这「模型三要素」里,前两者正在快速收敛:主流算法路线大同小异,算力也越来越多元、越来越容易获得。
所以,腾讯云存储产品解决方案总监、首席技术专家温涛直言,「各家具身公司真正能拉开差距的,是数据的质量、来源和总量,这些决定了具身智能能力的上限」。
可数据从采集到训练,要经过清洗、格式转换、标注、权限与版本管理、交付,任何一环卡住,海量数据就喂不进GPU,算力只能干等。
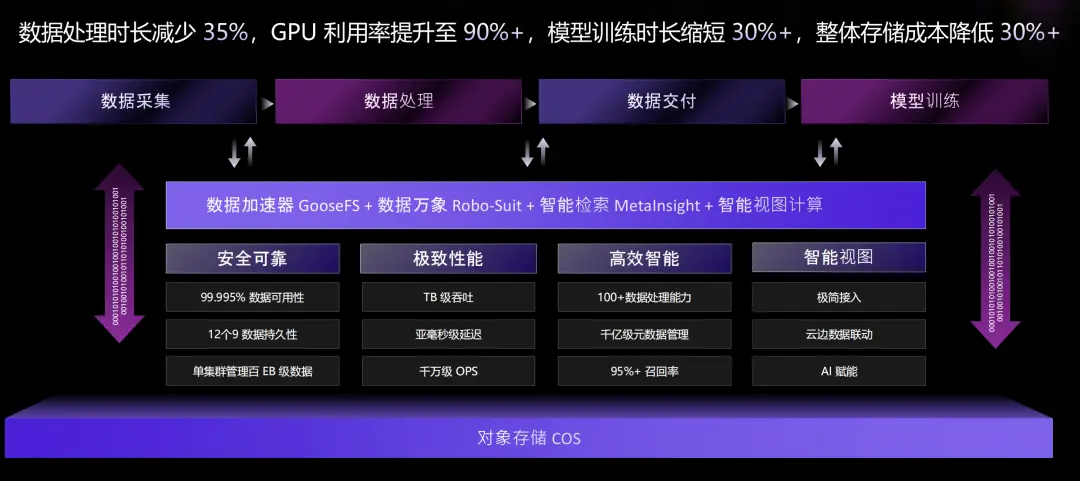
腾讯云给出的解法,是让数据飞轮转起来:采集、处理、训练,再到真机验证,哪里做得不好,就带着问题开始下一轮。支撑这个飞轮的,是三层架构。
底层:存得下,也存得起
对象存储COS是统一底座。真机、仿真、互联网视频、BAG、LeRobot、MCAP、HDF5等格式都能直接装;单集群可管理百EB级数据,可用性达99.995%,持久性达12个9。
成本同样要算。腾讯云用磁带、QLC、TLC多元介质加冷热分层,该热的放热层,该冷的放冷层,仅COS磁带存储就已累计超过2000PB。
中层:数据流转的「加工管道」
数据万象Robo-Suit提供质检、拆分、标注、重建、检索、脱敏6类算子、100多项能力;MetaInsight支持以文搜图、以图搜图,召回率95%以上。
再加上跨账号、跨园区复制和全球加速,格式转换、权限管控、数据定向交付,都在这一层完成。
顶层:贴着GPU的加速器
对象存储擅长大规模、低成本,和GPU训练之间却隔着一道性能的沟。
数据加速器GooseFS补上了它:单客户端吞吐40Gbps、时延亚毫秒级,热点数据就近缓存、反复读取零回源。新发布的COS Express,读取吞吐达到标准对象存储的10至20倍;高并发、海量小文件的训练场景,则交给全NVMe的并行文件系统CFS Turbo。
三层连起来,标杆客户的实测数据是:数据处理时间减少35%,GPU利用率提升到90%以上,训练时长缩短30%以上,整体存储成本下降30%以上。
再看开头的两家公司。
机器科学创始人兼CEO田野定了一条硬标准:一份数据,多地共享。腾讯云用COS在南京建起统一数据湖,北京、南京跨地域直读同一份数据,省下了两地各建一套高性能存储的数千万元投入;训练侧用CFS Turbo配合400Gbps级RDMA,减少数据等待。
双方还共创了潮汐算力:白天训练,夜里闲置的GPU跑VLM预标注,标注效率提升5到10倍。
元点Zeroth用COS在上海、北美、欧洲多个园区承接PB级数据,智能视图计算平台支撑远程看护的实时查看与回放,MetaInsight帮工程师快速捞出高价值片段。
用联席CTO李元庆的话说:相比一小时重复无效动作,一分钟高密度交互往往更有价值。
数据既要存得下,也要及时读得到。否则,算力再强,也只能等米下锅。
数据送到位,多台机器之间还得配合好。
具身模型越训越大,集群也越拉越大,训练得靠成百上千台机器一起干。单机再强,只要通信慢一拍、网络抖一下,整个集群都得陪着等。
就像一群人合写报告,每人都写得快,汇总时堵在一个窗口,报告照样交不出去。多机配合不好,算力堆得再多也是白搭。
腾讯云给出的答案,是自研的集合通信库HCCL。它配合星脉网络,优化端口流量均衡,并在多任务并发时感知拥塞、动态切换路径。其中,端口均衡优化带来了40%的AllReduce通信带宽收益。
落到具身场景里,一家具身智能公司的真实案例,使用HCCL后,模型端到端性能提升13%。集群之外,具身数据还需要跨地域流转。
一家具身智能客户要把数据在多个节点之间进行调度,原有自建链路难以满足快速扩容需求。
腾讯云AI Link通过多链路负载均衡,组合调度自有骨干网、合作伙伴网络和公网组合,再通过QoS队列分级,将空闲带宽用于大规模数据传输,拥塞时优先保障关键业务。在这一案例中,可交付带宽增至原来的5倍,单位成本降低50%以上。
从集群内协同到跨地域数据传输,两者共同要减少的,都是算力的等待。
从会生成世界的模型,到靠海量数据喂大的具身大模型,再到走进客厅的家庭机器人,流形空间、机器科学、元点三家做的事各不相同,碰到的难处却很像:算力要稳,数据要快,网络要通。
哪一环掉链子,模型就只能干等。
回头看,计算、存储、网络三条线,答的其实是同一道题:具身智能从实验室走向产业,基础设施的复杂度由谁来扛。谁扛得稳,谁就落地得快。
三科合卷,考的不是哪一门的单科成绩,而是计算、存储、网络能不能拧成一股绳。三家具身公司交出的成绩,就是腾讯云AI Infra在具身智能赛道上的最佳实践。
放到整个具身产业来看,竞争的重心也在悄悄转移。过去比的是谁的机器人走得更稳、抓得更准;接下来比的,是谁的数据飞轮转得更快、模型迭代得更勤、能力复制得更广。
本体可以各家自己造,算法可以各家自己写;但从数据采集、训练仿真到部署上线的这条长链路,正越来越多地交给云来承接。
当底座不再拖后腿,机器人从「造出来」到「用起来」的距离,就会被一点点缩短。
机器人真正上岗的那一天,或许并没有想象中那么远。
点击「阅读原文」,直击2026腾讯全球数字生态大会「算力与云基座专场」完整回放。
编辑:桃子