
近日,DeepSeek 为下一代超级智能体(Super Agent)提出了四个标准:连续,高效,主动,持久,让智能体称为能够承担工作的 AI 同事。
与这一理念同频,中国人民大学与复旦大学联合团队提出 CoworkOS,将复杂任务协作、共享应用与持久工作状态纳入同一套系统。
-
论文标题:CoworkOS: Scaling Agent Coworkers for Real-world Automation
-
项目主页:https://coworkos-ai.github.io/
-
Demo Gallery:https://coworkos-ai.github.io/showcase.html
-
论文链接:https://github.com/RUC-NLPIR/CoworkOS/blob/main/CoworkOS_paper.pdf
-
代码地址:https://github.com/RUC-NLPIR/CoworkOS
下面的总览视频完整展示了 CoworkOS 如何工作以及对应的工作产物:
总览视频・CoworkOS 完整演示
理念同频之外,CoworkOS 进一步探索一种「超级 AI 同事」形态。这一探索沿着两个维度展开:
-
任务复杂度:智能体需要通过多轮环境交互,来完成复杂办公交付工作。
-
时间跨度:实现跨天、跨会话的持续工作,并在中断后接续推进。
CoworkOS 旨在让 AI 同事既能处理复杂任务,也能在更长的时间跨度内持续承担工作。
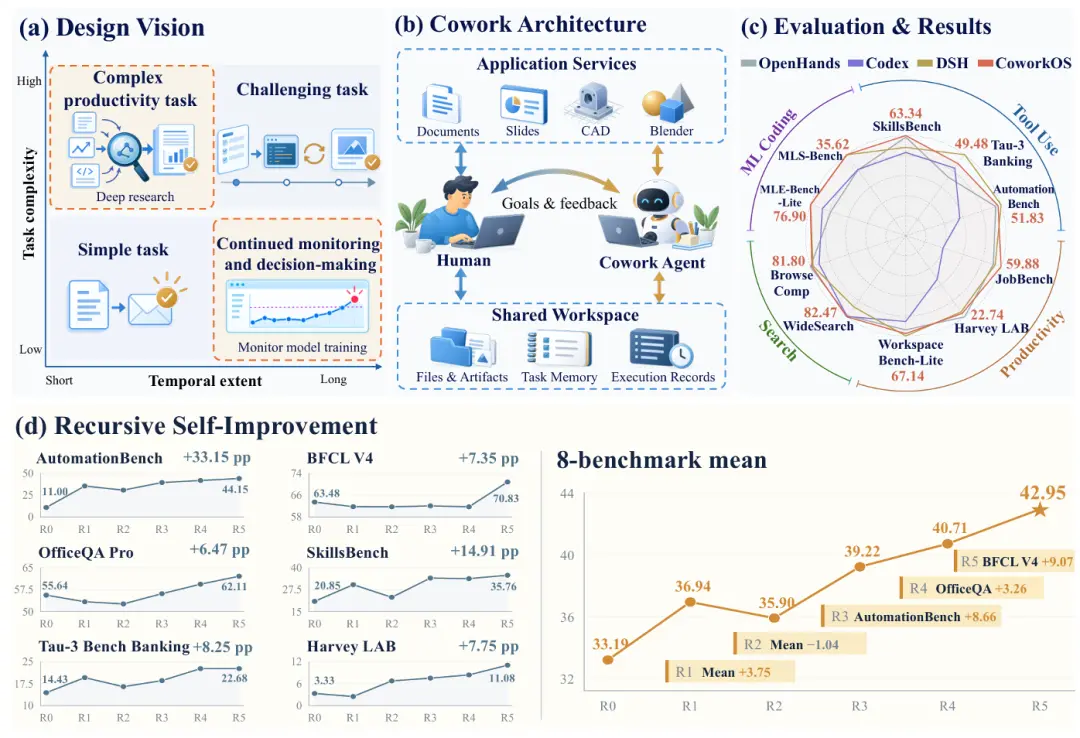
图 2:CoworkOS 总览:复杂办公交付与持续监控决策双挑战、三层协作架构与实验结果。
具体来说,CoworkOS 结合三项核心设计:
-
三层协作架构,由主智能体制定策略与验收,协调智能体管理调度与状态,子智能体执行子任务;
-
共享应用环境,支持人与智能体在 CAD、Blender 等应用中共同修订;
-
持久工作状态与异步执行,通过工作区、记忆与后台任务支撑跨会话监控。
如图 2 所示,在 12 项真实世界基准和 6 大类交付场景中,团队将 CoworkOS 与 DeepSeek Harness、Codex 等系统进行对比,最终性能不分伯仲。此外,团队还以模型自主后训练为 RSI 的探索场景,让 CoworkOS 组织 Qwen3.6-35B-A3B 的五轮迭代,在八项基准上的平均分从 33.19 提升至 42.95。
CoworkOS:让智能体变成 AI 同事
一.多智能体协作:从分头执行到共同完成
面对复杂任务,CoworkOS 让主智能体把握整体方向,让子智能体完成具体工作。一项复杂工作通常包含多个环节:有些可以同时开展,还有些必须反复检查和修改。如图 3 所示,CoworkOS 由主智能体(Main Agent)制定计划,将具体工作交给不同的子智能体(Subagent),再根据返回的成果决定下一步。子智能体提交结果后,主智能体还会检查它是否满足要求、发现遗漏或错误,就继续安排修改。这样,分工既能让多个环节并行推进,也能让最终交付始终围绕同一个目标。
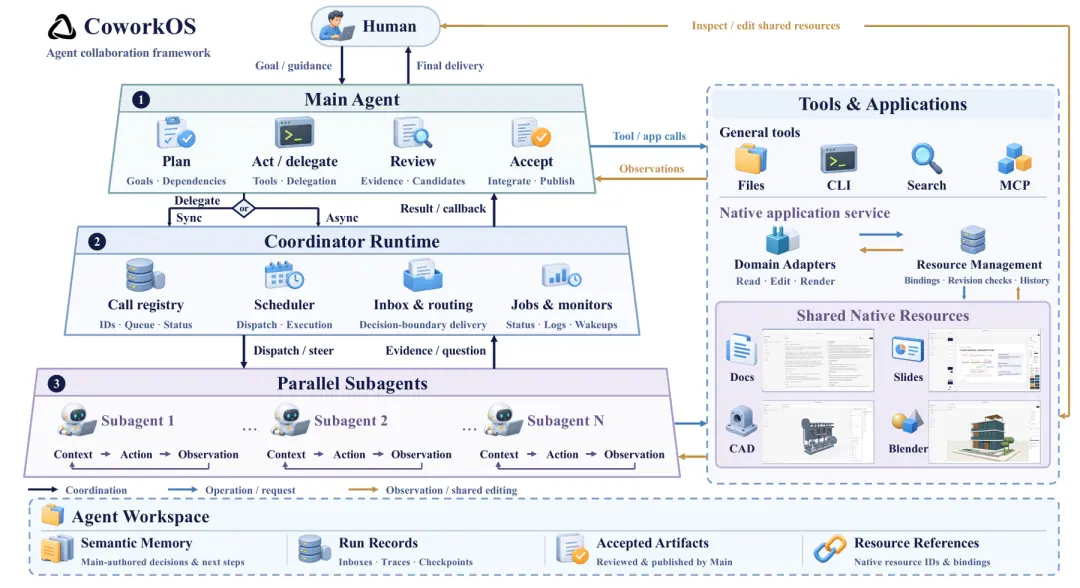
图 3:CoworkOS 的三层协作架构。
协作能否持续推进,还取决于任务分出去之后,进度与问题能否及时传回来。为此,CoworkOS 在主智能体与子智能体之间设置了协调运行时(Coordinator Runtime),负责调度任务、记录状态和传递结果。需要立即拿到结果的工作可以同步等待,耗时较长的工作则可以异步执行,让主智能体继续处理其他事项。执行过程中,用户可以追加指导,子智能体遇到不确定的问题也可以带着暂定方案提问。Watchdog 则检查子智能体是否停滞或异常,并将问题报告给协调运行时,为后续恢复或调整任务安排提供依据。
二.共享应用环境:让人和智能体围绕同一份作品协作
CoworkOS 把作品本身作为协作的共同基础,让人的修改直接进入智能体后续的工作。在实际办公中,用户往往不会只通过对话表达意见,也会直接改一段文案、调整一页演示。如图 4 所示,CoworkOS 将文档、演示、CAD、Blender 等应用接入共享环境,让人与智能体能够操作同一份作品。用户修改后,智能体下一次读取作品时,就以更新后的状态为依据继续工作。
多人、多智能体共同修改时,CoworkOS 通过版本核对与候选审查来协调改动。如果智能体读取作品后,用户又修改了其中的内容,智能体继续按旧版本写入就可能覆盖用户的工作。为此,CoworkOS 在写入时核对预期版本;发现版本已经变化,就暴露冲突,让智能体重新读取并判断如何处理。子智能体的修改则先保存在独立候选中,由主智能体审查后再合入。这让不同参与者能够分头准备改动,同时保留检查和调整的机会。
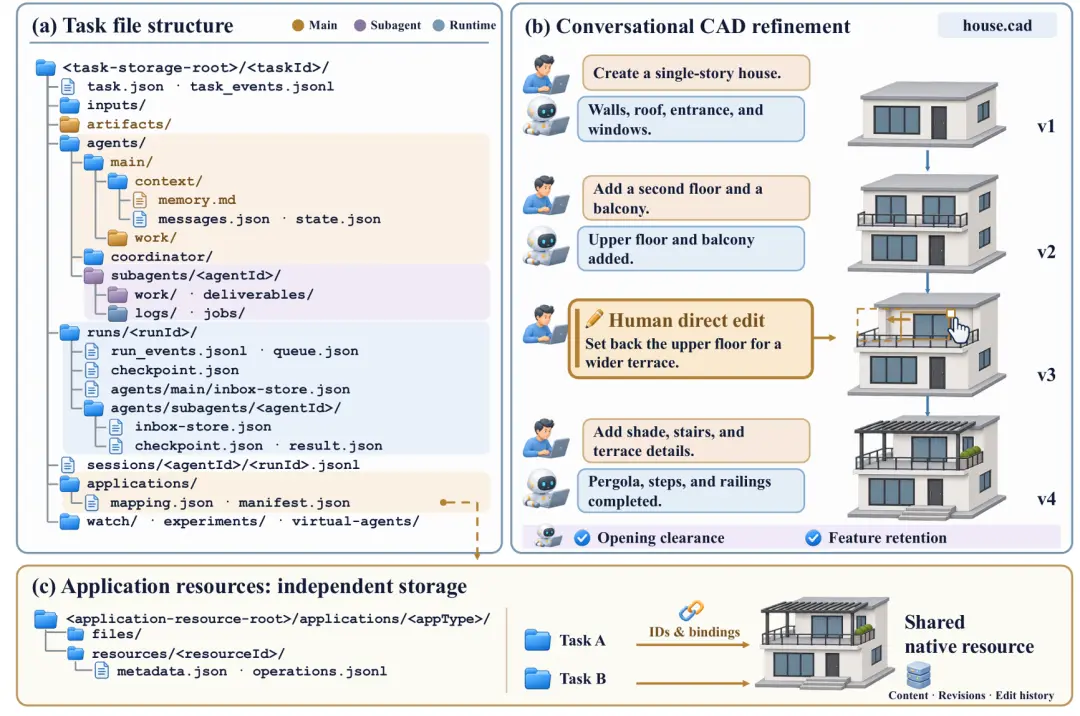
图 4:CoworkOS 的共享应用层:通用工具与文档、CAD 原生应用,人与智能体修订同一份资源。
真机操作演示・CoworkOS 驱动 Blender 建模
三、持久工作状态与异步执行:让工作跨越会话继续推进
要让智能体持续承担工作,需要保存的不只是对话,还有材料、决策与执行进度。一项任务持续几天后,智能体需要知道哪些事情已经完成、以及接下来还要处理什么。CoworkOS 将这些信息分别保存:工作区保留材料与成果,语义记忆记录关键决策和待办,任务台账关联执行过程与指标。切换会话时,系统先恢复一份精简的工作状态摘要,再按需查阅原始材料与证据。这样,后续行动就能建立在已有进展之上,避免头梳理整段历史。
对于耗时执行与持续监控,CoworkOS 让任务在后台运行,在需要判断时再唤回智能体。训练、构建等操作可能持续很长时间,系统会将它们托管为后台任务(Job),保留可查询的状态与日志,供智能体跨会话继续跟进。对于需要持续观察的事项,系统则按时间或外部事件唤回主智能体。监控条件发生变化后,也可以判断应该继续执行、调整方案、请求用户参与,还是结束任务。后台运行与智能体判断由此衔接起来,让工作能够持续推进。
实验结果(一):在 12 项基准上检验真实工作的执行能力
团队首先在四类任务、12 项基准上,验证 CoworkOS 处理真实工作的能力。这些任务覆盖工具使用、生产力、搜索与机器学习编程,实验统一使用 GLM-5.3 作为底层模型,将 CoworkOS 与 OpenHands、Codex、DeepSeek Harness 进行比较。
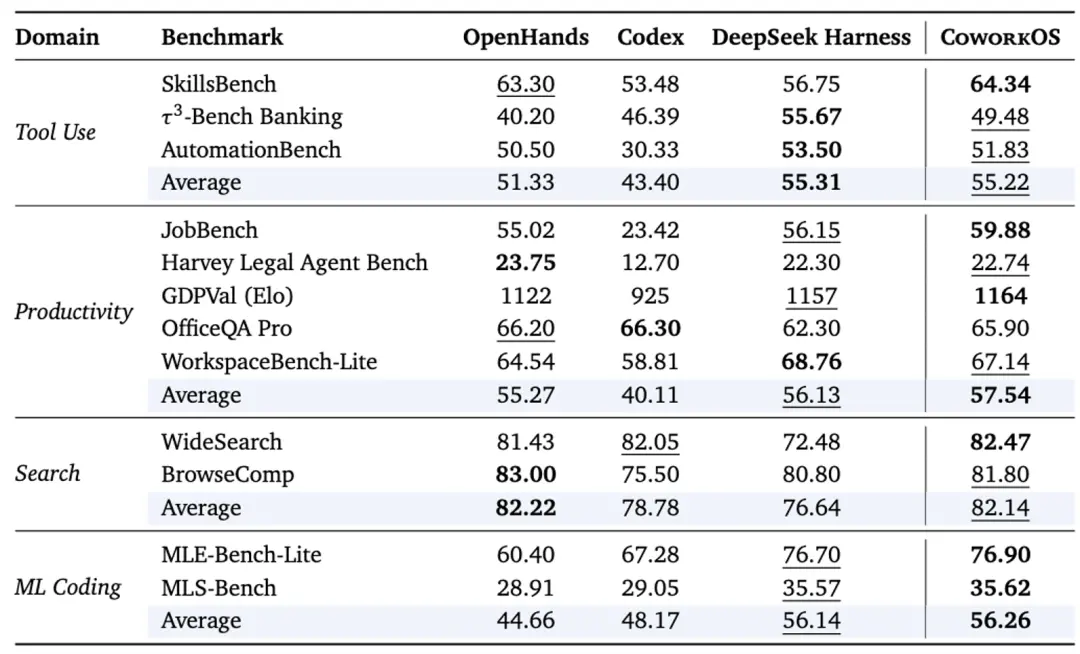
表 1:CoworkOS 与 OpenHands、Codex、DeepSeek Harness 在 12 项基准上的表现。粗体与下划线分别表示最优和次优结果。
从领域平均分看,CoworkOS 在四类任务中均位居前二,其中生产力与机器学习编程排名第一。在工具使用领域,CoworkOS 的平均分为 55.22,与 DSH 的 55.31 接近;在搜索领域,CoworkOS 为 82.14,略低于 OpenHands 的 82.22。在生产力与机器学习编程领域,CoworkOS 的平均分分别达到 57.54 和 56.26,均为四个系统中的最高值。这些结果显示,CoworkOS 能够覆盖多种工作类型,在不同任务上保持较有竞争力的表现。
具体到单项任务,CoworkOS 在其中六项取得最优结果。这些任务包括 SkillsBench、JobBench、GDPVal、WideSearch,以及两项机器学习编程基准。DSH 则在 Tau-3、AutomationBench 和 WorkspaceBench-Lite 上领先,OpenHands 在 BrowseComp 与 Harvey 上表现更好,Codex 在 OfficeQA Pro 上得分最高。这也说明,真实工作对智能体提出了不同要求:工具操作、信息查找、专业判断与最终交付,需要分别检验。
实验结果(二):从基准分数走向完整可交付产品
除了标准化评测,团队还通过六大类、24 个真实任务,展示智能体交付能力。这些任务覆盖网站、游戏、办公演示、交互可视化、CAD 与 Blender 场景。团队将 CoworkOS、Codex 与 DeepSeek Harness 的最终作品并置呈现,让读者能够直接比较视觉呈现与功能完成情况。
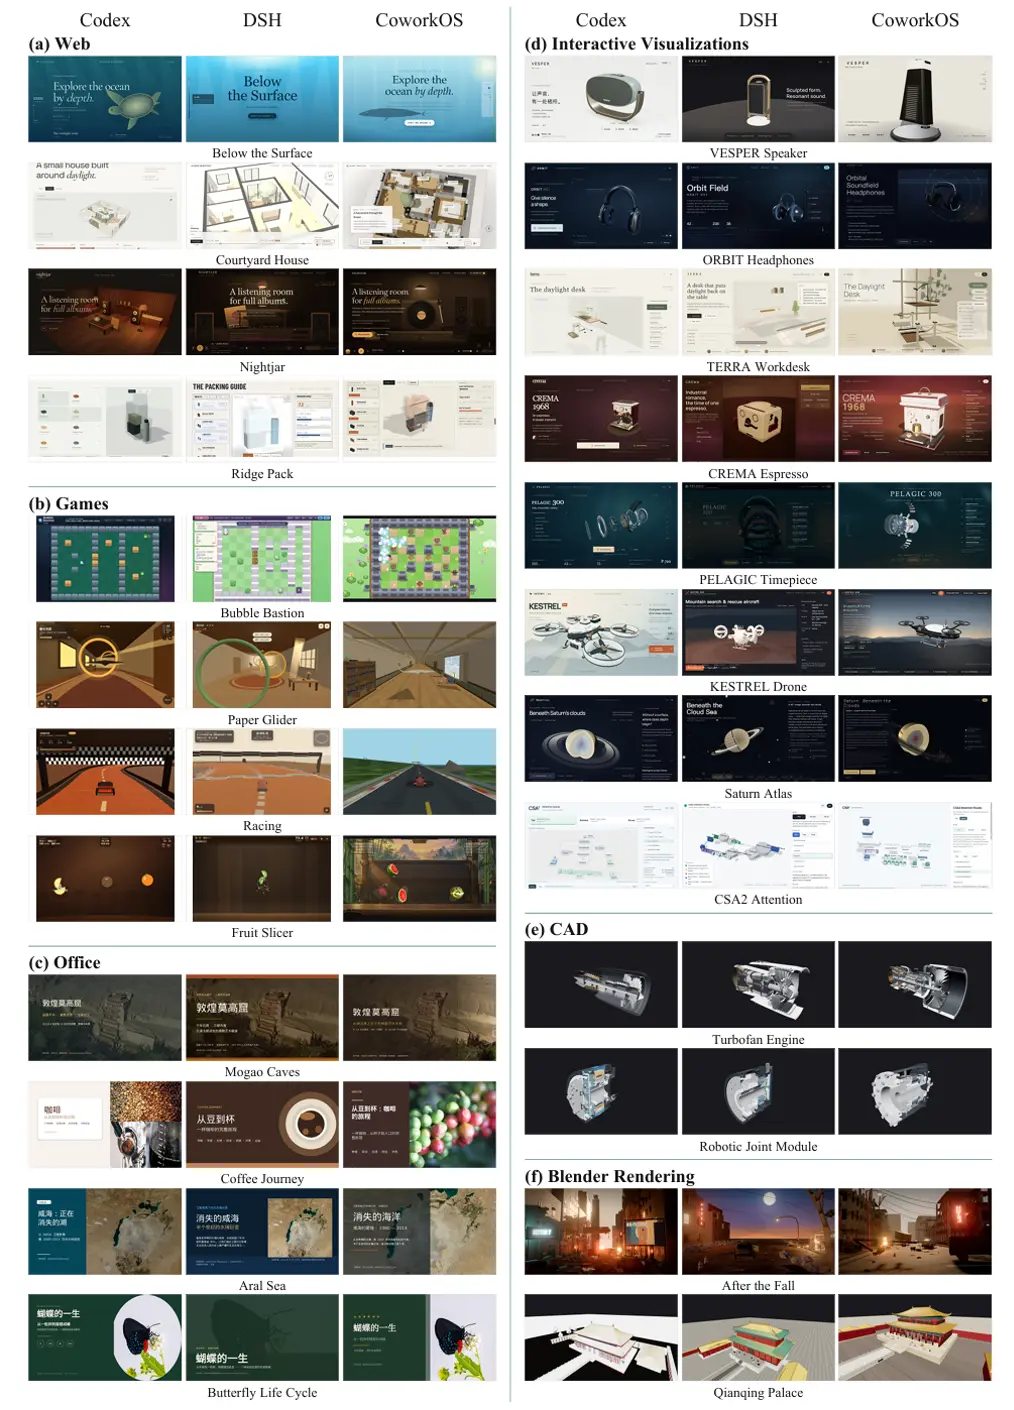
图 6:24 个真实任务的交付对比,覆盖网站、游戏、办公演示、交互可视化、CAD 与 Blender 六类场景。
不同类型的作品,也让复杂交付的要求变得更直观。例如,After the Fall 对应一个末日废土风格的 Blender 场景,Turbofan Engine 对应涡扇发动机 CAD 模型,KESTREL 将救援无人机以交互可视化形式呈现,Courtyard House 则围绕四合院组织网站内容。这些任务涉及的工作各不相同:场景需要组织空间、材质与光照,模型需要处理部件结构,交互页面需要把内容、布局与操作连接起来。下方选取四个案例展开,完整的 24 个任务及三方交付对比可在案例画廊中查看。
After the Fall・末日废土世界(Blender)
Turbofan Engine・涡扇发动机(CAD)
KESTREL・救援无人机(交互可视化)
Courtyard House・四合院(前端网站)
实验结果(三):探索递归自我改进(RSI),自动化推进 LLM 后训练
递归自我改进(RSI)关注的是:AI 能否参与改进 AI,并根据反馈持续推进下一轮优化。随着智能体能力逐步进化、自动化模型后训练成为代表性的智能体能力评测场景。它涉及评测、问题诊断、数据构建与训练等多个环节。要把这些环节持续组织起来,智能体既需要完成具体操作,也需要保留实验进展、理解反馈,并据此调整后续工作。
团队以自动化 LLM 后训练为任务场景,探索 CoworkOS 如何支撑多轮改进。实验由 GLM-5.3 担任控制器与数据教师,结合 CoworkOS 的 harness 对 Qwen3.6-35B-A3B 开展五轮迭代。起点 R0 是使用 1,345 条种子轨迹完成监督微调的模型;后续由 CoworkOS 衔接评测、诊断、数据生成与训练,根据每轮反馈调整后续方案,五轮迭代后,模型的八项平均分从 33.19 提升至 42.95,增加了 9.76 分。
这一过程包含多次依据反馈作出的调整。例如,第一轮围绕工具选择、参数填写与反馈处理等失败模式补充数据;第二轮平均分下降后,后续迭代进一步调整数据覆盖与训练安排。到第五轮,系统针对 BFCL 的表现补充函数调用相关轨迹,这类轨迹占当轮新增数据的 61.1%,对应的 BFCL 得分也出现明显回升。
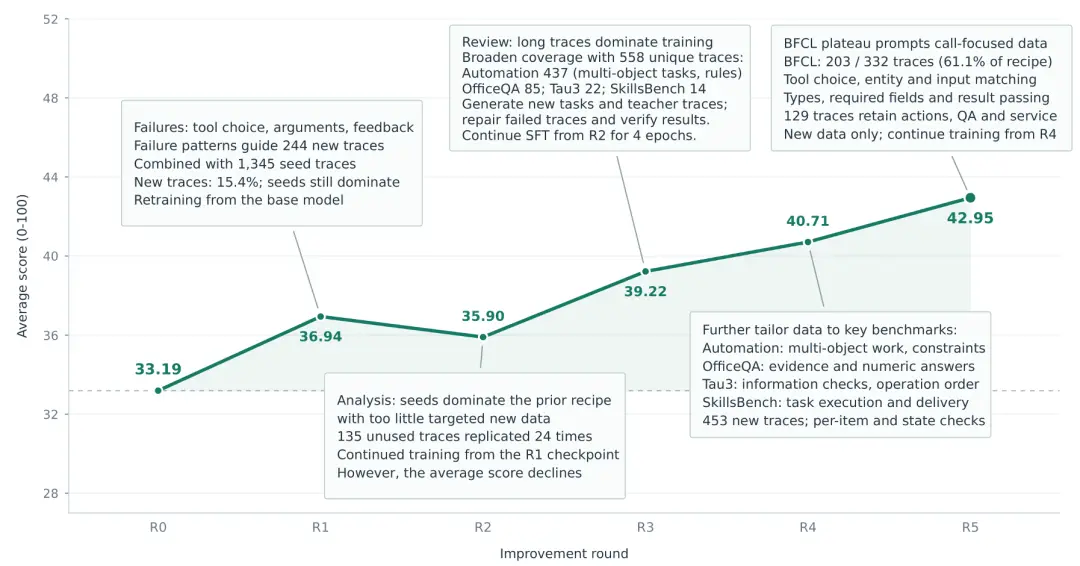
图 7:大模型自动化后训练结果展示:五轮后训练的平均分变化,以及各轮依据评测反馈作出的主要调整。
逐项结果显示,多数能力有所提升,但不同任务的变化并不同步。如下图,最终八项基准中有七项超过起点,其中六项达到 R0 至 R5 期间的最高分,包含并列最高的情况。Automation 从 11.00 提升至 44.15,SkillsBench 从 20.85 提升至 35.76,BFCL 从 63.48 提升至 70.83。与此同时,GDPVal 的最高分出现在第二轮,JobBench 的最终得分仍低于起点。
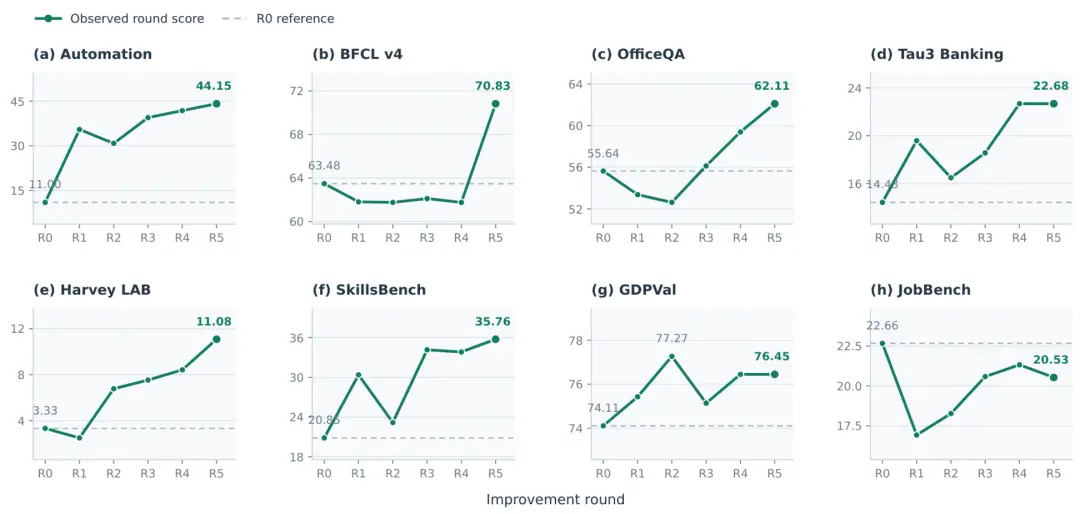
图 8:五轮实验中八项基准在各轮迭代中的变化,展示整体提升与单项波动。
总结与展望
CoworkOS 已将 Super Agent 的愿景落成一套可运行的系统。沿着同一组标准,其后续演进可归纳为六点:
-
连续:走向跨设备、跨会话的 AI 同事,上下文与作品无缝承接。
-
高效:走向更大规模、更细粒度的任务组织与资源调度。
-
主动:走向更可靠的事件理解与价值判断,减少误判与打扰。
-
持久:走向异常自愈与更长时程的无人值守运行。
-
生态扩展:进一步接入科学计算与多模态工具,让人与智能体能够在更多专业环境中共同完成工作。
-
自我改进:探索递归自我改进(RSI),让智能体根据评测结果诊断问题、调整方案并验证效果,将多轮改进扩展到更广泛的研究与工程任务。
作者团队
CoworkOS 由中国人民大学、复旦大学、北京大学、新加坡国立大学、上海交通大学、华东师范大学联合团队完成。其中核心贡献者包括:金佳杰 *、董冠霆 *、潘成骏 *、邓鑫、盛卓辉、王国强、桂韬†、朱余韬†(* 共同第一作者,† 通讯作者)。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com