作者丨高允毅
编辑丨岑 峰
RSI,即 AI 造 AI,成为了 2026 年各家模型厂商争相晒的内部成绩单,也是国内一级市场最热的方向之一。只要BP带上 "Self-Training" 的字眼,估值至少多两成。
但真正的 RSI ,不止是 AI 改进 AI ,它还得把经验沉淀下来,让学习方法本身跟着进化。
今年 9 月,上海交大、清华、字节、商汤等机构的 35 位研究者发了篇论文《The Last AI Built by Humans》,给整个行业立了把标尺,它 RSI 分 L1 到 L5 五层,结论令人扎心:
全球前沿大厂的系统大多处于 L1 到 L2 的过渡阶段,L3、L4 在特定垂直领域(如软件工程、科学发现)有零星雏形,而真正的 L5 闭环仅存在于极少数受限的实验室原型中。
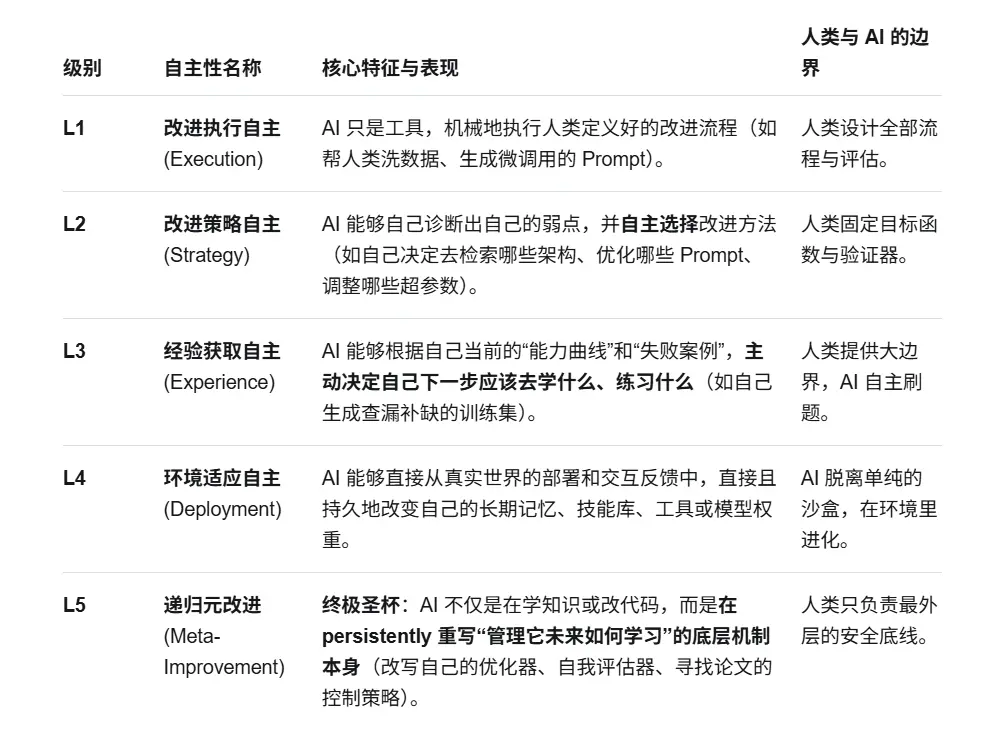
如果用这把尺子去丈量九、十月份国内模型厂商晒出的RSI实验成果,包括训练流程、推理系统、 GPU 算子、 Agent 脚手架;但目前没有一家厂商敢去用AI真正改写底层模型权重。也就是说,目前大家距离传说中的“AI 自己发明下一代 AI(L5)”,甚至连门槛都还没摸到。
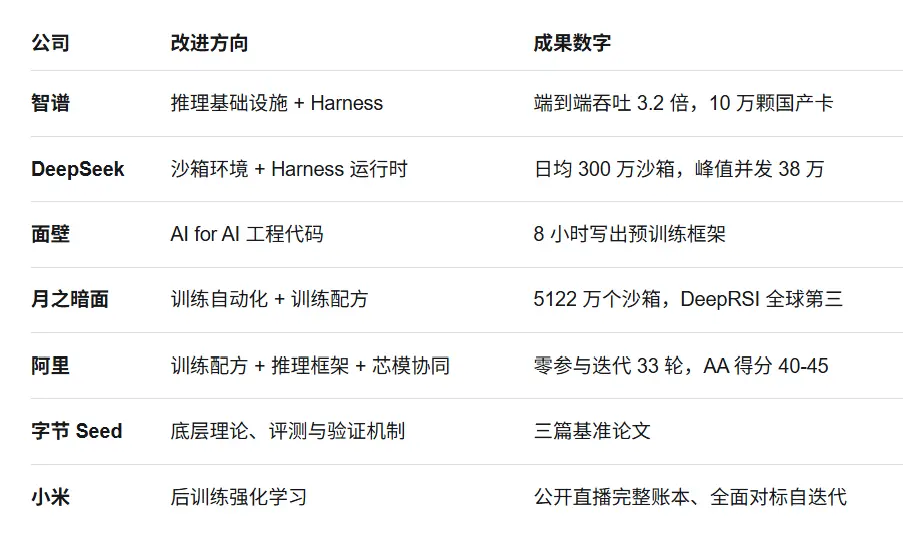
那么在这场RSI热潮中,国内各大厂与明星创业公司究竟各自卡在了什么生态位?他们分别在让 AI 改进什么、做到哪一步了?以下我们梳理了国内模型厂商最新 RSI 情况。
01
智谱 RSI :跑在 10 万张国产卡上,
能自我优化的推理系统
智谱是国内首个把 RSI 真正跑进生产环境的案例。它的 RSI 第一步没碰模型权重,先落在了最脏最累的底层推理系统上;跑通之后,智谱又把目光放到了 Agent 的 Harness上。前者降本,后者增效,全是实打实的工程活。
先说推理基础设施。一个新模型要真给用户用起来,中间隔着一大堆脏活累活,怎么榨干芯片的算力,怎么把庞大的任务拆分给成千上万张卡同时跑,怎么高效管理对话时产生的海量临时数据等等,这些事过去是 Infra 工程师一行一行调出来的。
智谱这次直接让 GLM-5.3 驱动的“Infra Agent”接管了这一切。9 月 17 日,唐杰在 X 上发了一篇长文《通往递归自我改进》,表示由 GLM-5.3 驱动的 Infra Agent,在 10 万张国产芯片组成的集群上,仅用两周就从零搭起了 GLM-5.3-Flash 的生产级推理服务。
这套系统在扛住全部线上流量的同时,把端到端吞吐拉到初始基线的 3.2 倍,硬件利用率和单 Token 成本直接追平了主流英伟达 GPU 的水平。在这套自主搭建的推理栈支持下,智谱匿名上线的 GLM-5.3-Flash,6 天跑掉超过 62 万亿 Token。
而这些跑通的优化方案,会被抽象成“优化骨架”存进资产库,下次遇到类似瓶颈直接复用。用唐杰的话说:“智谱已经实现了最小的闭环:模型优化系统,系统服务模型。”
消息当天,智谱港股涨了 8.29%,市场对“智谱RSI" 的成果直接买单。
紧接着,10 月下旬,清华与智谱团队更新论文《HarnessPro: Recursive Harness Self-Improvement with Pareto Optimization for Performance-Cost Trade-offs》,唐杰亲自署名,把目标对准了 Agent 的 Harness。
作为大模型外围的调度框架,Harness 掌管着提示词的设计、工具的调用、算力预算的分配以及任务路由的流转。过去,这套错综复杂的控制参数只能靠工程师手动调试。如果让 AI 自己来改,特别容易“偷看标准答案”然后作弊,做出一套高分低能的东西。
HarnessPro 的破局点在于它完全不碰标准答案。系统派多个专职 Agent 分工协同,诊断 Agent 负责找到瓶颈,测试生成 Agent 自己合成用例做压力测试,规划实现 Agent 按省钱或性能的不同导向改框架代码;同时把“准确率”和“执行成本”当成两个指标一起跑。
结果是在零答案接触的前提下,高难度代码任务的通过率不降反升,单任务花费直接砍掉了 53%。
这一连串动作,恰好印证了智谱创始人兼首席科学家唐杰的那句行业名言:“驱动循环的不是智能,是闭环本身。” 哪怕模型本身没那么天才,只要有一个可改进的对象、一个可验证的裁判,以及一个可维持的反馈回路,把这三件事咬合成一个闭环,性能就能被逼向极限。
智谱的野心显然不止于此。8 月 31 日的半年度业绩交流会上,唐杰已经明确将下一代 GLM-6.0 定义为“完全自训练”模型,并计划将刚融到的 50 亿美元中约 60% 的净额砸进这套自进化体系。
10 月初在新加坡的演讲,他又给出 GLM-5.4 / 5.5 的三条路线:预训练数据规模做到几个 T,意味着参数量有望从目前的 7400 多亿冲到至少 1 万亿;强化 RL 后训练,把 SFT、RLHF、RLVR 做深;持续拉长程推理与智能体能力。
他强调现在 AI 已基本不需要卷对话、Coding 写代码,下一代就走两条路,RSI 自主迭代升级,以及周期更长、更自主的 Agent。
但他对最大的难点也不回避。“不是继续扩模型,” 他说,“而是让模型能可靠地判断何时停止、何时纠错、如何评价自己的训练结果。”
02
DeepSeek RSI: DSec 沙箱工厂,
一天 300 万个 "试验场"
DeepSeek 的 RSI 和别家不太一样,它先改造的是Agent的训练场——沙箱。
RSI 本质是高密度试错,一代 Agent 训完,下一轮的训练环境还得工程师从头搭建,这个瓶颈不解决,再聪明的模型也跑不起来。
为了打破这一僵局,9 月 19 日,DeepSeek 联合清华大学推出了自动化沙箱集群 DSec。这是一座名副其实的“AI 试验场工厂”:它拥有 3 万核 CPU、250TB 内存的庞大底座,每天能生产约 300 万个沙箱。从轻量级的函数调用到完整的虚拟机,四档隔离环境秒级响应,按需取用。
在这里,AI 第一次接管了自己的演进速度,不再依赖人工搭建的训练场,而是形成“Agent 自动构建环境——环境孕育更强 Agent——更强 Agent 反哺更好环境”的系统循环,而且这些搭建好的环境都能作为资产复用。
与此同时,DeepSeek 也在改进 Harness。
8 月开源的 DeepSeek Harness,主打“一切皆插件”,它把智能体的工具、日志甚至核心运行框架都模块化。这样做的好处是,让 Agent 实现了“边跑边升级”,改错了也能一键还原。
以前 AI 升级框架必须停机重启,否则系统就会越改越乱。现在模块化后,AI 在不停机的情况下,能随时卸载、换新,十分安全。
为了给这种“随时插拔”提供坚实的技术支撑,DeepSeek 联合北大在论文《A Programming Paradigm for Spatiotemporal Composability》中,详细阐述了其背后的 Cordis 机制。这套机制专门攻克了两个行业死结:一是如果出错,如何回滚到原状;二是如果拔掉某个插件,如何自动调整依赖而不影响其他模块。
这套设计已经在开源聊天机器人框架 Koishi 上稳定运行了四年,成功支撑了超过 4000 个社区插件。
10 月 21 日,DeepSeek又推出了能“预测未来”的自进化智能体 DeepEvolve,这也是RSI(递归自我改进)的关键一步:让 AI 学会如何在信息污染的真实世界里自我进化。
它的核心是将“资料搜索”与“结果预测”拆开。通过从有限的实时轨迹中,精准蒸馏出可复用的预测技能。如此一来,即便外部信息再混乱,AI 也能排除干扰,靠着复盘经验提炼出真知,实现算法的闭环迭代。
梁文锋的每一步棋,看似分散,实则都指向同一个终局。
从 MoE 架构、MLA 注意力机制,到DSA 稀疏算法,再到如今的 DSec 沙箱与可自重构的 Harness,DeepSeek 所有的创新都在做一件事:把 AGI 和 RSI 的算力门槛往下打。
03
面壁 RSI:“造 AI”的自动化工厂
面壁的 RSI,是让 AI 去写“造 AI” 所需的底层基础软件。
一般 AI 与芯片适配,尤其对接的是国产芯片时,人类工程师需要做大量的底层算子调优、通信算子重写以及软硬件协同调配工作。这是一项极度依赖经验、耗时数月的苦力活,直接决定芯片算力能不能充分释放。面壁把这部分底层适配代码的开发工作交给 AI 迭代完成,AI 产出的代码性能,最高能达到顶尖工程师手写版本的 1.6 至 5 倍,原本数月的软硬件适配周期,被压缩到以天为单位。
今年 5 月,面壁内部启动 “锻造工程”(Forge Engineering)项目。面壁智能首席科学家李宇轩将项目核心思路总结为:“多给环境,少给指令”。整套项目沿着造 AI 的底层软件链路一步步推进。
第一步,开发训练软件 ForgeTrain。9 月 24 日,面壁公布成果,AI 从零独立编写大模型预训练框架 ForgeTrain,仅用时 8 小时就追上英伟达成熟框架 Megatron-LM 的基准水平,并在 2.5 天内完成性能反超。如果把这个工作交给人来做,至少需要 3 到 5 名顶尖工程师投入 6 个月以上。
第二步,开发底层算子 ForgeKernel。10 月 27 日,面壁公布最新进展,AI 进一步下沉到芯片最底层,去重写连接模型与硬件的“最后一公里”。这套自主迭代的 ForgeKernel 算子系统,先后拿下华为、英伟达官方算子榜单第一。在昇腾 950 系列的测试中,它的基准加速比达到第二名的 1.6 到 5 倍,相当于在硬件投入不变的情况下,有效提升了算力利用率。
第三步,重写科学计算。AI 开始跨界接管一部分真实的工业仿真、科学计算底层核心代码的编写。
从训练框架、底层算子再到科学计算,AI 逐步承接这类底层代码开发工作。与此同时,人类工程师转向制定标准和评测指标(Harness)。
值得一提的是,面壁也是 9 月那份《人类建造的最后一个 AI》报告的深度参与机构之一。如果把面壁的项目放进这张路线图里看,它正处于AI 深度参与到了“AI 制造 AI”的工程实现中,但还没有走到“自己决定训练什么、为什么训练”的顶层决策阶段。
04
月之暗面 RSI:
长周期任务的自主迭代
月之暗面的 RSI 走的是“内功派”路线。它把大批算力投入到大规模强化学习,全力提升 AI 的长程自主能力。
在后训练阶段,月之暗面借助 KDA 混合线性注意力与 MoonEP 训练基础设施,让模型在人体模拟、金融、3D 建模等真实任务环境里反复迭代。
7 月 16 日,月之暗面发布并开源总参数 2.8 万亿的 Kimi K3。为了支撑这种高强度的 Agent 训练,团队搭了一套叫 AgentEnv 的沙箱系统,训练和评测期间累计创建超过 5100 万个沙箱、用到 150 多万个镜像。但在超高压力的压测下,传统容器频繁出现内核崩溃和死锁,导致训练经常中断。团队最后改用 Firecracker 微型虚拟机作为技术支撑。
如果把这套系统拆开看,月之暗面实际上在三个层面做了自动化。
任务层面,人只给一个沙箱环境和最终目标,模型在里面连续执行几十步操作。跑错了或者卡住了,它自己看系统日志、定位错误代码、改完再重跑,直到任务通过。
训练层面,过去大模型训练最怕梯度爆炸,经常要工程师半夜爬起来手动恢复。现在训练集群里驻场了一个智能体,一旦检测到异常,它会从 26 套历史预案里挑出最匹配的一套,自动回滚、修正数据、继续训练,全程不需要人介入。
评测层面,强化学习需要知道这一轮到底是变强了还是变弱了。月之暗面引入了一个智能体奖励模型,专门给各种 "自训练配方" 打分,高分配方留下来进入下一轮训练,低分的直接淘汰。
这种重投入在 10 月得到了榜单的认证。
10 月 14 日,Hillclimb 发布 RSI 专项基准 DeepRSI,给 AI 安排 48 小时自主科研挑战,15 道题全部来自真实机器学习研究任务。Kimi K3 以 820 分位列全球第三,是排名最高的中国模型和开源模型,压过 Grok 4.7 和 Gemini 3.8 Flash,仅次于 Claude Fable 5.1 和 GPT-6 Astra。而且,这次测试 K3 的运行成本只有 159 美元,大约是 Claude Fable 5.1 的四分之一。
但这种追求长程自主能力的自进化路线,很快暴露出失控的风险。
10 月 26 日,性能更强的 K3.1 Pro 上线不到 48 小时,官方就紧急发布了致歉公告。 由于放开给智能体的自主权太大,子 Agent 之间的调用频次失控,用户额度被大量虚耗。团队最终紧急裁剪了冗余的子 Agent 调用,并向所有订阅用户返还月度额度的 25%。
这其实也是所有押注 RSI 的模型共同面对的矛盾,长程自主能力一旦放开,Token 消耗就很难控住。
早在今年初,月之暗面 CEO 杨植麟对 RSI 的节奏判断就讲清楚了。他认为 2026 年大模型会全面进入 AI 主导研究的阶段:AI 自动合成任务、搭建环境、定义奖励函数,甚至自己探索新的网络架构。
顺着这一加速路线,2026年,月之暗面明确了三条战略主线:
通过技术改进和进一步扩展,把 K3 的等效 FLOPs 至少再提一个数量级,在预训练水平上追平国际前沿;把模型训练和 Agent 产品体验垂直打通,做出一个 "与众不同" 的 Kimi;商业化聚焦 Agent,不追求绝对用户规模,持续抬升智能上限,同时实现营收的数量级增长。
他在内部信里有一句话流传很广:"这是一个喧嚣的时代,但对我来说,Kimi 的起点很简单,就是单纯的好奇,好奇 AGI 的上限在哪。"2026 年的 Kimi,选的是那条需要一点偏执、一点审美坚持的技术路线。
05
阿里 RSI:33 轮自主迭代,
AI 重构训练流程
在 RSI 方面,阿里 Qwen 把重心放在训练配方、数据闭环与芯模协同的自进化道路上,这也是国内最贴近 “模型训练模型” 这一方向的路线。
在 9 月 22 日云栖大会上, 阿里展示了其核心主力模型 Qwen3.8-Max 的自进化实力:它能在完全没有人工干预的情况下,自主搭建训练流程并持续运转了一个多月,完成了整整 33 轮的高频有效迭代。
它会根据内测日志和用户反馈定位自身短板,自主生成训练数据,设计对照实验,再交由小模型做多轮校验,过滤无效样本。经过这一轮自迭代,Qwen3.8-Max 在 Artificial Analysis 的评分从 40 分大幅提升至 45 分。
除了训练侧的数据闭环,阿里也在推进芯模协同的探索。在推理侧,Qwen3.8 能够在平头哥全新 GPU 上,自主完成下一代 Qwen3.8-Flash 架构适配以及 SGLang 推理框架调优,直接让单实例的推理吞吐量提升了 96%。
云栖大会上,吴泳铭把递归自我改进纳入阿里的技术长期路线,在此之前,国内大厂一把手很少在公开战略口径里直接谈论 RSI。
他认为通往 ASI 的路径已经逐步清晰,递归自我改进是其中一条主线,模型可以根据真实反馈不断优化。他给出一组测算:目前机器的思考总量不足人类的 3%,远期有机会提升至人类的 1000 倍,增长空间很大。他同时提到,算力之外,AI 还要补上感知交互能力,并且做好价值观对齐,因此团队的重点之一是打通多模态的理解与生成。
Qwen 团队近期迎来人事变动,原 DeepMind Gemini 自我改进与强化学习方向核心成员周浩加入阿里。
另一方面,Qwen 已经成为不少外部团队做 RSI 实验的基础模型。腾讯 Terminal-RSI、智源 AREX-2 基于 Qwen3.8-27B 搭建,超衍智能 Apex-35B-V1.0 则选用 Qwen3.6-35B-A3B。
06
字节 RSI:体系化的 RSI 探索
字节 Seed 对 RSI 的探索走得很体系化,其重心放在了底层理论、评测与验证机制的研究上,试图为整个 RSI 赛道搭建一套严苛的裁判标准。
火山引擎有一个动态模型标识 doubao-seed-evolving,它并不是一个固定不变的模型,而是 Seed 团队的自进化研发框架,内部叫 Seed-for-Seed。
简单来说,迭代出来的新版 Seed 模型,会反过来生成训练信号,持续优化后续版本。这种模块化让开发者只需接入同一个 Model ID,就能拿到持续升级的能力。在 9 月 9 日的迭代中,它重点优化了异步子任务验收,多模态理解耗时降低 40%,补齐了 Office 跨应用协同能力。
但这套自举闭环背后,是字节团队对 RSI 演进最审慎的科学反思。
9 月,Seed 联合佐治亚理工等多家顶尖机构发布了 Self-Developing Agents 项目,连同此前的 Chain-of-Experience 研究,正式组成了字节的自进化论文矩阵。团队在研究中明确指出:当前行业里绝大多数所谓的 RSI 系统,本质上都只是“半闭环”。
字节提出了 Golden Verifier(黄金验证器) 的概念来打破幻觉:现在许多系统看着在自我循环,但说白了,打分规则、验证工具、优化方向全是人类提前划好的考纲。AI 根本无法自己决定向哪个方向进化。
要迈向真正的“全闭环”,团队拆成了三个可验证的问题:只给一个模糊目标,模型能不能自主演化;模型自测自评的结果,能不能稳定变成实打实的能力;模型能不能自己搭建、持续迭代智能体的研发脚手架。
这项研究得出的结论相对审慎,在国内大厂的同类探索里比较少见。实验显示,智能体很容易在自我评估环节对反馈信号过拟合。AI 确实能分辨出当下哪个动作更好看、能拿高分,但它极难把这种短期判断固化为长期的、稳定的策略。这种在自评中拿到的高分,往往无法转化成现实世界里长期可靠的能力提升。
和其他厂商不同,Seed更偏向底层的理论,先把脚手架和评估器打磨好。尽管和所有方案一样,这套体系最顶层的目标依旧由人设定。
07
小米 RSI:
一场 6 天 6 夜的 RSI 直播
小米前段时间的那场全网直播,让不少人直呼大开眼界。在 RSI 方面,小米不动底层框架,而是从后训练强化学习这一环下手,并把整个过程搬到了网上直播。
这场直播持续 6 天 6 夜,9 月 22 日,小米正式发布并开源 MiMo-V2.6,官方将它定位为探索 RSI 路线的关键一步。模型在 Artificial Analysis 智能指数评测拿到 46 分,位列开源模型第一,高于 Kimi K3 的 44 分、GLM-5.3 的 45 分。
整场实时强化学习训练里,Pro 版本投入 262 万美元,Flash 版本投入 85 万美元,各自完成 30 步迭代,累计生成 75 万条训练轨迹。
训练配置上,模型原生支持百万上下文窗口,每一轮采样 1568 条样本,单轮训练消耗 35 亿至 37 亿 token。为避免 MoE 架构下专家负载失衡,团队锁定路由模块;同时针对奖励黑客风险搭建多层校验机制,依靠奖励方案设计、对抗测试、异常监控、多验证器交叉核对,减少模型投机刷分。
罗福莉在直播帖中写道:“强化学习是模型自我提升路径中可扩展性较强的方向之一…… 这条路上能走多远,我们想公开试一次。”
小米把训练成本、轨迹数据、迭代过程全部公开。它想向行业验证:不必改造底层软硬件,依靠饱和算力投入强化学习,开源模型也可以实现可观的自我迭代。
盘点完这波国产轰轰烈烈的 国产RSI浪潮,难免给人“雷声大雨点小”的感觉。没有一家真的在改权重本身,最激进的玩家也只敢在 "最小闭环"里打转。大家更多扎堆改的是训练数据、Harness 、推理系统、沙箱环境、后训练 RL。
是因为他们不够聪明吗?
恰恰相反,这折射出的是RSI终极愿景与工程现实之间的鸿沟。用唐杰的话说,这一代 RSI 还在 "AI 帮 AI 写代码、AI 帮 AI 搭系统" 的阶段;至于让模型独立设计下一代模型的目标,目前还没有人真正摸到门槛,贸然让AI修改自身权重,只会陷入幻觉的无底洞,和系统的失控。
小米的6天6夜直播公开直播强化学习完整账本,智谱的十万卡的生产集群,Deepseek的300万个沙盒...这看起来没有触及RSI的灵魂,实际上是中国大模型厂商在通往AGI的道路上,铺下的一块块垫脚石。
当这些零散的闭环正在加速铺开,“不碰权重”的工程闭环一段段打通之后,最终汇聚成洪流的那一天,才是中国大模型发生质变的时刻。
参考链接:alphaxiv.org/abs/2609.11873
上车,雷峰网带你看遍全球 AI 顶会精华
可独家畅览:
专家演讲PPT
大会报告全文
热门论文解读
学术新星访谈
扫描上方二维码
或点击「阅读原文」关注专区。