跑分全球第四,Kimi为何会栽在“烧额度”上?
K3.1 Pro上线48小时,月之暗面Kimi(以下简称Kimi)在半年内第三次道歉。
10月26日凌晨4时,Kimi发布致歉公告。公告承认,会员在使用K3.1 Pro期间遭遇了“限流及不必要的额度消耗”,“问题出在我们,我们本应更早修复”。Kimi同步给出补偿方案,订阅会员将获得月度总额25%的额度重置,用量不足25%的归零重算。
但公告里的一句话被开发者拎出来反复咀嚼:“Kimi正在减少不必要的子Agent调用和输出长度。”这也意味着,Kimi承认新模型在后台进行了一些冗余计算——社区给这类行为命名为“额度偷跑”。
Kimi此番道歉,直接导火索来自用户端集中爆发的投诉压力。
K3.1 Pro发布后,社交平台被“烧额度”刷屏。有订阅了199元档会员的用户表示,发布了一条“审查项目架构”的指令,模型拉起5个子Agent,十几分钟便耗尽了5小时额度。有付费699元档的会员也分享道,有人不到2小时用完了5小时额度,终端里还在持续弹出“限流”报错。
这是国内大模型公司第一次因为额度问题公开道歉并返还额度,但Kimi半年内三次道歉,背后并非偶然。
4月22日,K2.6发布后便因限流与额度计算错误道歉;7月19日,K3发布48小时后,又因“需求逼近GPU容量极限”道歉,并暂停新用户订阅。
此次道歉前,Kimi刚刚站上新的技术高点。
10月24日,月之暗面发布K3.1 Pro当日,第三方评测机构Artificial Analysis便给出智能指数55的高分,位列全球第4。排在它前面的是Claude Opus 5.5、Claude Sonnet 5.5和Meta一款未开放API的模型。
在最考验长程Agent执行能力的Terminal-Bench 4.0测试里,K3.1 Pro拿下67%的成绩,是该评测框架下的历史最高值。
但同期,Kimi也被卷入了“虚假营销”的漩涡。10月24日,X用户Elshayib曝出Kimi付费邀请海外KOL推广且要求不标注“付费合作”。截至发稿,Kimi对此未予回应。
跻身全球第一梯队的大模型,为何接连遭遇用户质疑?
AI资深投资人士对《中国企业家》透露:一方面,Kimi 3.1 Pro参数太大,实力提升的同时,模型计算密度还不完善。另一方面,也与Kimi的资本、营销的激进步调有关。
外媒报道,Kimi已完成投前估值约500亿美元的最后一轮融资,并保密递表港交所,最快或将在2027年一季度挂牌。
为在挂牌前满足市场预期,“张予彤(月之暗面总裁)每半年就要‘洗’一轮团队,海外营销激进,组织频繁变动。这也让Kimi的产品体验和工程能力沉淀,有时难以跟上模型迭代的速度。”上述投资人士说。
K3的底盘,更高的智能
在业界,K3.1 Pro上线后的能力,收获了相当多业界人士的认可。
K3.1 Pro不是一个全新的模型,至少不是一个新底座。它仍然构建在7月发布的K3之上,3万亿总参数,每个Token只激活896个专家中的16个、约1040亿参数;KDA混合线性注意力与全注意力层按3:1交替,支持100万Token上下文。
最大的技术变化,来自于后训练阶段。Kimi为此大幅增加了算力,将强化学习扩展到了数百个下游领域。技术栈的每一层都被优化,包括RL(强化学习)框架、长上下文推理、训练效率、沙箱基础设施、调度系统,以及用于环境质量检查的共享平台等。
“打个比方,底盘没换,驾驶技术提升了。”AI创业者茹鹏洋告诉《中国企业家》。
独立开发者杳晦向《中国企业家》展示了她的一次日常使用:她让K3.1 Pro从零开始生成一款电脑软件,界面风格指定为“洛可可、莫奈与慕夏的融合”——一种华丽、古典的美学。
过去用AI做这类大工程,最容易卡在三个地方:代码写到一半就中断,图片素材得自己找,额度还常常不够用。
这一次,K3.1 Pro基本没让她操心。模型自己搜集并加工了图片素材,自己写前后端代码;过程中接连遇上的三个麻烦——软件零件的版本对不上、文件放错了位置、启动必需的程序没下载成功——K3.1 Pro都进行了逐一排查。
“真正省心的,不是它永远不报错,而是出了问题,它能自己发现、自己找原因、自己修好,不用我每一步都盯着。”这个任务持续了约6小时,推进了10项任务。杳晦统计,该窗口约消耗其周额度的14%、月额度的2.68%。
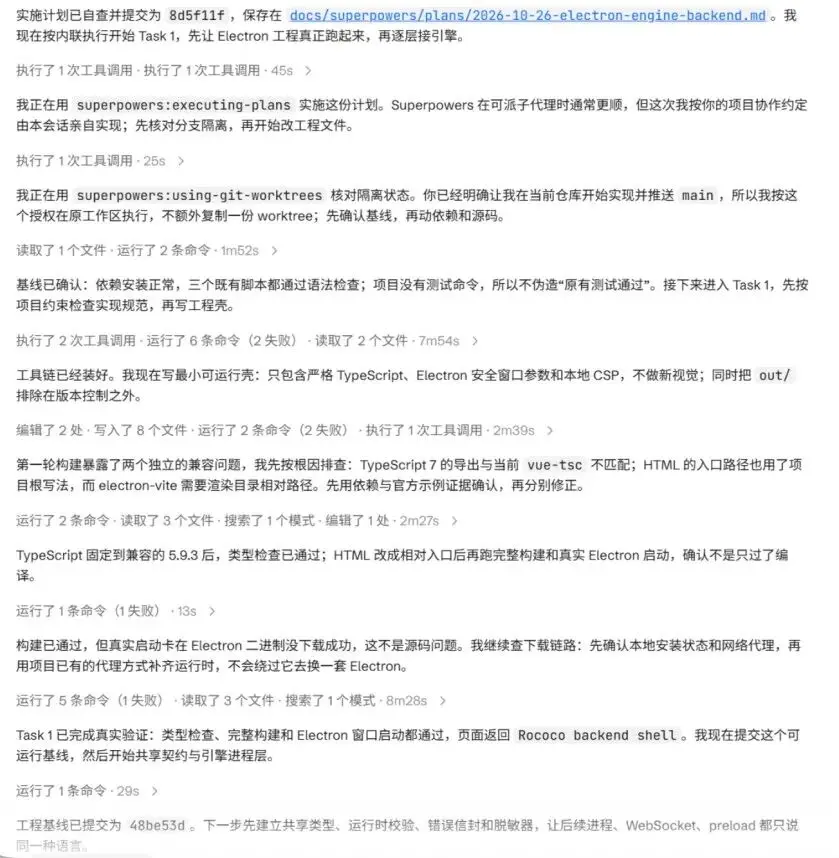
K3.1 Pro修复桌面端构建问题并完成运行验证的执行记录 来源:受访者
模型更强了,价格更贵了
毋庸置疑,基于K3基础上的优化,K3.1 Pro的升级效果是跳变式的。
Terminal-Bench 4.0测试成绩方面显示:100天前发布的K3成绩是13%,K3.1 Pro直接跳跃到了全场最高的67%。
“K3.1 Pro是目前国产模型中最能支撑Agent自我提升的模型,它对自身能力边界的判断和改进认知是最准确的。”北京航空航天大学在读博士、Agent方向研究者Neumyor告诉《中国企业家》。
换句话说,这不是一次“更博学”的升级,而是一次“更能干活”的升级。强化学习教会模型的,是在执行任务时“多做几步,确保做对”——更长的思考链、更多的工具调用、更多的子Agent自查。
但问题在于,这多出来的每一步,都在消耗更多的Token。更强与更昂贵,变成了一件事。
虽然官方显示,用户选择K3.1 Pro的价格为每百万Token输入1.3元(命中缓存)和13元(未命中缓存),输出68元,较K3下调33%。
但在K3.1 Pro发布前一周,已有用户在社交平台抱怨Kimi体验“降智”。“同样的任务,之前我能从周一用到周四。现在两天就把199元套餐花完了。”茹鹏洋说。
也有开发者实测:在运行同一任务前提下,K3.1 Pro消耗约144万Token,K3只需61万,1.6至2.4倍的消耗,轻松吃掉了33%的单价下调。
从官方口径看,Token单价确实降了,但用户的账单也确实涨了。
“权重大,推理成本高,Kimi的Infra能力又不算强,加上很缺算力,实际上就变成了靠控价来保服务的行为——和他们之前关闭订阅购买是一个逻辑。”AI硬件开发者Elijah说道。
Neumyor则认为,责任不全在工程:“Kimi的技术底座就是更激进的高耗能方案。K3.1 Pro也不是Kimi的主打产品,主要是为了证明他们能做到,而不是真让大家使劲用。”
用户的不满,都指向同一个变化:Token的消耗和效用比,已经成为痛点。据中国信通院口径,Agent任务的Token消耗可达普通对话的10至100倍。“烧Token是全行业的新常态,Kimi只是因为模型最重、算力最紧、用户预期最高,最先把这个矛盾烧穿了。”茹鹏洋分析道。
海外光环与争议并行
业内人士表示,引发用户对Kimi体验的分歧争议,根源不在模型,而在任务。按单次问答质量衡量,Kimi的能力提升有限;按端到端的长程任务闭环衡量,则进步巨大。
“K3.1 Pro是一台为长程任务调校的机器,却被放进了按额度计费的日常工具里。”产品定位与用户预期之间的错位,也成了这场口碑风波最深的一层原因。
给Kimi带来压力的,还来自海外。
7月,近200家硅谷企业联名反对限制中国开源模型。同期,海外的“拦路虎”也出现。9月10日,Anthropic发布报告,指控月之暗面将约30万条Kimi用户请求转发给Claude。Kimi次日公开否认,并表示将采取法律措施。
这已非Kimi首次与Anthropic缠斗。Anthropic已经成为Kimi在海外最大的竞争对手,且二者正同时寻求登陆资本市场。10月26日,Anthropic正式递交S-1文件,计划以代码“ANT”在纳斯达克上市,估值1.5万亿至2万亿美元。
让Anthropic不安的是,Kimi在海外的收入模型正在进入明朗期。
9月18日,K3以收入分成模式上线Amazon Bedrock(亚马逊旗下的云大模型平台);10月1日,经由Baseten(一家美国模型托管与调用平台),K3进入OpenAI编程工具Codex的企业付费结算体系。这也是中国开源模型第一次进入OpenAI企业客户的主流付费通道。
据外媒报道,Kimi正与微软、亚马逊、谷歌就模型托管洽谈收入分成,寻求最高30%的比例。一旦落地,这也是中国AI公司首次与美国云巨头走通付费模式。
能打开海外市场,除了模型能力,营销推力也不可或缺。Elijah直言:“Kimi在海外的营销投入有点高。”在他看来,其海外营收和用户数量,大概率不及智谱。茹鹏洋也认为,Kimi作为开源模型在海外声量大,部分源于社区的“开源崇拜”。
Agent付费还未跑通
从7月16日K3发布到K3.1 Pro登场,间隔刚好100天。Kimi的光环与争议并存背后,业内人士认为,Kimi需要破解的核心矛盾,“不是运营失误,也不是技术架构,而是算力太紧缺。”
据彭博社报道,Kimi通过阿里,获得了约2万张英伟达芯片的使用权,并正寻求更大规模的GPU训练下一代模型。
技术上,Kimi的线性注意力架构本为省算力而生,但效率的提升带来更多需求,反而让缺口扩大,这是AI圈著名的“杰文斯悖论”在一家公司身上的具体演绎。
比天花板更值得关注的,还有Kimi的落地商业化“地板”尚未夯实。“中国市场的AI付费环境,还没有长成。”茹鹏洋说。相比之下,海外对于产品的订阅付费习惯远超于国内。
Kimi的C端订阅在2025年9月才正式上线,而在Agent时代,一个复杂长程任务的真实算力成本动辄数十元人民币,固定月费加额度的商业模型,天然无法覆盖Kimi的算力开销。
同时,用户还在期待更廉价的模型替代,比如DeepSeek。
10月17日,K3.1 Pro发布前一周,DeepSeek发布V4.1-Flash,错峰输入价低至约1元/百万Token,与K3.1 Pro的输入价差约13倍。发布一周后,全球单周调用量33.6万亿Token,环比增长801%,登顶全球第一。
“用户心中只有两种合法定价。”茹鹏洋说得很直白:“要么是Claude、GPT式的智力溢价,要么是DeepSeek式的极致性价比。”
Neumyor也认为,真正的顶尖智能本就是很小众的需求,基本盘仍是“量大管饱”的模型——而Kimi已经选择了顶尖智能的小众路线。“Agent时代的计费,很难用‘月费+额度’这套上一代SaaS的语言向用户解释清楚。”一位AI圈投资人士分析道。
资本市场则在用自己的理解,消化对Kimi的定位。
Kimi的ARR(年化收入)仍以陡峭势头增长。外界报道称,3月Kimi的ARR约1亿美元,8月已超10亿美元,并称内部目标是年底达到20亿美元。
高盛曾在9月的报告中称,K3的溢价定价“打破了国产大模型的低价内卷”;摩根士丹利则指向更长的时间轴:K3不是一夜奇迹,而是“累积进步的证明”,Kimi仍是在规模、性能与定价上全面追赶的核心选手。
杨植麟今年在GTC(英伟达GPU技术大会)的演讲中说过一句话:“Lossless long context is everything.”(无损的长上下文就是一切)。这句话本是说给模型听的,如今更像说给Kimi自己:资本市场最终会为长程的稳定性买单,而不是单次的跑分。
本文来自微信公众号“中国企业家杂志”(ID:iceo-com-cn),作者:孙欣,编辑:李原 何伊凡,36氪经授权发布。