最近,黄仁勋又把目光投向了数据中心。这一次,他关注的不只是里面放什么芯片,还有一个更基础的问题:如何更快地建好一座数据中心。
老黄给出的办法是:做预制。
整套Vera Rubin AI工厂在合作伙伴的工厂里装进模块化集装箱,线缆、电路、液冷管路全部布设完毕并通过功能验证,运抵现场后接上电力、冷却和网络即可开机。靠着这一招,现场部署从6个月压缩至最短14天。
预制数据中心,其实并非老黄一家琢磨。
华为推出3D数据中心,将空间布局调整与工厂预制结合起来;立讯精密旗下的立讯智算,也展示了集装箱式预制数据中心方案。大家想解决的是同一个问题:让机房建设和设备交付,尽量跟上算力需求的增长。
毕竟,在AI时代,机房如果还按老节奏慢慢盖,确实容易出现一种尴尬:爷爷立项,爸爸施工,孙子开机,顺便给上一代GPU办个怀旧展。等数据中心两年后建出来,黄花菜都凉了,最后只能当作AI的传家宝。
01 数据中心,花钱大户
AI基础设施到底有多热,可以先看两个指标:花钱,用电。
国际能源署在2026年的报告中指出,五家科技公司的资本开支在2025年超过4000亿美元,预计2026年还要增长75%。用电量也在同步增长。IEA统计,2025年全球数据中心用电需求增长17%,其中面向AI的数据中心增长50%;其更新后的基准预测是,全球数据中心用电量将从2025年的485太瓦时,上升到2030年的约950太瓦时。
国内这边,工信部披露,截至2026年9月底,我国智能算力规模达到2592 EFLOPS,同比增长146%。而这些数字,最终都要靠具体的设备和机房上去实现。
芯片需要服务器,服务器需要网络和存储,还要吃电、散热。到了高密度AI系统这里,供电、液冷、设备重量、安装空间和维护通道,都需要一起设计。英伟达在DSX POD技术说明中,也将计算、网络、电力、液冷和运输结构列为需要协同处理的工程环节。
这意味着,算力扩张带来的不只是“多盖几间机房”。设备的集成程度提高了,配套系统也需要跟着调整。
与此同时,计算设备本身的组织方式正在变化。面对大模型训练和推理中的通信需求,厂商开始通过更紧密的高速互联,将更多加速器组织成协同工作的系统,超节点成为其中的重要方向。
而超节点怎么设计,会直接影响机房怎么配套、怎么安装,以及多久才能交付。
02 形态各异的超节点,给机房出了新题
数据中心的需求下,服务器跟不上了,行业里全都在看超节点。
当前,厂商所说的超节点,并不对应完全一致的物理尺寸。它可以集中在一座机柜里,也可以跨越多座机柜。例如,新华三有单柜32卡或64卡的产品,华为公布的Atlas 950最大配置则覆盖160个机柜。
看超节点不能只盯着“多少卡”。至少要分清三个数字:单个机柜装多少卡,一个超节点连接多少卡,以及整个集群总共有多少卡。这三个数字,分别关系到部署密度、紧密互联的规模和整体建设规模。
首先来看机柜形态和数量。
按照单柜集成数量,业内的超节点大致形成了三个梯队。32卡、64卡是较常见的基础配置。其中,华为Atlas 950、沐曦曦景S600,以及百度天池、新华三的相关方案,都采用了单个计算柜64卡的设计。
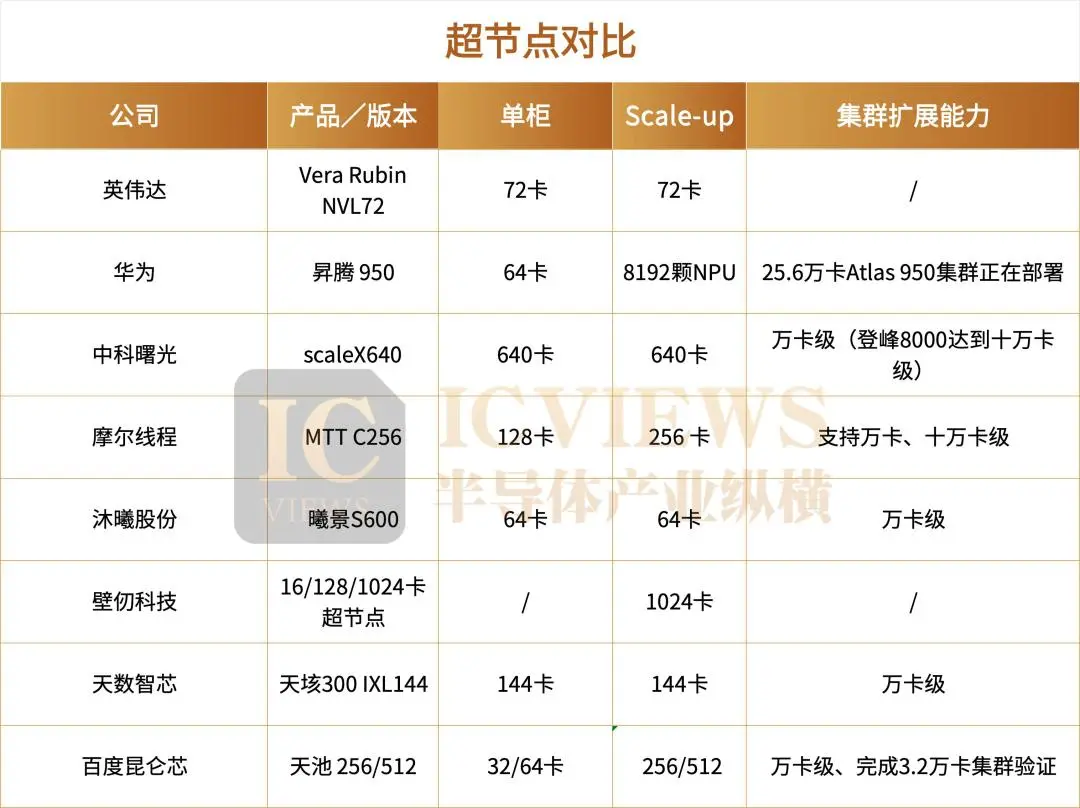
再往上,是将单柜集成数量提高到百卡以上的方案。摩尔线程在2026年WAIC展示的MTT C256,采用单柜128卡配置;天数智芯展示的IXL144,则强调将144颗GPU集成到单机柜中。
在这里比较特别的是中科曙光scaleX640,采用“一拖二”高密架构和极度定制化的刀片模块(将加速卡、内存、互联芯片集成至30cm×20cm×5cm的空间内),在1.8米标准机柜内容纳80个刀片模块,硬生生将单柜密度推高至惊人的640卡。
再来看密度背后的互联。卡装得越多,数据往来就越繁忙。在大模型训练和MoE负载中,芯片之间的通信已经成为系统设计的重点。
讨论互联时,可以分成三个层面:采用什么协议,硬件怎样连接,以及信号通过铜还是光传输。
在协议层面,华为通过灵衢互联体系组织计算资源,百度围绕自研XPU-Link和可编程交换技术构建通信域,壁仞则布局BLink超节点互连协议。行业中也有UALink这样的开放加速器互联标准。比如,新华三UniPoD系列,就同时包含基于以太协议和PCIe协议的产品,其中F80000采用PCIe光互联。
在硬件连接层面,业内在讨论正交直连、Cable Tray等设计。比如,沐曦曦景S600强调柜内连接的“三零”设计,通过减少传统线缆连接,改善部署与维护;百度则在天池方案中,将XPU-Link协议、交换技术与Cable Tray铜缆互连一起设计。
值得关注的是光连接选手。
壁仞推出的1024卡方案采用NPO近封装光学与分布式解耦架构,将GPU节点和交换节点分开部署,通过光连接组织资源,支持单个超节点最高1024卡Scale-up扩展。华为的光模块的应用也很领先,此前384卡配置400G光模块,当前1024卡升级为800G GPU光模块,速率提升一倍、用量减少。
第三看迁移成本,也就是软件生态。对已经积累了大量CUDA应用的客户来说,更换计算平台涉及的不只是采购。
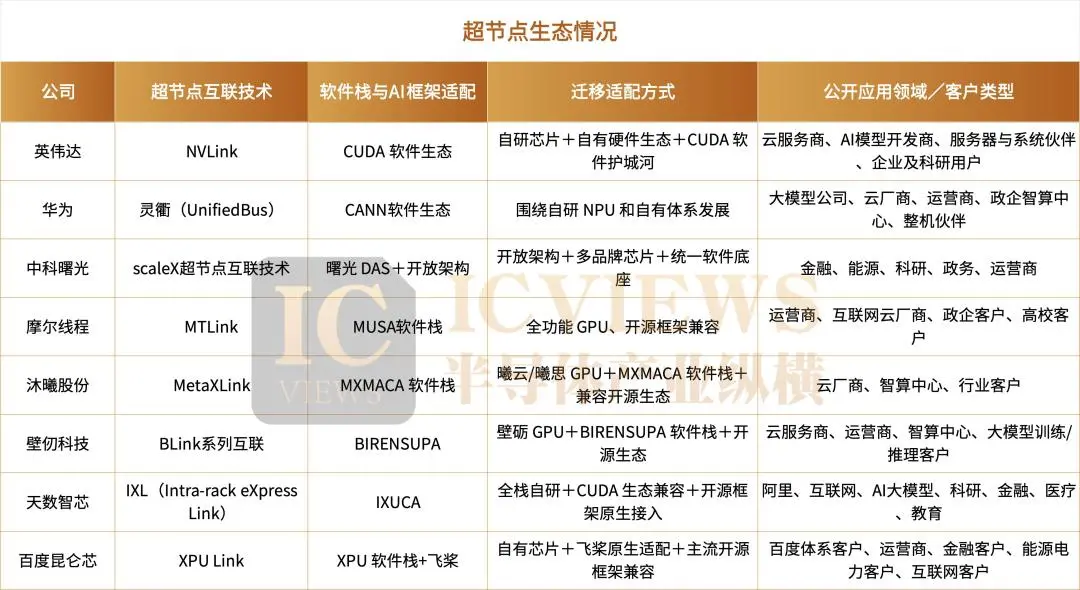
各家国产芯片都有自己的软件底座:华为有CANN,摩尔线程有MUSA,沐曦有MXMACA,昆仑芯和天数也分别建立了配套的软件栈。在框架层的迁移上,客户继续使用PyTorch等熟悉的框架,底层则切换到新的硬件平台。华为通过TorchNPU将PyTorch接入昇腾,昆仑芯与飞桨进行适配,其他厂商也通过框架支持,让模型开发延续原有方式。
在应用中直接用CUDA接口和自定义内核的部分,摩尔线程的MUSA提供了两种具体做法:musify将CUDA源码转换为MUSA代码,MUSA Mapping则在编译过程中完成映射,让支持范围内的源码保留CUDA写法,再编译成面向摩尔线程GPU的程序。昆仑芯也在XPU Runtime中提供CUDA兼容接口。中科曙光则主打开放包容,兼容主流生态并支持多品牌国产卡混合部署。
最后来看,这些超节点正在进入哪些场景。从实际需求看,超节点目前主要沿着三类场景推进:大模型训练与推理、公共智算基础设施,以及科学计算等行业应用。
大模型是最直接的推动力。模型规模扩大、训练任务增加,让互联网企业较早产生了大规模紧密互连的需求。作为第一代正式商用的超节点,昇腾384超节点已商用落地750多套,规模应用于互联网、运营商、金融、教育、医疗、交通、制造等行业,也是国内唯一训练出SOTA模型的超节点。
百度超节点有百度自身核心业务的验证,已经实现了量产交付,是国内率先实现量产交付的超节点产品之一。
中科曙光国家超算互联网核心节点在郑州上线试运行。据悉,该节点算力资源由3套曙光scaleX万卡超集群系统提供支撑,可对外提供超3万卡的国产AI算力。
与此同时,国产GPU厂商的集群业务也在推进。摩尔线程MTT C256 目前处于“商用准备就绪、早期客户验证”阶段;但摩尔线程的夸娥智算集群已在多地交付,摩尔线程披露一笔6.6亿元夸娥智算集群合同,已在上半年完成交付并确认收入。同时,无锡惠山智算中心一期部署2000 张 S5000,两个月后基本满载,已有 20 多家客户测试或正式使用。
壁仞目前成功交付了包括2048卡光互连光交换GPU超节点在内的多个千卡级智算集群。此前推出了“光跃LightSphere X”的超节点方案,在半年内快速实现了128卡商用版的落地。
天数智芯天垓系列GPU已经实现万卡级规模化落地,服务超过380家政企、科研与产业客户,落地部署超过1000个项目。
各家的产品形态和商业化进度不尽相同,但这些案例已经把一个问题摆到了台前:当计算设备开始以整柜、多柜乃至万卡集群的规模组织起来,承载它们的机房,也需要相应的建设和交付能力。
计算、网络、供电和冷却需要一起考虑。预制化提供的办法,就是把能够提前完成的集成与验证工作放进工厂,让现场少一些逐项安装和协调。
03 数据中心,早就开始预制了
早在2006年,Sun就发布过Project Blackbox,将计算、存储、网络,以及配套供电和冷却设施装进标准集装箱,主打运输方便、快速部署。
当年的发布现场,就已经展示了接入外部电力、冷却水和网络后投入运行的思路。
换句话说,“机房装箱,运到即接”的思路,快到可以参加二十周年同学会了。把预制说成AI时代横空出世的新发明,多少有点替老技术补办出生证明。
如今,AI需求让这条老路线有了更大的用武之地。从供电、制冷等机电模块,到集装箱式机房,再到围绕特定计算平台进行整套集成,各家正在把预制推进到不同层级。
先来看已经开展规模化交付的模块化数据中心。以中集集团为例,公司在2026年3月30日的投资者关系活动记录中披露,其在中东、东南亚等地区累计交付的模块化数据中心规模超过1000MW、模块超过17000个;同时,正在为超过300MW的行业客户提供预制化数据中心的技术与制造交付服务。
中国速度的秘诀在于“双厂协同”与全流程一体化交付:90%以上的结构施工、机电安装和内部装修在国内工厂完成,现场只需像搭积木一样进行拼接。
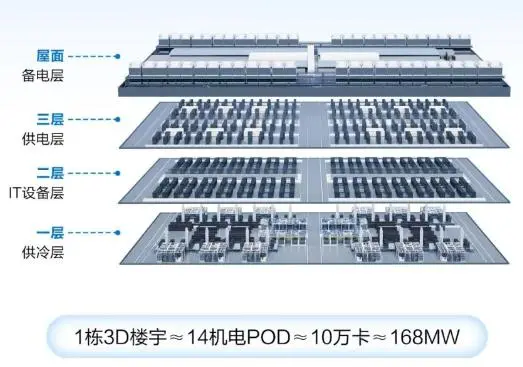
国内华为3D数据中心,借鉴芯片工厂“动力层”与“IT层”严格分离的理念,通过分层解耦、立体堆叠,将传统水平部署的各个功能空间垂直叠加,形成“一层供冷、二层IT设备、三层供电、屋面备电”的垂直架构,实现垂直供电,垂直制冷,链路最短,损耗最小,支撑AI算力集群高密部署,同时为算力演进预留空间。
在建设模式上,华为将供电、制冷等核心机电系统做成标准化POD(可独立运行的最小数据中心单元),在工厂完成预制、组装和测试,现场主要进行装配和连接。其大小机电预制化率超过90%,机电交付时间由约6个月缩短至3个月。
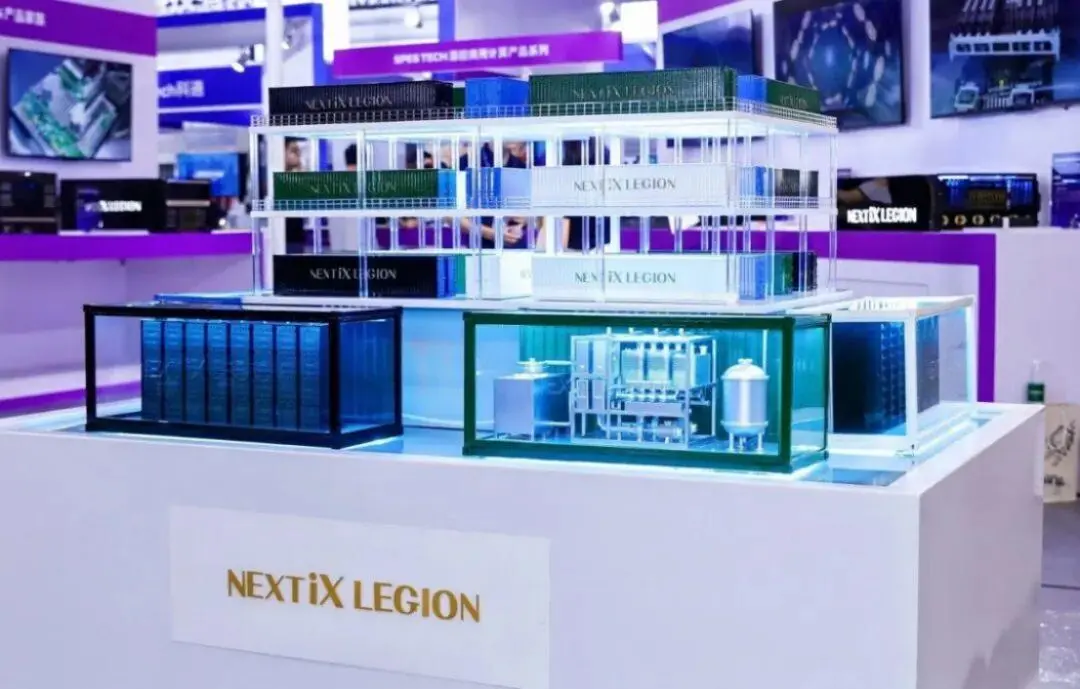
立讯智算推出的是集装箱式预制数据中心方案。数据中心被拆分为一个个集装箱大小的标准模块,供电、散热、算力、组网、存储等都在工厂里提前集成、调试完毕,运到现场像搭积木一样拼接起来,接上电即可使用。一座方舱,就是一座开机即用的数据中心。
其中,能源模块将变配电与储能融为一体,负责稳定供电;液冷模块通过冷却液分配单元(CDU)与冷板管路,让冷却液直达芯片、带走热量;算力模块由成排的 GPU 整机柜组成,上电即有算力;组网模块基于正交组网(Orthogonal Fabric)将所有整机高速连通;租户模块则可按需配置,支持一池多租。客户需要什么就选配什么,钥匙一交,数据中心即刻上线。
浪潮的方案是预制化方舱数据中心PrefabDC-C1000 系列 AIO 方舱。标准化箱体设计,主流规格涵盖 20 英尺、40 英尺国际标准尺寸,可根据算力需求灵活选型或组合扩展。据了解,已经在日本、沙特、哈萨克斯坦阿拉木图落地建设。
谈回这次的英伟达。DSX POD是把7个Vera Rubin机架连同线缆在工厂内预装成一个集装箱,合作伙伴可以在工厂完成机架间连接、管路安装和功能验证,再将预装模块运输到已经准备好的场地。参与这一方案的合作伙伴包括戴尔、HPE、联想、施耐德电气、维谛等,计划于2027年初开始交付。
按照英伟达提出的部署目标,在外部配套就绪的条件下,DSX POD可以将现场部署时间压缩至最短14天。提前完成的工厂集成与现场基础设施准备相互配合,共同推动AI工厂上线。
04 结语
预制数据中心始终在处理一个问题:怎样减少现场组装和集成的时间。
今天的变化,是需要提前集成的系统更加复杂,计算、网络、供电和冷却之间的配合也更加紧密。设备在工厂里多完成一道工序、多做一次验证,现场就能少一些安装和协调。
数据中心,早就开始预制了。如今这项老技术重新火起来,背后是一个越来越迫切的要求:算力设备在升级,机房的建设和交付也得跟上。
毕竟,GPU可以买新一代,机房总不能还停在上一代的工期里。
本文来自微信公众号“半导体产业纵横”(ID:ICViews),作者:九林,36氪经授权发布。