10月28日,超衍智能发布其首个模型 Apex-35B-V1.0。
这款 35B 模型以 Qwen3.6-35B-A3B 为基础,经过中训练和后训练进一步优化,模型开发过程中融入了大量自有数据集和研究轨迹。在参与评测的同量级模型中,Apex-35B-V1.0 的研…能力处于领先水平,同时保持了出色的通用能力;在部分基准测试中,其表现也可与更大尺寸规模的模型竞争。
模型构建过程中,AI 自主参与了数据构造、实验设计、代码执行、训练结果分析和训练优化等环节。在实际应用中,Apex-35B-V1.0 既能完成 Coding、Agent、问答和深度搜索等常规任务,也能完成计算闭环的研究任务,如AI研究、计算科学、机器人仿真等,是一款兼具通用能力与研究能力的模型。
Apex-35B-V1.0 既是递归自我改进的成果,也将成为继续推动 AI 与科学研究的工具。
01
基准评测
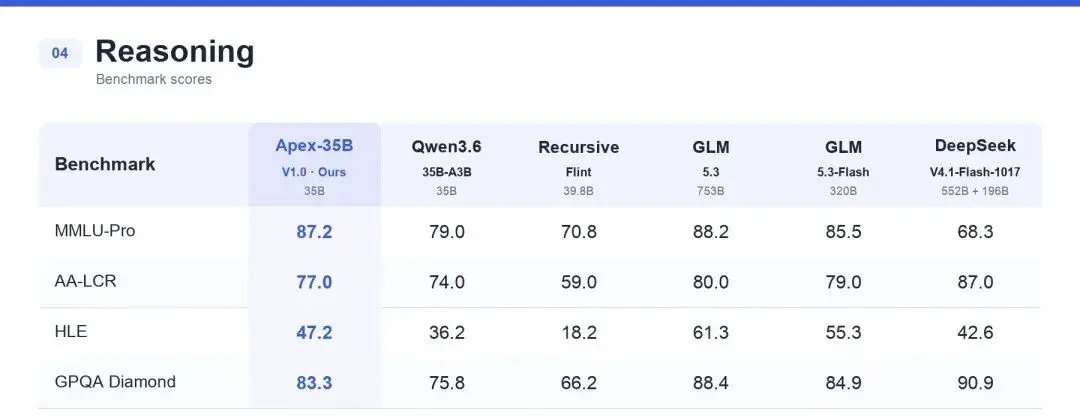
在 21 项基准测试中,Apex-35B-V1.0 相比同量级的 Qwen3.6-35B-A3B 取得 20 项领先;相比 Recursive Flint(40B)取得 18 项领先、1 项持平。除了研究任务表现突出,它在智能体任务、编程和推理方面也展现出广泛的竞争力,并在部分基准测试中超过更大规模的模型。
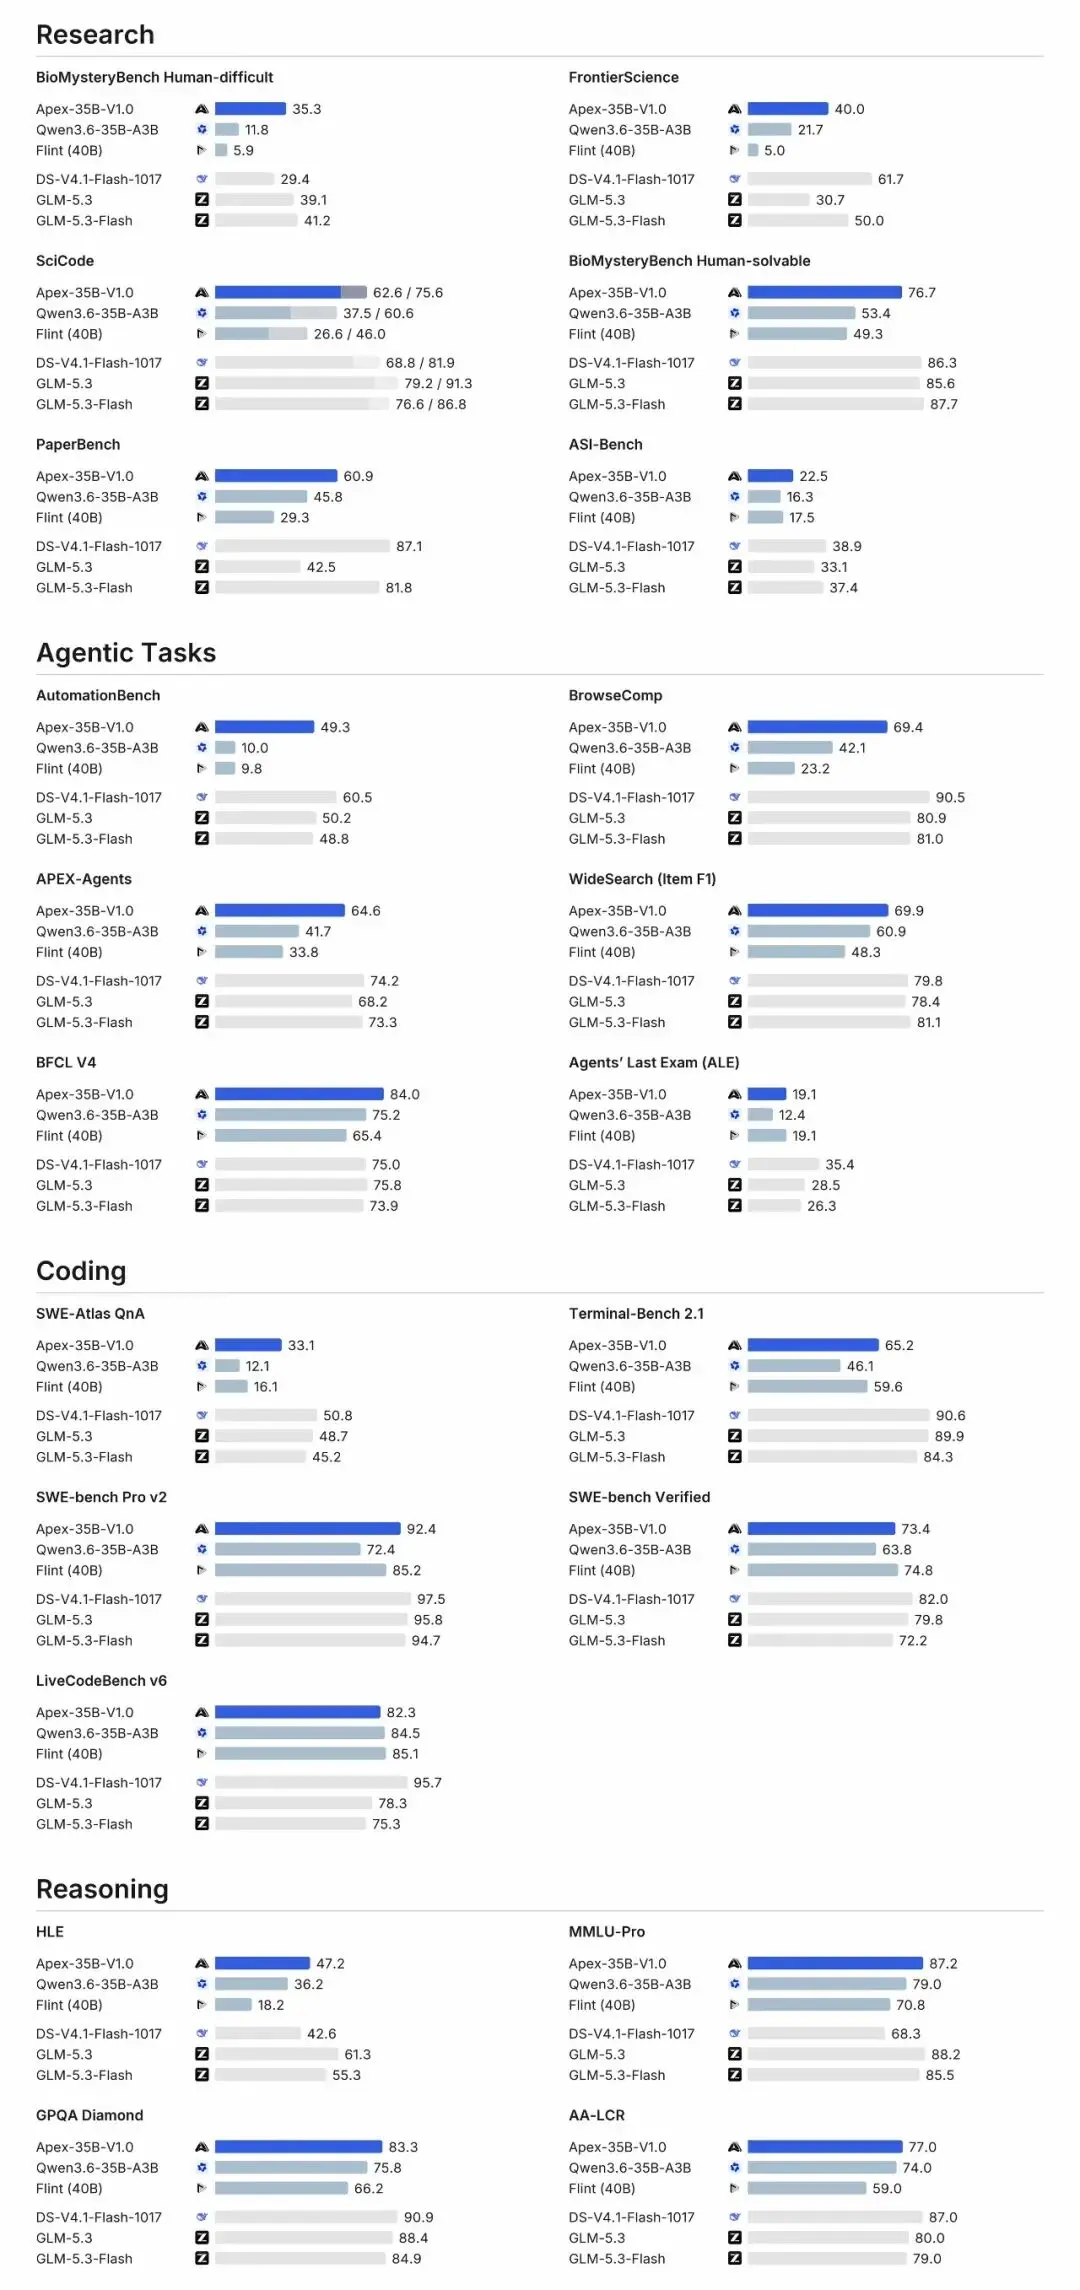
研究能力方面 :
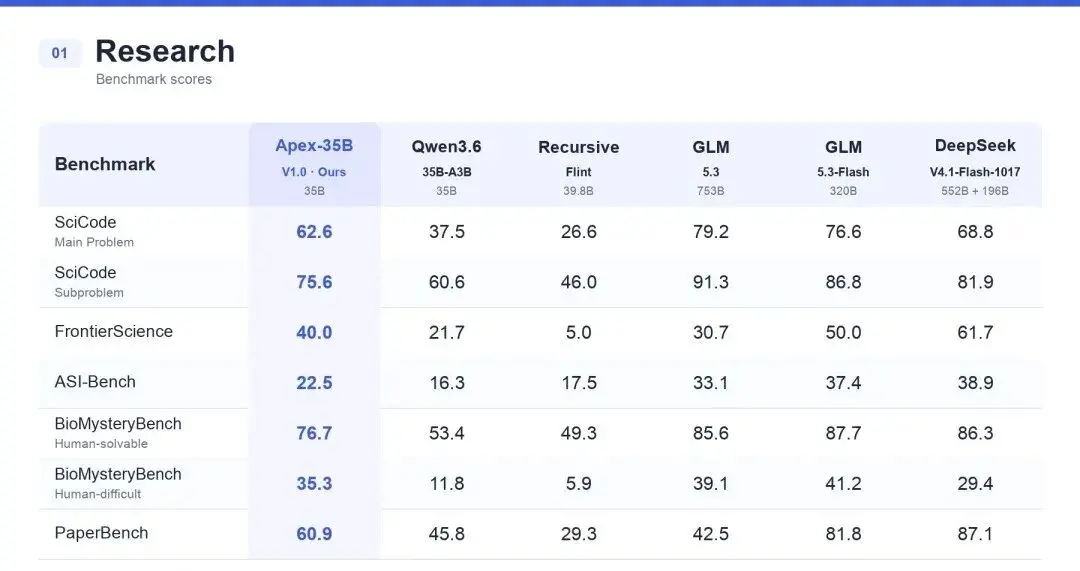
智能体任务方面:
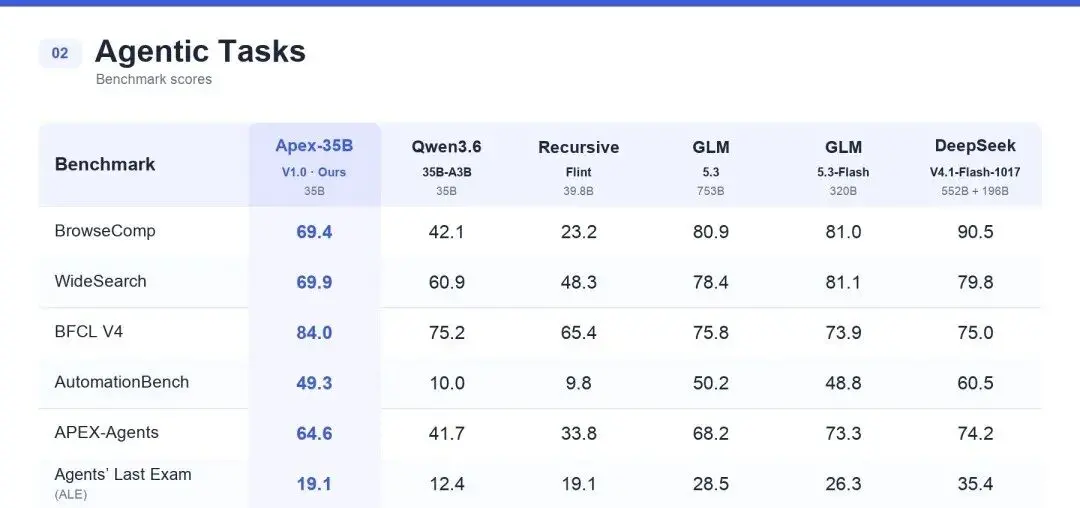
编程能力方面:
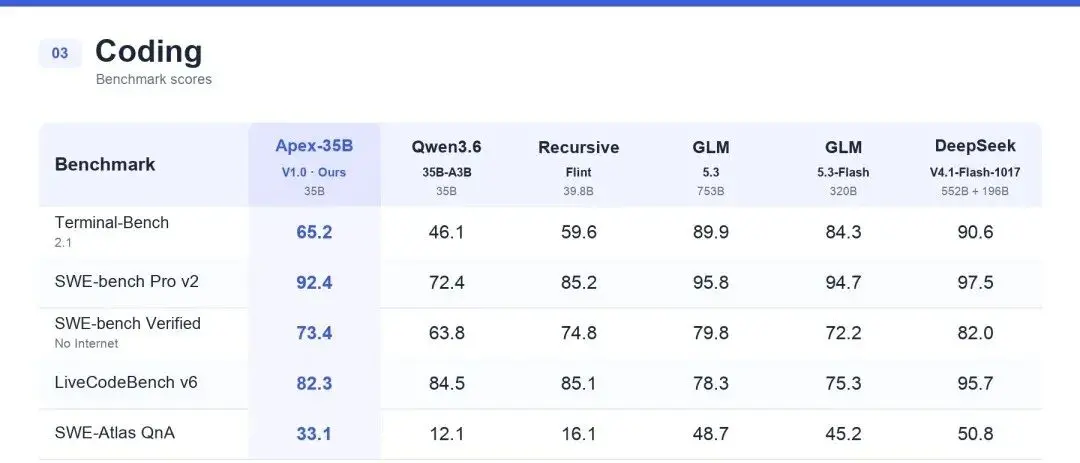
推理能力方面:
02
演示案例
机器人:从任务执行到真实场景的仿真重建
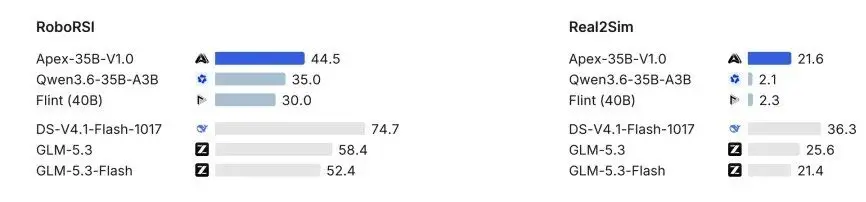
Apex-35B-V1.0 在机器人任务执行、轨迹采集和真实场景仿真重建方面展现出较强能力。在 RoboRSI 和 Real2Sim 基准测试中,我们的 35B 模型分别取得 44.5 分和 21.55 分,显著优于其他参数量低于 50B 的模型,其表现也可与规模大得多的 300B 级模型 GLM-5.3-Flash 相媲美;后者在两项测试中的得分分别为 52.4 分和 21.4 分。
下图将 Apex-35B-V1.0 与 GLM-5.3、GLM-5.3-Flash、DeepSeek-V4.1-Flash-1017、Qwen3.6-35B-A3B 和 Flint 进行了比较。
以下演示展示了两种互为补充的能力:利用代码和视觉反馈完成机器人任务,以及将真实世界的观测结果转化为可执行的物理仿真。
1)RoboRSI:机器人任务执行与轨迹采集
RoboRSI 在 RobotTwin 和 RoboCasa 两个仿真环境中,评估 AI 智能体通过生成代码并根据反馈反复调整来控制机器人的效果。
给定一项机器人任务后,模型会生成控制代码,在仿真器中执行动作,借助视觉反馈观察结果,并在尝试失败时修改方案。该基准测试在固定的时间和计算资源预算内,衡量任务完成情况和轨迹采集效果。
下方视频演示了五项具有代表性的任务:
积木堆叠:将多块积木堆成稳定的结构。
按大小排列:将积木按尺寸从大到小排列。
目标位置放置:将一块 T 形积木移动到指定目标位置。
有干扰物的目标位置放置:避开无关物体,将一块 T 形积木移动到目标位置。
物体操作:将一个红色小球从杯中倒入垃圾桶。
这些示例展示了模型将任务指令转化为可执行的机器人动作、解读视觉反馈并通过反复调整改进执行效果的能力。
2)Real2Sim:从真实世界图像到可执行的仿真环境
Real2Sim 评估模型依据单张真实世界图像重建具备物理模拟能力的仿真环境的能力。
给定一张二维照片后,Apex-35B-V1.0 会识别场景中的物体,选择视觉和物理属性相近的仿真资源,并重建物体之间的空间布局。随后,它会构建基于物理规律的虚拟环境,以便在其中模拟和测试机器人动作及物体间的相互作用。
与仅重建视觉外观的三维重建不同,这项任务旨在创建一个同时近似还原场景外观和物理行为、且能够实际运行的仿真环境,供后续机器人实验使用。
下方六个示例将真实世界的原始照片与 Base 模型和 Apex 模型重建的环境进行了比较。配套动画展示了各仿真场景中的物理相互作用和物体运动过程。
这些示例共同展示了 Apex-35B-V1.0 如何将真实世界感知与基于仿真的机器人实验衔接起来。
计算流体力学
Apex-35B-V1.0 利用仿真反馈优化流体动力学系统,在满足物理和运行约束的同时提升性能。在 CFD-Bench 上,它相对于基础模型取得了 79% 的胜率,战绩为 79 胜、0 平、21 负。
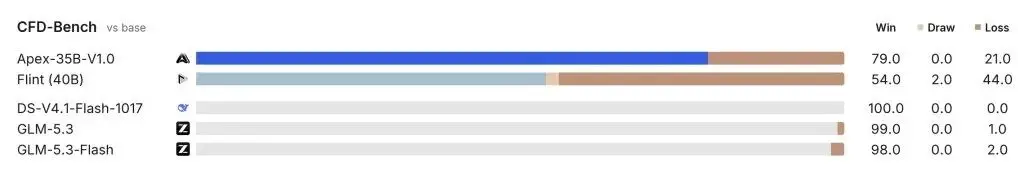
该基准测试以 Qwen3.6-35B-A3B 为共同基线,比较了 Apex-35B-V1.0、GLM-5.3、GLM-5.3-Flash、DeepSeek-V4.1-Flash-1017 和 Flint 的表现。以下演示展示了流体动力学中两种互为补充的优化能力:设计连续运动轨迹以提高推进效率,以及优化相互连通的流体网络中的参数分配。
1)扑翼翼型运动优化
扑翼翼型仿真广泛用于包括水下航行器和仿生机器人在内的推进系统设计。工程师可以借此探索运动策略、评估不同流动条件下的性能,并在制作实体原型前优化设计。
在这项任务中,Apex-35B-V1.0 优化翼型的垂荡(竖直运动)和俯仰(旋转运动),以在不同来流条件下最大化净推力,同时限制驱动成本和运动变化幅度。
运动由 32 个傅里叶系数参数化;这些系数共同决定每个扑翼周期的运动形态和时序。模型根据仿真反馈反复调整系数,从而找到更有效的推进策略。
Apex-35B-V1.0 取得了最高的净推力 0.164,优于 GLM-5.3 的 0.150 和 Qwen3.6-35B-A3B 的 0.081。
2)流体网络参数分配
复杂的流体分配网络是城市供水、油气管道、工业冷却系统和血管循环等许多工程系统的基础。这些网络由相互连通的分支构成;一个出口的阻力、压力或流量发生变化,就可能影响整个系统的运行状态。
优化此类网络,需要协调各处的局部参数,以实现稳定的入口压力、均衡的流量分配,以及在不同工况下的高效运行等整体目标。
在这项任务中,Apex-35B-V1.0 为具有 64 个末端出口的血管网络分配预先给定的阻力和顺应性参数,以匹配目标入口阻抗和血流分布。每组参数都必须恰好使用一次,而一个出口的参数变化会影响整个网络的流动,因此这是一项具有挑战性的全局优化任务。
Apex-35B-V1.0 取得了最低的失配值 1.24×10⁻⁵,优于 GLM-5.3 的 1.41×10⁻⁵ 和 Qwen3.6-35B-A3B 的 1.68×10⁻³。
AI For AI
Apex-35B-V1.0 运用其研究与工程能力改进其他 AI 系统。通过自动化实验、训练优化和反馈迭代,它制定有效的训练策略,并将研究发现转化为可衡量的模型性能提升。
1)训练模型解决推箱子问题
在 AI4AI-Bench 的 ragen_sokoban_grpo 任务中,Apex-35B-V1.0 训练 Qwen2.5-3B-Instruct 模型解决需要长期空间规划与推理的推箱子谜题。任务分为两个阶段:先用 4 小时探索训练策略,再用 12 小时重新训练模型;最终在 512 个未见过的关卡上评估性能。
在探索阶段,Apex-35B-V1.0 遵循了系统的研究流程:理解问题、设计实验、分析结果并完善训练方案。在其 207 次命令执行和代码编辑中,我们识别出 36 项高质量的研究与工程操作,其中包括 15 项决定最终训练策略的关键决策。相比之下,基础模型跳过了参考资料和基线评估,实验安排缺乏条理,未能形成有效的训练方案。
Apex-35B-V1.0 在 512 个未见过的关卡上取得了 24.4% 的成功率,是基础模型 11.7% 成功率的两倍多。
2)用强化学习改进图像生成
在AI4AI-Bench 的 ddpo_sd15_aesthetic 任务中,Apex-35B-V1.0 使用 DDPO 和 LoRA 微调 Stable Diffusion 1.5,目标是提高由固定美学奖励模型衡量的图像质量。该任务采用相同的两阶段流程:4 小时探索,随后 12 小时重新训练。
在探索阶段,Apex 找到了两项关键改进:
1.降低计算成本。Apex 检查评估流程后发现,基准测试使用的是 20 步去噪,而非默认的 50 步。它测试了 20 步配置,观察到两种配置的美学得分相近(5.499 对 5.487),而单次试验耗时从 1,040 秒降至 551 秒。
2.提高训练时间利用率。Apex 发现,固定且偏低的训练轮数上限可能使重新训练提前结束。它将上限提高至 1,000 轮,引入按时间停止的机制,并实现完整的检查点保存,使模型得以在规定预算内完成 409 轮训练。
通过这些优化,平均美学得分从 5.397 提高至 6.638,增幅为 23%。
03
通过递归自我改进构建
超衍智能的自进化AI研究系统 Apex Research能够持续识别模型弱点、提出假设、开展实验,并将研究发现转化为可衡量的模型改进。
从自进化训练数据和自动化实验,到训练方案、GPU 内核及推理优化,Apex Research 参与了 Apex-35B-V1.0 的整个开发过程。
自进化数据。 Apex Research 识别模型弱点,并自动生成有针对性的训练数据。例如,当评测发现模型在计算流体力学(CFD)任务中出现失误时,系统分析了背后的推理缺口,合成并验证新的科学训练样例,再将其纳入后续训练。这套自进化数据流程使模型在内部 CFD-Bench 上的成绩提高了 32.1 分。
自动化实验。 Apex Research 分析评测结果和智能体运行轨迹,发现系统性的失败模式,并优化训练策略。例如,它发现过长的推理上下文和失衡的数据配比会降低智能体表现。随后,系统探索了不同的序列长度分布、长短轨迹采样比例,以及考虑 token 数量的批次组成,找到更有效的训练配置,提高了智能体的可靠性和训练效率。
训练与推理基础设施。 Apex Research 将自动化优化扩展到底层计算系统,探索更高效的 GPU 内核、负载均衡、通信策略和执行调度。在训练侧,它优化 GPU 负载均衡、通信与计算重叠、动态批处理,以及考虑 token 数量的工作负载分配,以减少同步开销、缩短 GPU 空闲时间、提高硬件利用率,使训练吞吐量提升 45%–60%。在推理侧,它优化注意力内核、KV 缓存管理,以及预填充和解码阶段的执行方式;在可比工作负载下,实现解码速度提升至 1.6–1.8 倍,首 token 响应时间降低 30%–35%。
这些改进贯穿数据、训练和基础设施,并逐步累积为一个持续反馈的研究循环:每一轮研究的成果,都为下一轮改进提供基础。
04
未来:迈向下一代自进化基础大模型
超衍智能由清华大学人工智能学院助理教授陈勇超创立,目标是构建下一代自进化基础大模型。这里的“自进化”指递归自我改进(Recursive Self-Improvement,RSI):让 AI 参与研究、实验与验证,并将成果用于改进模型自身。我们希望推动 AI 从辅助工具成为共同研究者,从加速已知走向发现未知。我们的长期愿景是让模型具备相当于并逐步超过10 万名覆盖不同学科的顶尖 AI Scientist 的整体科研能力,持续参与科学研究与发现。
继 35B 模型之后,超衍智能计划推出更大量级的自进化基础大模型,新模型将继续提升 AI 研发能力,并拓展至芯片、量子计算等科学研究领域。