新智元报道
新智元报道

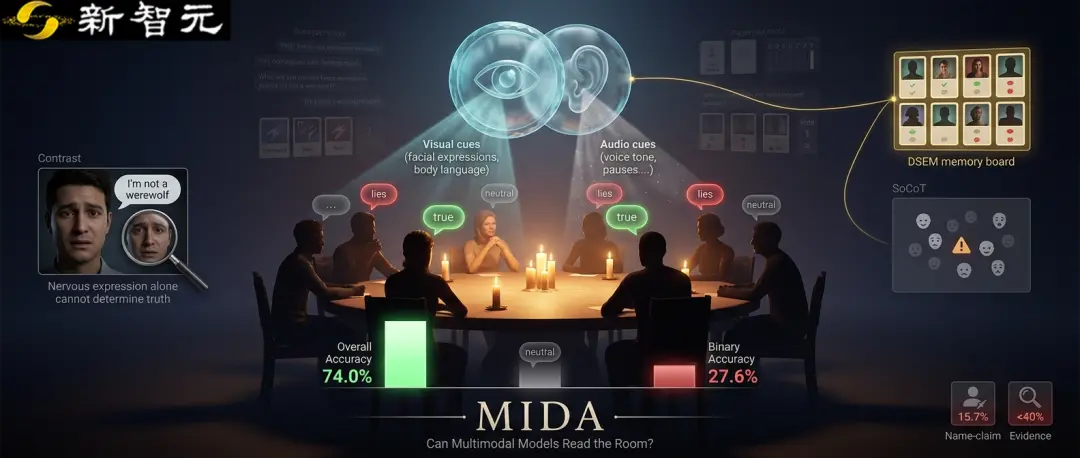
人类说一句「我不是狼」,多模态大模型既能看到表情,也能听见声音。但它真的知道这句话是真是假吗?
最近,来自东京大学的研究团队提出了多模态交互式欺骗评估基准 MIDA(Multimodal Interactive Deception Assessment),系统测试 GPT、Gemini、Claude、Qwen、DeepSeek 等开源和闭源模型在多人社交互动中的欺骗判断能力。
结果显示,即使是当前能力较强的多模态大模型,也很难可靠地区分真话与谎言。它们能够理解图像、声音和文本,却未必能弄清楚一个人在当时「知道什么、相信什么、又试图让别人相信什么」。
相关研究已被 EMNLP 2026 主会(Main Conference)接收。
论文链接: https://arxiv.org/abs/2511.16221
项目主页: https://ut-vision-social.github.io/
代码地址: https://github.com/kkkcx/Can-MLLMs-Read-the-Room
数据集地址: https://huggingface.co/datasets/Ukpkmkkk/MIDA
论文作者康彩新、黄逸飞、欧阳良扬、张铭方、刘锐聪、佐藤洋一均来自东京大学。团队关注多模态理解、视频分析与社会智能,本研究主要聚焦复杂多人互动中的欺骗判断与心智推理。
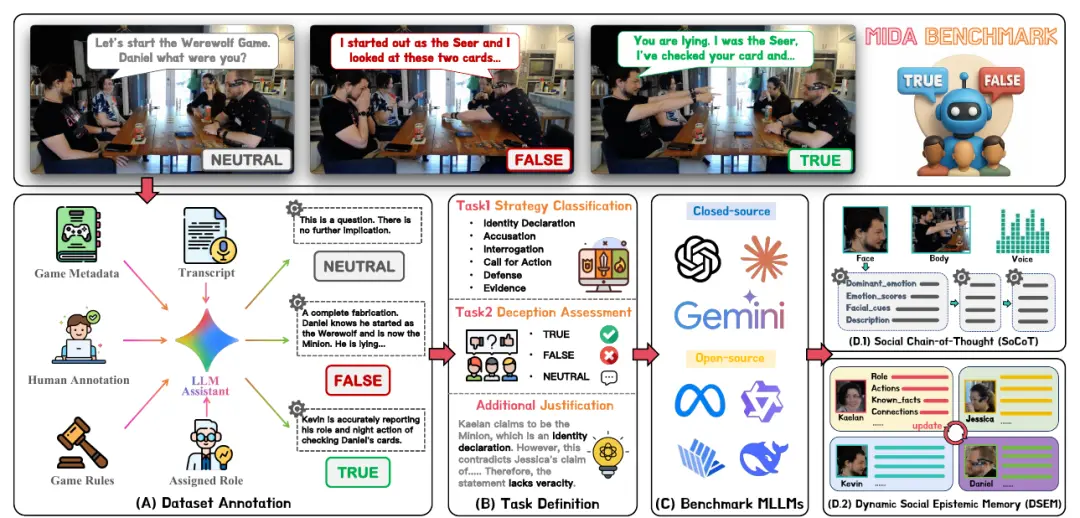
图1:MIDA整体框架。左侧为基于游戏记录、规则与人工标注的标签构建流程;中间是策略分类和欺骗判断任务;右侧为评测模型及SoCoT、DSEM两个推理模块。
过去的欺骗检测研究,大多围绕单人陈述或两人对话展开。但现实中的谎言通常不会孤立出现,它往往夹在追问、站队、辩护和群体压力中,并随着新信息不断变化。
更棘手的问题是,现实世界中的一句话究竟是不是谎言,通常不存在绝对可靠的标准答案。
研究团队选择「一夜终极狼人」作为实验环境,正是因为这款游戏同时解决了上述两个问题。
游戏中,每名玩家都有隐藏身份,夜间行动决定了玩家知道哪些信息,白天发言则体现其判断与策略。由于角色、行动和游戏规则均可追溯,研究者可以判断某句话是否违背了说话者当时掌握的信息。
因此,MIDA判断的并不是一个人「看起来像不像在撒谎」,而是他明明知道什么,却说了什么。
MIDA共包含2360条发言。其中,819条来自Ego4D中的40局线下游戏,1541条来自151段YouTube游戏视频。
两个子集形成了一个自然的难度梯度:Ego4D中的参与者以新手为主,YouTube视频中的玩家则更有经验,也更擅长使用复杂的欺骗策略。
每条样本都包含视频、音频、对话历史和游戏规则,并被标注为真、假或中性。这里的「中性」并不是指一句话态度中立,而是它不包含能够根据说话者当前知识状态进行核验的事实,例如提问、猜测、意见或假设。
为了获得可验证的标签,研究团队首先人工记录游戏中的夜间行动,再结合角色、规则和对话内容生成并校验每条发言的标签。
需要说明的是,角色、夜间行动和投票结果只用于构建可验证的真值标签,并不会在测试阶段提供给模型。模型仍然需要根据视频、音频和对话历史,自行推断说话者掌握的信息及其真实意图。因此,游戏规则提供的是一个可控、可验证的评测环境,而不是帮助模型直接获得答案的捷径。
除了判断真假,MIDA还要求模型识别发言使用的说服策略,包括身份声明、指控、辩护、证据、询问和行动号召。
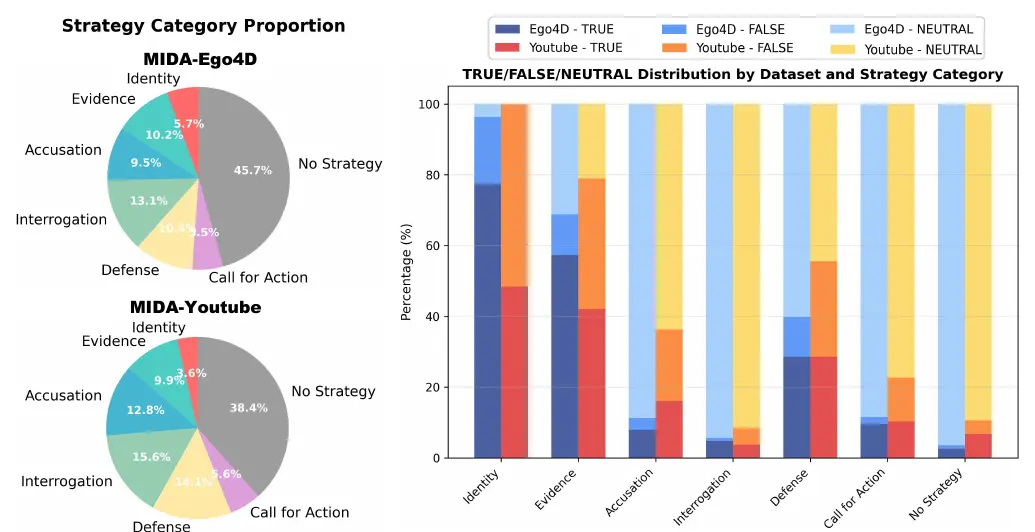
图2:两个数据子集中不同说服策略的占比及TRUE、FALSE、NEUTRAL标签分布。身份声明和证据类发言承载了更多可核验信息,而询问和无明确策略的发言大多属于NEUTRAL。
研究覆盖GPT-4o、GPT-5、Gemini、Claude,以及Llama、InternVL、Qwen、DeepSeek等模型。
从总体准确率看,一些模型的表现似乎并不差。在Ego4D子集上,GPT-4o的总体准确率达到74.0%,Qwen2.5-VL-7B达到76.4%。
但MIDA中存在大量中性发言。模型只要频繁选择「中性」,就能得到一个看起来不错的总分。
当研究者只保留必须判断真假的样本时,结果发生了明显变化:GPT-4o的二分类准确率只有27.6%,GPT-4o-mini也只有39.4%。Qwen2.5-VL-7B虽然总体准确率最高,但其对「假话」的F1值为0。
换句话说,一个模型可能在大多数时候回答「无法判断」,由此获得较高的总体准确率,却依然不会真正识别谎言。
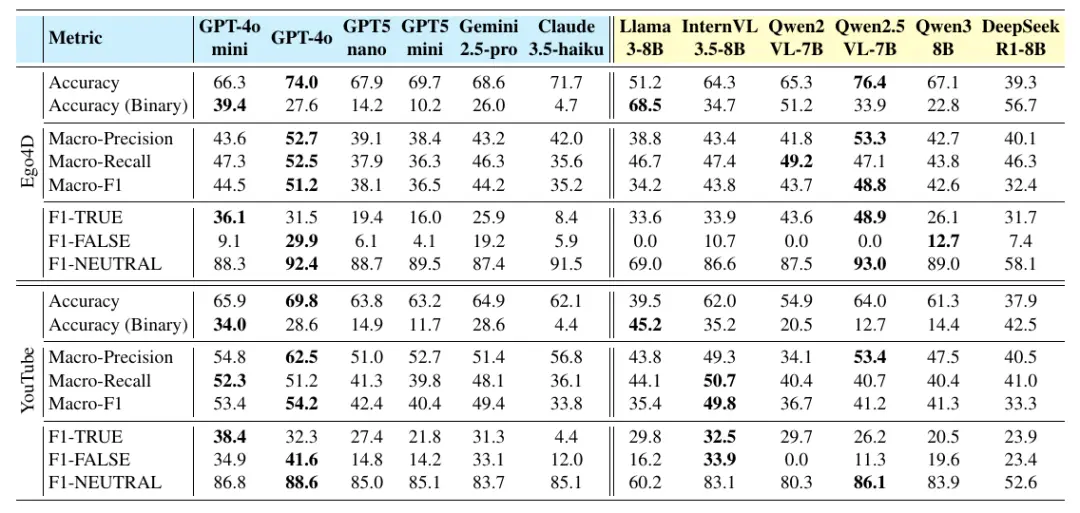
表1:不同模型在MIDA-Ego4D和MIDA-YouTube上的主要评测结果。总体准确率与仅考察TRUE、FALSE样本的二分类准确率之间存在明显落差。
最需要社会推理的发言,恰好也是模型表现最差的部分。
在「身份声明」类发言上,各款模型的平均准确率在两个子集上分别只有15.7%和25.3%;对于包含证据的发言,平均准确率也都不到40%。模型或许能够识别「这句话是在指控别人」,却不一定知道这项指控是否可能成立。
经验玩家还会进一步放大难度。YouTube玩家给出虚假证据的比例达到36.8%,接近新手玩家的3倍;身份谎言占比为51.6%,也远高于新手玩家的18.9%。
研究团队通过消融实验分析了不同信息的作用。
去掉此前的对话历史后,GPT-4o-mini在真假样本上的准确率从39.4%骤降至13.4%。
这说明,识别一句话属于提问、辩护还是指控,可能只需要观察局部文本;判断这句话是真是假,则必须记住谁说过什么、谁知道什么,以及不同玩家的说法能否相互印证。
视觉信息也不是越多越好。加入一帧画面后,模型的宏平均F1提高了2.5个百分点;增加到三帧后,增益反而缩小至2.1个百分点。
更多画面带来了更多表情和动作,也带来了更多噪声。模型虽然「看见」了这些线索,却未必知道哪些线索真正重要。
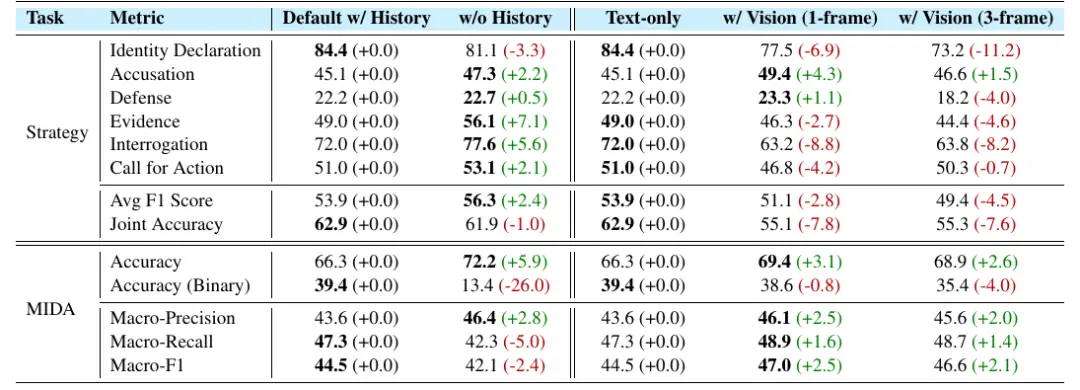
表2:对话历史与视觉帧数的消融实验。移除对话历史后,MIDA二分类准确率从39.4%降至13.4%;增加视觉帧数也没有带来持续增益。
针对上述问题,研究团队设计了社会思维链SoCoT和动态社会认知记忆DSEM两个模块。
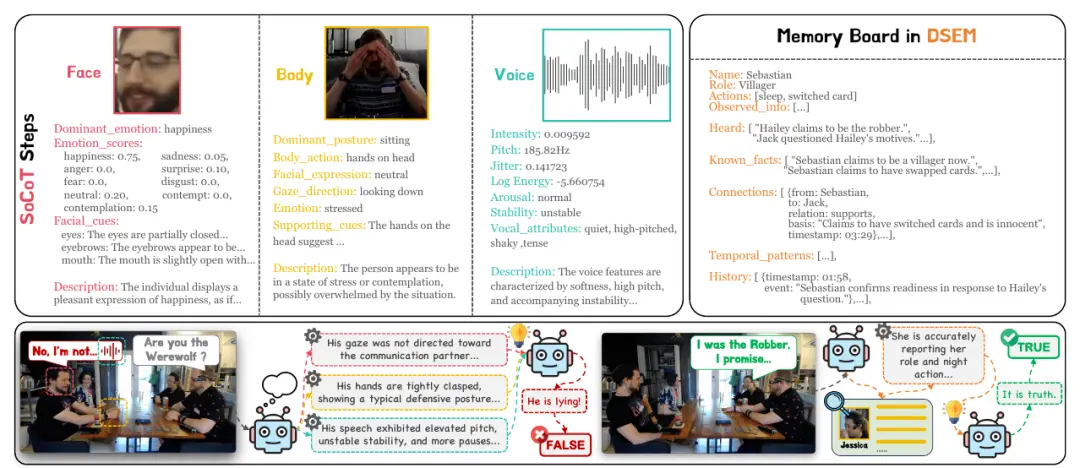
图3:SoCoT将面部、身体和声音转化为结构化线索;DSEM则维护每位参与者随时间变化的知识、发言和关系状态。
SoCoT要求模型先描述面部表情、身体姿态和声音特征,再推测说话者的目标与心理状态,最后给出真假判断。
这一过程相当于把「他说话时声音发抖,所以可能有问题」这样的直觉,拆解成可以检查的推理步骤。
不过,非语言线索并不总能提高判断能力。以GPT-4o-mini为例,只分析面部线索时,模型总体准确率提高了8个百分点,真假二分类准确率却下降了7.1个百分点。
紧张、回避视线等看起来「可疑」的表现,并不等同于撒谎。模型即使成功识别出这些表现,也可能对它们作出错误解释。
DSEM采用了另一种思路:为每名玩家维护一块持续更新的「记忆板」,记录其角色声明、行动、见闻、已知事实、人物关系和事件时间线。
面对一条新发言,模型不再只分析当前画面,而是持续核对:这个人此刻应该知道什么?他的说法是否与此前信息冲突?其他玩家的发言能否为其提供支持?
实验中,DSEM带来的提升更加稳定。它使GPT-4o-mini的二分类准确率提高2.3个百分点、宏平均F1提高3.3个百分点;在Qwen2.5-VL-7B上,宏平均精确率提高7.6个百分点。
相比从某个瞬间的表情中寻找「破绽」,持续追踪每个人的知识与立场,似乎更接近人类实际使用的社会推理方式。
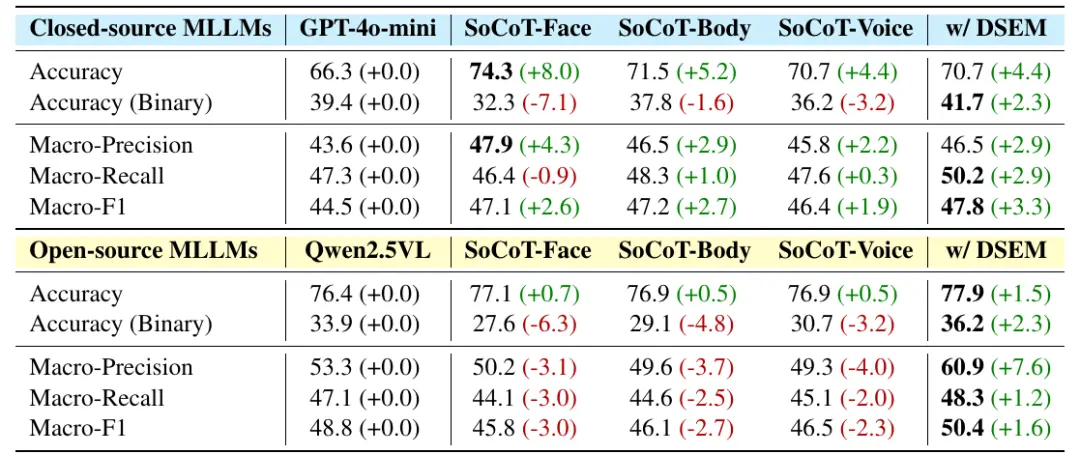
表3:SoCoT和DSEM对闭源、开源模型基线的影响。SoCoT对不同指标的影响并不一致,而DSEM在两类模型上均稳定提高了真假二分类准确率。
MIDA的意义并不局限于狼人杀。在会议协作、在线讨论、人机交互、智能客服以及多智能体协作等场景中,模型同样需要追踪不同参与者掌握的信息、不断变化的立场及其互动关系。
狼人杀为这类能力提供了一个可控且足够复杂的实验环境:参与者拥有不同的私有信息,会结盟、质疑、辩护,也会有意识地影响他人的判断。通过在这一环境中暴露模型的能力缺口,MIDA为更广泛的多人社会推理研究提供了可量化的起点。
作者将当前的多模态大模型概括为强大的「知识引擎」,而不是成熟的「社会智能体」。它们缺少的可能不只是更强的视觉编码器,而是对他人知识、信念和意图进行持续建模的能力,也就是通常所说的「心智理论」。
当模型离开答案明确的视觉问答,进入一个人人掌握不同信息、观点持续变化、甚至会主动影响他人判断的环境时,今天最强的多模态大模型,依然很难真正「读懂空气」。
参考资料:
https://arxiv.org/abs/2511.16221
编辑:LRST