(本文作者为 TechPulse,钛媒体经授权发布)
"国产算力今天跟英伟达比还是差了将近两代,虽然我们在快速追赶。"10月22日,在2026科大讯飞全球1024开发者节大会上,科大讯飞董事长刘庆峰表示。“但国产算力在进步,未来两年我觉得会拉平。”
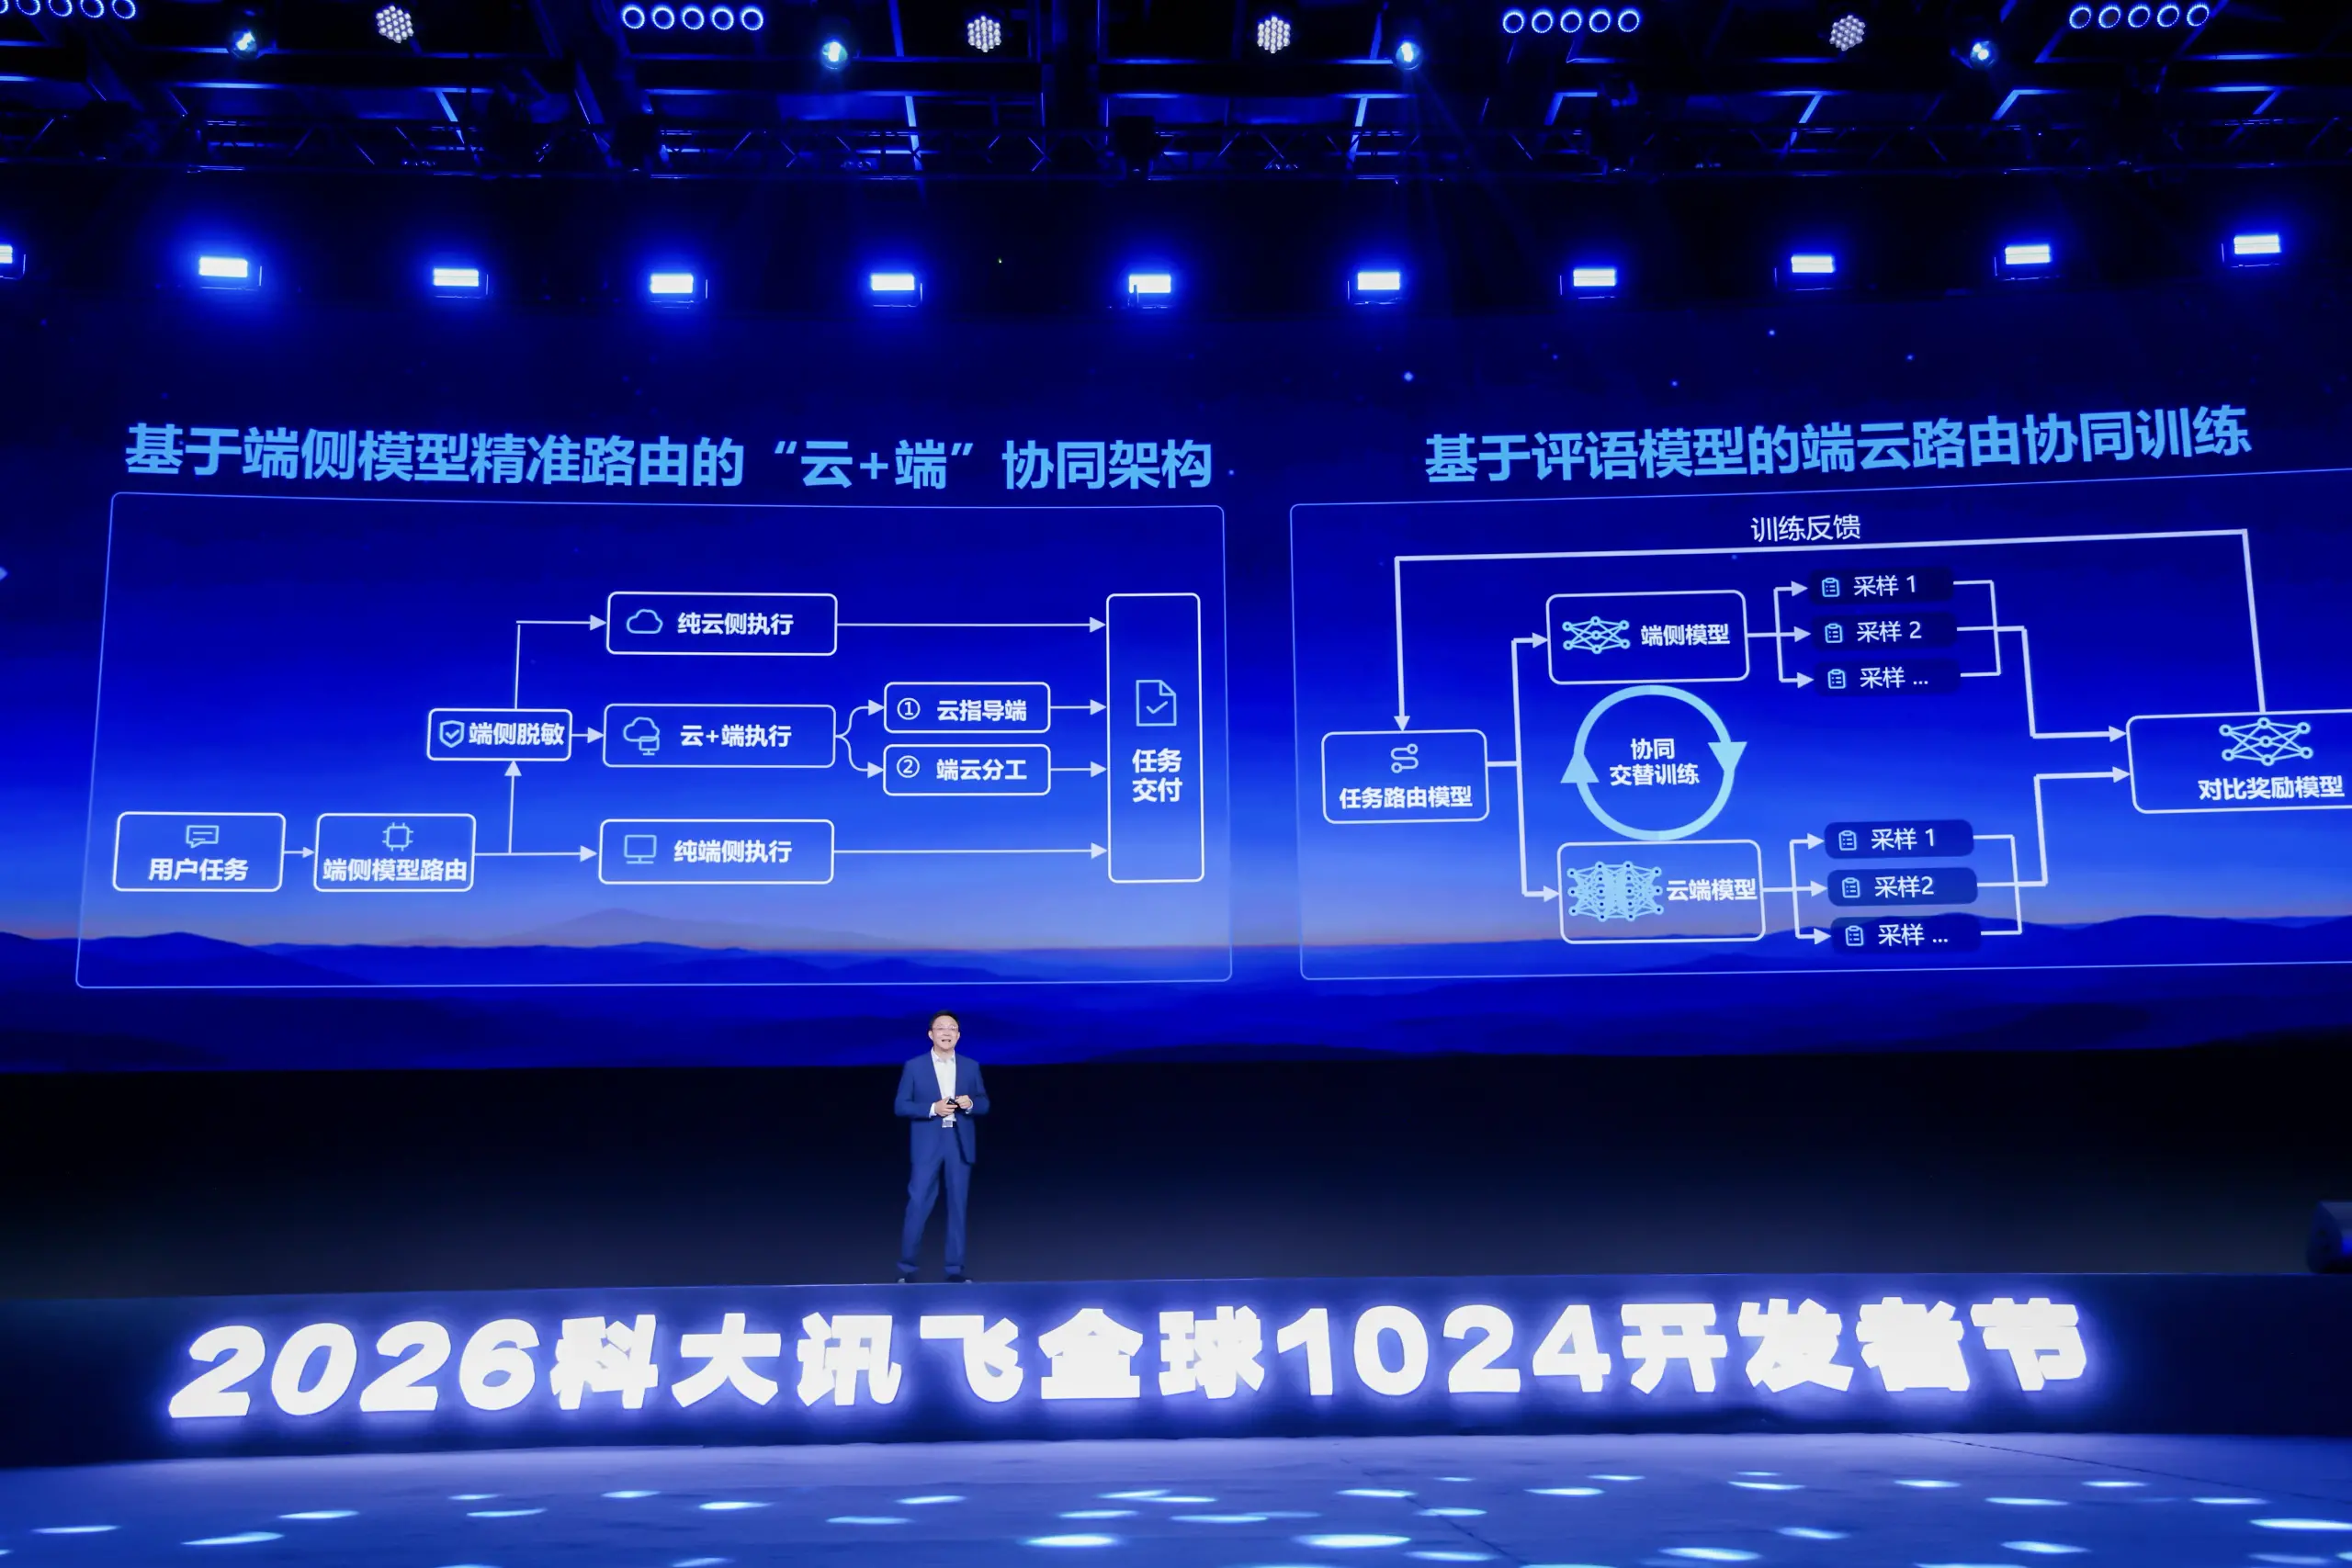
本次大会上,科大讯飞发布了端云一体的讯飞星火X2.6,一个云端大模型配一个4B的端侧模型,按任务难度和数据敏感度决定任务是留在本地、两端协同还是交给云端。
讯飞星火X2.6采用了全国产算力训练,当前国产算力距离英伟达仍有差距,刘庆峰给给出的判断是"将近两代"。差距主要集中在显存和带宽。这一波代码和智能体任务动辄需要一百万上下文,原来的状态被他概括为"装不下、训不动"。
讯飞的解法是长程任务动态并行训练,按任务长度自适应分配算力,超长上下文训练效率提升约4倍;推理侧则基于自适应存算协同,加上首个基于全国产设备的四层KVCache和分布式推理技术,效率提升4.5倍。
端侧模型,先找到突围的路
真正绕开当前算力约束的是端侧模型,刘庆峰表示,"虽然算力我们现在跟美国比有所差距,但是训端侧模型我们算力是够的"。模型变小之后,算力限制被大幅抵消,可以在这个层面上跟海外同台竞技。
端侧能接多少活,取决于复杂智能体任务的完成率。
据介绍,此前业内端侧模型在这类智能体任务上的完成率只有百分之十二点几,讯飞的4B模型把它推到了41.9%,下一步的目标是60%。手机、PC、AI眼镜、智能座舱、机器人都算端侧,支撑这套分工的是路由,讯飞给出的端云路由准确率数据是96.1%。
现场演示了两个场景。一个是"机器人创业公司CEO"的经营复盘,模型在本地关联周报、采购通知和项目邮件,识别出重复跟进同一客户的问题,资料不出端。另一个是采购合同审核,敏感信息先在本地脱敏、经用户确认后再发送,本地原始文件不上传。
这套打法对应着一个明确的取舍,用端云一体化解决大模型既安全又省Token成本的落地问题。刘庆峰也强调,"因为国产算力本身现在也有限,所以我们定位是云端结合端,云端模型我们也不会做太大的"。
与此同时,端云一体这套架构里,云端的角色不只是兜底。
刘庆峰表示,如果要训端侧模型,没有云端模型的能力就训不好,端侧做的事达不达标,需要用云端大模型判断;端的能力边界在哪,需要用云端标定,讯飞这次做的是云端联合统一训练。
在他看来,只做端侧模型的厂商,没有云端大模型的基本能力,指导不了端,也不知道哪些任务该留端、哪些必须上云,大概率不具备竞争优势。
呼吁更多厂商用国产算力训练大模型
除了端云一体讯飞星火X2.6之外,科大讯飞本次还发布了星火语音基座大模型SparkAudio 1.0、星火具身多模交互技术及相关产品,以及讯飞星帆WinWork数字员工平台和科大讯飞AIPC系列产品,并面向智能硬件和企业应用等领域开发者发布新的技术解决方案
刘庆峰表示,"我们并不希望讯飞是唯一一个在国产算力上做训练的,我们大声疾呼就希望有更多的人进来。"
"现在只有华为跟我们是比较主力在做。"他解释说,英伟达上的算法创新开源出来各家都能直接用,算子、代码拿来就能跑;国产算力上架构不同,很多坑没人踩过,在国产算力上的模型摸高问题,十家一起搞和一家单独搞,分摊的成本差一个量级。
"如果大家都用国产算力,我还怕个啥?"刘庆峰说到,"我们是小米加步枪,人家至少已经飞机大炮了"。
对差距收窄的速度,他给出的判断是,未来两年会拉平,国产算力本身在进步,而美国在限制。他还提到了更远的一层,讯飞已经在布局量子计算,如果三五年之内在量子计算跟现在的经典的人工智能的预训练方法能结合,算力的量级问题会被根本改写。
在目前算力的约束下,他给讯飞划了三条定位,在全栈自主可控的平台上对标全球顶尖模型,目标是紧紧跟进;在教育、医疗、能源、安全这些行业做到全球领先;多语言大模型代表中国给全球提供第二选择。(本文首发于钛媒体APP,文 | TechPulse)
更多精彩内容,关注钛媒体微信号(ID:taimeiti),或者下载钛媒体App