AI 实时交互视频,是今年最热的技术方向之一。
过去大半年,相关模型密集破圈。阿里推出 HappyOyster,昆仑万维发布 Matrix-Game 4.0、爱诗科技发布 PixVerse R2,生数科技 7 月推出 Vidu S1,9 月紧接着发布 Vidu S2……
资本同样在跑步入场,多家公司完成新一轮融资,世界模型、数字人、实时编辑…… 各路人马从不同方向涌入。
但火热背后,这个赛道正处于一种混乱状态。
混乱首先来自定义。同样做实时交互视频,有人叫它「交互世界模型」,有人叫「实时交互多模态模型」,有人把它理解为独立于视频生成和世界模型之外的第三条路线。连赛道叫什么都没有共识,评测标准自然更谈不上。
现有评测工具还在沿用老框架,给模型一段提示词,生成一段视频,看画面清不清晰、动作合不合理、风格符不符合描述,VBench、EvalCrafter 等主流基准都是这个逻辑,但对实时交互视频系统来说,这套方法测的根本不是最难的那部分。
实时交互视频的核心挑战在于,用户的指令是连续的,模型需要在不中断生成的前提下及时响应新指令,同时保持人物身份、已有场景和此前所有有效修改不变。而这些,现有评测工具几乎没有触及。
最近,清华大学、NVIDIA、CMU、UC Berkeley、Princeton、NUS 等海内外高校机构联合发起了一个新的评测基准 ——StreamEval。
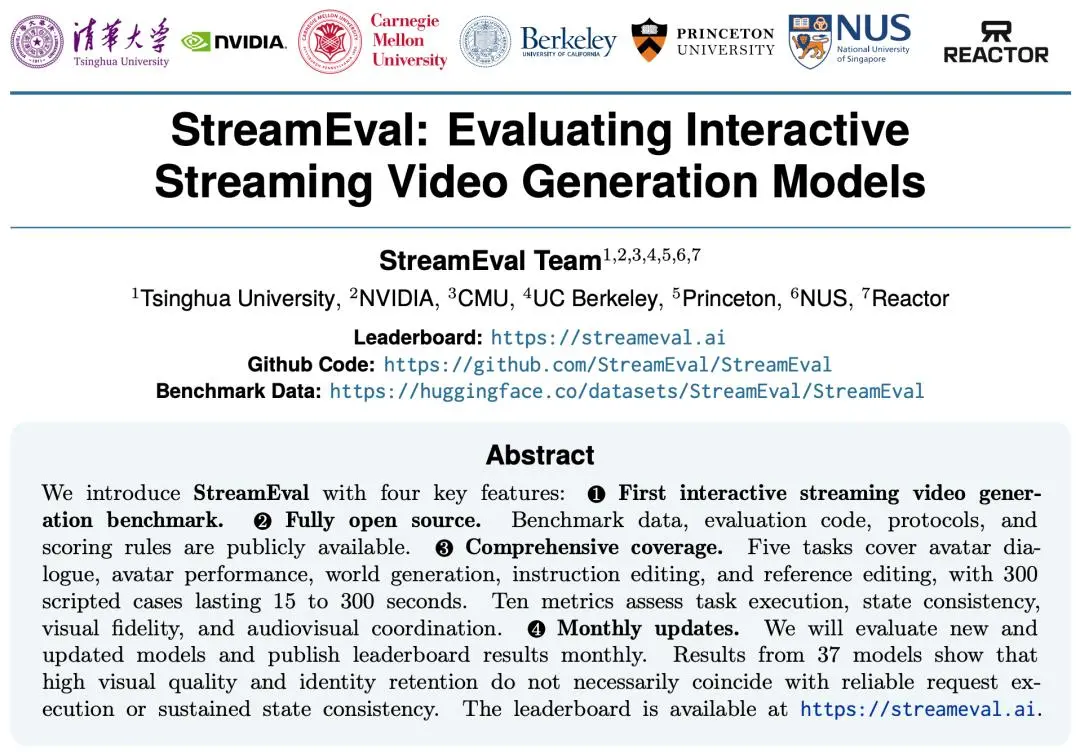
Leaderboard: https://streameval.ai
Paper: https://arxiv.org/pdf/2610.28402
Github Code: https://github.com/StreamEval/StreamEval
Benchmark Data on Huggingface: https://huggingface.co/datasets/StreamEval/StreamEval
Benchmark Data on ModelScope: https://www.modelscope.ai/datasets/StreamEval/StreamEval
这是行业内全球首个流式交互视频生成评测榜单,覆盖数字人对话、虚拟人表演、世界生成、指令编辑和参考编辑五类任务,共 300 个测试用例,涵盖 38 个模型。
与现有基准相比,StreamEval 不只测「生成质量」,更测「交互能力」,把指令执行、状态一致性、视觉质量和音画协调纳入同一套可量化的评测体系,让不同技术路线的模型在统一条件下完成测试。
目前代码、数据集和评分规则全部开源,开发者可以按照公开流程独立复测、核查评分过程。榜单持续更新,任何开发者都可以接入自己的模型参与测试。
StreamEval 具体测什么?怎么测?
评测实时交互系统,必须让它在接近真实的条件下运行,指令分批到达,场景持续演化,模型在时间流动中持续响应。
StreamEval 正是基于这一逻辑设计的,覆盖数字人对话、虚拟人表演、世界生成、指令编辑和参考编辑五类任务,每类包含 60 个测试用例,分别覆盖 15 秒、30 秒、60 秒、120 秒和 300 秒五档时长,测评维度非常全面。每个用例由同一模型独立运行三次,以减少偶然因素对结果的影响。
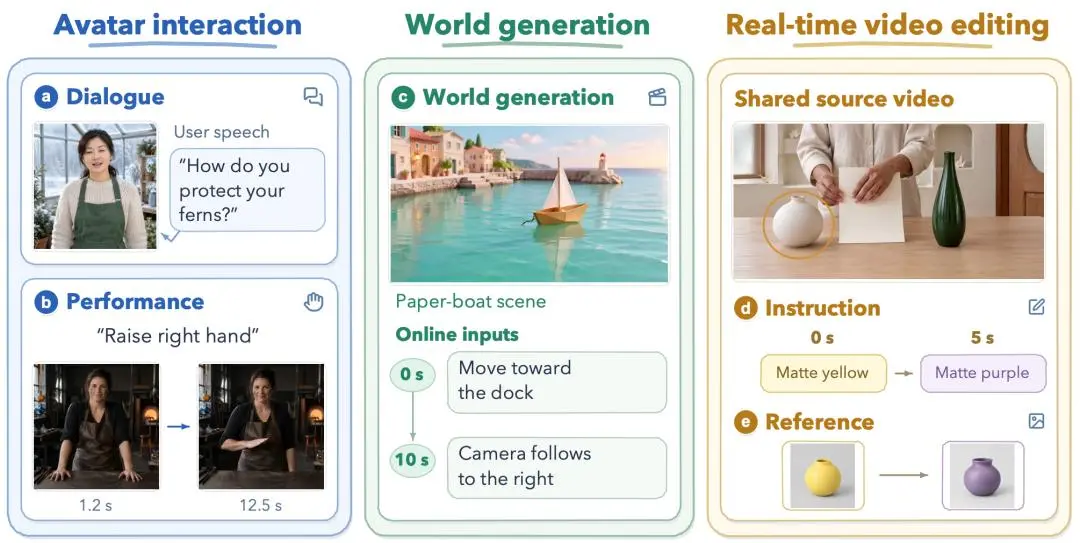
StreamEval 整体框架。该基准涵盖五类任务,涉及数字人交互、世界生成和实时视频编辑。
整套数据包含 1347 个在线事件,语音、文字指令、参考图和源视频帧会按照时间轴逐步释放,模型只能看到当前已经释放的输入,无法提前得知后续要求,也接触不到用于评分的预期答案。
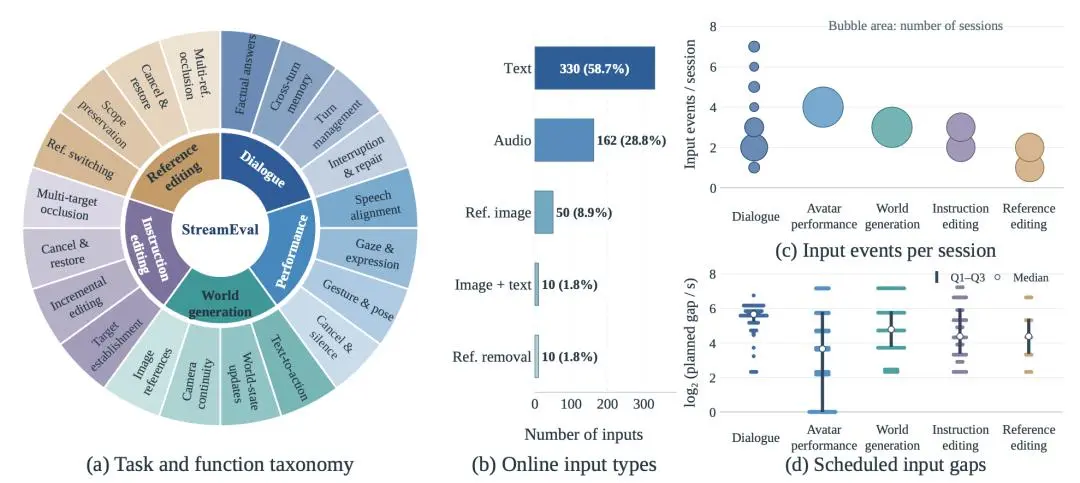
基准数据集的构成。(a)任务与功能分布;(b)预设输入类型;(c)每个测试会话中的输入事件数量;(d)相邻预设输入事件之间的时间间隔。图中展示了 200 个测试用例,共包含 562 个在线输入事件,不包括初始化输入和连续输入的源视频帧。统计输入间隔时,排除了涉及触发事件的事件对。
五类任务各有重点:
数字人对话考察模型能否理解用户语音,给出符合上下文的回应,同时维持人物身份和对话状态;
虚拟人表演要求角色根据实时指令完成视线、表情、姿态和手势等动作;
世界生成关注连续控制下的场景变化、镜头移动和空间连续性;
指令编辑与参考编辑则要求模型在源视频持续播放时,根据文字或参考图完成修改,并保留未被指定的内容。
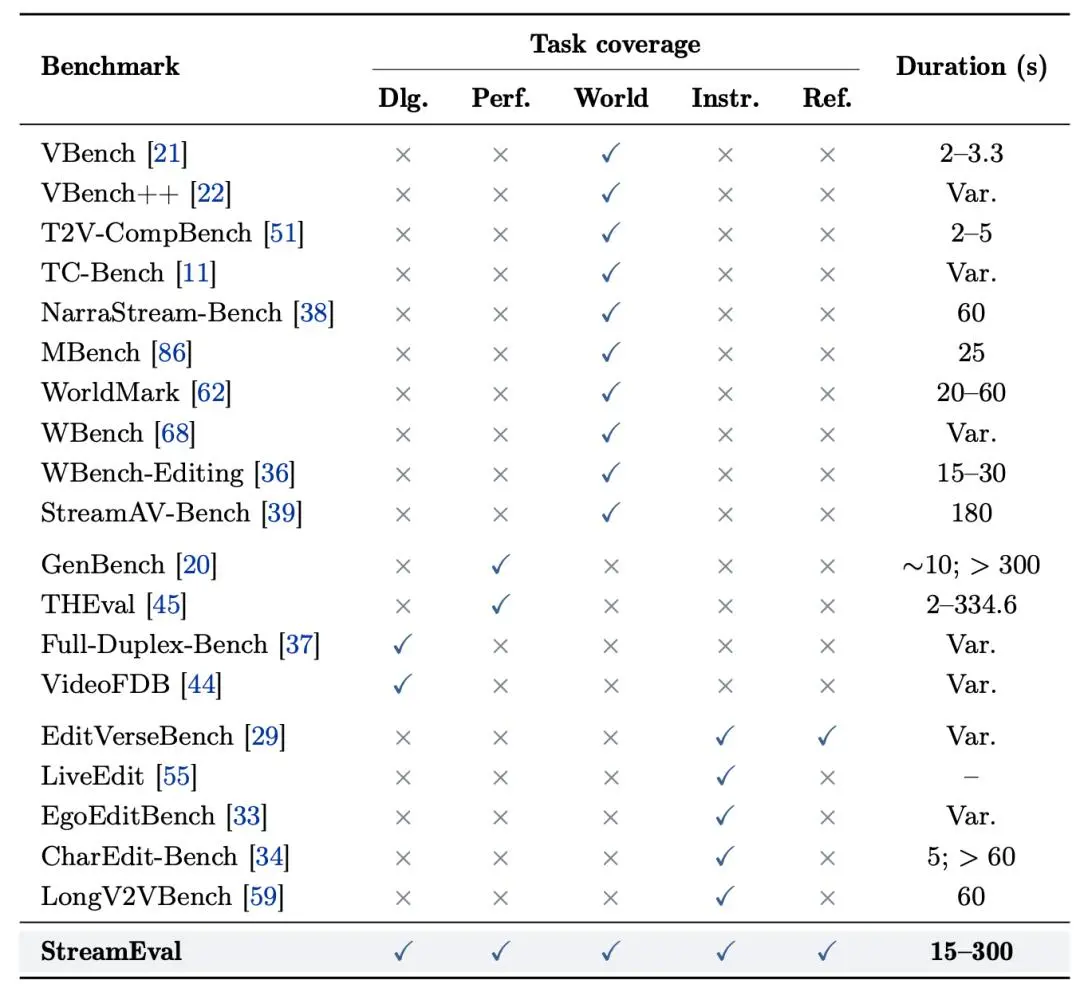
五类任务的覆盖范围与评测时长。Dlg. 表示数字人对话,Perf. 表示虚拟人表演,World 表示世界生成,Instr./Ref. 分别表示基于文本指令和参考图像的实时视频编辑。✓ 表示包含该任务,× 表示不包含该任务。
StreamEval 将表现拆成四个维度、十项指标。
任务执行关注对话表现、指令跟随和完整编辑;状态一致性考察画面稳定性、时间连续性及非目标内容保留;…觉保真度覆盖画质、人物身份和参考图匹配;声画协调主要评价音画同步。
各指标采用 0—100 分。每项任务只计算适用指标,再等权得到任务内综合分。数字人任务还对支持自定义形象的系统额外增加 5 分。五类任务分别排名,不合并成一个跨任务总榜。
38 个模型交卷,连续指令最难拿分
论文共评测 38 个模型,形成 49 个模型任务配置。结果显示,画面质量、人物身份保持和实时控制是几种相对独立的能力,模型能够稳定生成视频,不等于能够可靠执行不断变化的指令。
在数字人对话任务中,Vidu S2-Avatar 的基础综合得分(Q-Overall)为 88.98,加上 5 分自定义形象能力后,综合得分(Overall)达到 93.98,在支持自定义形象的参评模型中取得最高成绩。
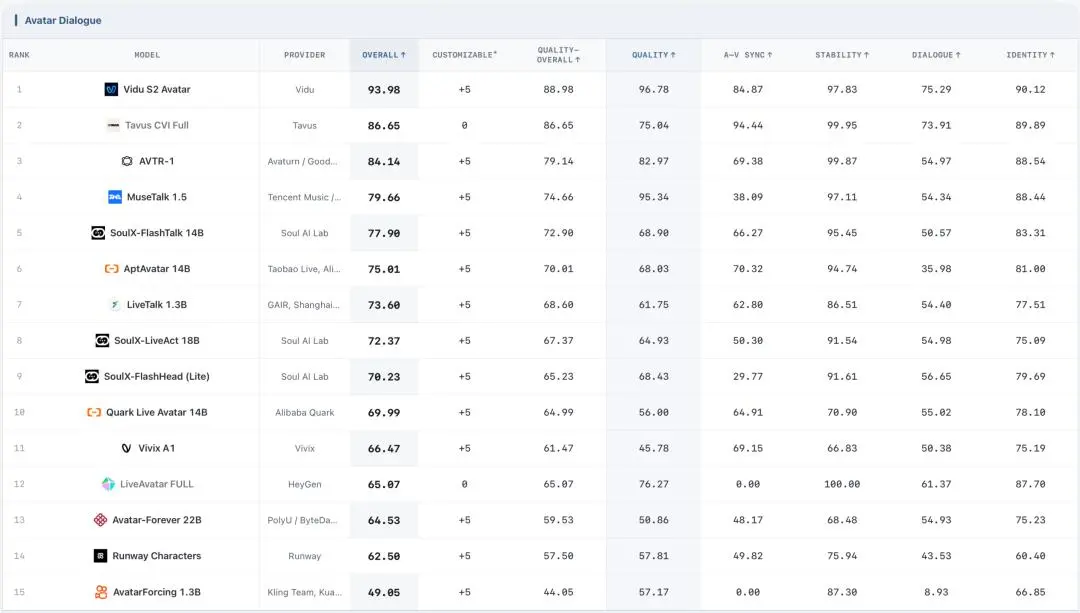
数字人对话任务评测结果。
到了虚拟人表演任务,Vidu S2-Avatar 同样以 81.71 取得最高综合得分,其音画同步、稳定性和身份一致性分别达到 99.60、97.25 和 86.12。不过,它的指令跟随(Following)只有 36.90。这个成绩已经是七个参评模型中的最高值。
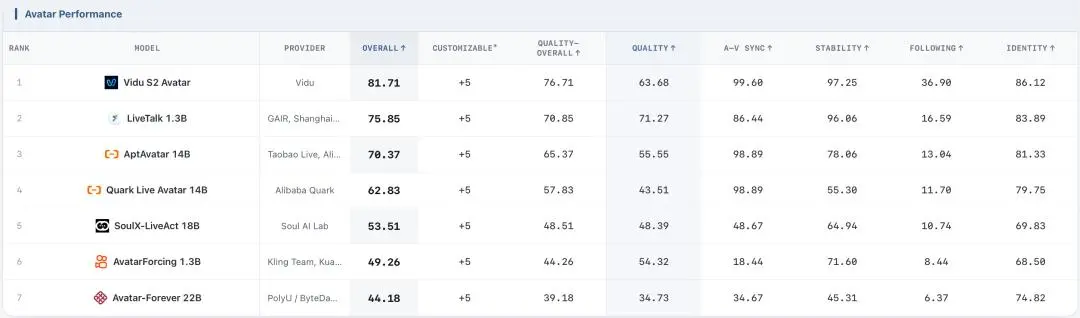
这意味着,角色可以保持稳定,嘴型也能跟上声音,具体动作仍可能没有按要求完成。连续交互对模型提出了更复杂的要求,它既要听懂指令,还要在正确时间让正确对象发生变化。
世界生成也呈现出明显的能力分化。
MemFlow 以 33.36 取得最高综合得分,Krea Realtime 以 25.93 拿到最高指令跟随得分,Matrix-Game 3.5 则以 34.50 取得最高连续性(Continuity)得分。HappyOyster 1.0 Adventure 的画质和稳定性分别达到 58.34 和 56.67,均为该任务最高值,但指令跟随得分仅为 5.56,连续性得分也只有 2.78。
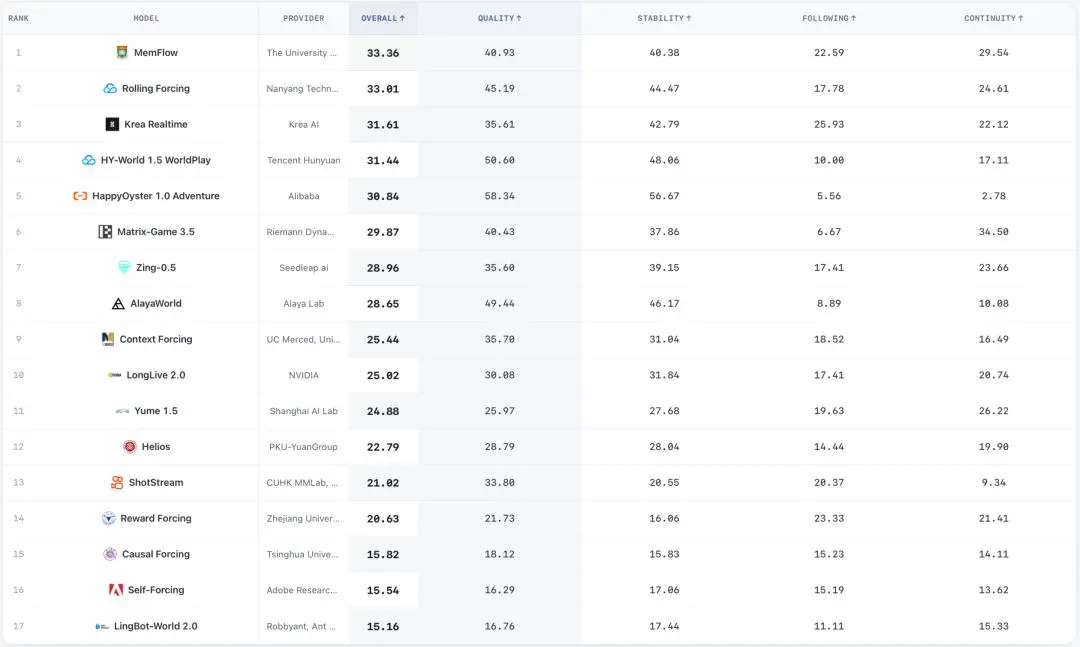
世界生成。文本条件和图像条件下的模型配置统一参与排名;同一模型同时接受两种输入条件评测时,仅报告其文本条件下的评测结果。
这些结果说明,画面观感、指令响应和长时间连续性需要分别判断,某个模型看起来更稳定,不代表它更听指挥。
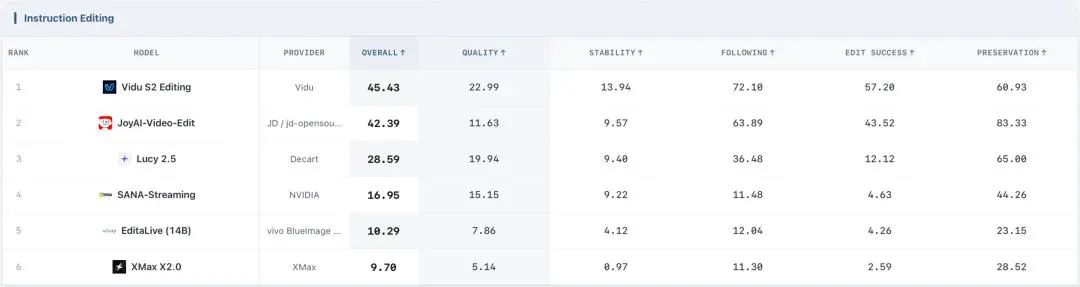
实时编辑部分,Vidu S2-Editing 在指令编辑任务中取得 45.43 的综合得分,指令跟随和编辑成功率(Edit Success)分别为 72.10 和 57.20;JoyAI-Video-Edit 的综合得分为 42.39,但内容保留(Preservation)得分达到 83.33,高于 Vidu S2-Editing 的 60.93。前者在指令执行相关指标上更高,后者更擅长保留源视频中的非目标内容。
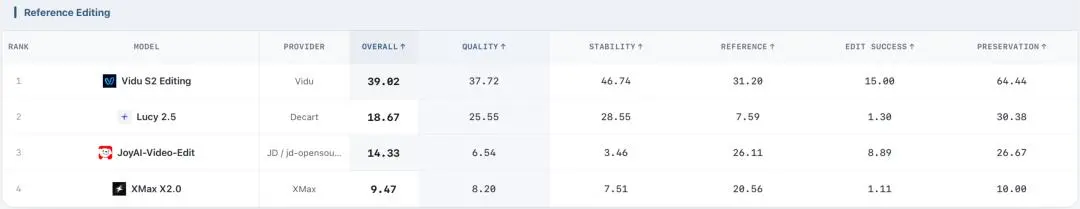
参考编辑的难度更高。Vidu S2-Editing 以 39.02 取得最高 Overall,Preservation 为 64.44,Edit Success 只有 15.00。这个分数已经是论文公开报告的四个参考编辑配置中的最高值。
参考图切换、修改范围控制、已有状态保持和撤销恢复,需要在同一次持续生成中共同完成。模型可能成功改变人物外观,却破坏背景;也可能保留原视频内容,却没有采用新的参考形象。只有全部条件同时满足,才能获得完整编辑分数。
以系统先加载红色天鹅绒披风、第 10 秒切换为金色缎面披风、第 20 秒要求移除编辑为例,模型既要及时换装,还要保持人物动作和背景,最后精确恢复到源视频的原始状态。
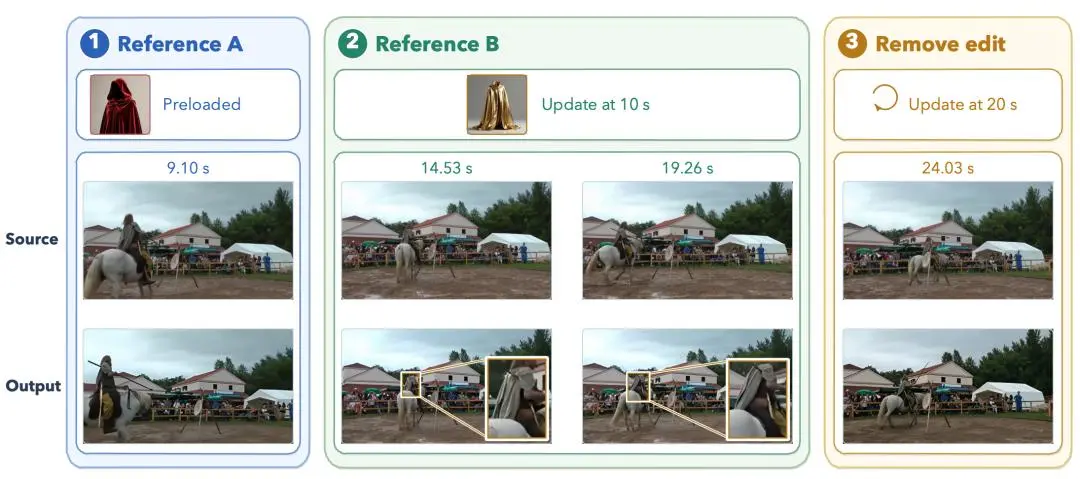
输入变化过程中的参考图编辑。参考图 A 预先加载,参考图 B 于第 10 秒输入,第 20 秒发出移除参考图的指令。各列分别配对展示对应会话时间点的源视频帧与模型输出帧。局部放大图展示了框选的披风区域。结果显示,在参考图 B 生效阶段的两组输出中,披风仍保持灰色,没有按要求变为金色缎面。
因此,StreamEval 呈现出的重点并非谁在所有任务中全面领先。不同模型各有优势,行业共同面对的难题,是如何在持续生成过程中稳定执行连续指令,并正确维护已经建立的状态。
结语
StreamEval 的价值,不只是给模型排个名次。
它的背后,是清华大学、英伟达、CMU、UC Berkeley、Princeton、NUS 等顶尖学术与工业机构。多方研究力量共同参与,决定了它从一开始就是面向整个行业的公共评测框架,服务的是这个领域的共同需求。
更关键的是,它正在为实时交互视频建立一套可复现、可持续演进的评价标准。公开的测试数据与评分规则,让开发者得以精准定位模型的短板,不同技术路线的进展也因此有了清晰可查的依据。在一个连定义都尚未统一的赛道里,能够提供这样一套公开、透明、可验证的基准,本身就是稀缺的。
榜单的含金量,取决于有多少模型参与、评测能否持续更新。StreamEval 计划长期维护榜单,每月持续纳入新模型与最新评测结果。随着更多研究团队和开发者加入,测试记录将不断积累,帮助整个行业更清楚地判断技术走到了哪一步,哪些问题还悬而未决。
StreamEval 参与方式直接,分三步走。
第一步,获取代码和数据。开发者可以通过 GitHub 查看评测流程、模型接入示例和评分规则,并通过公开数据集下载评测所需的媒体文件。项目提供完整的任务定义、测试时间轴和预期结果,支持在统一条件下复现评测。
第二步,接入自己的模型。项目提供明确的模型接口规范,目前支持进程内模型接口和 WebSocket 服务两种接入形式,具体技术要求可参考 GitHub 中的 Add a Model 文档。
第三步,提交模型信息与评测结果。 科研机构、企业模型团队和个人开发者,均可通过 StreamEval 官网(https://streameval.ai)的「Evaluate your model」入口提交模型信息。已按照公开流程在本地完成测试的参与者,也可附上自行评测的结果与技术反馈。结果经审核验证后,将纳入后续榜单发布。
实时交互视频的下一步,需要模型持续突破,也需要一套经得起检验的评价标准。 如果你正在研发数字人、交互式世界或实时视频编辑模型,不妨亲自跑一遍 StreamEval,让自己的模型接受测试,也让更多真实结果进入这份持续更新的榜单,共同为行业的进步添砖加瓦。
GitHub:https://github.com/StreamEval/StreamEval
本文来自微信公众号“机器之心”(ID:almosthuman2014),作者:杨文,36氪经授权发布。