
人通过观摩、尝试和指点学习,机器人也能如此。可可矩阵(COCO Matrix)发布机器人模型 CO01(读作/kuːl/),让机器人也能从这些经验中学习。
一次示范、一段失败经历、一句提醒,甚至一张目标图片,都能帮助 CO01 决定下一步。团队将这种方式称为「经验提示」:经验可直接放入模型上下文,无需为当前任务重新训练。
这让新任务更少依赖专门的示范采集和微调,降低适配与部署成本。用户也能通过示范和指点教机器人做事。失败、重试和人的纠正,既能供机器人当下参考,也能经整理后用于后续训练,让使用中积累的经验持续帮助模型改进。
希望 CO01,成为一个非常 COOL 的机器人模型!真正实现可可矩阵的愿景:Robots for all,shaped by all!
本文看点:
-
新任务上手更快:同一预训练模型下,一段示范、约 1 分钟,未见任务平均成功率达到 52%;微调达到相近水平需约 180 条示范、约 9 小时。
-
失败经验带来可量化提升:在相同的五次尝试机会下,保留自身历史的真机累计成功率为 84%,不保留历史为 56%。
-
扎实的技术支撑: 会话式训练保留示范、失败与纠正之间的联系,让动作模型无需更新权重,就能利用经验调整行为。部署中积累的交互记录还能经整理后用于后续训练,让真实使用持续推动数据飞轮。
-
统一感知能力:同一套权重支持深度、分割、光流、人体姿态等多类感知任务,在 8 项基准中有 5 项优于专用模型,深度估计基本持平,为机器人读懂示范中的空间关系与动作变化提供感知基础。
-
技术博客:Experience is the Prompt: Introducing CO01
-
博客地址:https://www.ccmtrx.com/research/co01
目录
1. 从 In-Context Learning 到经验提示
2. 从不同经验中学习
2.1 示范・2.2 自身尝试・2.3 即时指导・2.4 跨机体技能传递
3. 经验如何成为行动的依据
3.1 System 1 与 System 2・3.2 会话式训练・3.3 统一视觉主干
4. 从即时适应走向持续学习
1. 从 In-Context Learning 到经验提示
过去,教机器人新任务,往往要先由人遥操作,采集大量示范,再微调模型。换一项工作,就可能重走一遍流程。
In-Context Learning(ICL,上下文学习)让模型在不更新权重的情况下,利用上下文适应任务。GPT-3 在语言任务中展示了这一能力,机器人领域也开始探索从示范中学习。CO01 进一步让示范、尝试和即时指导等多种经验参与动作决策。
真实世界的任务难以穷举。CO01 探索的是让新任务能够现场教、执行偏差能够及时改、历史经验能够再次用,为应对泛化挑战、降低部署成本和推动跨场景复制提供技术支撑。
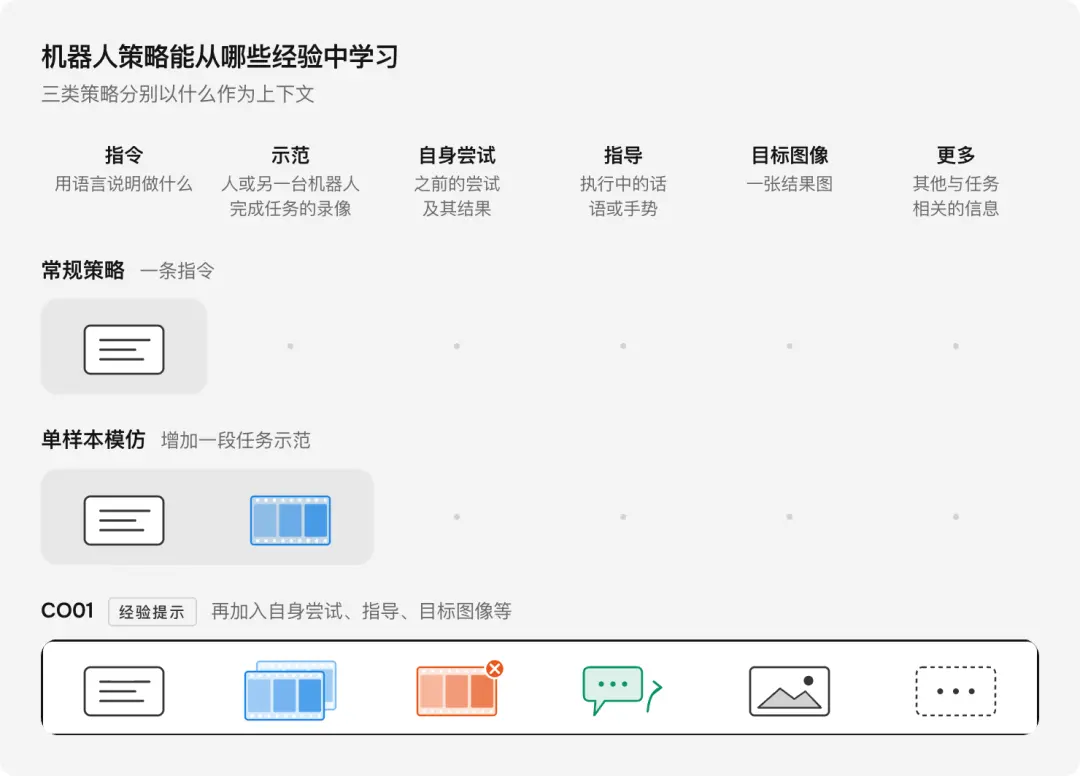
图 1:从任务指令、单次示范,到多种来源的示范、先前尝试、即时指导和目标图像,CO01 扩大了策略模型可以参照的上下文。
2. 从不同经验中学习
2.1 从示范中学习:适应新任务与新场景
CO01 可以从人的第一视角、侧面录像或其他机器人的示范中,理解目标与步骤,找到适合自身机体的做法。插线时,它沿用了示范中的换手步骤,抓取方式和运动路径则适应夹爪。

插线演示:左下角为人的侧面示范,主画面为机器人自主执行,均为 2 倍速。
把人搭积木的录像倒放,就得到一份拆积木的示范。CO01 看过之后,依照倒放的顺序完成拆解。
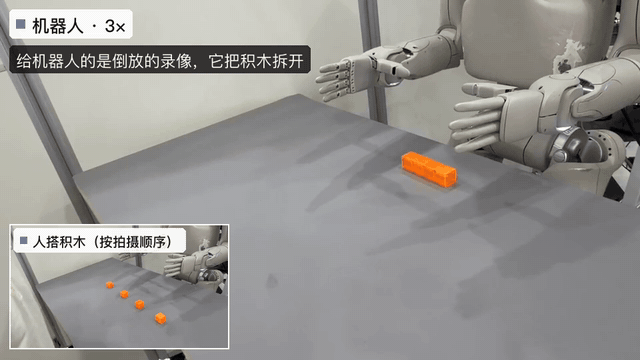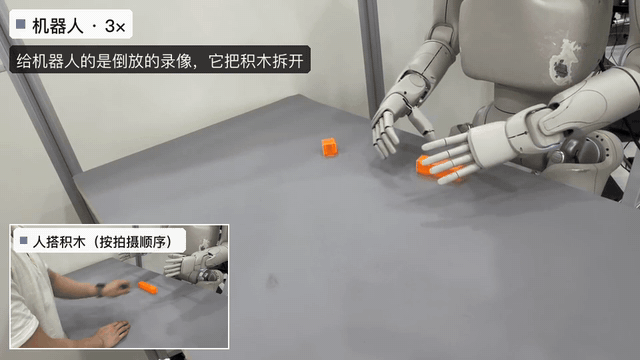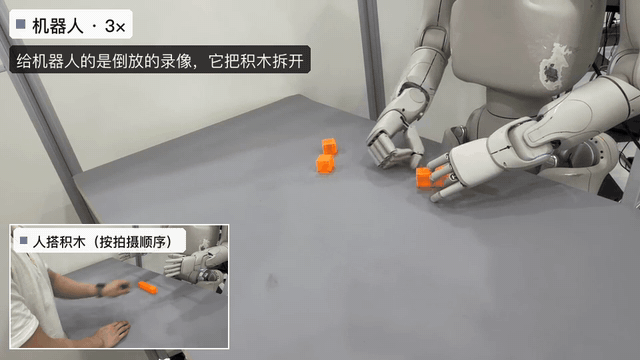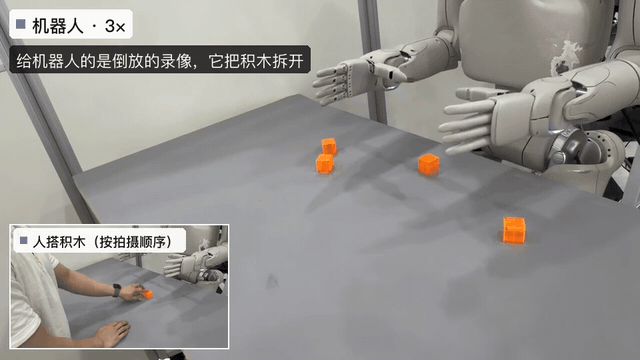
左下角按原顺序播放搭建过程;机器人接收倒放版,自主执行拆解。均为 3 倍速。
示范也能把已有动作组合起来。训练时只练过单次折叠的模型,看人连折两次毛巾后,也依次完成了两次折叠;人逐个指向按钮,它便按顺序按下。

连续折叠:左下角为人的示范,主画面为机器人自主执行,均为 2 倍速。
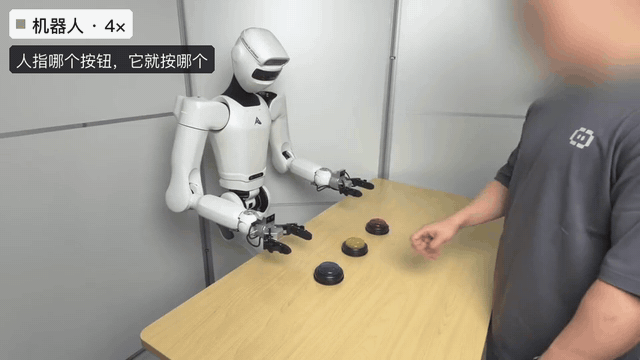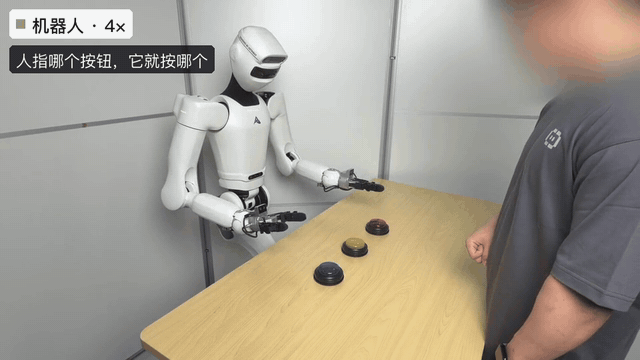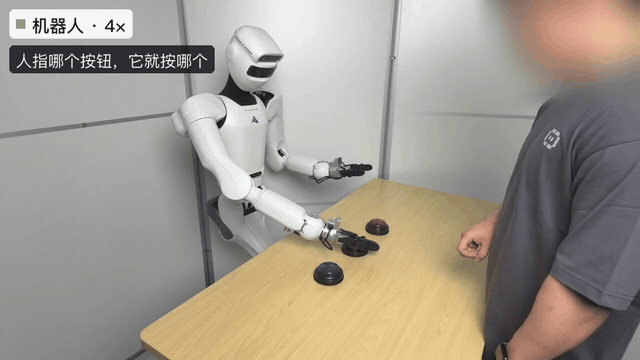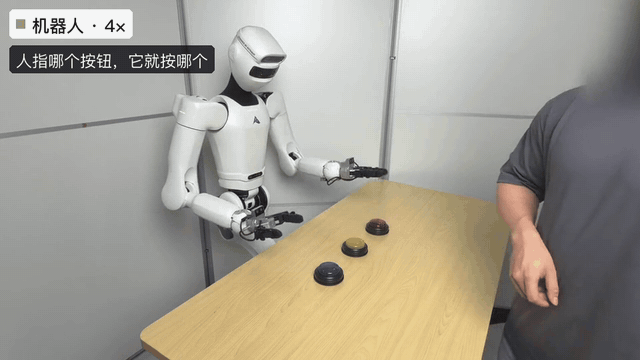
跟随指向按按钮,机器人自主执行,4 倍速。
为检验机器人是否利用了示范,团队保持场景和起始状态不变,只改变毛巾折法或按钮顺序。
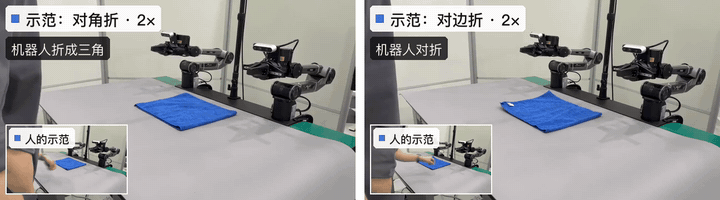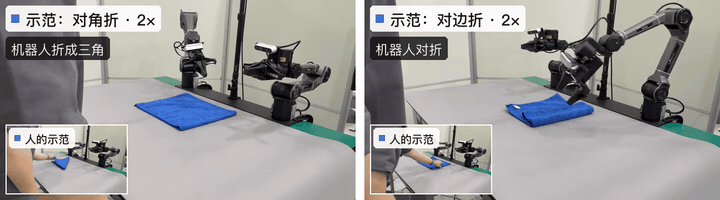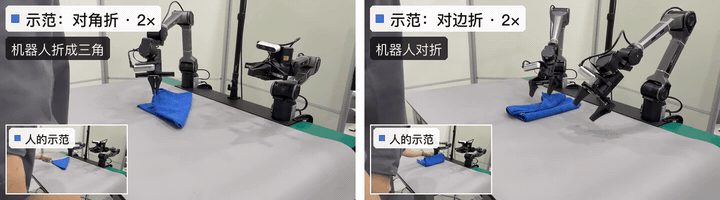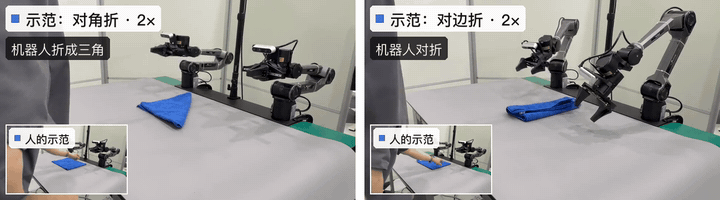
左为对角折,右为对边折;左下角为对应示范,均为 2 倍速。
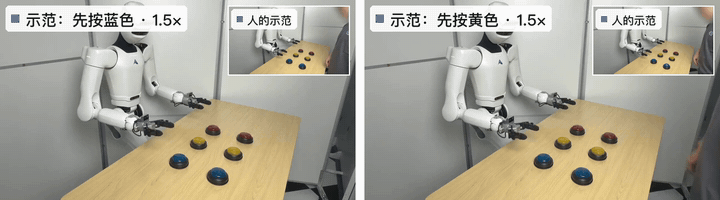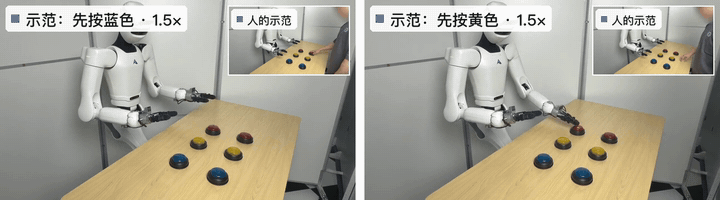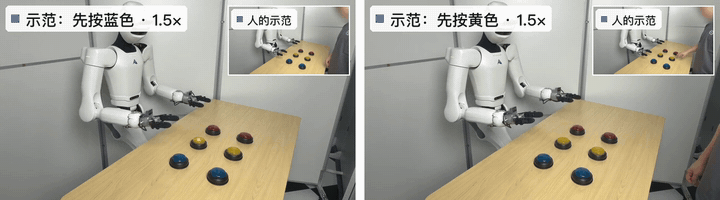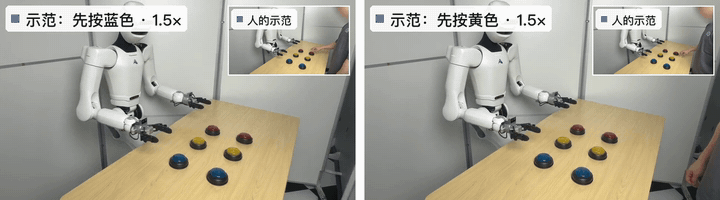
右上角显示示范顺序,两侧机器人分别依照各自的示范执行,均为 1.5 倍速。
结果显示,96% 的按钮操作遵循了示范顺序,92% 的毛巾操作采用了示范折法。
团队进一步改变场景布局、物件、工具及任务,比较「给一段示范」与「只给语言指令」的效果,每个条件测试 100 次。
换用功能相近的替代工具时,一段示范将成功率从 14% 提升至 52%;面对训练中未见的技能,从 6% 提升至 43%。
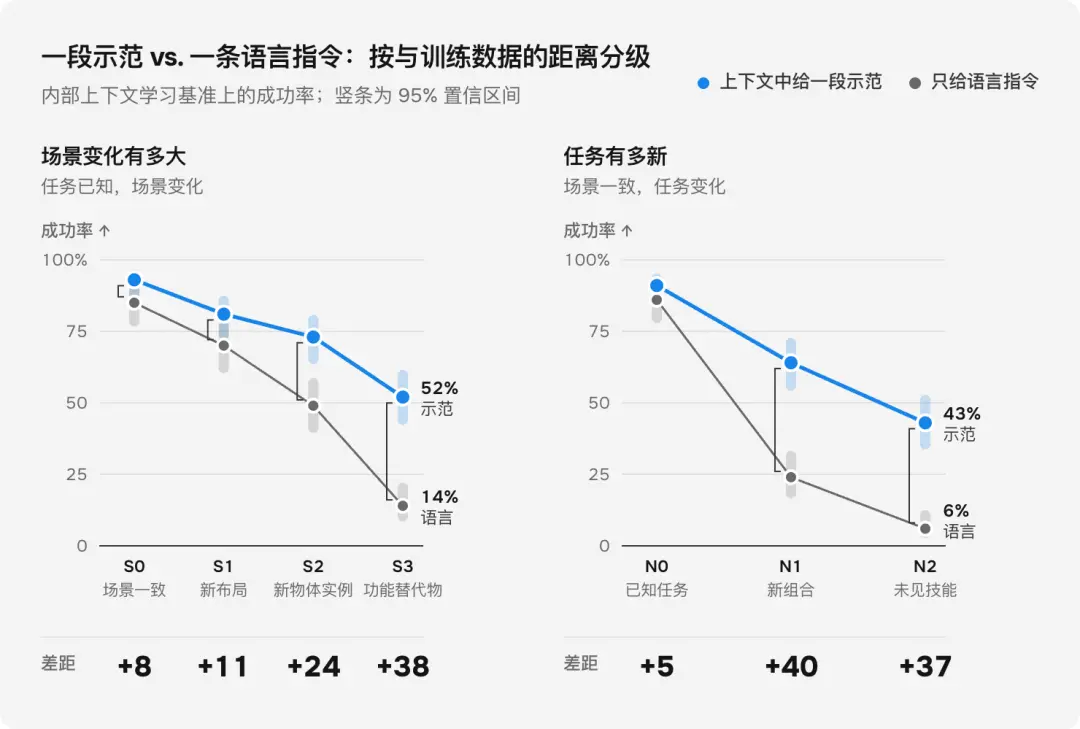
图 2:左图从原场景出发,依次测试新布局、新物体实例及功能替代物(S0–S3);右图依次测试已知任务、技能新组合和未见技能(N0–N2)。每点 100 次试验。
在另一组未见任务上,团队以同一预训练模型比较 ICL 与微调,准备时间包括示范采集与训练。
ICL 用一段示范、约 1 分钟,达到 52% 的平均成功率;微调达到相近水平需要约 180 条示范、约 9 小时,准备时间相差约 460 倍。这意味着,新任务可以先通过现场示范快速验证,再按需要追加训练。
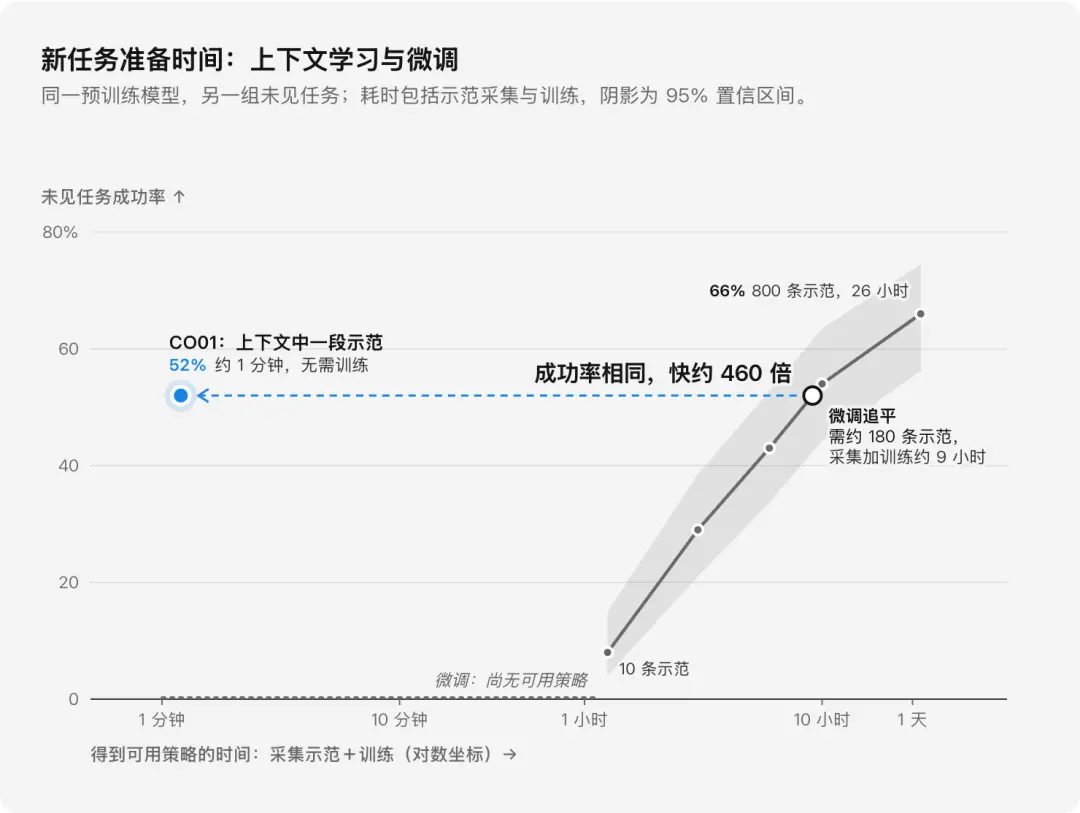
图 3:未见任务上的准备时间与成功率。时间包括示范采集与训练,阴影为 95% 置信区间;约 460 倍按未舍入时间计算。微调最高点为 800 条示范、26 小时,成功率 66%。
2.2 从自身尝试中学习:利用失败改进下一次行动
试管能否放进孔里,动手之后才知道。保留先前尝试的机器人试过左、右两边,第三次把试管放进蓝色架子;看不到历史的那一侧,在同一个架子上试了两次,试管倒了。

左为保留先前尝试,右为不保留历史。两侧均自主执行,2 倍速。
手机盒的演示也出现了同样的差别:保留历史的机器人第四次盖好了盒盖;没有历史的一侧,仍一次次放歪盒盖。
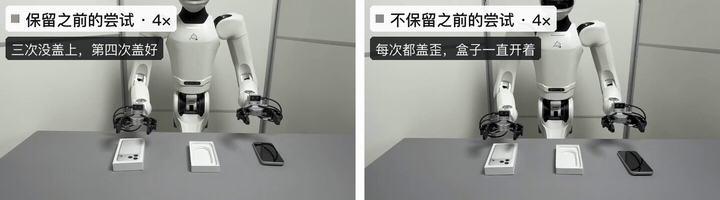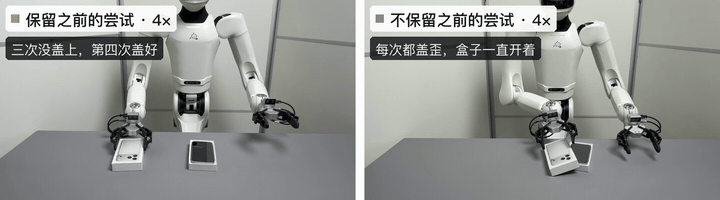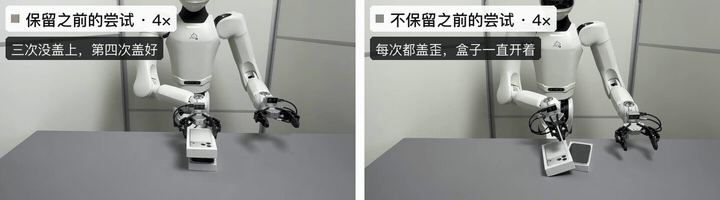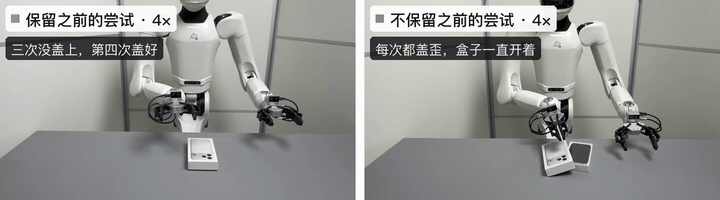
左为保留先前尝试,右为不保留历史。两侧均自主执行,4 倍速。
真机评测选取首次尝试经常失败的任务,每项最多尝试五次,任务、场景和指令保持不变。保留自身历史时,累计成功率从首次的 33% 升至五次内的 84%;同样五次机会,不保留历史为 56%,使用其他任务的失败记录为 58%。相关的失败经验,让重试更有效。
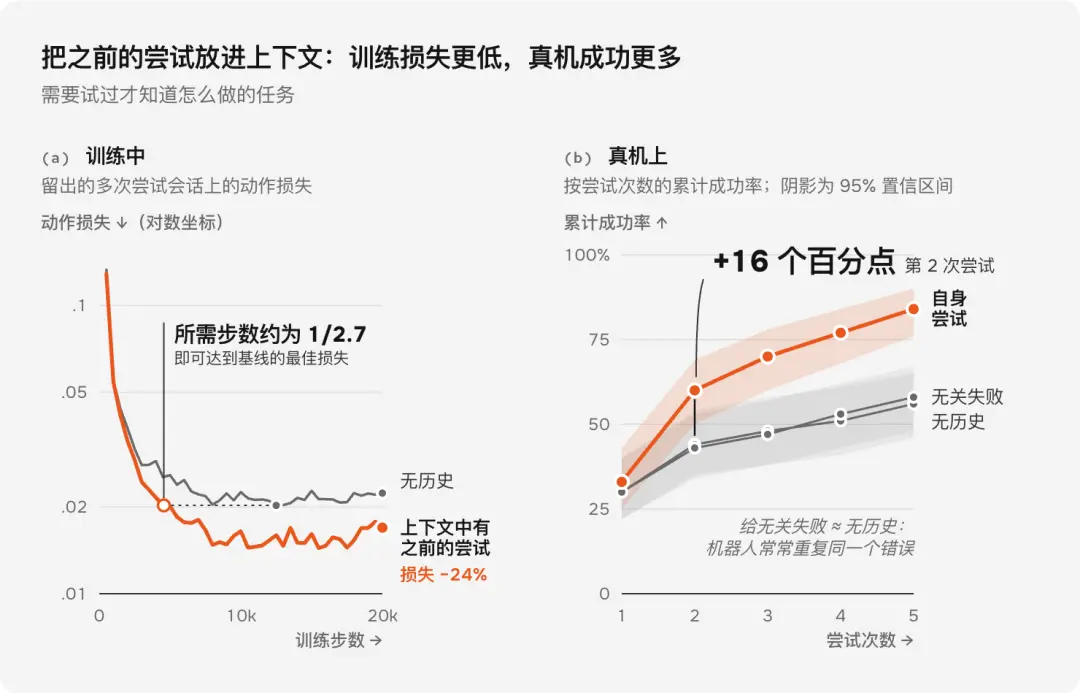
图 4:(a) 同一模型带、不带历史尝试训练,比较未参与训练的多次尝试记录上的动作损失;带历史时损失低约四分之一,并更早达到基线最佳水平。(b) 真机累计成功率,每点 100 次试验,阴影为 95% 置信区间。
2.3 从即时指导中学习:调整当前动作,沿用新的要求
机器人动手后,仍能接收人的指导。机器人正把杯子送向杯架,人中途放下杯垫,它便改变了落杯的位置。
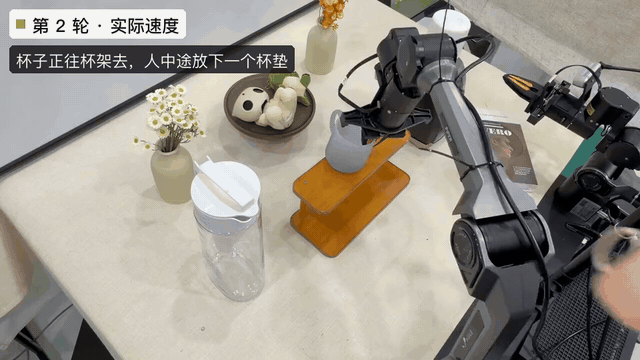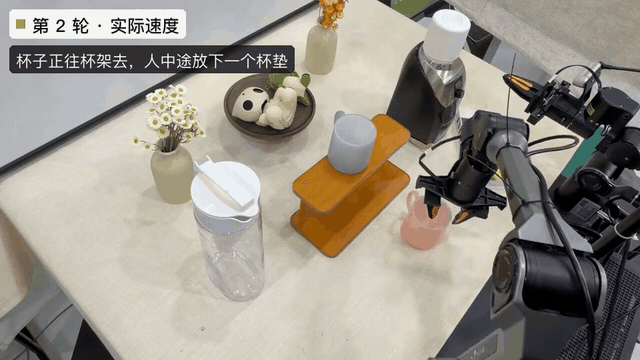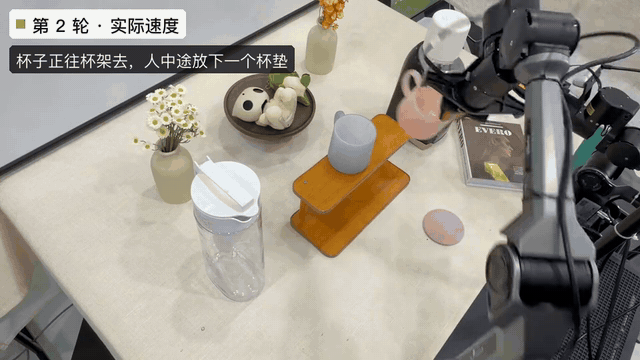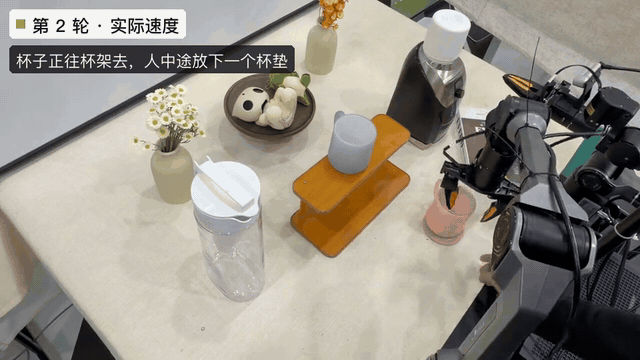
机器人自主执行,中途接收人的指导。实际速度。
一次指点,也能成为后续操作的依据。人先用手势指定杯子与杯垫的配对,再打乱杯垫位置;没有新的提示,机器人仍按刚才教过的关系摆放。
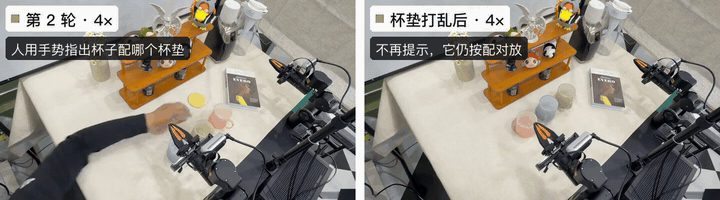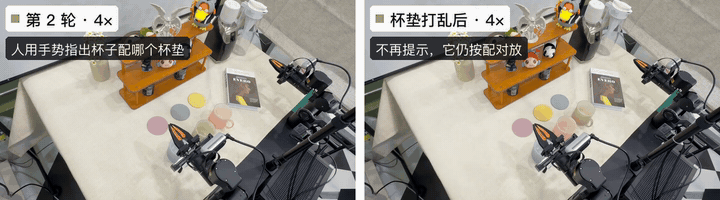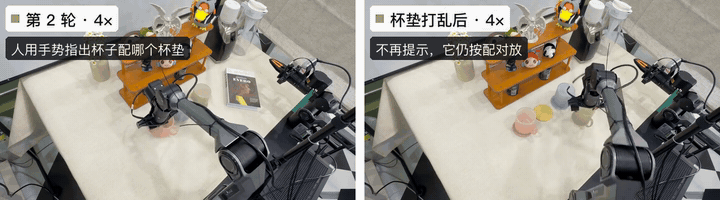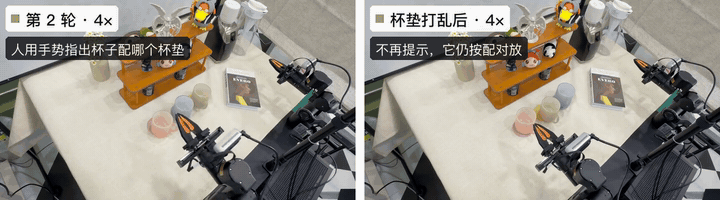
左为手势指定配对,右为打乱杯垫后自主执行,均为 4 倍速。
执行中的指导会保留在 System 1 的上下文中,继续供后续动作参考;跨任务的偏好由 System 2 保存,并在后续任务中重新提供。
2.4 从其他机器人学习:仿真中的跨机体技能传递
在仿真中,双臂机器人先把碎屑扫进簸箕,轮式机器人以这段录像为示范完成任务,人形机器人再向轮式机器人学习。目标和步骤得以沿用,三台机器人拿工具的方式各不相同。
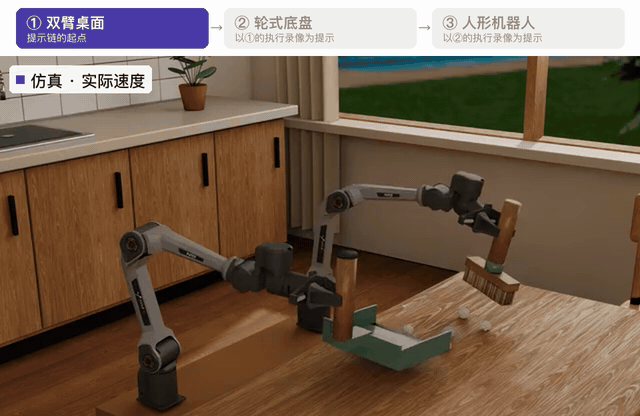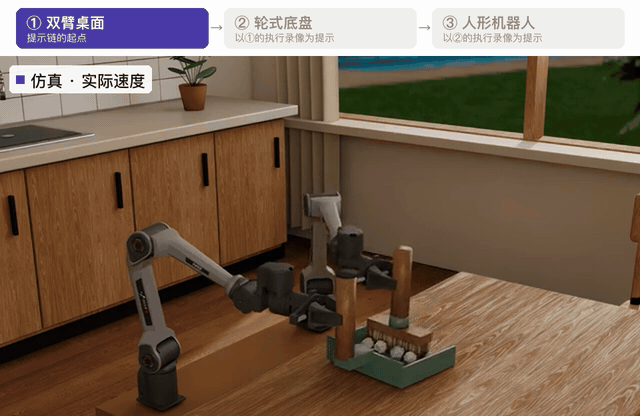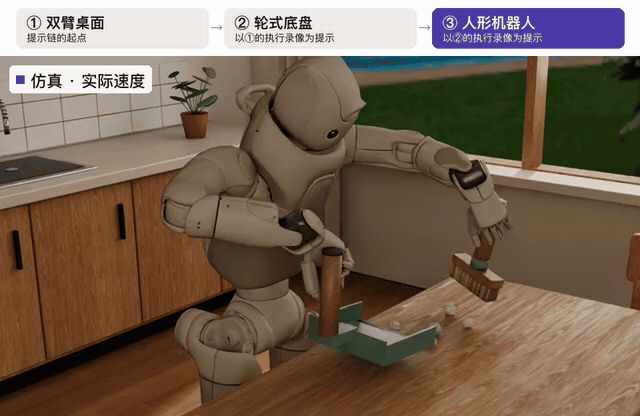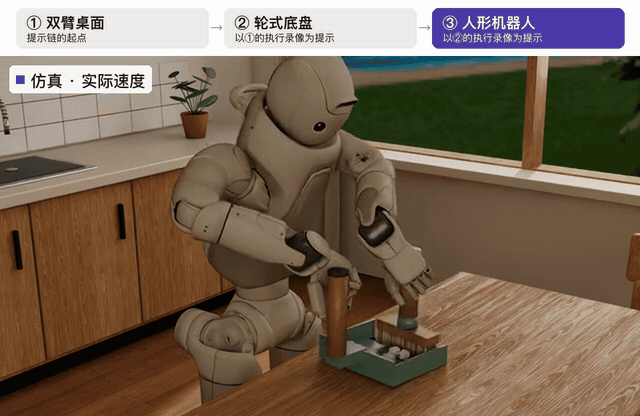
仿真中的技能接力:后两台机器人依次以上一台的录像为示范,自主执行,实际速度。
3. 经验如何成为行动的依据
3.1 System 1 与 System 2:从经验到行动
System 2 组织经验。它负责规划、记忆、调用工具和检查进度,为当前子任务挑选示范、先前尝试或目标图像,并把失败记录交给 System 1,供下一轮参考。
System 1 生成动作。它结合参考经验、实时画面和机器人状态作出决策,也持续接收执行中的指导。训练时,它同时预测后续画面与动作;部署时只输出动作。
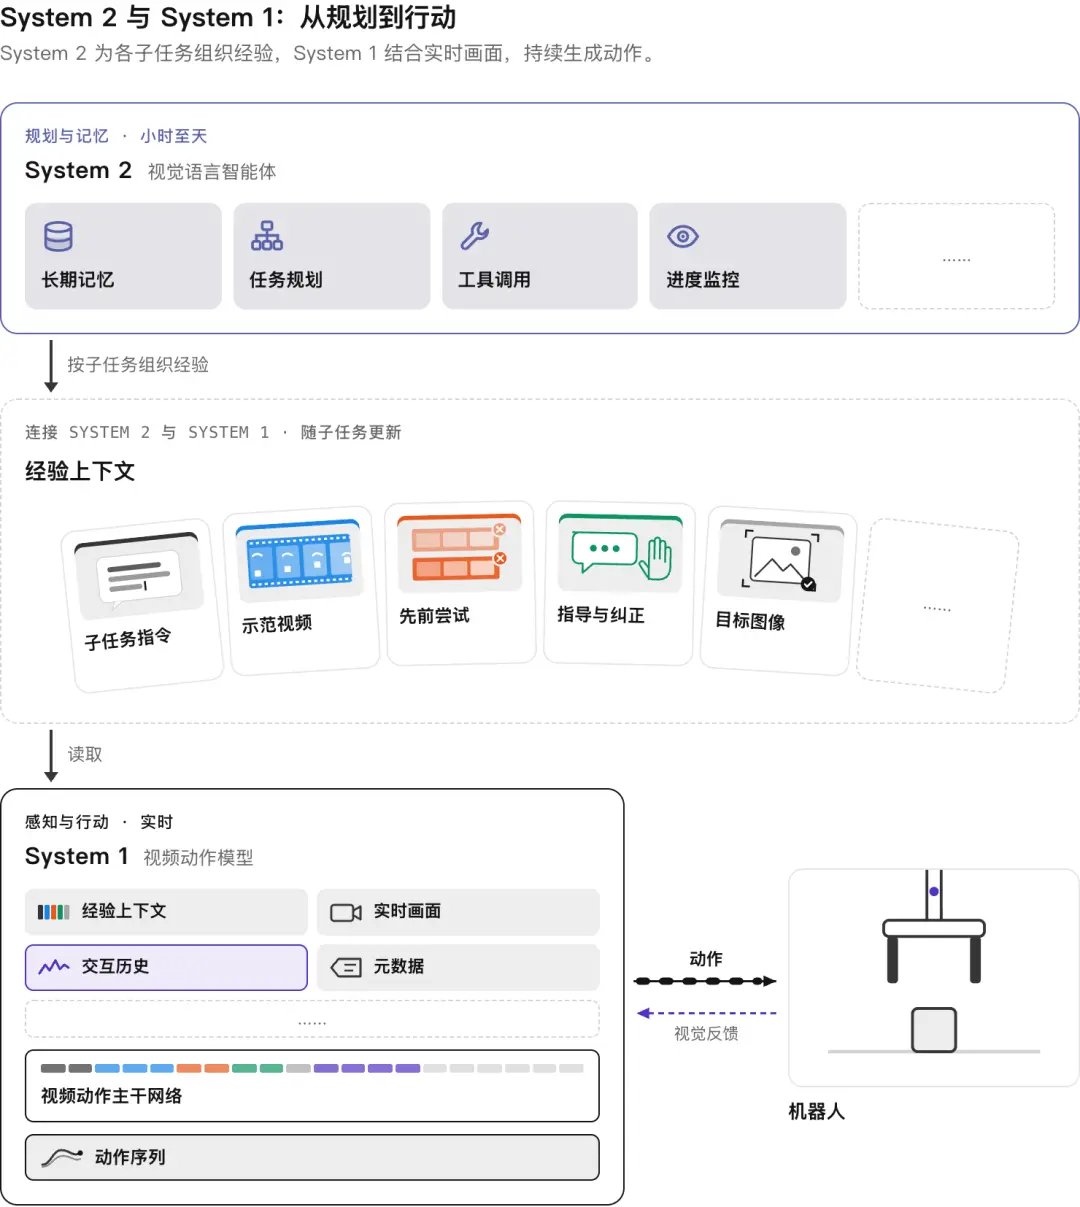
图 5:System 2 组织子任务所需的经验,System 1 结合实时观察生成动作。两者之间既传递任务指令,也传递示范和交互记录。
CO01 的技术重点,是让动作模型直接利用示范和交互记录,保留难以用语言转述的操作细节。
3.2 会话式训练:保留成败的前因后果
CO01 以「会话」(Session)为单位,按时间顺序保留同一任务中的示范、失败、重试和指导,训练模型利用此前的经验预测下一段动作。单次执行记录也参与训练,以保留已有技能。
会话来自专门采集和已有录像整理。不同来源的记录按任务与步骤对齐,经视觉语言模型辅助标注、人工审核;仿真和视频生成进一步扩展物理条件、场景与视角。
训练时,相关示范与先前尝试被放在一起,有时混入无关经验,让模型学会分辨什么值得参考。
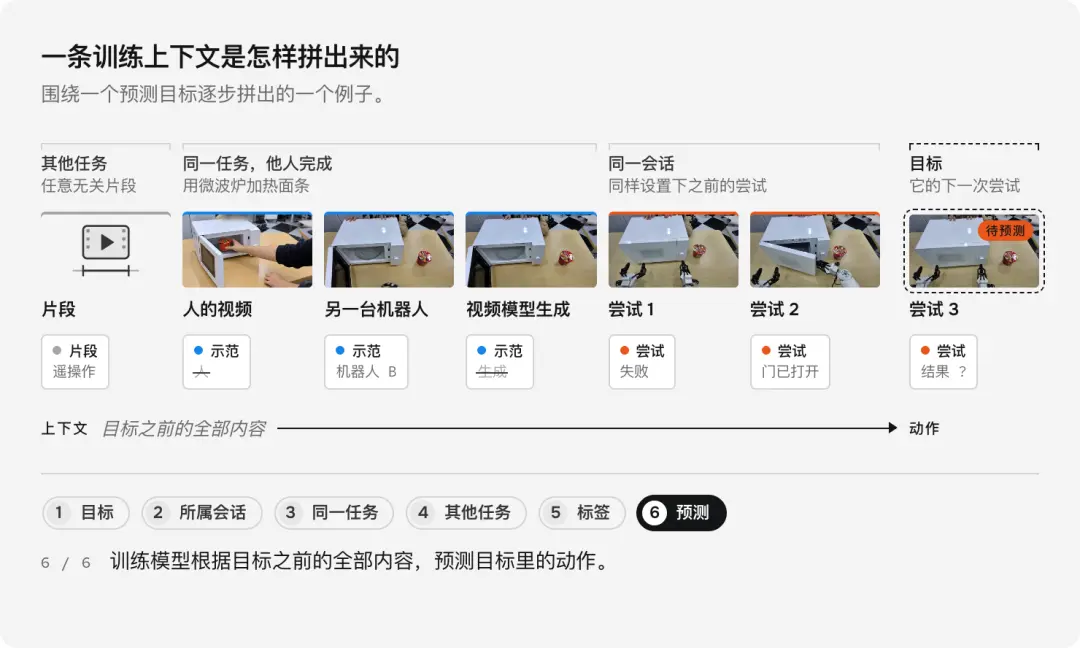
图 6:以第三次用微波炉加热面条为目标,前面放入更早尝试,以及人、其他机器人和视频模型提供的同类示范;有时加入无关任务。训练时随机丢弃部分元数据标签,并改变上下文长度与经验组合。
3.3 统一视觉主干:理解空间与运动
统一视觉主干以人的第一视角视频、多种机器人和手持夹爪记录、仿真及筛选后的网络视频预训练,团队已收集处理约 5 万小时数据。
除预测后续画面外,同一主干还学习深度、表面法线、分割、光流,以及人体、手部和相机运动等感知任务,让与操作有关的信息更容易被模型利用。
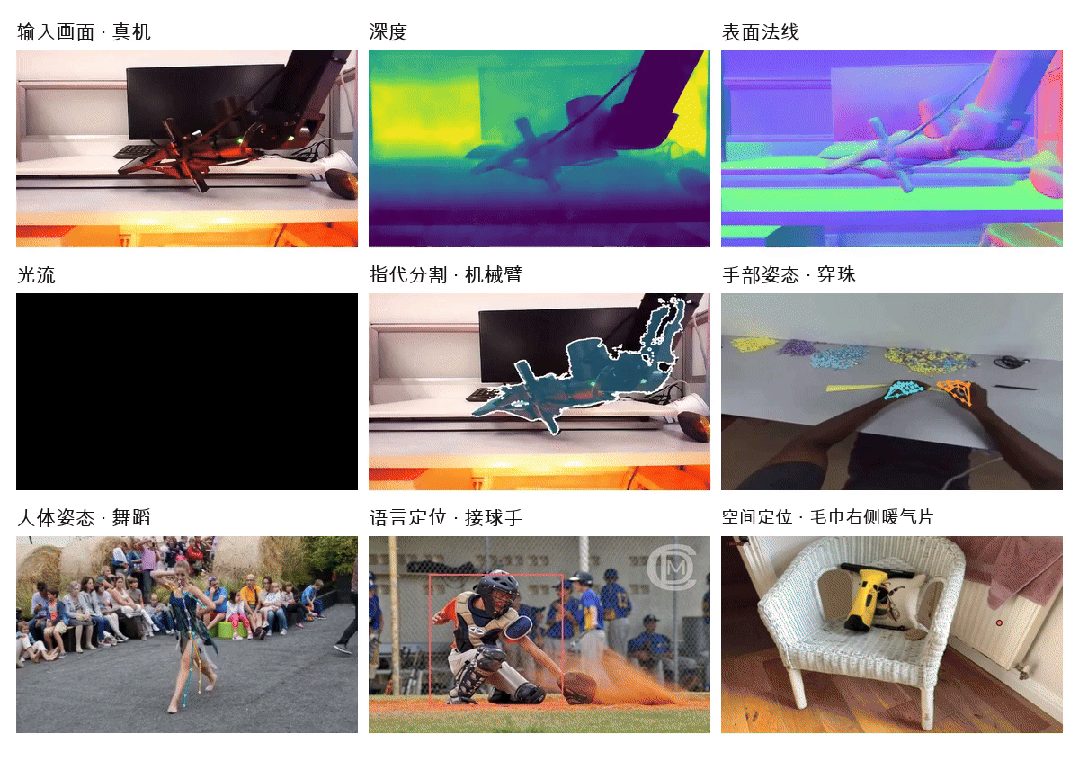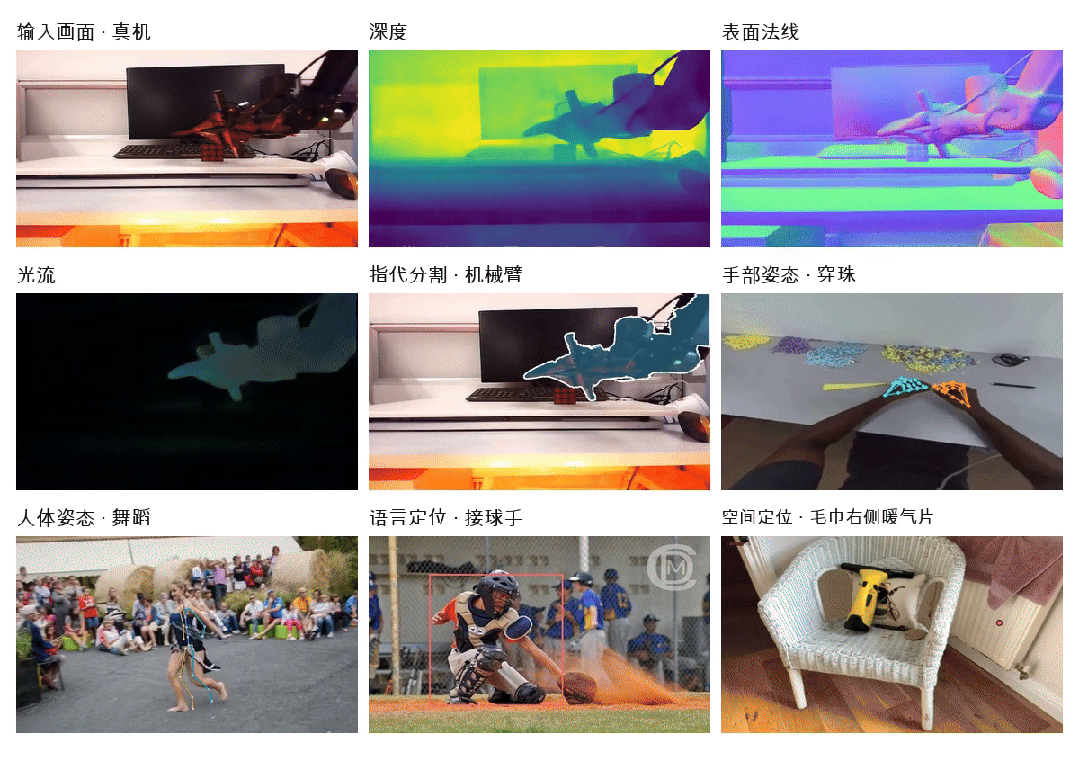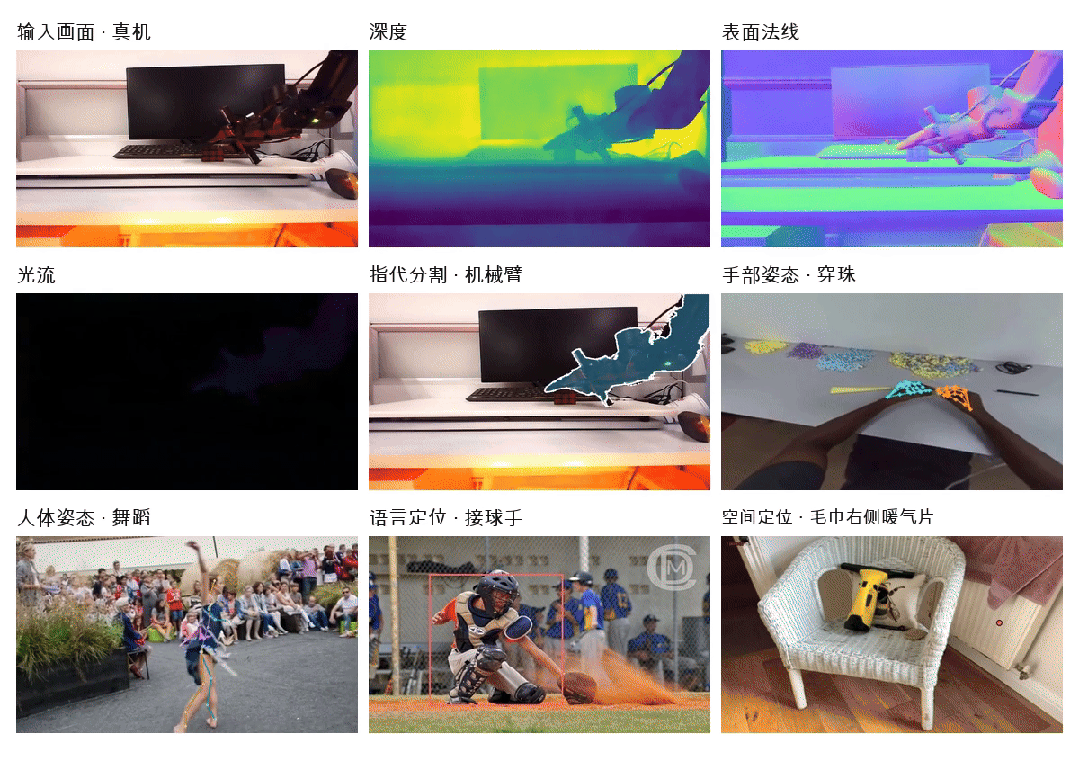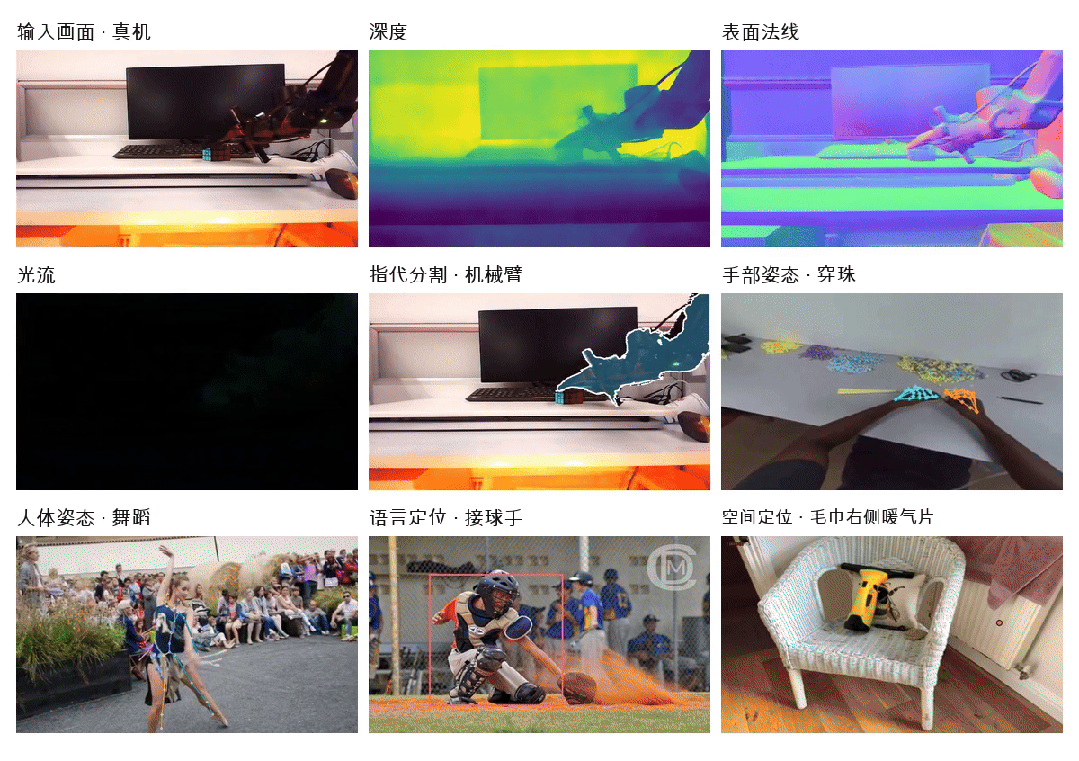
视觉主干的感知能力:真机画面的深度、表面法线、光流与分割,以及手部骨架、人体骨架、语言定位和空间定位。前五格来自同一段真机视频,其余各格为独立案例;手部与定位采用 P10000 EMA 精选结果,与下方基准评测分开呈现。动态片段原速播放,较短片段结束后停留至本轮结束。
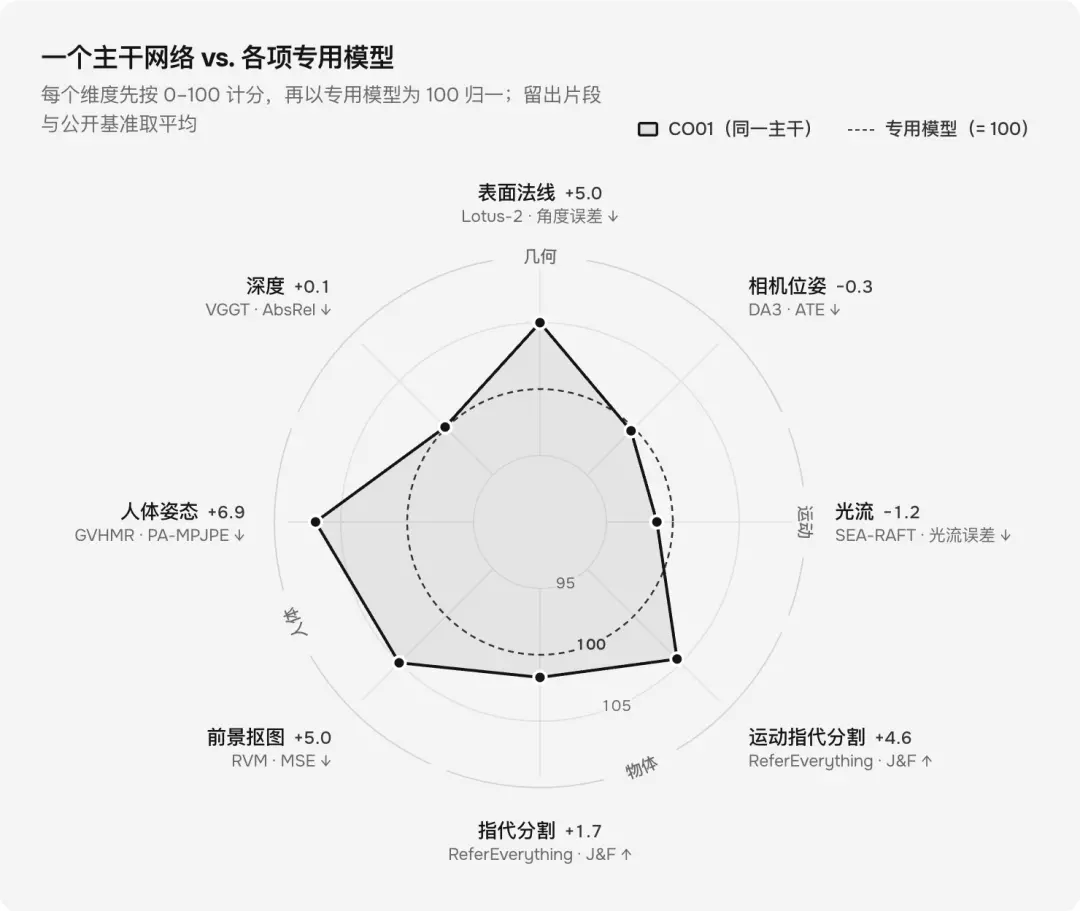
图 7:同一套权重与专用模型比较,八项感知基准中五项领先、深度基本持平,两项落后。相机位姿与光流的原始误差分别高约 19% 和 18%;图中为归一化得分,不等同于原始误差的变化比例。
团队还分别评估了数据规模与任务多样性的作用:随着预训练数据增加,ICL 与微调的表现持续提升;当 ICL 训练覆盖 3,543 种任务时,单示范在未见任务上的成功率达到 53%,仅给语言指令为 18%。扩大训练经验的规模与覆盖范围,有助于提升模型适应新任务的能力。
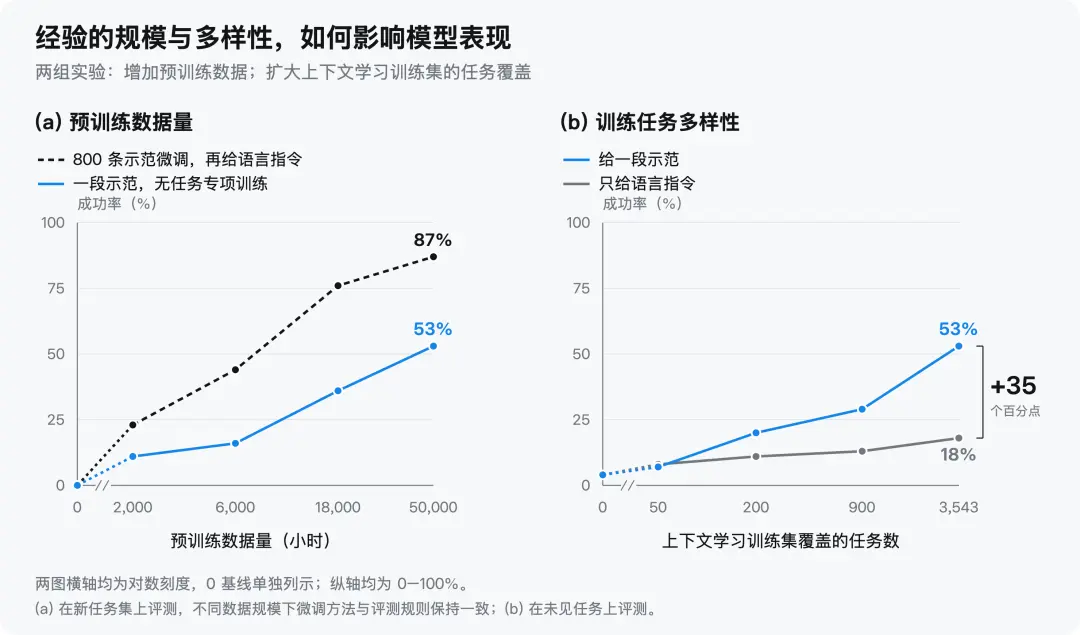
图 8:(a) 增加预训练数据,在新任务集上比较 800 条示范微调与单示范上下文学习;5 万小时时成功率分别为 87% 和 53%。(b) 增加上下文训练任务种类,比较单示范与仅给语言指令。横轴均为对数刻度,0 基线单列;微调方法和评测规则在各规模下保持一致。
4. 从即时适应走向持续学习
下一阶段,团队将重点减少长任务中的误差累积,提高 CO01 选择经验的准确性。让一个场景下积累的经验,可以用在相近场景中,进一步降低部署成本。
团队还计划让 CO01 主动求教:拿不准时请求示范,反复失败时安排练习,并从其他机器人的记录中寻找经验。
目前,新技能主要通过上下文学习来适应,跨任务偏好由 System 2 保存。COCO 长期的目标,是以执行经验驱动模型持续进化,让机器人共享技能、加速学习与适应,最终服务千行百业,走进千家万户。
可可矩阵正在持续寻找进一步优化 CO01 合作伙伴,欢迎对 In-Context Learning 与持续学习、多模态表示学习及真机实验方向感兴趣的研究人员与工程师加入。
参考链接
1. Brown, T. et al. Language Models are Few-Shot Learners. NeurIPS 2020. https://arxiv.org/abs/2005.14165
2. Generalist AI. GEN-1.5: Embodied Foundation Models are One-Shot Learners. 2026. https://generalistai.com/blog/gen-1.5
3. Skild AI. Introducing S1: In-Context Learning for Robotics. 2026. https://www.skild.ai/blogs/s1
4. Duan, Y. et al. One-Shot Imitation Learning. NeurIPS 2017. https://arxiv.org/abs/1703.07326
5. Polanyi, M. The Tacit Dimension. University of Chicago Press, 1966.
6. Chan, S. C. Y. et al. Data Distributional Properties Drive Emergent In-Context Learning in Transformers. NeurIPS 2022. https://arxiv.org/abs/2205.05055
7. Raventós, A. et al. Pretraining Task Diversity and the Emergence of Non-Bayesian In-Context Learning for Regression. NeurIPS 2023. https://arxiv.org/abs/2306.15063
8. Wang, L. et al. Video Generation Models are General-Purpose Vision Learners. 2026. https://arxiv.org/abs/2607.09024
9. Silver, D. and Sutton, R. S. Welcome to the Era of Experience. 2025. PDF
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com