近日,Arm公布新一代Mali GPU架构更新,在图形管线内升级矩阵运算单元,强化端侧大模型推理与神经渲染协同,面向车载、移动及嵌入式终端推出统一软件调度方案。
这种把AI算力融入GPU、以统一硬件承载多类负载的方式,正成为行业共同选择。类似的融合尝试也在不同市场层次展开,从移动端到桌面端,再到IP授权市场,厂商路径各异,指向的却是同一个方向。
01 本地AI为何需要GPU
随着边缘端应用场景持续丰富,设备需要同时承载图形渲染、机器视觉、信号处理与大模型推理等多类任务。
以端侧大模型为例,从单一对话到多模态协同,从短上下文到长上下文,负载特征持续变化,对硬件灵活性提出更高要求。过去一段时间,芯片设计的主流思路是针对不同负载单独配置专用硬件模块,图形单元、AI加速器、视频编解码单元各自拥有独立的数据通路与软件栈。这种方案可以针对单一指标做到性能最优,但短板同样突出。多加速器并存会显著提升系统集成难度,硬件资源难以跨任务调度。一旦终端需求迭代,部分专用固定功能硬件就会出现利用率不足的问题,推高芯片整体成本与功耗。
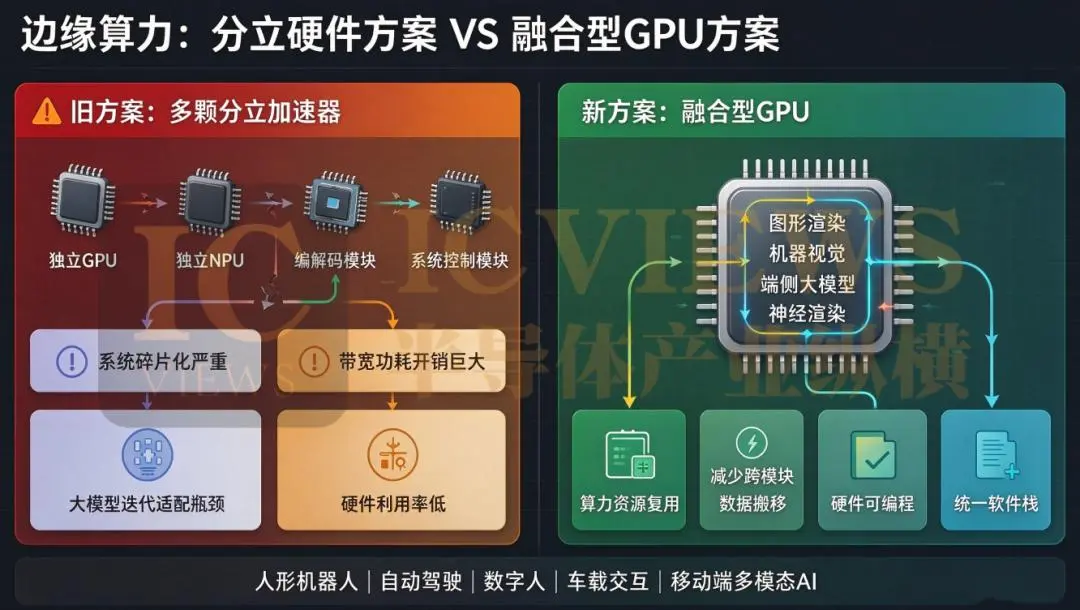
在边缘AI爆发初期,市场涌现大量独立NPU产品,规格围绕固定算子与模型结构设计。但大模型架构、量化方案、算子集合仍处于快速迭代周期,固定硬件架构很容易在模型更新后出现适配瓶颈。行业逐步意识到,单一专用加速器难以长期适配持续变化的AI工作负载,兼具图形能力、通用并行计算、可编程特性的GPU,开始成为边缘融合算力的核心载体。算力架构的竞争重心,也从单纯比拼峰值算力,转向硬件可编程能力、软件栈通用性以及多任务下的实际能效表现。
在此背景下,不少芯片厂商早已开始实践这套融合思路。NVIDIA依靠Tensor Core,让GPU硬件可以在图形渲染、机器视觉、AI推理之间复用算力;高通则一边打通Adreno GPU与Hexagon NPU调度,一边将超分、帧生成这类AI任务往图形管线迁移;Imagination的E系列产品选择直接把可编程矩阵加速器整合进渲染管线,靠一套内核同时扛图形、通用计算和AI推理。因此,端侧想跑通AI,图形能力已经是绕不开的底层底座。
02 算力融合下的硬件与软件协同
基础矩阵与卷积运算能力,成为融合型GPU支撑AI与视觉任务的核心。AMD的嵌入式产品线在GPU内核中集成专用AI单元,面向工业机器人场景,同步处理实时可视化画面与目标检测、分割等计算机视觉任务,看重多任务并发稳定性。英特尔的Arc核显持续迭代XeSS神经超分,把AI上采样能力深度绑定图形渲染流程,减少单独NPU带来的数据搬移开销。这些取舍背后,是对端侧多任务并发效率与数据搬运带宽开销的共同考量。各家实现路径虽有不同,但都认识到单一硬件指标难以支撑持续演进的AI负载,硬件可编程性正取代固定算子,成为底层竞争的焦点。
神经渲染是把AI引入图形管线最直接的落点。NVIDIA的DLSS以神经网络重构低分辨率帧,DLSS 4进一步引入多帧生成,可为每个传统渲染帧生成多帧画面,最高把帧率提升至传统渲染的数倍;随后迭代到把光影与材质交给AI的3D引导神经渲染。AMD的FSR 4用训练过的神经网络从低分辨率帧重构画质,Intel的XeSS 2把AI帧生成与低延迟技术打包,支持游戏总数不断扩充。超分辨率成为各家的共同切入点,原因在于它可以在不改变渲染分辨率的前提下,用神经网络补足画面细节,兼顾画质与性能,避免单独为AI功能铺设专用硬件。Imagination的E系列在这一方向推出NSR神经超分辨率方案,深度适配自家GPU,采用单次时序超分处理,配合网络自压缩技术削减冗余权重以降低推理功耗,在1GHz单核配置上540p到1080p的超分延迟约2.3毫秒,并计划通过PowerVR SDK及Unreal Engine、Godot等引擎提供支持。把超分辨率这类任务放进GPU而非分立NPU,共同的好处是减少帧数据在不同硬件模块间来回搬移带来的带宽损耗。
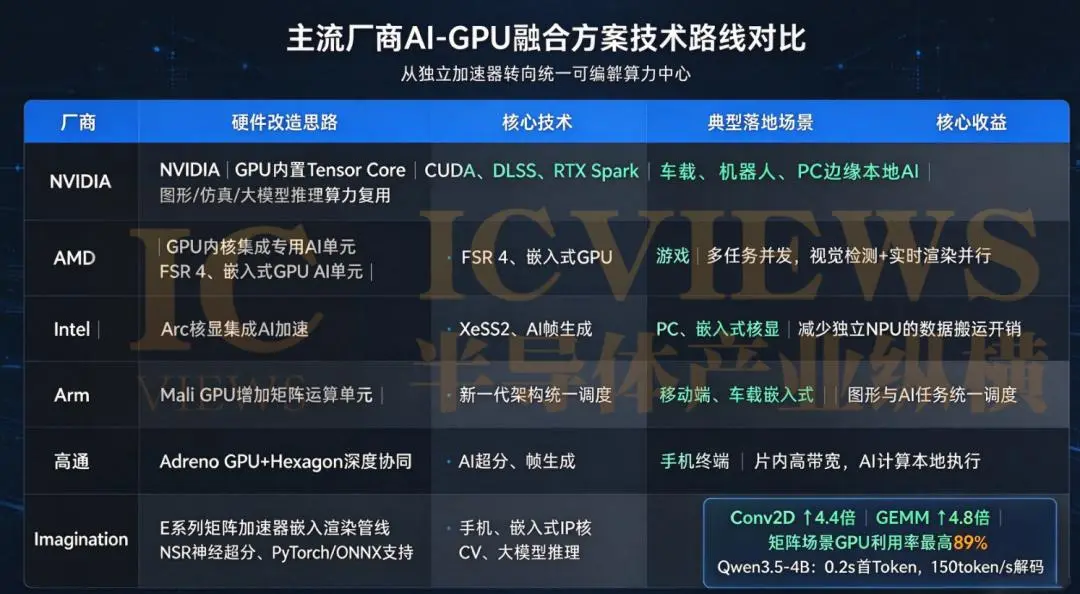
在基础算力上,Imagination给出的一组对比数据是,与上一代D系列相比,E系列的Conv2D卷积运算性能提升4.4倍,GEMM矩阵乘法提升4.8倍,矩阵运算场景GPU利用率最高可达89%。在典型边缘语言模型上,其预填充性能提升4.7倍,以Qwen 3.5 4B模型为例,1.5GHz四核配置可实现0.2秒首次Token生成,解码吞吐量约每秒150个Token。为降低模型迁移成本,团队正把优化后的Llama.cpp后端提交至上游开源社区,后续计划原生支持PyTorch与ONNX Runtime。图形仍是这套IP的基本盘,E系列新增DirectX 12 FL11_0支持,游戏负载下相比上代最高获得54%性能提升,每瓦性能最高提升39%,提供多档可配置规格覆盖智能手机到嵌入式系统,首批芯片预计年内流片。
03 整个行业向GPU收敛
NVIDIA基于Blackwell架构继续打磨统一算力体系,依靠CUDA软件栈打通渲染、通用计算和本地智能体推理,新版3D引导神经渲染直接把AI生成能力注入实时渲染流程。RTX Spark这类消费级硬件,把图形、CPU、AI算力收敛到单颗芯片,支持离线跑大参数本地智能体,就是这套思路面向终端的落地产物。
就在10月21日的柏林GTC大会上,黄仁勋的主题演讲也侧面印证了这一方向。他提出“物理 AI”将是下一波发展主线,人形机器人、自动驾驶这类现实世界交互场景,非常依赖设备本地同时完成仿真渲染与AI推理。现场演示中,RTX Spark就在同一套GPU资源上,并行承担3D仿真和机器人…能体推理。
另一边,Arm新一代Mali架构选择在图形管线内加大矩阵运算资源,实现图形AI任务统一调度,减少多加速器之间的数据来回搬运;高通也给GPU加入AI矩阵核心,将神经处理、超分、帧生成收拢进图形管线,依靠片内高带宽内存把AI计算留在本地。
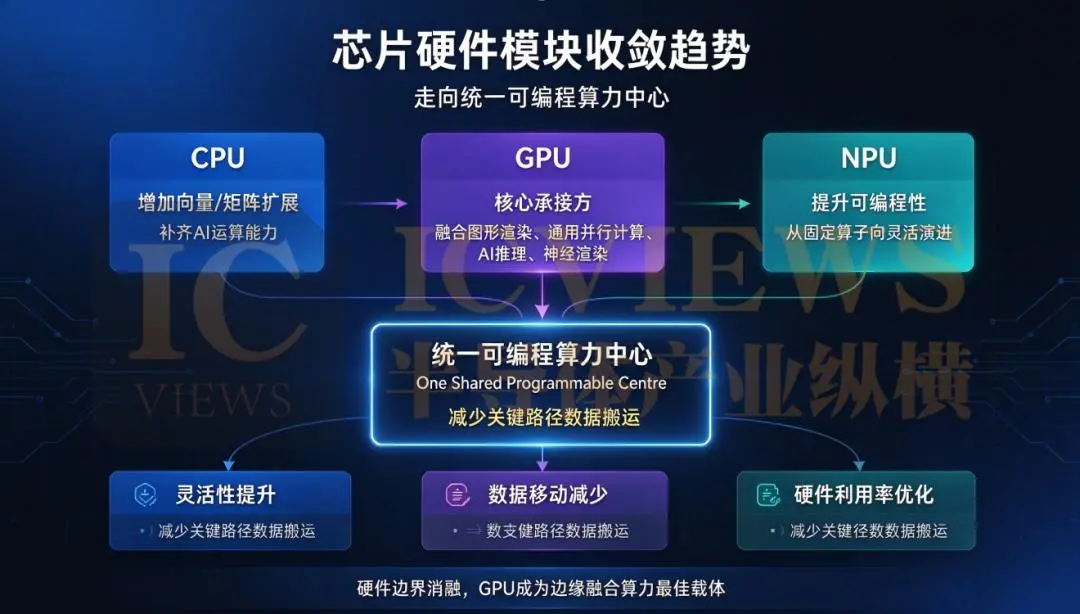
从IP厂商到终端芯片,硬件之间的界限正在消融:CPU靠向量扩展补强AI,NPU不断强化可编程能力,而GPU因为并行算力、成熟软件生态和原生图形能力,在混合负载场景里优势突出。随着移动端多模态大模型普及,端侧不再只是跑对话,还要兼顾视觉、语音协同处理,对统一硬件调度的需求越来越强。行业评判硬件的标准也在转变,纸面TOPS峰值算力不再是唯一标尺,端到端Token吞吐、渲染延迟、带宽开销、真实能效以及软件可拓展性,变得更加重要。
04 从卖硬件转向卖平台
算力融合时代,芯片IP与处理器厂商的竞争重心逐步从硬件单元性能比拼,转向完整平台能力建设。硬件可编程能力、开源生态适配、上层引擎集成,共同决定产品在设备生命周期内的价值。单一硬件参数优势很难长期维持,一套统一、可迭代的软件栈,成为融合GPU方案的核心护城河。这也意味着,围绕GPU建立的开发工具链、开源贡献与引擎适配,正在取代单纯的算力数字,成为衡量一家芯片企业竞争力的重要维度。对下游开发者而言,熟悉的编程模型与可复用工具链,直接决定了一款硬件能否快速进入主流生态。
Jon Peddie Research总裁兼创始人Jon Peddie表示:“传统处理器类别之间的界限正在逐渐模糊。CPU正在利用向量扩展来提升AI性能,而NPU也正在变得更加通用。随着功能不断融合,GPU最有可能在这一趋势中脱颖而出;毕竟,GPU不仅具备并行计算能力和成熟的软件生态,与其他处理器不同的是,它还能够在运行AI和计算工作负载的同时处理图形任务。”
放眼未来,随着生成式AI、数字人、机器人、车载交互等边缘应用持续落地,图形渲染与AI推理的混合负载会越来越普遍。芯片设计企业将持续权衡专用硬件与通用可编程架构的取舍。融合型GPU为行业提供了一条降低系统碎片化、复用算力资源的可行路径,后续产业竞争,也会更多聚焦在软件生态完善度、跨负载调度效率、模型迁移成本以及不同终端场景下的持续迭代能力。
本文来自微信公众号“半导体产业纵横”(ID:ICViews),作者:子皓,36氪经授权发布。