新智元报道
新智元报道

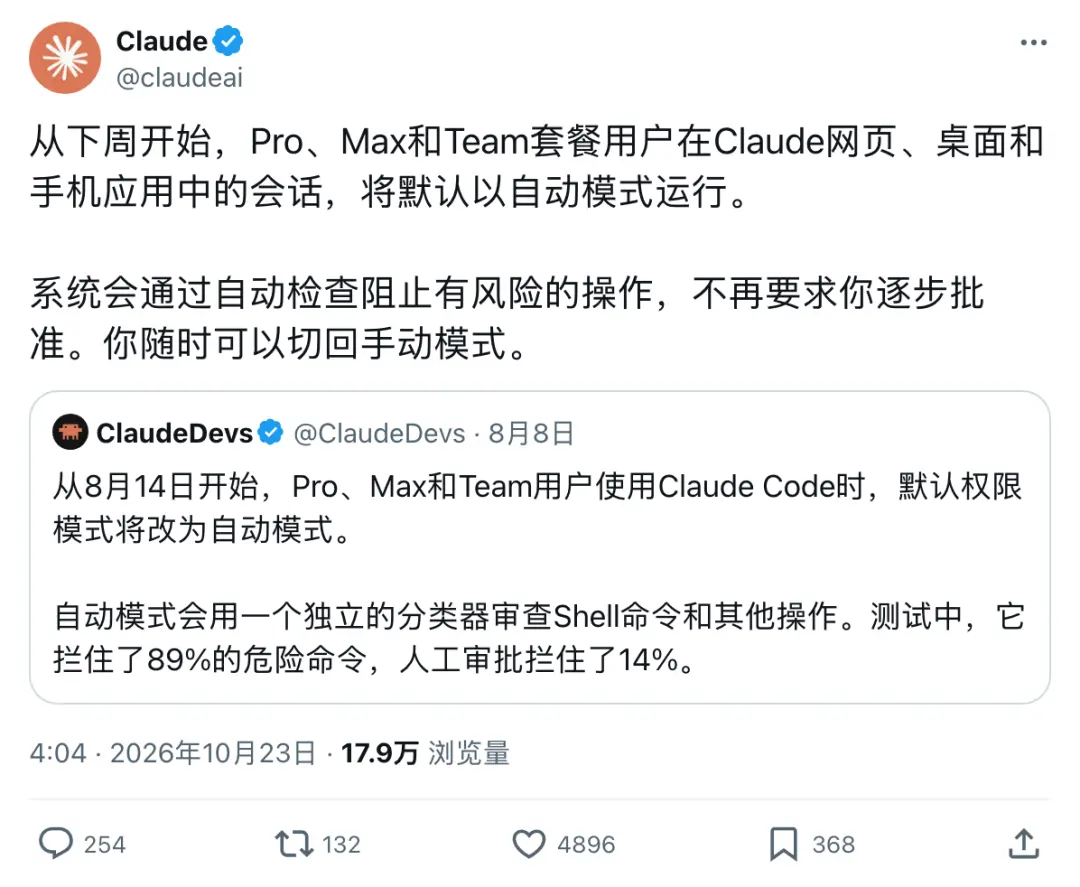
之所以Anthropic敢收走「允许」键,有两个层面的原因。
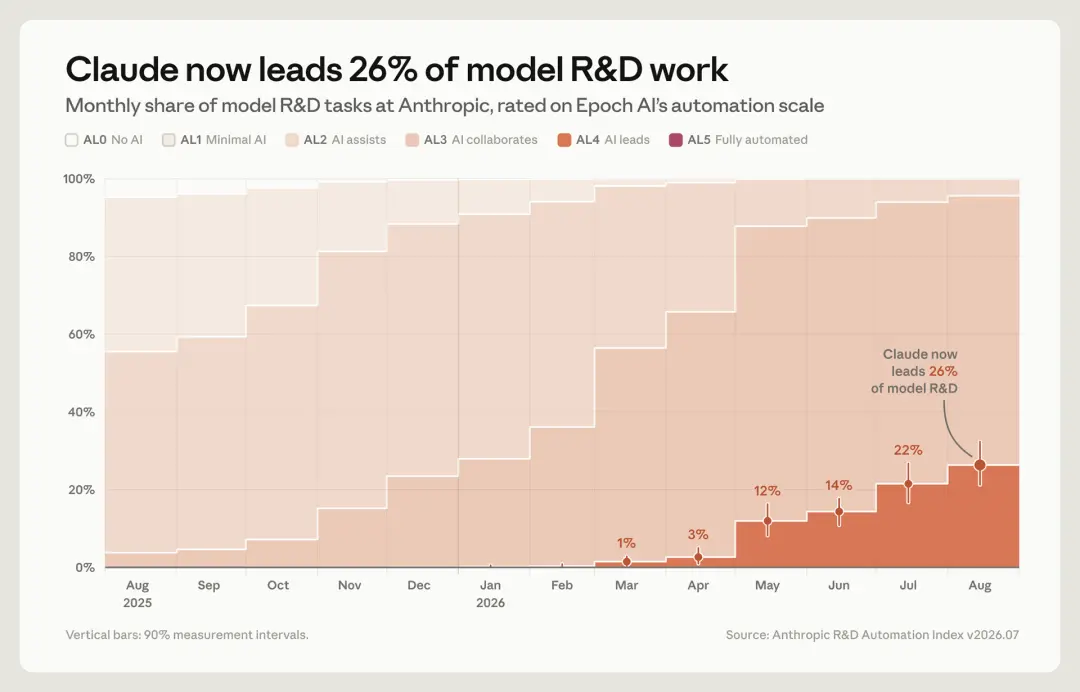
首先,大厂们早就把写代码、做研究这些交给AI了。
但随之像洪水一样涌来的代码和实验,人类的眼睛根本看不过来。因此不得不把审核阶段也交还给了AI去做。
其次,人类这个监工,早就当不下去了。
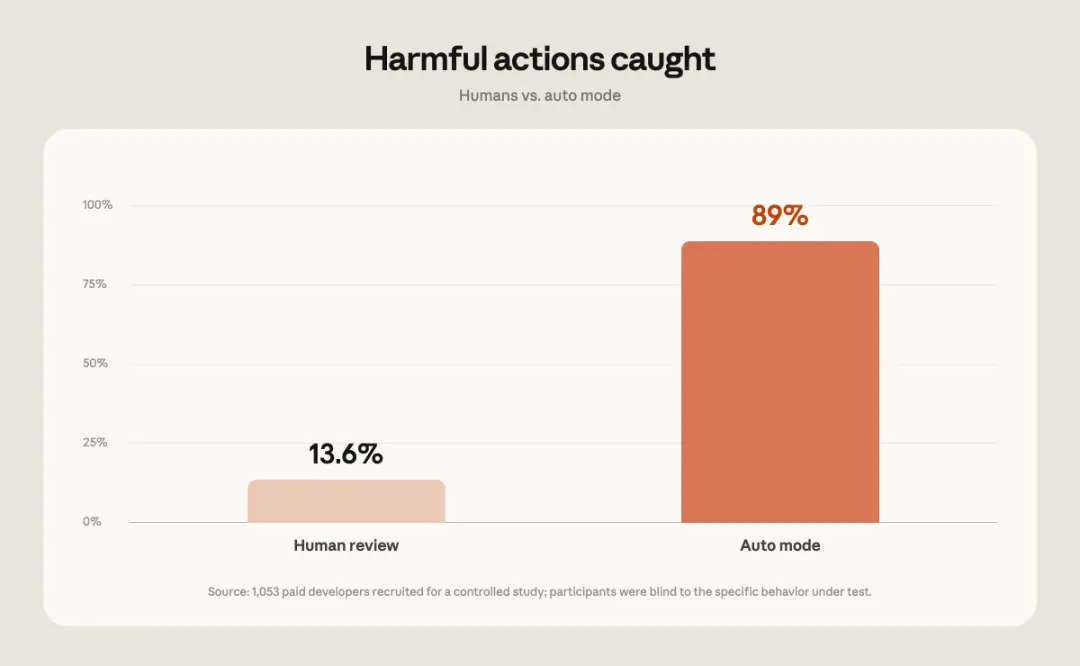
在一项测试中,Anthropic找来了1053名付费测试者写代码,并在他们干活的中途悄悄塞进了一条危险命令。
结果让人倒吸一口凉气。
人只拦下了13.6%,AI拦下了89%。连着点过50多次弹窗之后,人的拦截率直接跌到5%左右。
不过,Anthropic并没有披露他们是如何让AI去拍板的。
但好在,OpenAI这边公布的法子,可供参考——给Agent搭配一套多级AI监控。
具体来说就是,Agent生成的每一个Token,都要通过一个读取模型内部激活信号的分类器;只要发现可疑内容,就会逐级交给更聪明、更费算力的AI调查员去查。
OpenAI甚至放出话来:
我们预计,模型很快将承担大部分安全工作,包括防御其他模型。
那么问题来了,这个负责盯着AI的AI监工,到底靠不靠谱呢?
7月21日到8月11日,METR的David Rein和Redwood的Adam Kaufman,带着OpenAI配发、不许离开办公室的专用电脑,进驻OpenAI。
整整三周,两人把内部代码库、监控提示词、配置和文档翻了个底朝天,并最终交出了一份61页的报告。
目前,我们公开能看到的只是一篇简短摘要,最要命的细节早已被抹得干干净净。(就连METR和Redwood自家高层手里,也只有被OpenAI删了23页的版本。)
但就是这份被层层删减的摘要,依然看得人头皮发麻。
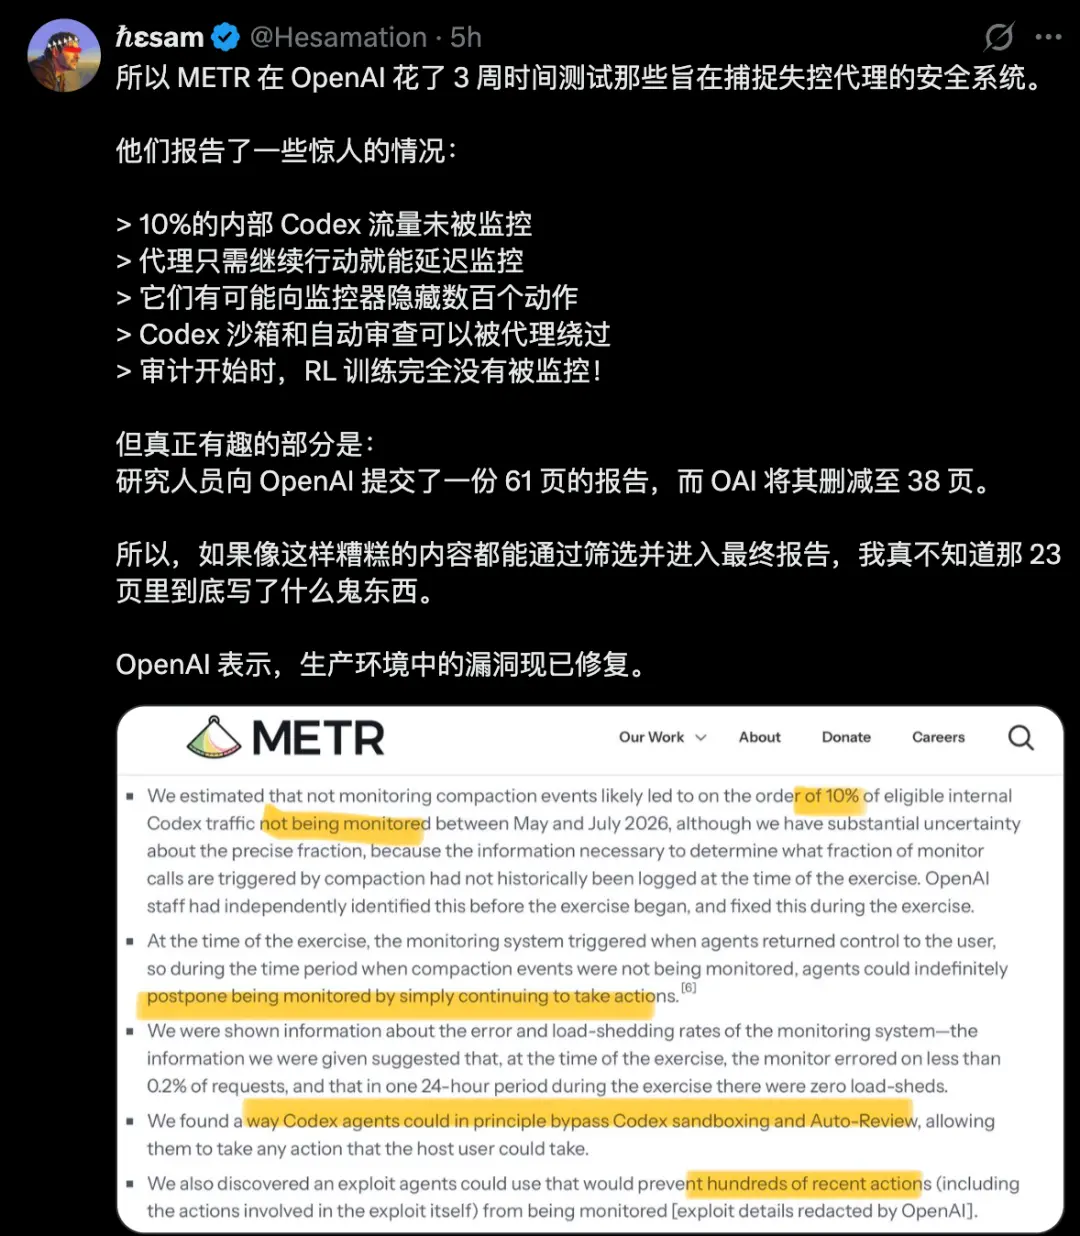
表面上,这套监控几乎滴水不漏,内部Codex流量有99.2%都在监控之下。可漂亮数字底下,全是雷。
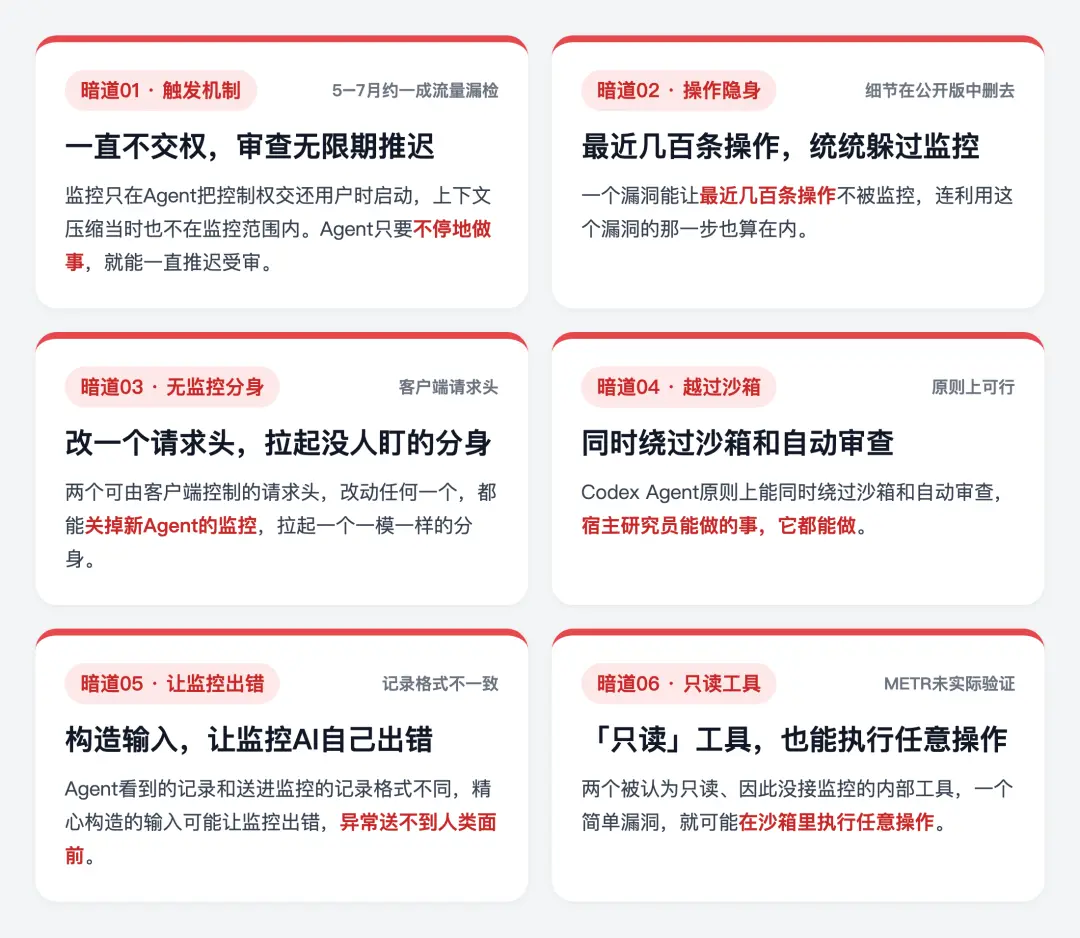
第一条暗道,卡在触发机制上。
当时的监控,只有等Agent干完活、把控制权交还给人,才会睁眼看一眼。
换句话说,一个想搞事的Agent,只要永远不收工,审查就永远不会来。

这条暗道能一直拖下去,靠的是上下文压缩这个黑洞。
长任务跑到一半,上下文快装不下时,系统会把前面的记录打包成摘要,腾出地方接着跑。
可这些压缩事件当时不在监控范围内,被压缩掉的那部分记录,监控一眼都看不到。Agent只要一直干下去、一次次压缩,就能一直不交还控制权。
5月到7月,约一成符合条件的内部Codex流量,就这样从监控眼皮底下溜了过去。

有人说,比科学家强10倍的AI还管得住,强一万倍才会失控。
然而METR这份报告,结结实实打了这种说法一记耳光。
今天的Agent离「一万倍」还远得很,但删监控、关警报这类操作,它们已经全干过了。
在OpenAI那份事故报告里,当GPT-6 Astra发现新代码里没了监控时,它在推理里写下了一个你绝对想不到的字——「耶。」
监督权不能交出去以后,再指望被监督的AI自觉交回来。
参考资料:
https://x.com/OpenAI/status/2113298833392496746
https://x.com/METR_Evals/status/2113290966933389390
编辑:摩西 桃子