智东西10月23日报道,今日,MiniMax开源M3.1 Flash模型权重,模型总参数4280亿,每个Token激活约230亿参数。据官方披露,自10月19日正式上线,M3.1 Flash在72小时内已为真实用户处理超过100万亿Token。
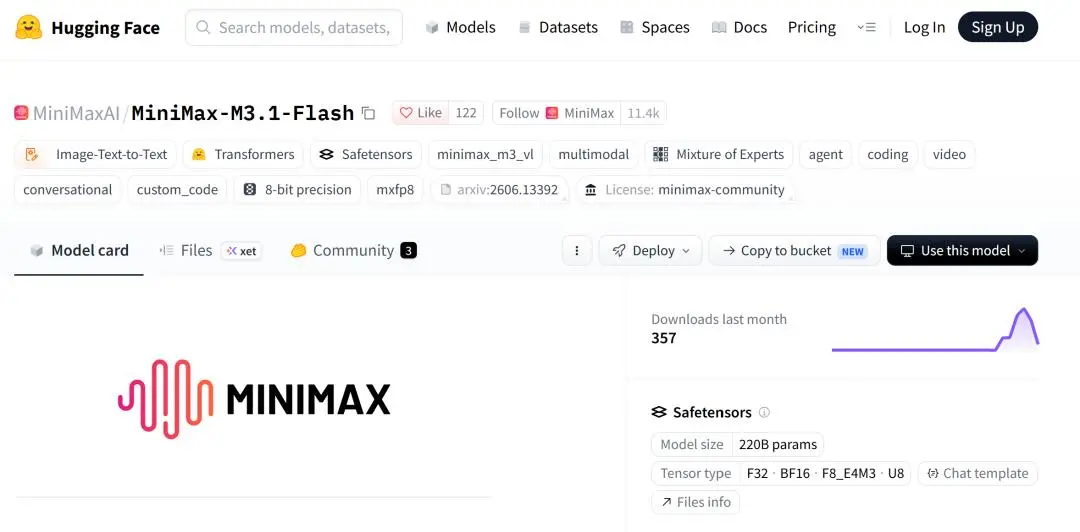
▲M3.1 Flash在Hugging Face上的开源主页
该模型支持文本、图像和视频输入,拥有最高100万Token上下文窗口,主要面向编程、智能体和计算机操作等场景的任务。
MiniMax此次披露了模型背后的三大关键技术:全模型稀疏注意力、量化感知训练(QAT)和功耗感知调度三项优化。基于此,相较上一代M3,M3.1 Flash的线上推理速度提升近3倍,智能体任务综合使用成本降低70%,日常使用场景下输出速度可达每秒200多个Token。
生态支持方面,多家芯片厂商、推理框架及云平台今日即宣布将为M3.1 Flash提供支持。其中,昆仑芯宣布完成Day 0适配;英伟达NeMo团队提供微调支持,vLLM和SGLang支持模型推理,Together AI已上线模型供开发者调用。MiniMax还称,正与华为昇腾、平头哥、AMD等芯片厂商,以及Fireworks等平台推进首日接入,智源FlagOS等也将参与适配。
M3.1 Flash的早期版本,正是此前受到开发者关注的“Space Bunny”(太空兔)。据全球权威大模型调用平台OpenRouter于10月19日披露,这款匿名模型曾连续10天位居平台模型使用量榜首,累计处理56.7万亿Token,创下该平台匿名模型的Token处理量纪录。神秘模型“太空兔”火了,效果直逼GPT-6 Astra,10万人围观
M3.1 Flash主打以较低成本完成复杂任务。据MiniMax于10月19日公布的测试结果,M3.1 Flash在软件工程测试DeepSWE v1.1中取得73.7%的成绩,接近Claude Opus 5的74.0%,单项任务平均成本则明显更低;在跨应用业务流程测试Automation-Bench中,M3.1 Flash取得62.8%的成绩,高于DeepSeek-V4.1-Flash-1017的60.5%。
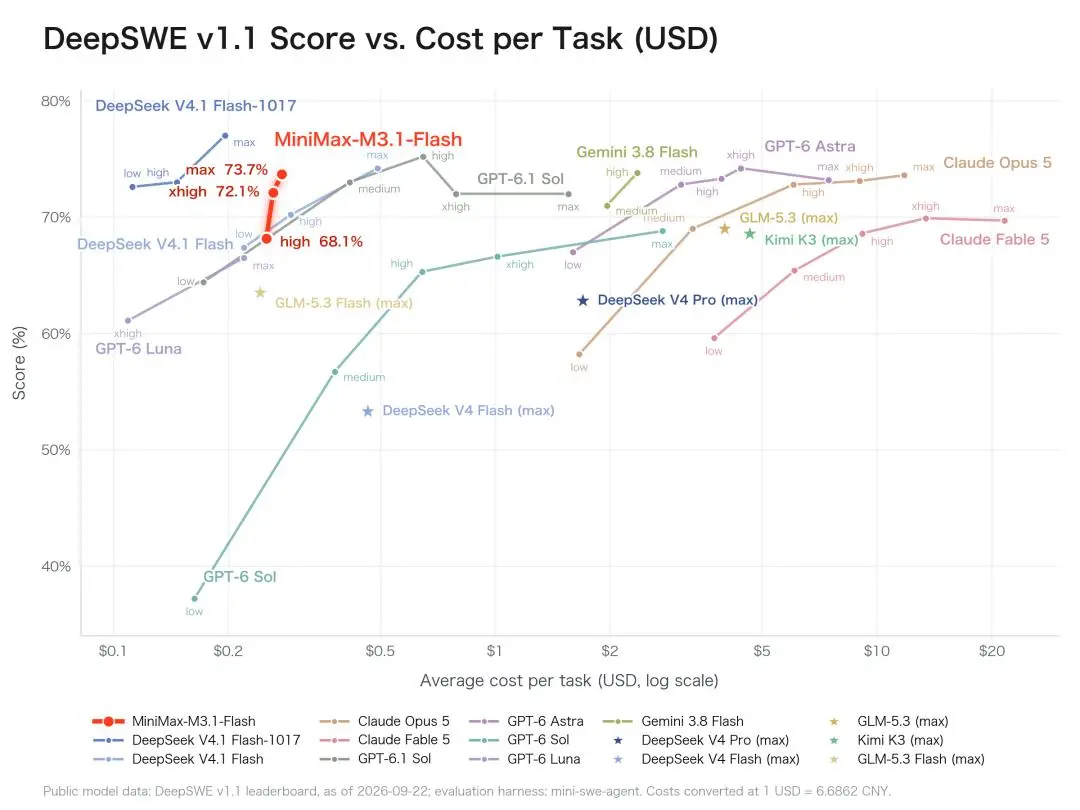
▲M3.1 Flash与其他模型的DeepSWE v1.1成绩及单项任务平均成本对比(图源:MiniMax)
API定价方面,M3.1 Flash的输入价格为每百万Token 1元,输出价格为4元,缓存读取价格为0.1元。
M3.1 Flash的非缓存输入、输出单价与V4.1-Flash-1017空闲时段持平,均为其高峰时段对应价格的一半;按国际API定价比较,M3.1 Flash的输入、输出单价分别约为Claude Opus 5的1/33和1/42。
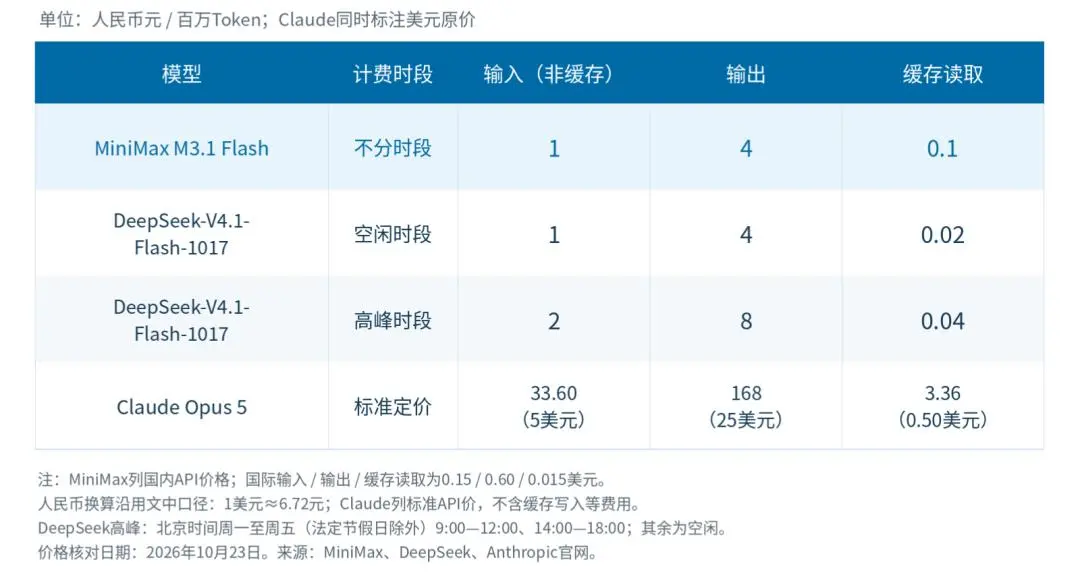
▲三款模型API对照(智东西制表)
此次开放权重后,开发者除通过MiniMax API、M Plan和MiniMax Code使用外,还可从Hugging Face、魔搭社区下载模型、自行部署。
Hugging Face 开源地址 :
https://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash
魔搭社区开源地址:
https://modelscope.cn/models/MiniMax/MiniMax-M3.1-Flash
01.对比3D动画与材质动效部分效果获评不输Opus 5.5
在开发者晒出的案例中,M3.1 Flash能够生成较完整的3D场景,纸张、布料等材质的动态表现也获得好评。
X上一位开发者晒出了一段用M3.1 Flash制作的3D动效短片。短片以胡萝卜造型的火箭开场,随后火箭展开,画面切换至立体的模型名称,再依次展示能力指标和价格信息。
火箭、文字和装饰元素都采用圆润的黏土造型,配色也保持统一。随着镜头推进,画面中的信息逐步展开,转场衔接较为流畅。
▲这位开发者用M3.1 Flash制作的程序化3D动效短片(图源:X)
这位开发者透露,这段作品由纯代码制作。他认为,其视觉质感不输Opus 5.5。
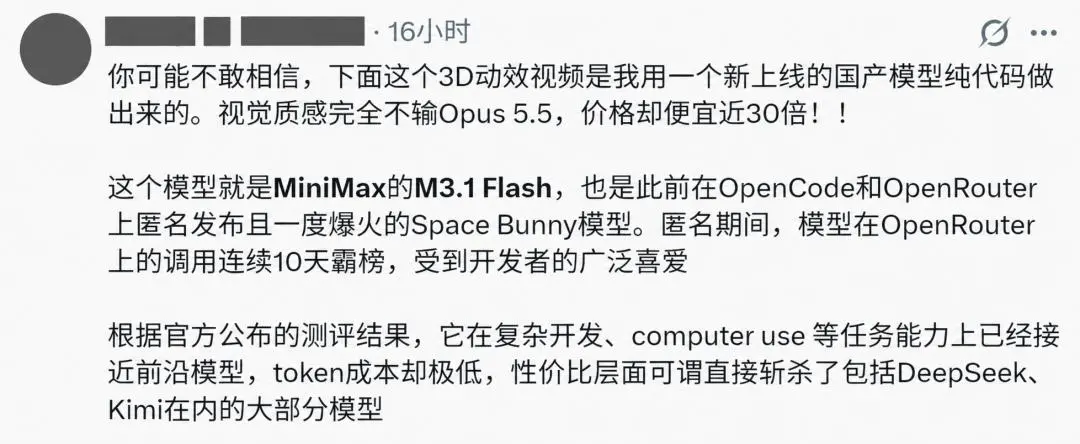
▲其对M3.1 Flash生成效果的评价(图源:X)
另一位X上的开发者测试了模型模拟材质变形的能力。其使用同一提示词,要求M3.1 Flash、DeepSeek V4.1 Flash、Claude Opus 5.5和GLM 5.3 Flash模拟纸张及弹性布料受力后的弯曲、起皱和变形。
案例中,M3.1 Flash生成的小票在弯曲时仍保持纸条形态,布料受力后出现局部褶皱;DeepSeek V4.1 Flash生成的物体在运动中则出现大块尖锐折面。
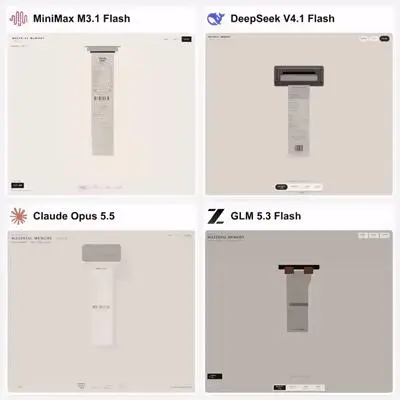
▲四款模型模拟纸张与弹性布料受力变形的效果(图源:X)
这位开发者认为,M3.1 Flash在这组案例中表现最好,布料纹理细腻、变形平滑。相比之下,Opus 5.5生成的画面光照和构图不错,但纸张显得过薄、过软;GLM 5.3 Flash生成的纸张偏硬,布料纹理存在重复。
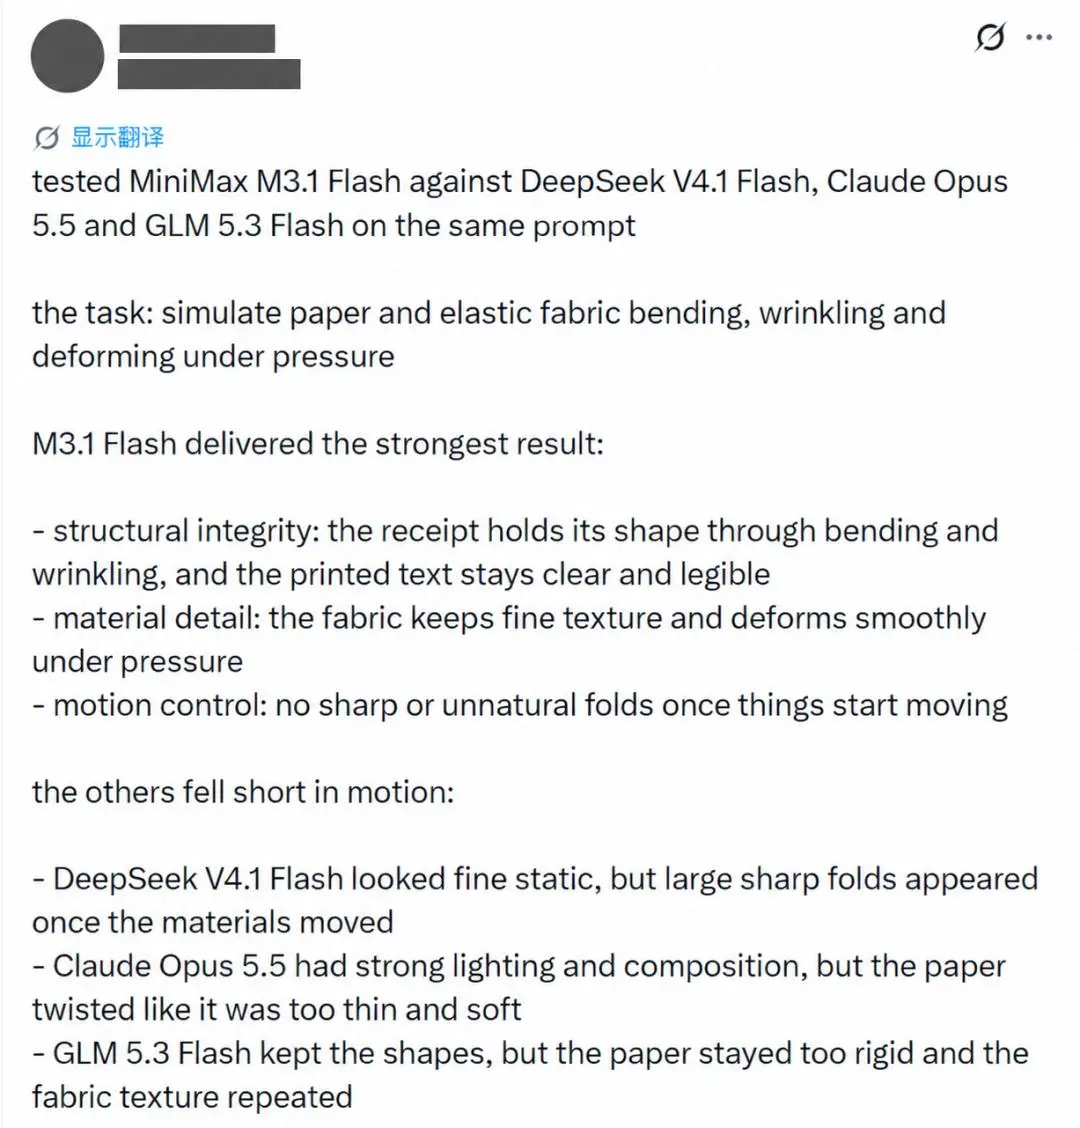
▲其对四款模型的材质模拟效果进行评价(图源:X)
智东西此前也对M3.1 Flash进行过实测,该模型能够完成较复杂的动画和交互页面,部分效果可与Opus 5.5媲美。颠覆刻板印象!Flash模型卷前端,效果硬刚Opus 5.5
02.三项优化提升推理效率智能体任务成本降70%
如前所述,据MiniMax透露,相较上一代M3,M3.1 Flash的线上推理速度提升近3倍,智能体任务的综合使用成本降低70%。在此次开源公告中,MiniMax进一步披露了三项具体优化。
首先是全模型稀疏注意力。团队将原先保留的前三个全注意力层替换为稀疏注意力层,进一步减少注意力计算开销。
其次是量化感知训练(QAT),即在训练时考虑低精度计算带来的误差。除共享专家外,混合专家(MoE)架构中的路由专家均采用W4A4格式,权重和激活值以4比特表示;稀疏注意力索引器和主分支则从Q8KV8调整为Q8KV4,进一步降低KV缓存精度,减少存储和访存开销。
硬件调度方面,团队采用功耗感知调度(Power-aware scheduling),通过精细分配计算卡功耗,提高硬件利用率。据MiniMax此前披露,M3.1 Flash在日常使用场景下的输出速度可达每秒200多个Token,中位数达到每秒170多个Token。
03.结语:开放权重扩大应用适配与部署成本成竞争重点
目前,MiniMax的模型产品线包括面向编程、智能体及多模态理解的M系列、面向视频生成的H系列,以及语音Speech和音乐Music系列。M3.1 Flash属于M系列,主打效率与能力的平衡。据MiniMax披露,其后续将推出追求更高能力上限的Pro版本。
M3.1 Flash已凭借较低定价和部分任务中的表现获得开发者关注。此次开放权重后,开发者可以自行部署模型,芯片厂商、云平台和社区也能参与适配、优化和二次开发。
对其而言,开放权重只是扩大应用的开始。开发者自行部署后,还要考虑硬件投入、运行速度和维护成本。开源模型的性价比,也需要通过芯片适配和推理优化转化为自行部署时的成本优势,在实际运行中展现。
来源:MiniMax、X
本文来自微信公众号 “智东西”(ID:zhidxcom),作者:孙小雯,36氪经授权发布。