在企业网 D1net 主办的 2026 秋季央国企 CIO 及数科公司高管峰会(第 19 届)上,硅基流动解决方案总监唐安波出席峰会并作主题分享:《从“算力”到“Token 生产力”:央国企大模型规模化落地的推理基础设施与 ROI 实践》。以下为分享内容精华。
当下,AI 应用正处于爆发式增长的早期阶段,Token 消耗量呈指数级增长。这背后,模型架构持续演进,版本更新节奏快速;同时,算力架构也在不断演进。模型与算力之间,是相互推动的迭代过程。对于企业来说,一方面要适配这些变化,另一方面又要面向自己的业务场景提供多元化模型服务,还要把成本控制在合理范围内。
硅基流动在做的事,就是打通从算力到 Token 之间的转化层:把算力统一纳管起来;通过自研推理引擎,让模型跑得更快、更好。我们既在公有云端建设 Token 工厂,也帮助央国企在内部打造自己的 Token 工厂。
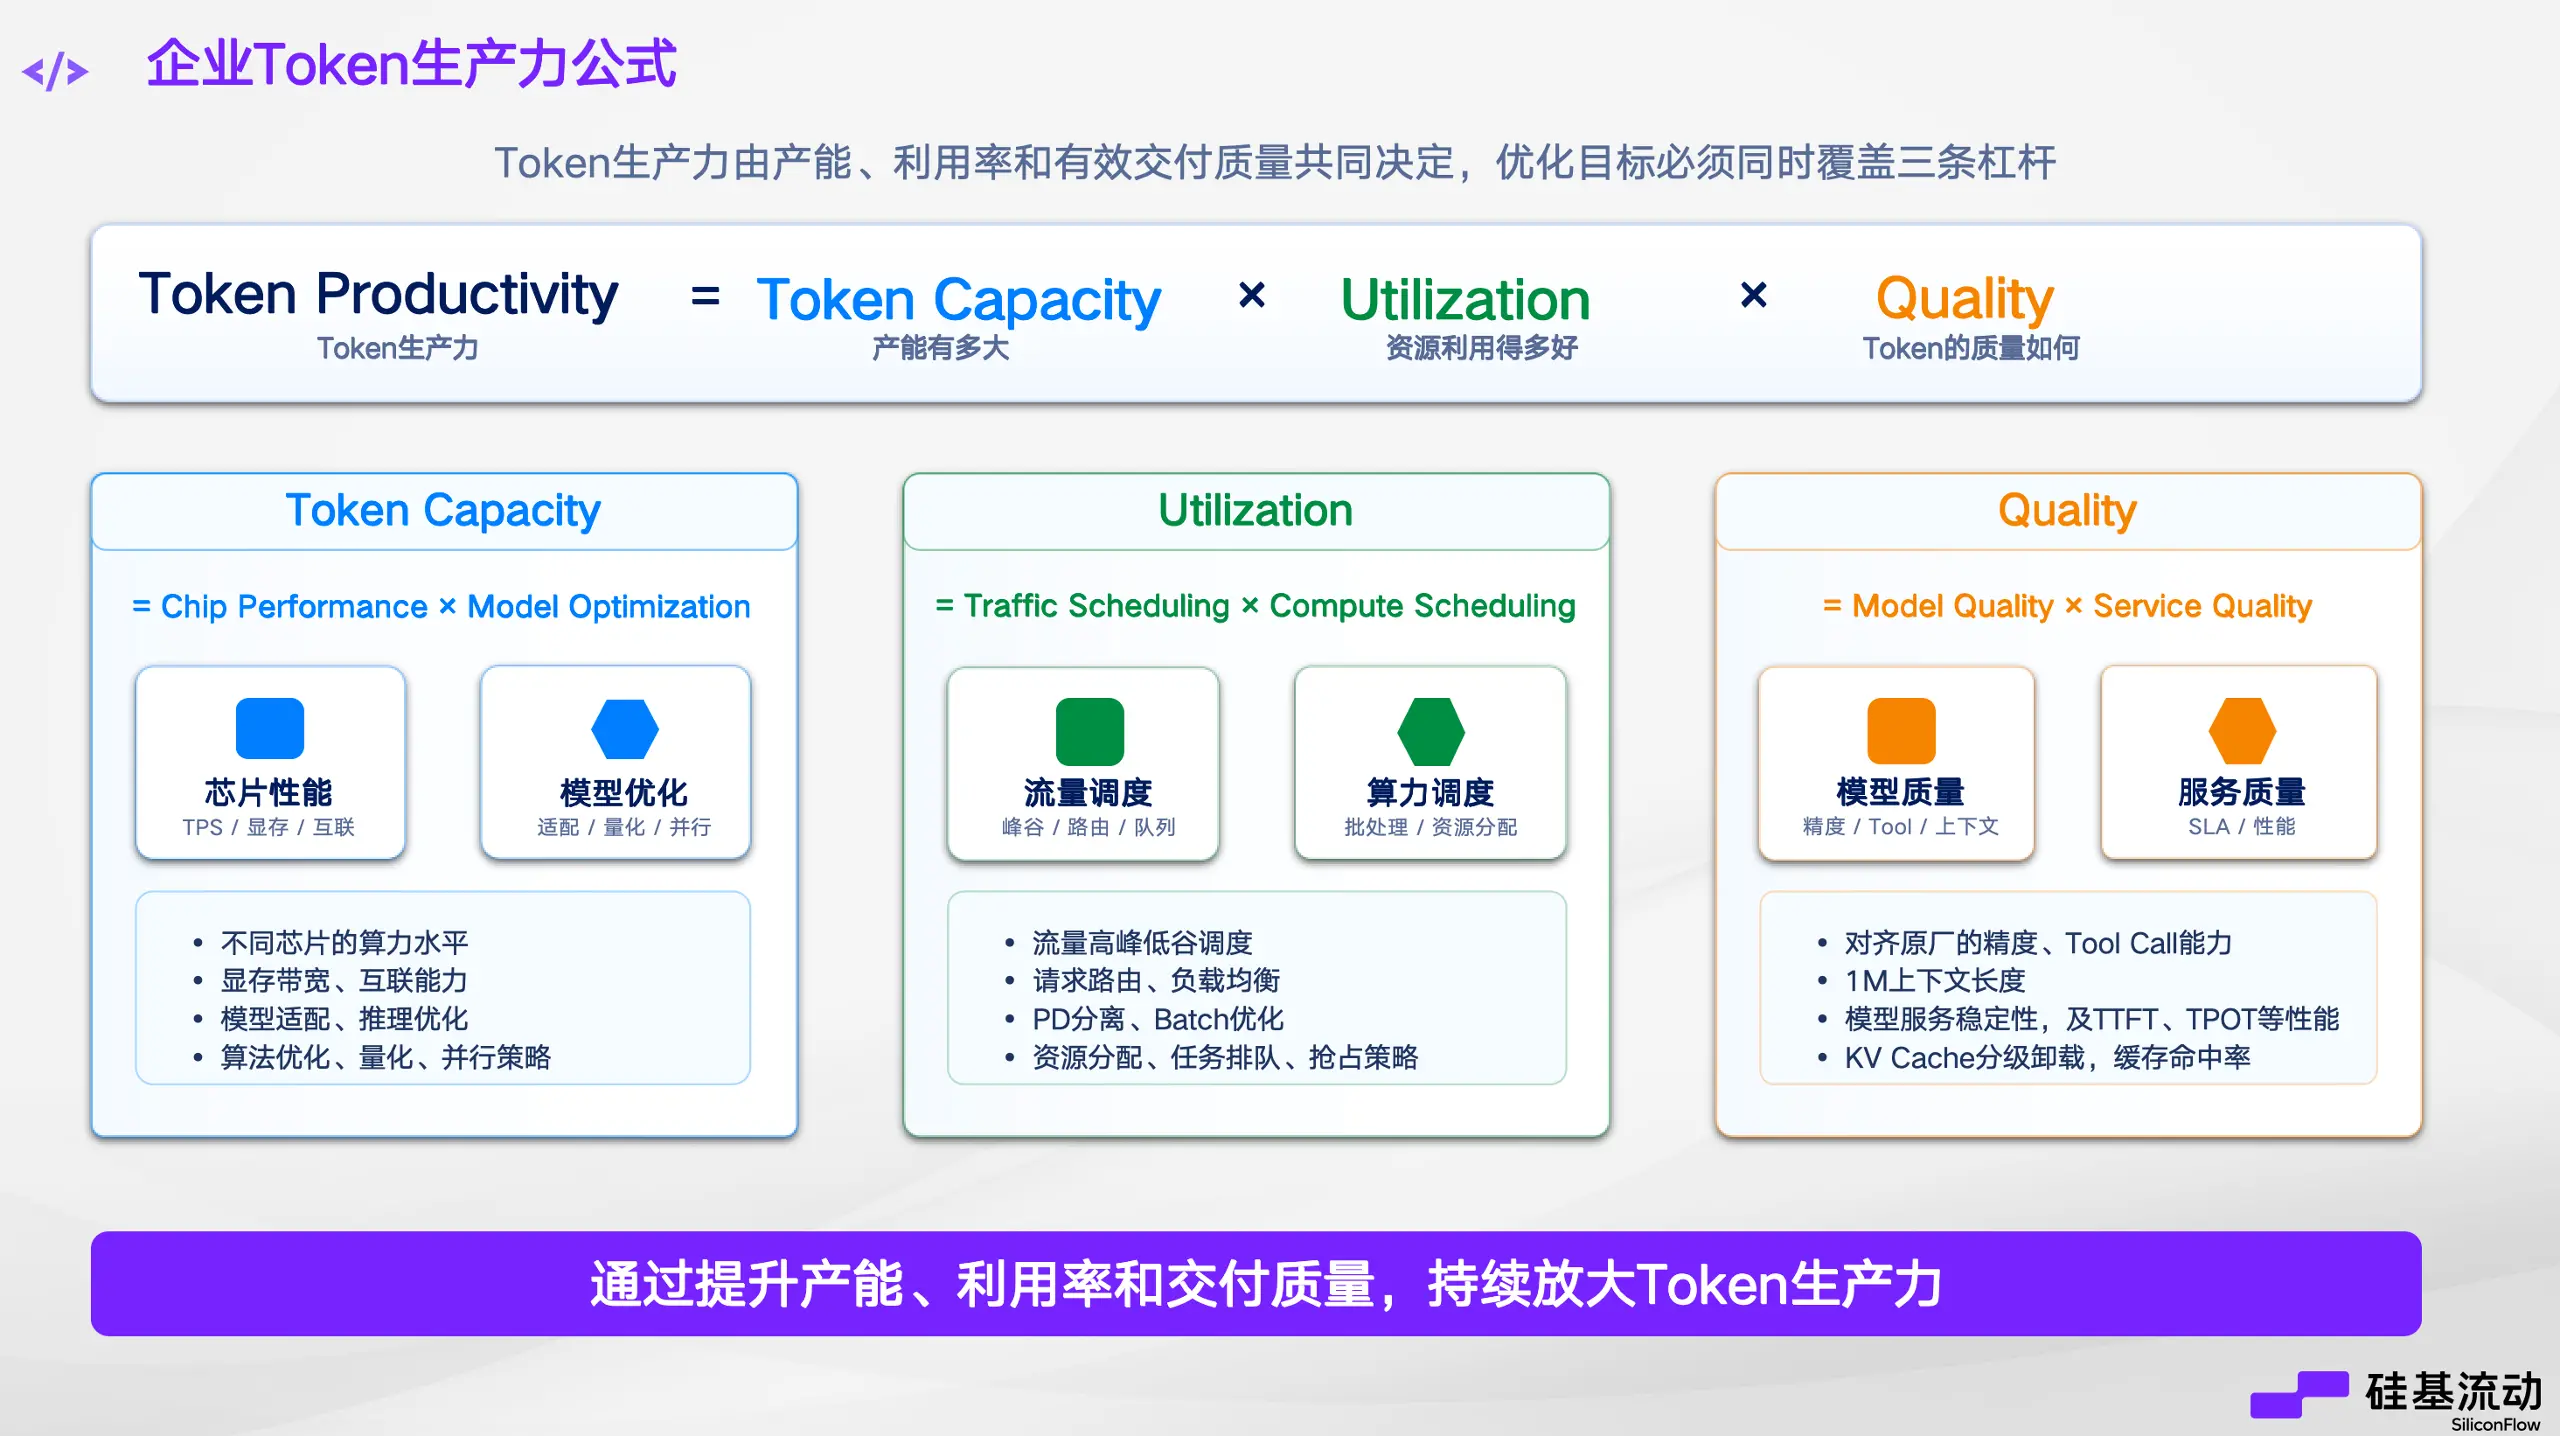
简言之,通过系统化的推理工程,做好模型与算力的多重适配。基于此,硅基流动提出 Token 生产力核心公式:Token 生产力 = 产能 × 利用率 × 交付质量。其中,产能由芯片硬件能力、模型优化水平共同决定;利用率依靠流量治理与算力智能调度实现;交付质量包含模型推理精度、工具调用等任务执行成功率,以及生产环境必备的 SLA 服务稳定性。
从统一纳管到模型运营,把算力利用率真正做起来
我们从业务和流量的视角,设计了四层解耦架构。把模型运营、模型运维、推理执行与算力调度连接起来,覆盖一个模型从部署、加速到服务调度等全生命周期的各个环节。分层解耦的架构设计,也是为了适应央国企已有的平台建设情况,避免重复建设;如果企业已有自研能力,可结合已有系统对接,不必推倒重来,即可以“能力组合”的方式直接补齐所需能力。
模型网关:不仅是入口,也是模型运营平台。
这一层直接面向模型服务的使用方,如各地分子公司及下属集团。所有大模型调用均经由该层完成计量、计费、鉴权等基础工作。更重要的是,它还提供丰富的调度与路由策略:如可根据不同业务场景对响应时间的要求,将请求路由至相应的模型服务,实现业务间互不影响,确保各方获得满意的 SLA;同时也支持按性能优先、成本优先等不同目标进行灵活调度。
模型服务平台:把部署与运维的最佳实践交付给企业。
这一层主要从运维角度管理模型上下架、模型仓库等能力。我们会把模型部署的最佳实践放进去,让企业能够一键拉起模型,而不是每次重新做适配。我们已经适配了近百款模型,新的主流模型持续适配,目标都是让业务团队能够开箱即用。
高性能推理框架:面向具体模型与硬件的优化迭代。
我们与不同算力厂商开展深入合作,围绕具体模型与算力,自研算子库、通信库,尽可能释放模型在对应硬件上的性能。例如,与华为云合作,在业内首次推出基于国产芯片的 DeepSeek R1/V3 Token 服务,并共同为 CloudMatrix 超节点集群开发并优化推理解决方案,在 DeepSeek-R1 上实现单卡 Decode 吞吐量超过 1,920 tokens/s;全球首发基于沐曦曦云 C550 集群的 Kimi-K2 大模型商业化服务部署;在摩尔线程 MTT S5000 芯片上部署 DeepSeek-V3,实现单卡 Prefill 吞吐超过 4000 tokens/s、Decode 吞吐超过 1000 tokens/s。
同时,我们的推理技术也在持续演进:随着模型处理任务的上下文不断增长、并发持续提升,需要持续地对推理框架进行优化,如算子优化、通信优化、模型量化等,同时结合 PD 分离以及 KV Cache 分级卸载等手段,全面提升模型推理的整体性能与吞吐能力。
算力调度:算力资源弹性管理。
弹性灵活的算力调度是降低推理成本、提升算力利用效率的关键要素。但算力规划常常面临两难:估得过于保守,可能很快满负荷甚至过载;完全按白天峰值配置,又会在其他时段造成资源浪费。因此,既需要弹性扩缩容策略,也需要运营手段配合。
例如,央国企面向各分子公司提供模型服务时,可在内部结算中采用分时定价:白天按常规定价,夜间给予折扣,引导部分业务在夜间运行。各业务可能使用不同模型,这就要求平台能够基于请求队列、性能等多维度指标动态调整模型实例。
央国企案例:从“租机器”转向“调用模型服务”
我们服务过一家央国企集团,原来有大约 50 台机器,向下属分子公司提供服务。早期的服务方式很直接,各分子公司来申请机器,部署自己要用的模型,说白了,是在“租机器”。
这样一来,模型实例开了四五十个,但整体算力利用率很低。有的单位占用机器后,只部署一个模型;有的白天用、晚上不用;还有的每周只用几天。机器被占住了,却没有持续产生有效负载。
我们和客户深度协同,针对以上现状进行重构:模型统一,算力统一。把重复模型收敛到大约十个;把按机器分配资源的方式,改为 Serverless 模型服务,大家统一调用 API,不再关心模型具体部署在哪里、占用了哪台机器。
这样,同样约 50 台机器,就能做更多事情。例如,用部分机器承载原有的一些小模型后,可以腾出多台机器来部署新的大参数模型,比如 GLM-5.2、DeepSeek-V4-Flash-0731 等。过去,这类模型在集团内部是没有条件运行的。但事实上,大参数的新模型对业务探索非常重要,因为模型智力的上限,也决定了应用创新的上限。通过模型收敛和算力集约化管理,我们把这些模型部署了进去,再结合性能优化,让更多场景从“不可用”变成了“可用”,从“可以探索”走向“可以放量”。
原来,业务侧最大的担忧是:做探索、做一个 Agent 没问题,但能不能规模化上线?能不能承接更多调用?大家心里是有问号的。新模型上线以后,在单并发到较多并发的测试中,输出速度综合下来基本保持在 30 tokens/s 以上。以编程为例,超过 30TPS 是获得较好使用体验的基础要求。在相同模型的对比测试中,我们取得了40%~100% 的性能提升。当然,这取决于不同的输入、输出长度,具体收益并不相同。
整体上,一是模型吞吐能力提高了,二是算力利用率提高了。两方面叠加,最终反映在每百万 Token 的成本上,这是一个很多企业会用来衡量推理服务效率的指标。在这个案例中,原先一个 Qwen 模型的每百万 Token 成本在一百多元,调整后降到了十元以下。成本下降明显,但最关键的,还是打开了更多原本难以落地的业务场景。
进一步提升 ROI,应用与基础设施共同优化
随着 Agent 规模化落地,我们也观察到一个问题:应用层与基础设施层之间,存在一定脱节。过去做应用程序,即使主要负责前端,开发者通常也会对数据库索引、SQL 优化有一些理解。现在,大模型应用与基础设施的分层比较明显,应用侧未必充分理解底层推理与缓存机制,而这会直接影响效率。
以 Coding 为例,我们正在与客户共同探索这方面的优化。央国企的软件工程,不是今天写一个 App、明天再做另一个演示,而是要在多年里持续迭代。代码仓库会不断更新,每天提交代码、进行构建,都是长期工程的一部分。这些代码怎样构造为模型的 Context,非常关键。
如果上下文构造不好,每次请求都无法命中缓存,动辄数十万 Token 的输入,会消耗大量算力。但如果构造得好,其中约九成的内容可能命中缓存,效率差距就体现出来了。举例来说,在不命中缓存时,系统可能支持 100 个并发;提高缓存命中以后,可能支持 200 个并发。这个提升并没有增加硬件,而是减少了重复计算。因此,Context 构建本身,就需要面向推理进行优化。
另一个方向,是结合 DevOps 做优化。算力使用有波峰波谷,白天大家都在用算力,而 Coding 场景的输入又很长。如果所有代码都等到白天发起请求时才处理、再生成缓存,就会占用大量高峰时段的算力。那么,能不能在每天晚上的日常构建过程中,通过工程化手段,让模型对代码仓库进行预处理,把相应计算结果预先存入 KV Cache?这样,白天就不必重复计算。这些方式,都有机会进一步提高算力利用率。但这部分能力,也依赖我们与场景方共同探索。
硅基流动希望与央国企一起,探索更多 AI 落地场景,把真正的算力和产能释放出来。
雷峰网 雷峰网