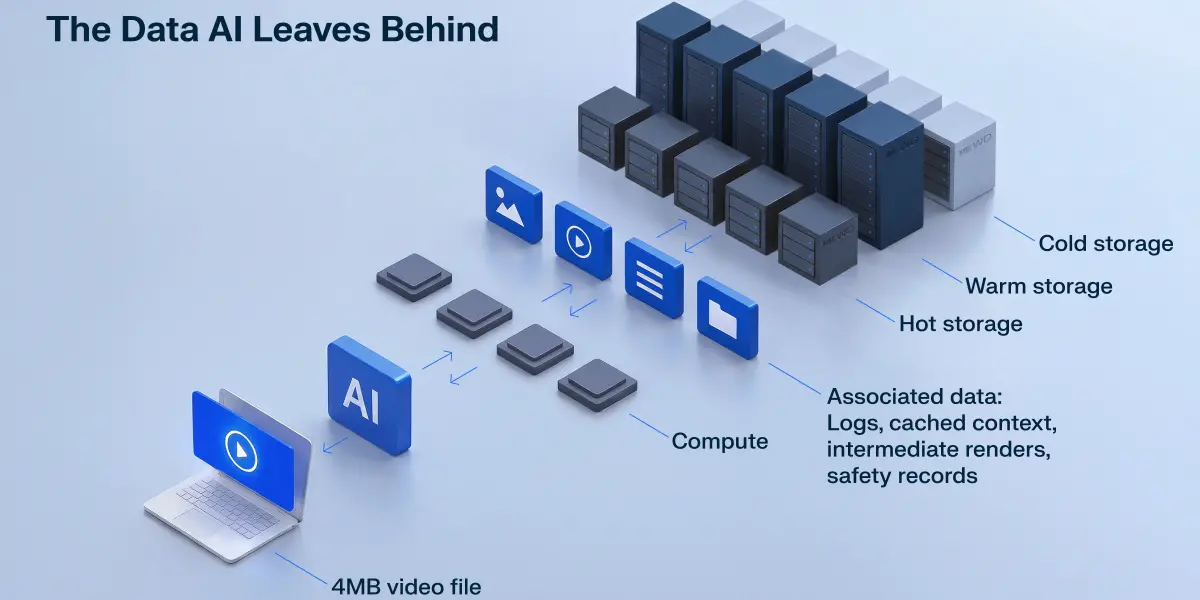
编者按:当AI预算被GPU、电力和芯片供应占据时,推理产生的数据正在悄悄变成第二张账单。存储成本不是一次性支出,而是随每一次调用累积的长尾成本。
MIT Technology Review文章指出,多数高管在想象AI成本时,看到的往往是GPU机架、吉瓦级电力和芯片等待名单。这幅图景并没有错,但它遗漏了后端的另一条成本曲线:数据存储。模型给出回答之后,数据并没有消失。每天数十亿次提示、生成的图像和视频,以及围绕推理产生的日志、缓存和审计记录,都需要被写入、保留、索引、检索,甚至长期归档。
推理结束,数据才开始
一次模型响应看似结束于屏幕上的答案,但在后端,系统通常留下大量数据:用户输入和模型输出、上下文缓存、调用日志、向量嵌入、多模态文件、内容安全记录、模型版本信息和评估样本。对于文本应用,单次请求的数据量或许不大,但乘以每天数十亿次调用,规模就会迅速膨胀;对于图像、视频和音频应用,单个文件可能达到数十MB甚至更大,存储压力更明显。
与传统业务数据不同,AI推理数据具有生成速度快、结构多样、生命周期模糊等特点。很多团队在上线初期只关注模型效果和响应延迟,直到存储账单逐月攀升,才发现日志、副本和旧版本数据已经分散在对象存储、数据湖、向量数据库、搜索系统和备份系统中。GPU账单通常集中且可见,存储账单却碎片化地藏在多个服务里,因而更容易被低估。
为什么存储账单被低估
首先,AI基础设施的讨论长期围绕训练展开。训练需要大规模算力和电力,成本显性;推理则随使用量增长,存储成本更像长尾支出,单次看似便宜,累积后却不可忽视。其次,存储按量计费、分层计价,热存储、冷存储和归档存储的价格差异很大,但检索延迟、API调用和数据迁移也会产生费用。第三,许多企业缺乏清晰的数据保留政策,默认“先存下来再说”,导致重复数据、过期日志和无人访问的资产长期占用空间。
“最贵的不是把数据存下来,而是不知道为什么要存、该存多久、谁会读取。”
向量数据库进一步放大了这一问题。为了让模型具备检索增强能力,企业需要存储嵌入向量和索引结构,部分索引还会占用内存或高性能存储。多模态应用则带来图像、视频和音频资产,文件体积大、元数据复杂,且往往需要生成缩略图、转码副本和内容审核记录。若缺少统一治理,同一份内容可能在多个系统中重复保存。
从“能存”到“会存”
企业需要把AI存储纳入FinOps和数据治理框架。第一步是成本归因:按团队、应用、模型和租户打标签,区分热数据、温数据和冷数据,识别高成本但低访问的数据集。第二步是生命周期管理:为提示日志、输出内容、向量索引和多媒体资产设定差异化保留策略,自动删除过期数据,减少不必要的副本。第三步是技术优化:通过压缩、去重、日志采样、索引裁剪和分层存储降低单位成本,同时保证关键业务的检索延迟和合规要求。
更重要的是,企业应在AI应用设计阶段就回答几个问题:哪些数据必须留存,哪些可以即时丢弃;哪些用于审计,哪些用于产品改进;哪些需要在线检索,哪些可以归档。存储不是推理系统的附属品,而是AI成本结构的一部分。随着生成式AI从试点走向规模化调用,隐藏的存储账单会逐渐显性化。提前建立可观测、可分层、可治理的存储策略,比事后压缩预算更有效。
本文编译自MIT Technology Review
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接