引言
Reflection 的 Beam 是一款 501B 参数的混合专家(MoE)模型,每 token 激活 23B 参数,专为软件工程与长时程智能体任务打造。SGLang 已原生支持 Beam,并为其生产 API 提供高性能推理服务。
亮点概览
- Beam 1.0 501B-A23B:采用滑动窗口与全注意力混合的解码器-only MoE,256 个路由专家,top-8 选择,原生支持 1M token 上下文。
- 检查点支持:BF16、ModelOpt NVFP4 及 compressed-tensors 动态 FP8。
- 服务特性:DFlash2 推测解码、radix 缓存与 HiCache、分块预填充、CUDA 图、TP/EP/PP 及注意力数据并行。
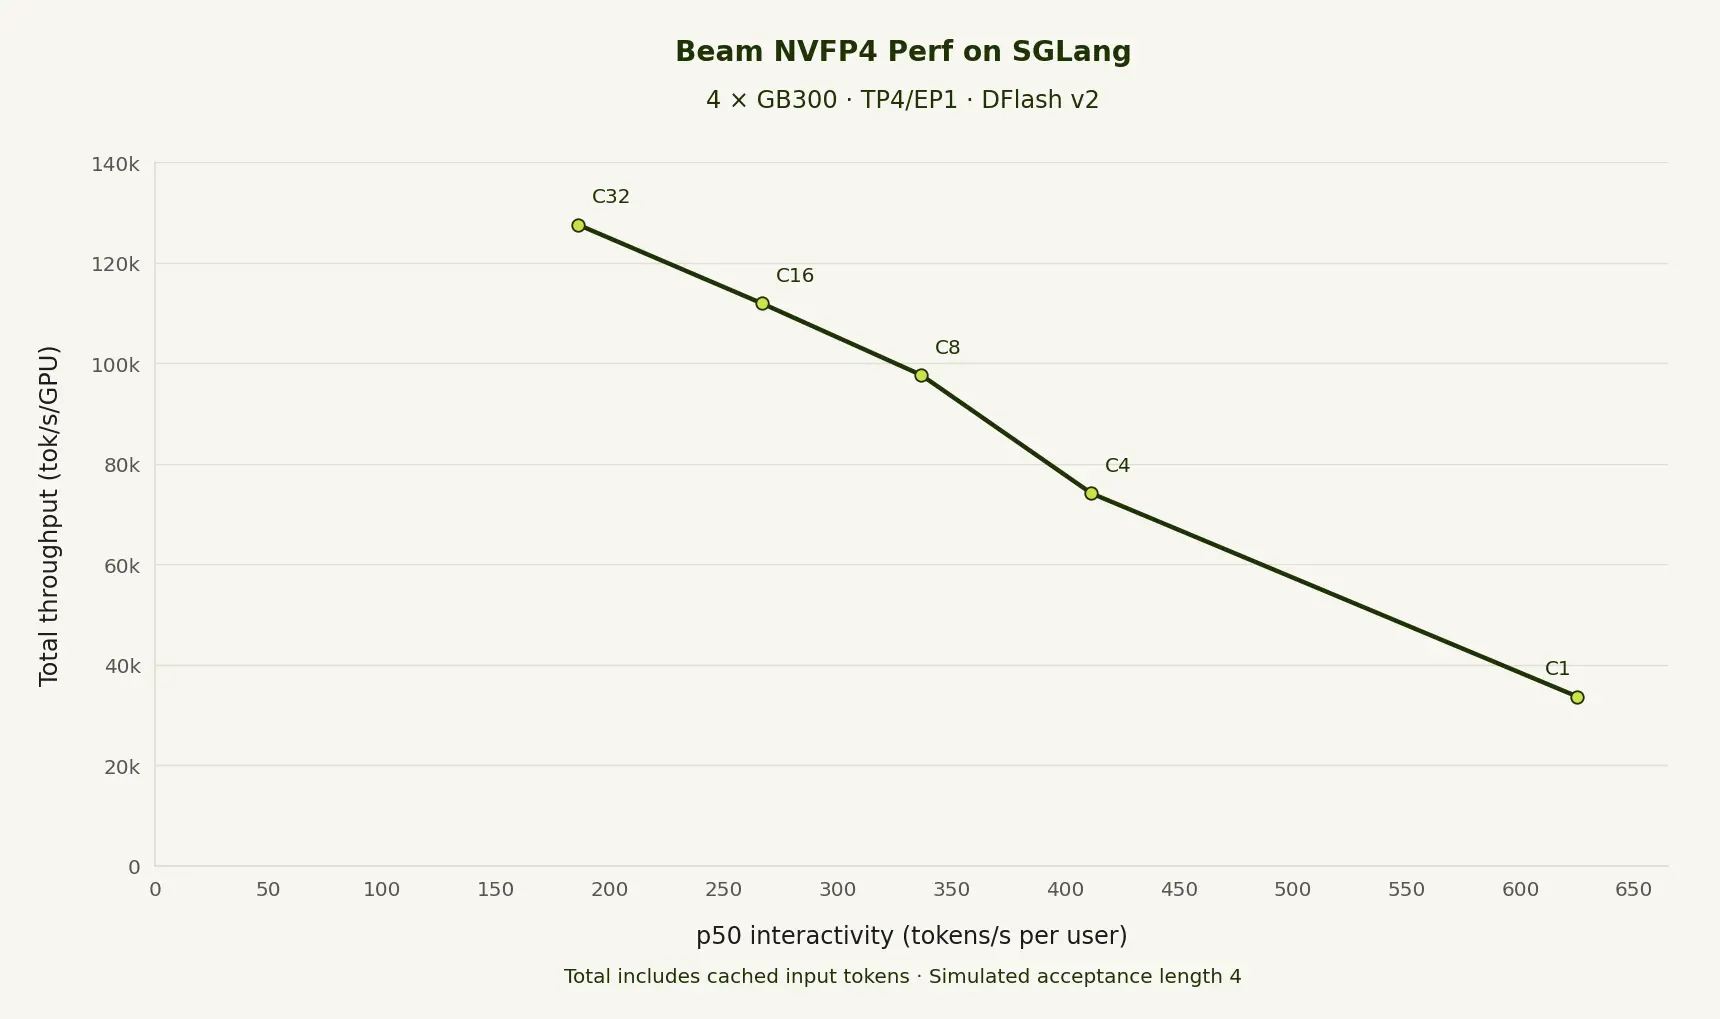
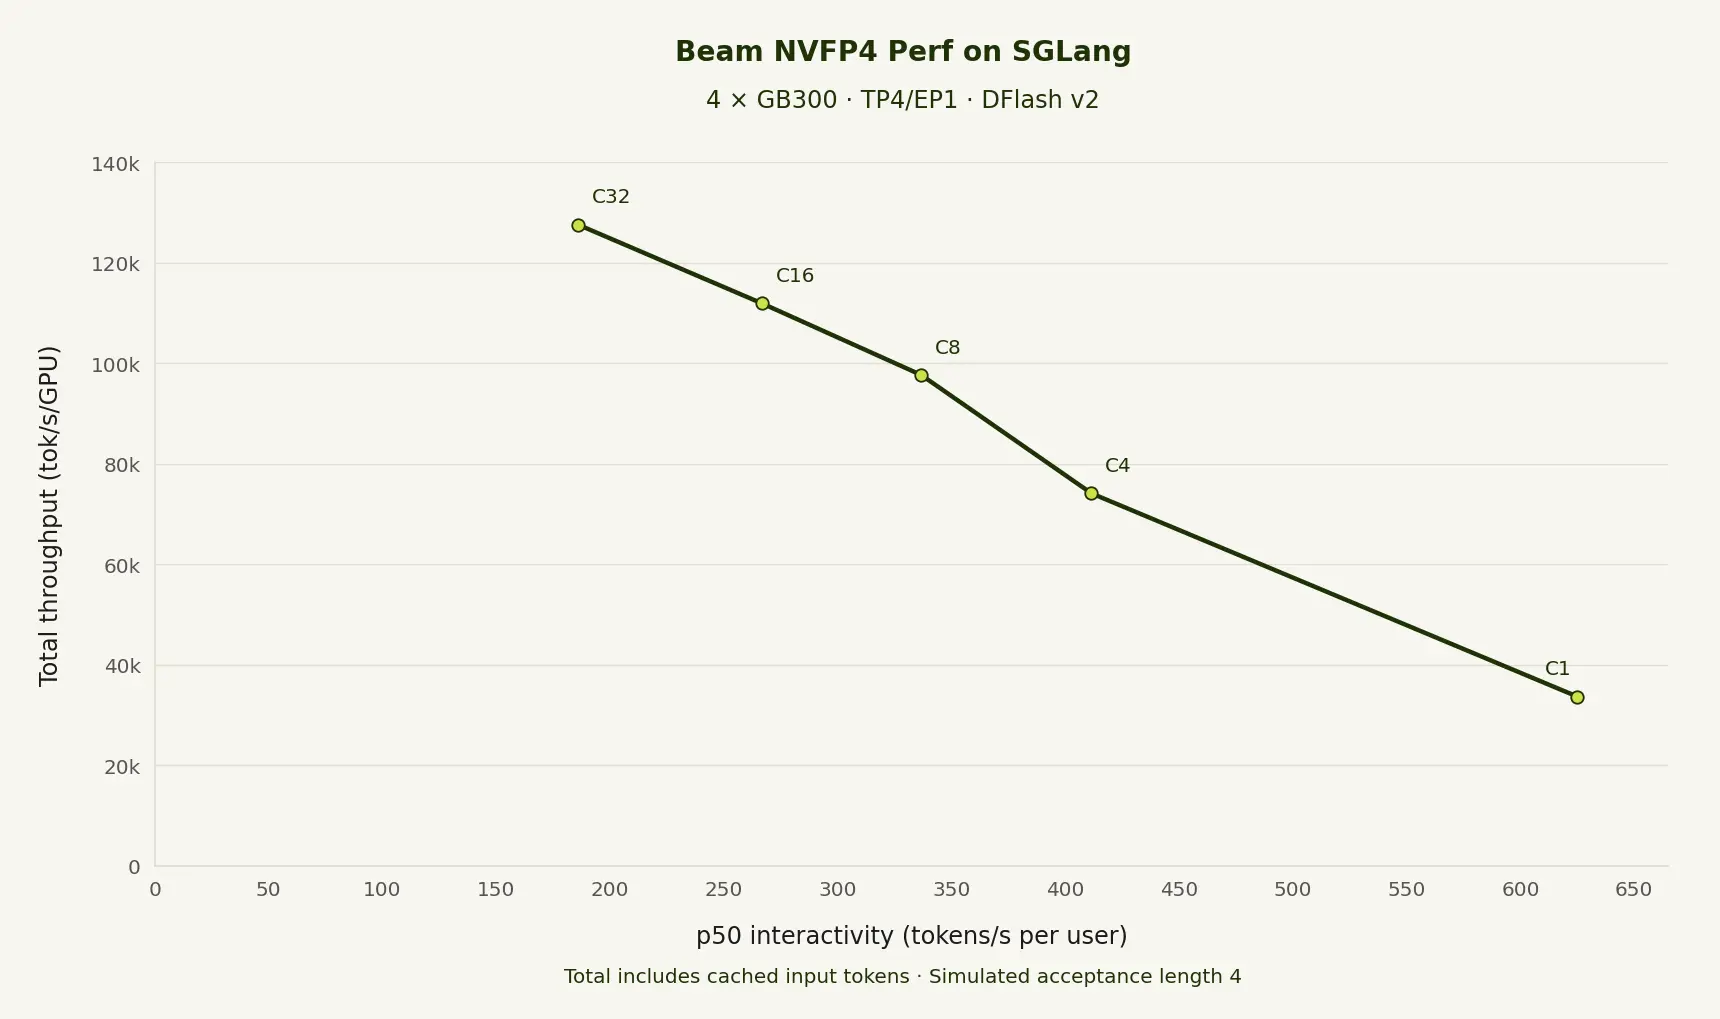
- 性能表现:在 4 张 NVIDIA GB300 GPU 上运行 NVFP4 检查点,OpenHands 多轮智能体编码回放任务中,SGLang 达到每 GPU 127.6K tokens/sec 总吞吐,p50 交互性 185.87 tokens/sec(并发 32)。
模型架构
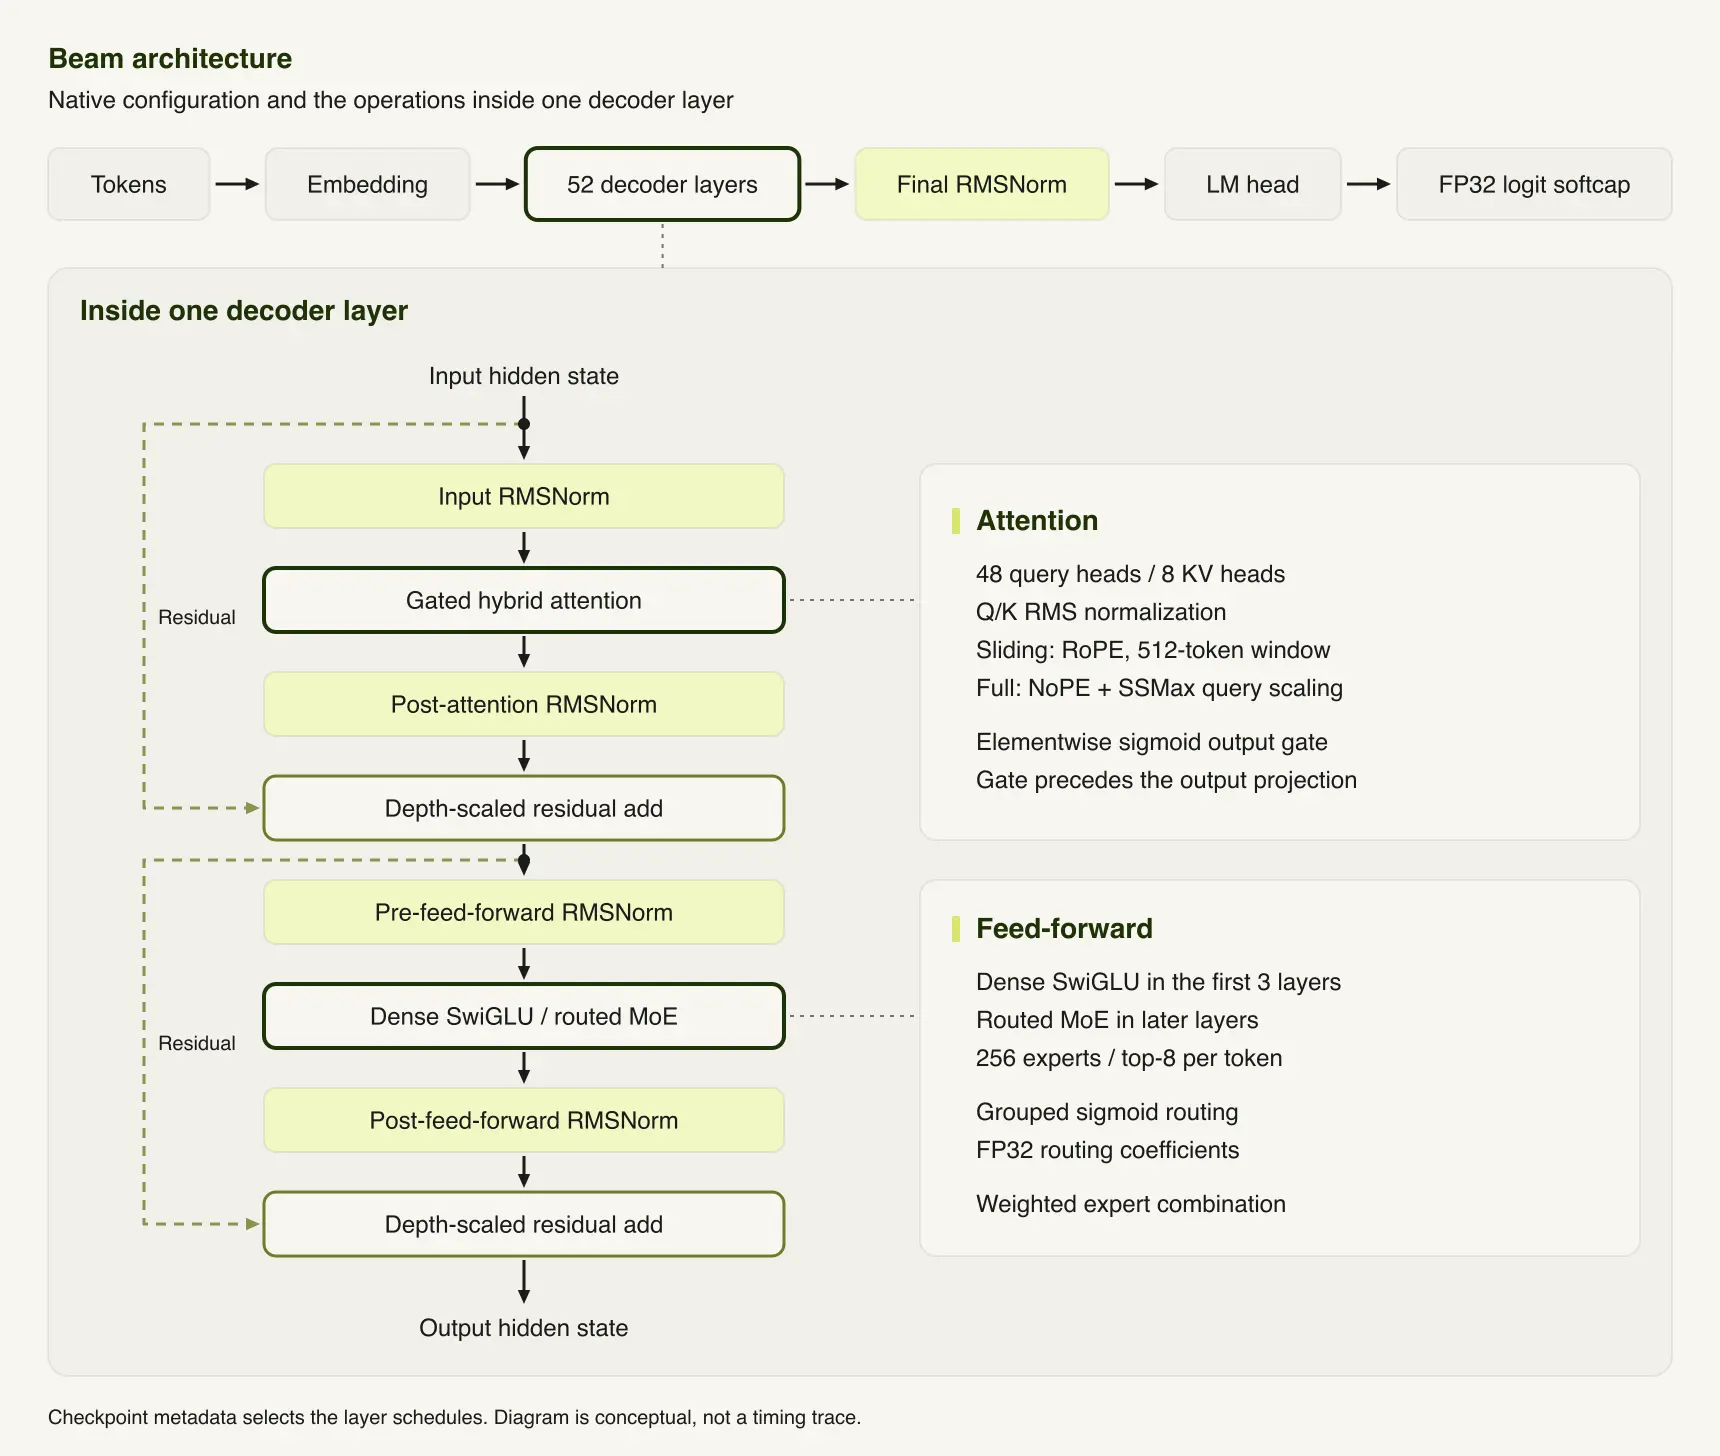
Beam 结合分组查询注意力(GQA)与滑动窗口/全注意力混合层。前馈网络先使用密集 SwiGLU 层,随后切换至路由 MoE。注意力输出经过门控后再投影,并采用三明治归一化与深度缩放残差连接。
混合注意力和输出门控
48 个查询头共享 8 个 KV 头,显著降低 KV 缓存占用。滑动窗口层限制历史长度,全注意力层使用 SSMax 缩放以保持长上下文注意力聚焦。
密集层与分组 MoE 路由
前三层为密集 SwiGLU,后续层从 256 个专家中选 8 个。路由器以 FP32 计算 logits,并使用专家修正偏置。
功能支持
DFlash2 推测解码与注意力数据并行
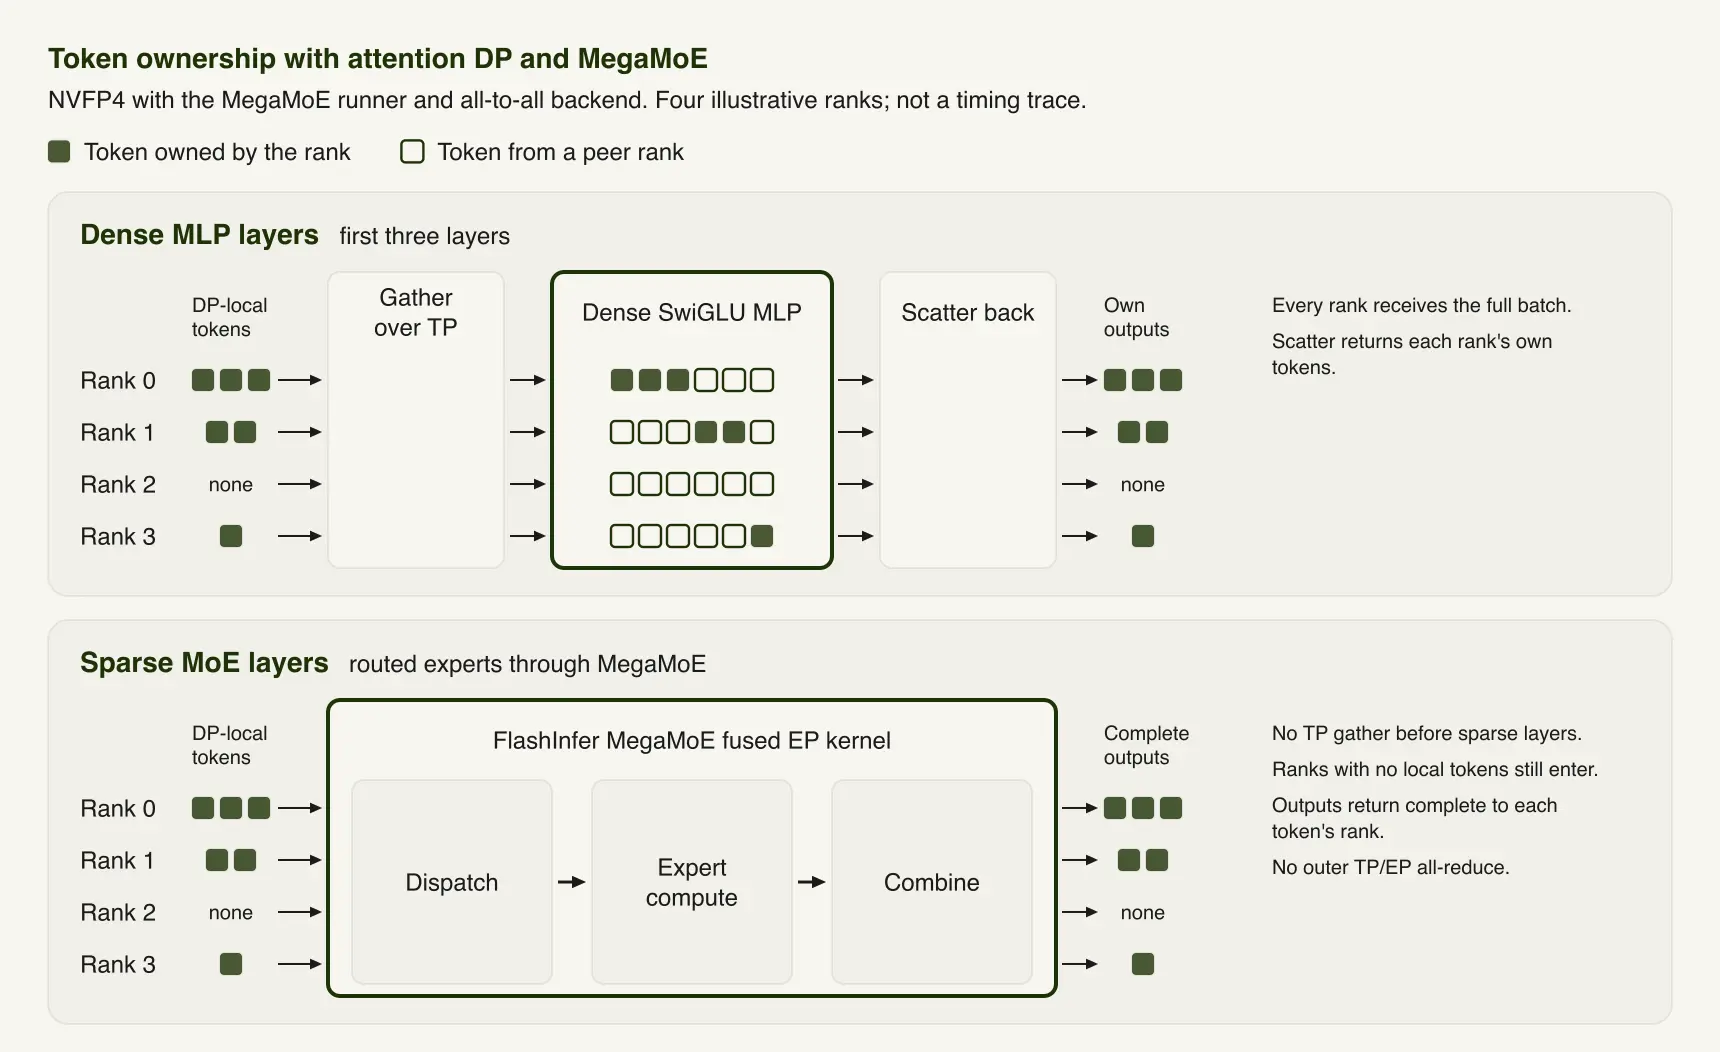
SGLang 通过 DFLASH runtime 支持 DFlash2,结合注意力数据并行实现高效验证。统一 KV 内存池同时管理目标与草稿 KV 缓存。
异构 TP 用于预填充/解码解耦
通过 NIXL 与 Mooncake 实现预填充与解码阶段不同 TP 大小,并完整保留全注意力与滑动窗口 KV 状态。
推理、工具调用与 LoRA
SGLang 自动解析 Beam 检查点响应模板,支持流式与非流式请求中的推理、答案与工具调用分离,同时兼容 BF16 LoRA。
多精度模型支持
完整支持原生 BF16、动态 FP8 及 NVFP4 检查点,并通过 FlashInfer MegaMoE 提供专家并行加速路径。
性能实测
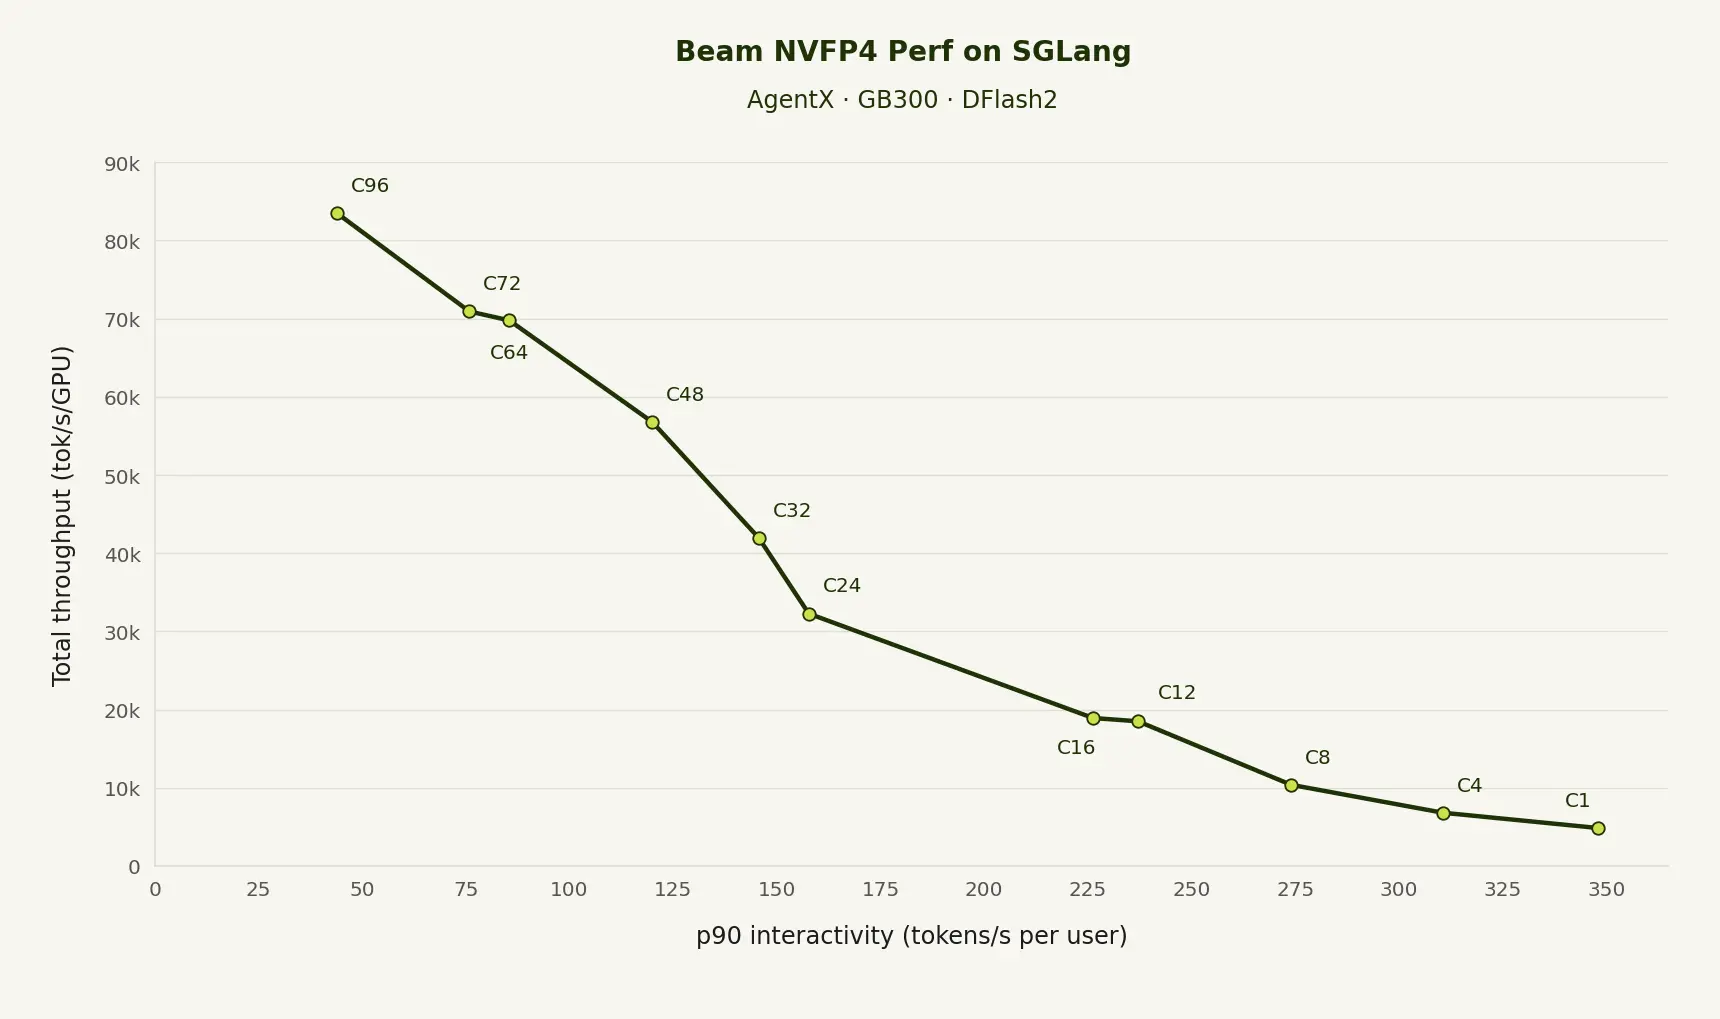
在 GB300 平台上,NVFP4 版本 Beam 在 OpenHands 与 AgentX 任务中展现优异吞吐与交互性平衡。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接