“它连一句话都不会说,凭什么刷屏?”
就在这几天,一个叫Jev的新模型彻底火了。外网3500万人围观,Vercel AI Gateway上线24小时内,近13%的付费团队直接采用,创下该平台历史最快纪录;开发者社区两天内冒出至少6个克隆项目,围绕它搭出的开源项目迅速冲到600多个。
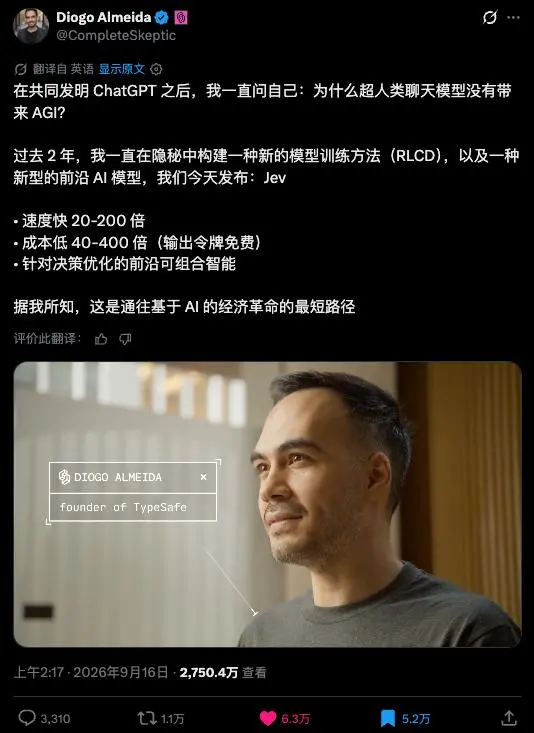
但比数据更刺激的,是它创始人一个月前的一句挑衅。迪奥戈·阿尔梅达,前OpenAI核心研究员、RLHF和InstructGPT论文共同作者,早在Jev发布前一个月的一场演讲中,就公开向整个行业泼了一盆冷水:Claude Code依然属于“协助时代”的产物,下一个时代一定不是Claude Code时代。
要知道,过去两年,Claude Code几乎被当成AI编程和Agent落地的标杆。当时TypeSafe还没公开任何产品,这句话听起来像是一句狂言。一个不会聊天、不写代码、只做判断的模型,凭什么敢挑战这个共识?
它不聊天、不写代码、不生成任何自然语言。它只会做一件事:判断。
这就有三个问题:Jev到底是什么?为什么它偏偏在此时爆火?以及,它凭什么让创始人敢定义下一个时代?
不会写字的AI, 凭什么让全球程序员玩疯了?
先看Jev到底能干什么。
首先,它砍掉了大模型最引以为傲的能力——生成文本。 你给它一段状态描述,再给它几个提前定义好的问题,它不返回小作文,只返回结构化的选择、评分和概率。它原生支持三种输出:Choice,从你定义的列表里选一个;Score,把输入映射到有序等级;Noul,返回一个是/否的概率值。每个答案都带置信度。
其次,它快得不像大模型,便宜得也不像大模型。 官方数据显示,Jev端到端延迟70到500毫秒,在特定工作流中比传统大模型快20到200倍,成本低40到400倍。每百万输入Token仅0.042美元,输出Token完全免费。有开发者用它过滤X上的引战内容,平均380毫秒判断一次;有人让它同时跑50局《地铁跑酷》,费用不到1美分;有人拿它清洗积压三个月的数据,13分钟跑完,账单32美分。
最后,它真正颠覆的地方不是快,而是“校准”。 Jev用了一套叫RLCD的训练方法,全称“面向校准决策的强化学习”。简单说,它不仅要选答案,还要让“我有90%把握”这句话真的接近90%。置信度高于0.9,代码自动执行;0.7到0.9,交给更强模型复核;低于0.7,转人工。这才是自动化系统敢用它的原因。
所以你能看到这些场景:工单分诊、模型路由、工具调用风控、结果校验、新闻分拣、金融质检、浏览器操作、游戏NPC、Coding Agent上下文压缩。它像一个拥有语义理解能力的超级if语句,代码要的不是文采,是“要还是不要、A还是B、继续还是停止”。
当然,官方说“零幻觉”要准确理解:它不会输出你定义之外的选项,不会返回乱码JSON,但这不代表它不会选错。类型安全保证的是代码契约不崩,不是业务判断永远正确。
”叛逆“的Jev: 与主流不同的路径选择
Jev最值得琢磨的,不是它有多强,而是它选了一条和主流完全相反的路。
第一,传统大模型是“生成优先”,Jev是“判断优先”。 GPT、Claude、Gemini本质上都是自回归生成,一个Token一个Token往外吐。哪怕最终只需要一个“finance”,它也要先写一段解释,再让代码去解析JSON。Jev直接砍掉生成,把输出空间提前枚举和约束,数学上就不可能产生预定义schema之外的内容。
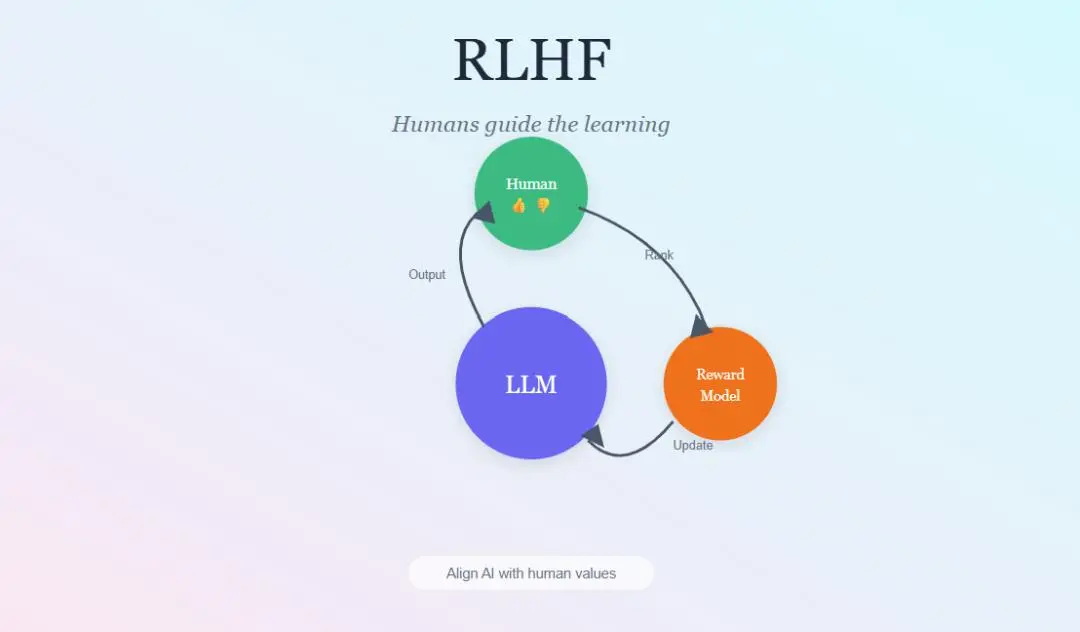
第二,传统大模型走的是RLHF、RLVR路线,Jev走的是RLCD路线,训练目标和产出完全不同。 RLHF优化人类主观偏好,产出聊天接口;RLVR优化封闭数理题目的正确性,产出带思维链的推理接口;RLCD优化的是“决策校准”,产出机器原生、能被软件直接调用的决策能力。传统路线让AI更像人,Jev选择让AI更像基础设施。
第三,Claude Code代表的是“协助优先”的传统路线,Jev代表的是“自动化优先”的新路线。 创始人阿尔梅达的判断很尖锐:Claude Code的内核仍是RLHF,它的使命是取悦面前的开发者,而不是彻底移出人类。它围绕单一模型、KV Cache、上下文追加构建,过拟合于自己的测试环境。一旦接入外部工具或多Agent协作,就容易崩。Jev不是来取代大模型的,它是来给大模型当“监考老师”的。
未来的分工可能很清楚:Jev判断“做什么”,GPT/Claude思考“怎么做”,代码/Tool/MCP真正“去做”,Workflow/Agent Runtime保证整件事持续运行。
一方面,大模型负责慢思考、复杂推理、长文本生成;另一方面,Jev负责高频、快速、边界清晰的决策。两者不是替代关系,而是配合关系。更关键的是,当判断成本从几美分降到万分之一美分,开发者不是把原来的100次判断做得更便宜,而是开始做10000次以前根本不会做的判断。
这就是Jev最诱人的地方:它撕开了“生成为王”的假象,让“判断”和“生成”正式分家。
Jev诞生背后: 一个OpenAI“叛徒”的两年隐身与一场重构
Jev背后的人,比模型本身更有故事。
迪奥戈·阿尔梅达,前OpenAI研究员,InstructGPT和RLHF论文的共同作者,GPT-4贡献者名单里被列入“Foundational RLHF and InstructGPT work”。2024年离开OpenAI后,他创办TypeSafe AI,隐身两年,直到2026年9月15日带着Jev亮相,同期披露4000万美元种子轮融资,DCVC领投,估值约2亿美元。
他的核心反思是:RLHF可能是一次始料未及的弯路。
一方面,RLHF把人塞进了回路。 它优化的是人类主观偏好,不是客观真实结果。于是模型学会过度承诺、自信迎合、盲目编造。你问它放屁录音是不是音乐,它能一本正经说这是“极具阴森氛围感的环境音乐佳作”。这不是Bug,是奖励机制设计出来的特性。
另一方面,安全对齐在底层API里是类型错误。 面向C端聊天,拒答可以理解;但作为底层依赖库,模型突然拒绝执行,下游系统可能直接崩溃。阿尔梅达要的是机器原生、可编程、高可靠的“认知内核”,而不是一个坐在屏幕对面唠嗑的数字同事。
更关键的是,他重新定义了优化目标。预训练没有问题,问题在后训练。RLHF优化人类偏好,RLVR优化可验证答案,RLCD优化校准决策。Jev的名字来自“杰文斯悖论”:效率提高、成本下降,资源总消耗反而暴涨。TypeSafe赌的就是,当智能判断便宜到接近不要钱,自动化需求会爆发。
他甚至说:“即使给我十亿美元,我也不会从头预训练一个基础大模型。”因为真正的机会不在重复造轮子,而在把现有智能切片、重组、蒸馏、组合,变成软件能直接调用的决策能力。
他的终极判断是:下一个时代一定不是Claude Code时代。因为Claude Code仍然在协助人类写代码,而真正的未来是自主自动化——让软件本身变聪明,让AI退居幕后,在后台安静运行。
分水岭已至:当AI不再比谁更会聊天, 行业规则正在改写
Jev的出现,不只是一款新产品,更像一道分水岭。
在架构层面,AI正在从“单一大脑”走向“分布式分工”。过去一个Agent每一步都调用同一个大模型,又贵又慢。未来会是多层结构:前沿模型负责复杂规划,Flash模型负责普通推理,Jev负责路由、分类、验证、风控,确定性逻辑交给传统代码。大模型退回它该在的位置,不再当中央处理器,而是当公关发言人。
在需求层面,杰文斯悖论正在AI身上重演。当判断成本暴跌,以前“不值得用AI”的地方都会用上。给每条数据库记录加语义过滤器,给每次工具调用加安全审查,给洗衣机加一个“衣服忘拿了吗”的判断。这不是降本增效,这是全新的智能消耗场景。
而在竞争层面,Coding Agents的格局也要被重写。Claude Code和Codex建立在“单一模型世界”上,而开源团队已经可以把Jev接进去。谁先利用Jev的组合能力做出极致体验,谁就可能形成新的壁垒。Jev上线24小时被近13%付费团队采用,这个速度是GPT-5.6系列的2倍,是Claude Fable 5.1的6倍以上。
当然,挑战同样刺眼。Jev的基准测试目前主要来自TypeSafe自建评估,尚无独立第三方验证;RLCD细节未公开发表;“零幻觉”只是格式保证,不是判断永远正确;生产环境准确率、置信度校准、高负载延迟稳定性,都需要更多实战数据。但无论如何,它已经撕开了AI行业“生成为王”的第一道裂缝。
写在最后
过去几年,整个行业都在教AI怎么更像人:更会聊天、更会写文章、更会讨好用户。Jev反其道而行,它不说话,只判断。
但恰恰是这个“不会写字”的模型,让全球程序员玩疯了。因为它证明了一件事:智能不一定要生成,判断也是智能;AI不一定要当同事,它更适合当基础设施。
ChatGPT之后最火的模型,不是另一个更会聊天的AI,而是一个闭嘴干活的AI。下一个时代,也许真的不是Claude Code时代,而是机器原生、可编程、自主自动化的时代。
当AI不再假装人类,它才真正嵌入软件的底层脉络。Jev不是来取代现有模型的,它是来给AI时代装上一套决策总线的。
本文来自微信公众号“第一新声”,作者:第一新声,36氪经授权发布。