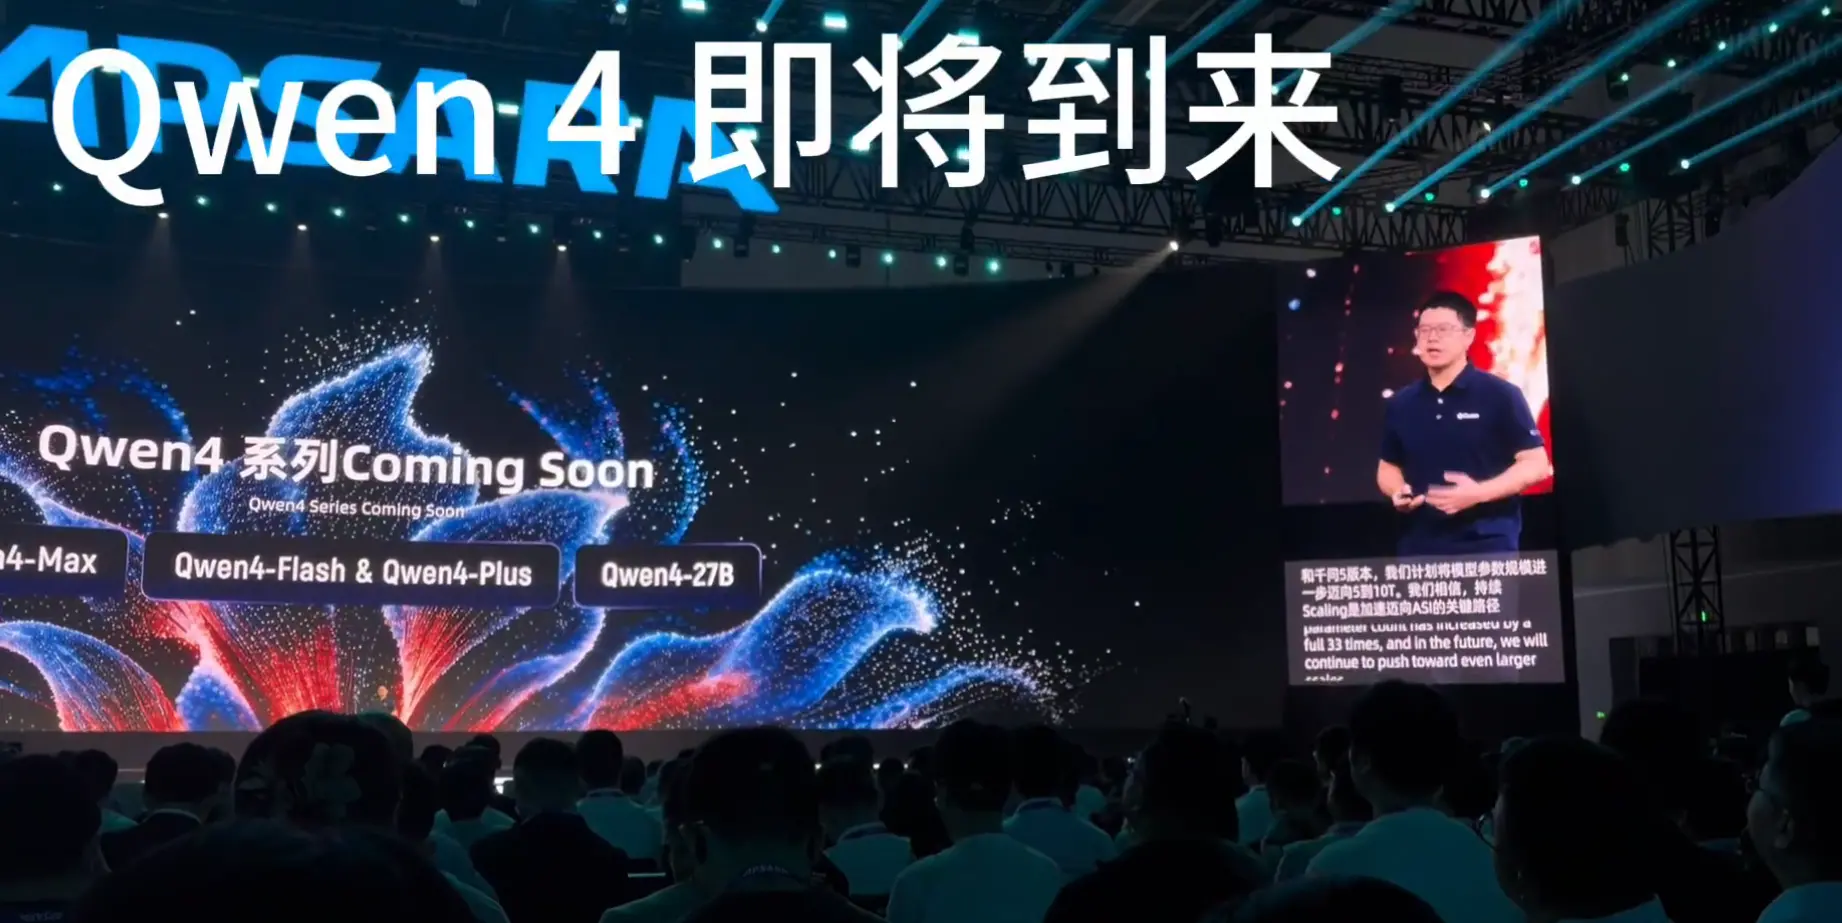
9 月 22 日,2026 云栖大会在杭州开幕,阿里巴巴把通义千问一年攒下的进展做了次集中发布。最核心的一条线:大模型递归自我改进(RSI)已经从论文概念进入了真实的训练、推理和芯片协同环节。基于新一代架构的 Qwen4 已进入训练,往后 Qwen4.5、Qwen5 的参数规模将扩展到 5 万亿至 10 万亿。千问 LLM 项目负责人刘大一恒在会上的表态很直白:Scaling 仍然是走向更强通用能力的核心路径。
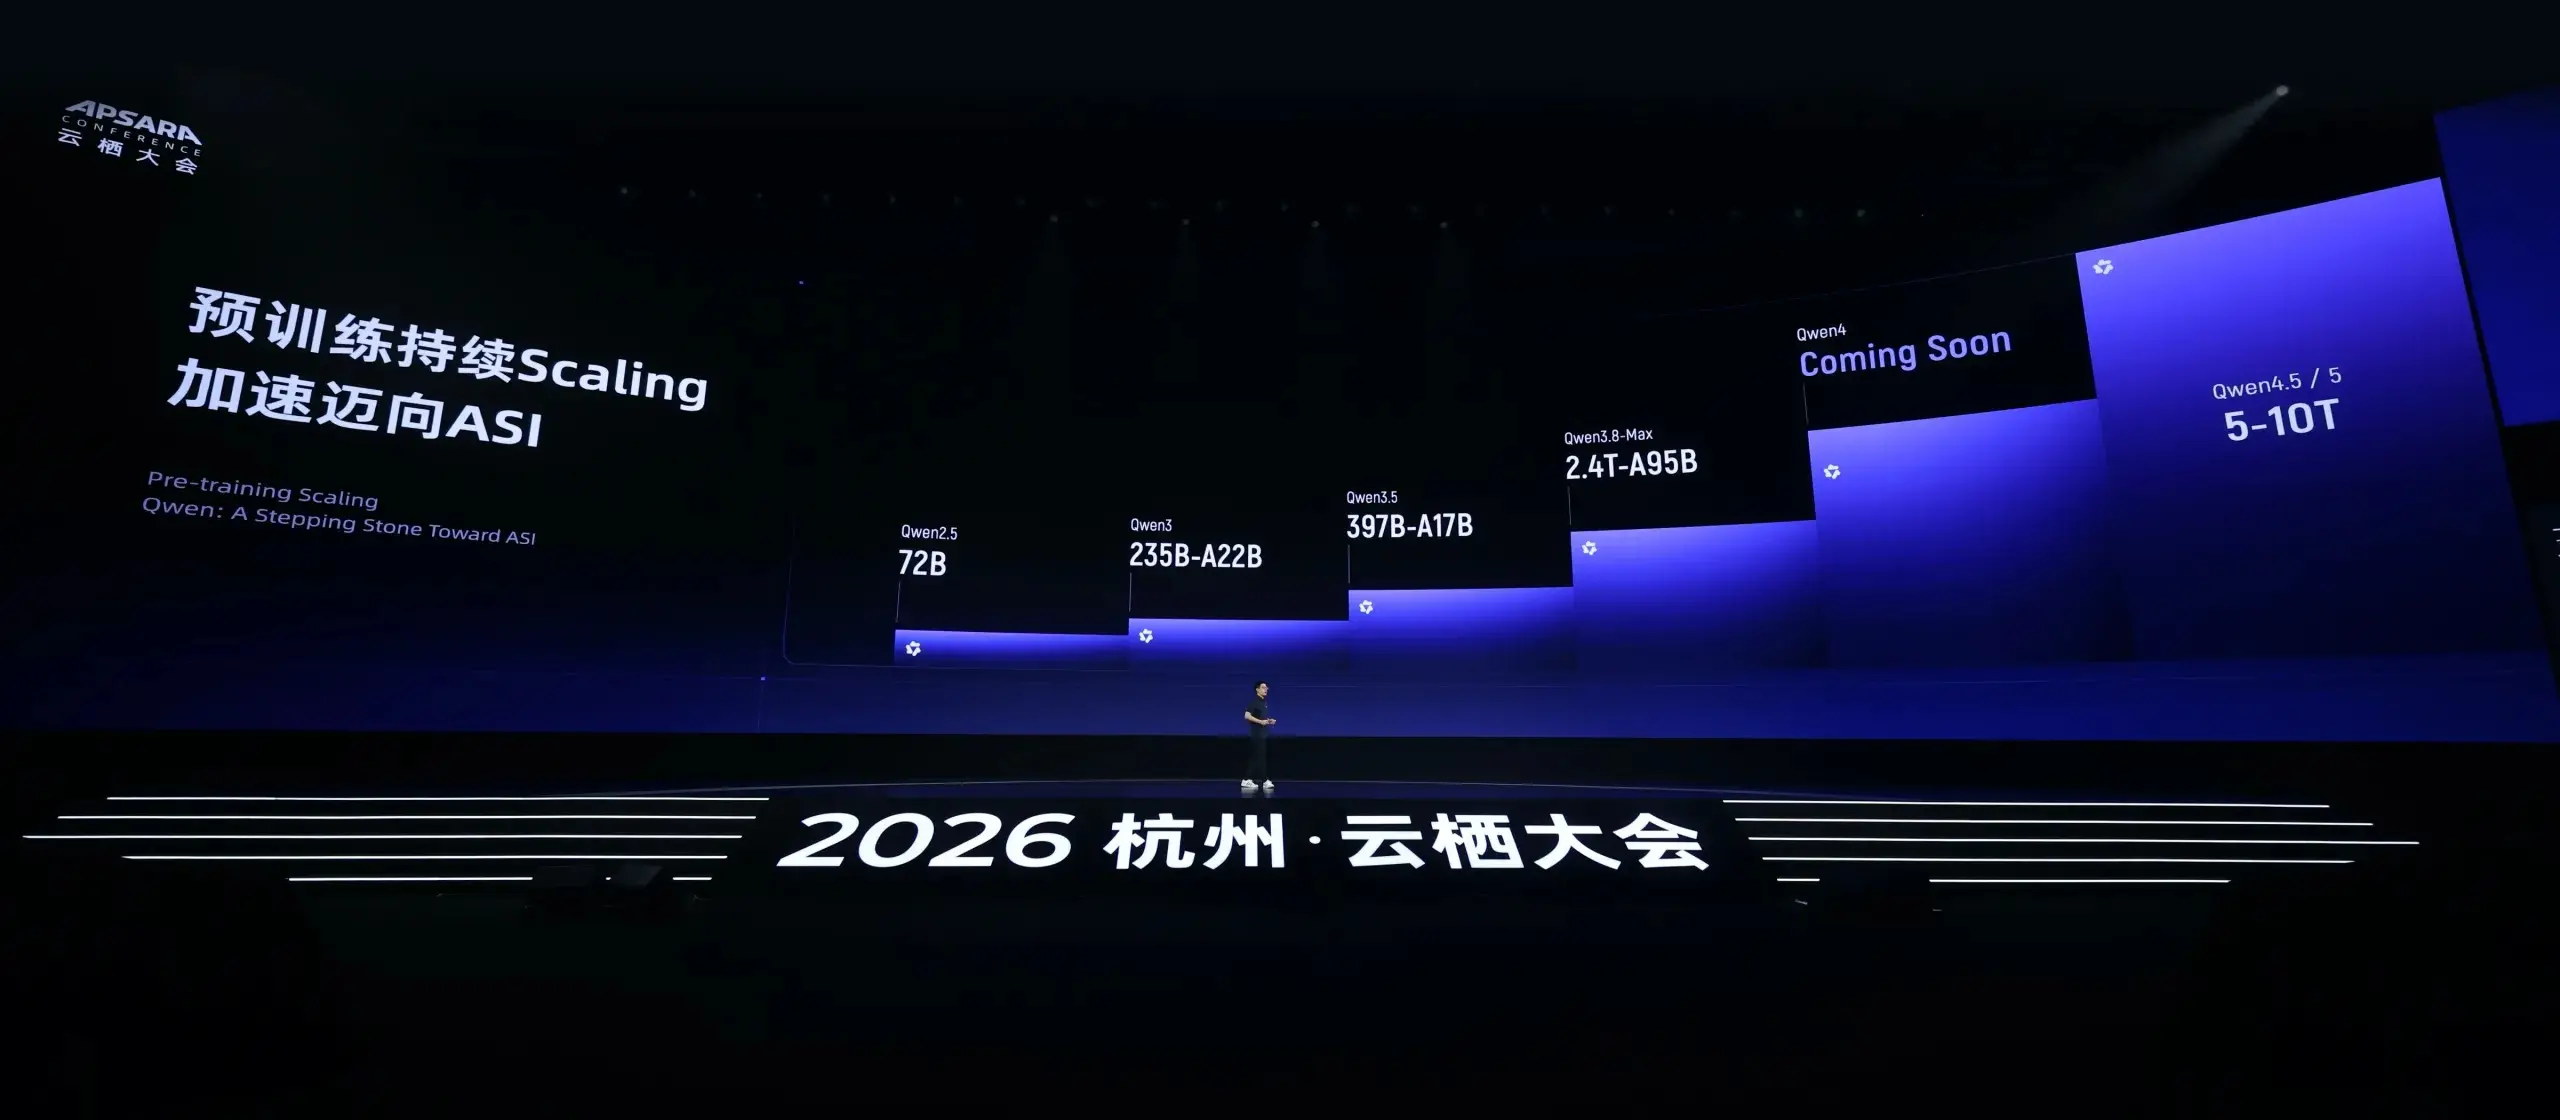
RSI 是这次最值得拆开来讲的技术点。传统的大模型迭代流程里,分析评测结果、准备训练数据、设计下一轮实验、定位缺陷——每一步都得人上手。阿里说 Qwen3.8-Max 已经能自己跑完这一整圈:自主搭建训练流程、构造训练数据、设计实验并定位缺陷,在人类完全零参与的情况下持续迭代超过一个月,完成了 33 轮有效迭代。最新版本在 Artificial Analysis 全球大模型榜上的得分也因此从 40 分抬到 45 分,进入 Claude、GPT 所在的第一梯队。
RSI 没有只停留在训练环节,它往上下游都伸了出去。推理侧:Qwen3.8 在一块从未见过的平头哥新款 GPU 上,自主完成了下一代架构 Qwen3.8-Flash 的 SGLang 推理框架适配优化,单实例推理吞吐量提升了 96%。芯片侧:仅凭一份真实的总线模块规范,自主展开前端、验证、后端的全链路迭代,在自主运行超过 60 小时、调用 EDA 工具上万次后,实现了面积减少 42%、标准单元数降低 29%、功耗降低 59.5% 的物理实现优化。后一项尤其值得注意——芯片设计长期被认为是 AI 最难插手的领域之一,流程长、依赖大量工具链和人工经验判断,只给一份规范就能把前端到后端跑通,说明模型在长周期多工具任务上已经有了相当强的自主规划能力。
多模态模型矩阵则是雷打不动的全家桶升级。全模态模型 Qwen3.8-Omni-Flash 正式亮相,把视频、音频、图像、文字纳入统一理解框架。视频生成方面,Wan3.0 支持单次 30 秒视频生成、结构化输入与原生音画同步,在 Artificial Analysis 文生视频与视频编辑双榜位列全球第一;下一代视频模型计划 11 月发布。语音家族 Qwen-Audio-3.1 全线升级,涵盖转写(ASR)、合成(TTS)和实时交互(Realtime)三条线,同步推出 Qwen-Audio-3.1-ASR-Next 与 Qwen-Audio-3.1-TTS-Next。同声传译模型 Qwen3.8-LiveTranslate 首次亮相,字均延迟压到 2.3 秒——人类同传的平均时延通常超过 4 秒。图像侧 Qwen-Image-3.1 面向电商与设计场景商用优化,7B 的 Qwen-Image-2.1 全面开源。音乐模型 HappyShrimp 1.1 和世界模型 HappyOyster 2.0 Preview 也一并更新。
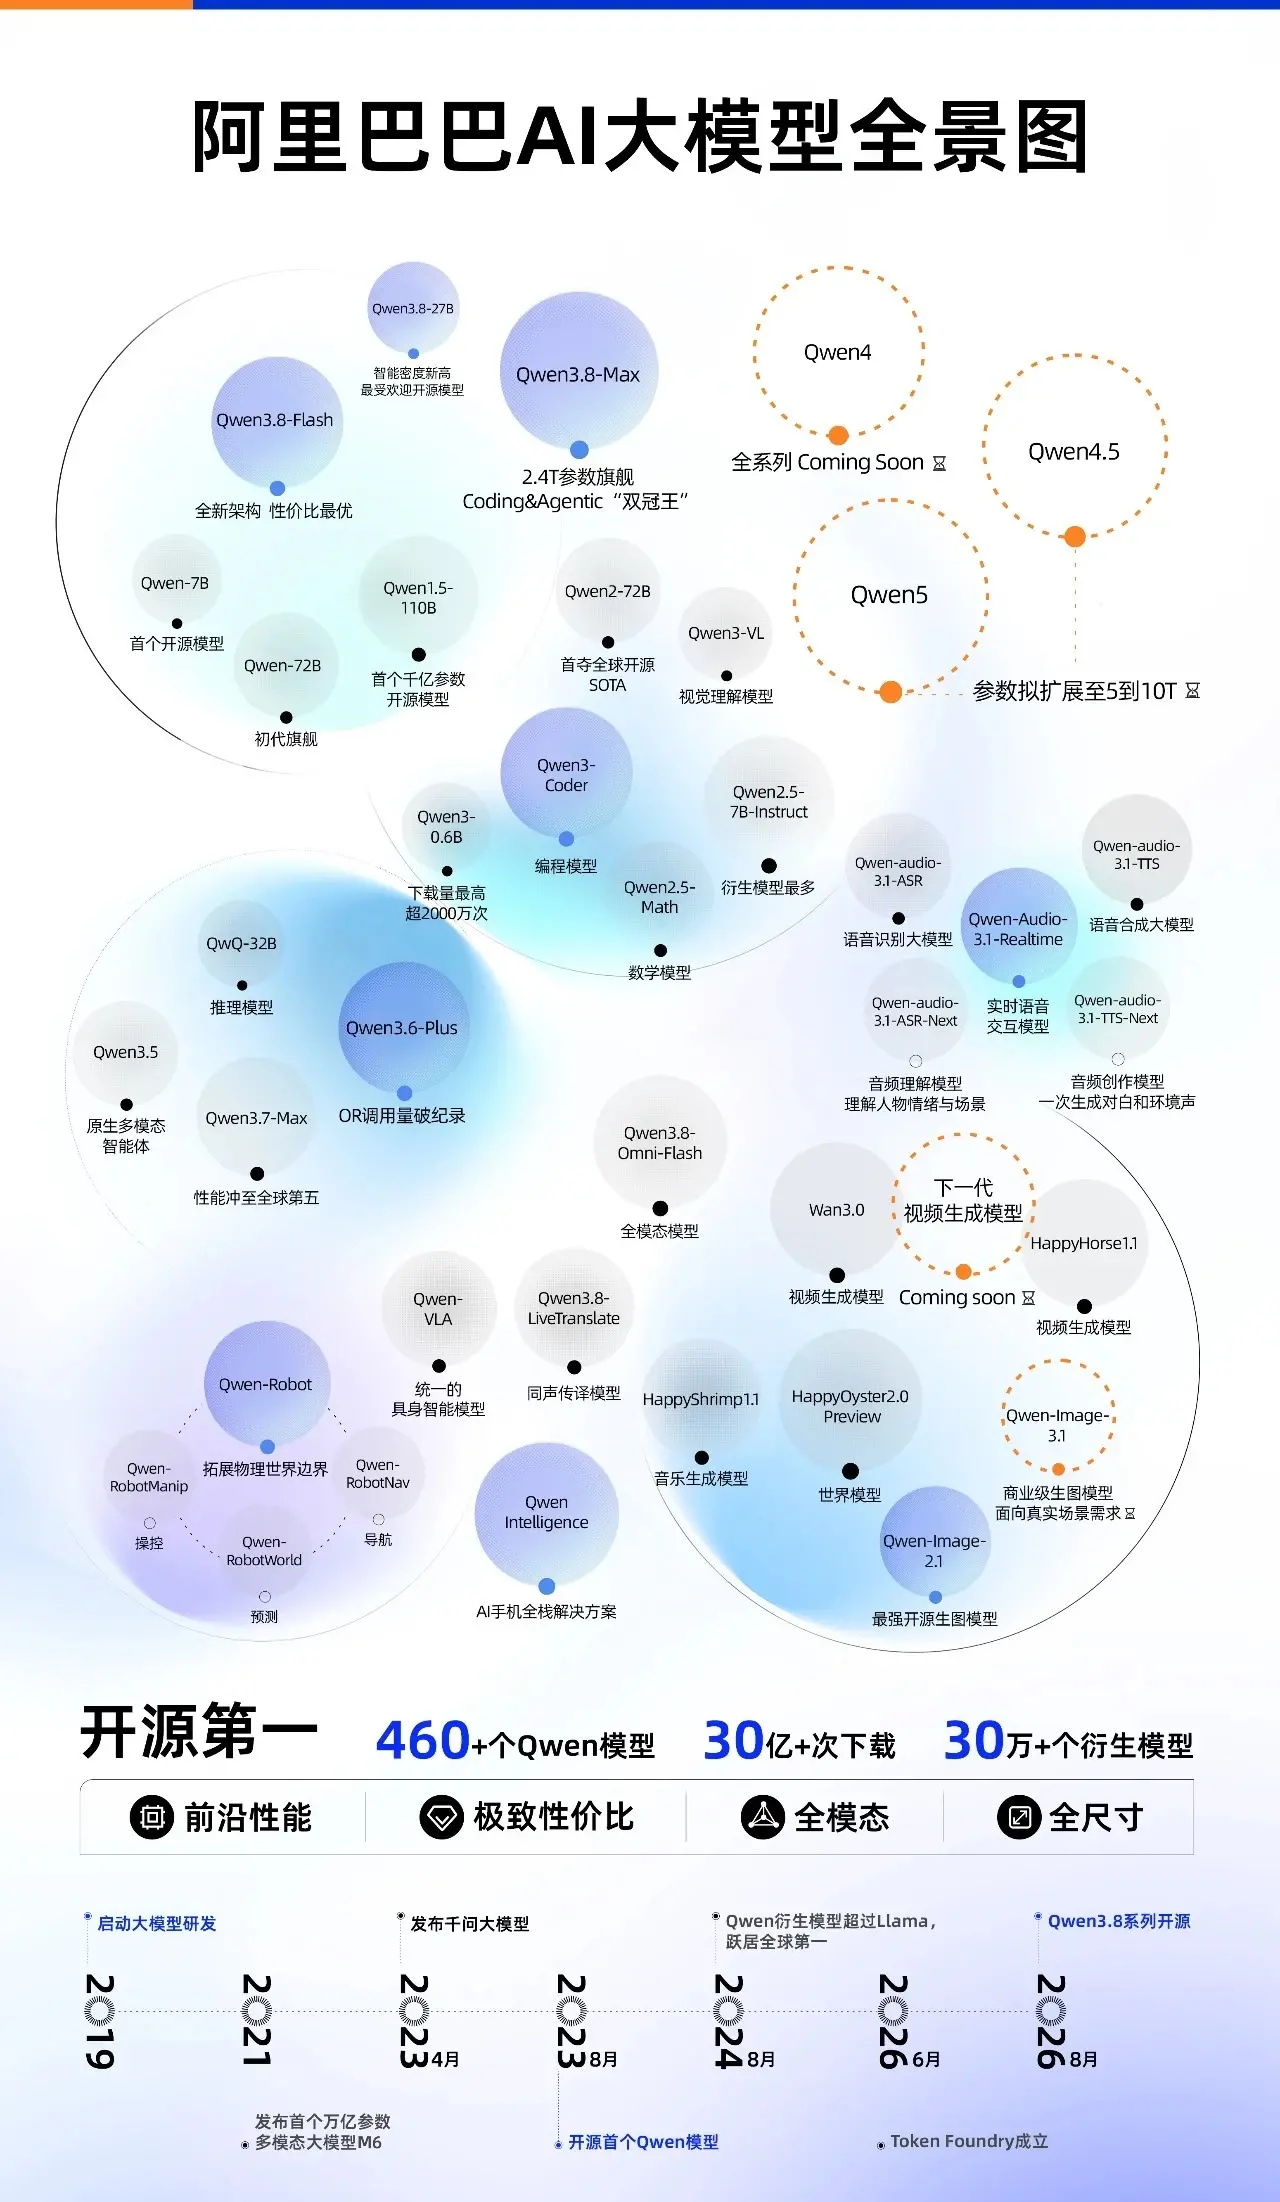
开源数字也被摆了出来:Qwen3.8 系列发布一个月下载量突破 5600 万次,衍生模型超 1900 个;累计已开源 460 多个千问模型,总下载量超 30 亿次,衍生模型突破 30 万个。落地侧,Perplexity、Airbnb、Pinterest、路透社等都在用 Qwen。架构减负也同样惊人:提前开源的 Qwen3.8-Flash 通过注意力机制和信息传递机制等核心改动,把训练成本压下去接近 90%,API 定价为每百万 tokens 输入 1 元、输出 3 元。