TypeSafe 的判断模型 Jev 火到什么程度?Vercel 的说法是——"Jev 是 AI Gateway 历史上被采用速度最快的模型"。但 Arcturus Labs 创始人 John Berryman 在最新一篇博客里泼了盆冷水:《Will OpenAI Eat Jev's Lunch?》。他的判断很直接:Jev 的架构几乎没有护城河,真正值钱的是它的训练数据和强化学习流程——而这两样 OpenAI 都完全有能力自己造。
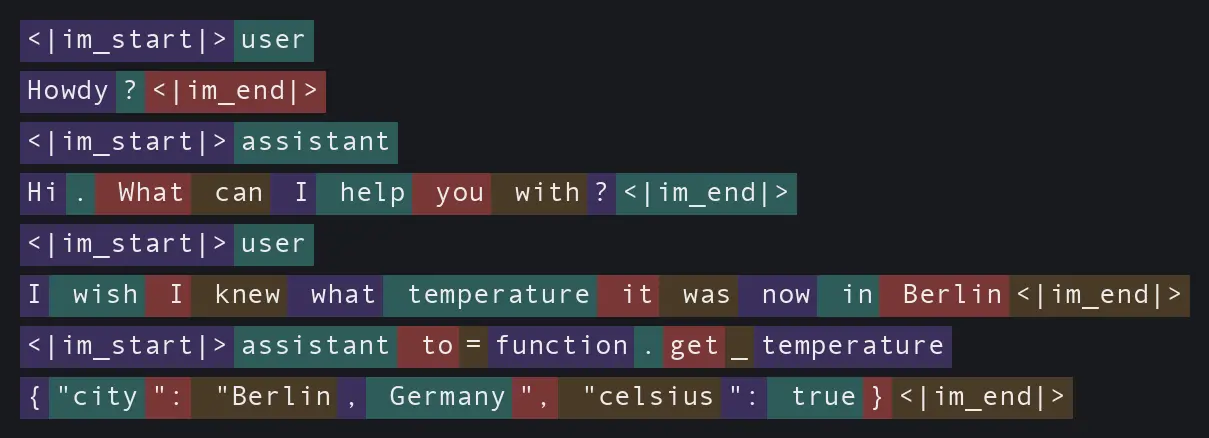
他的核心论点是"OpenAI 多年来一直在把 LLM 当隐式分类器用",只不过没打包成一个通用分类产品。论据很硬:从 2024 年初的工具调用(tool calling)开始,OpenAI 的模型内部就在干 Jev 那套事——预测 to=function 一个 token,决定要不要调用工具;再预测下一个 token 决定调哪个工具; 和 <|im_end|> 这些保留 token 本质都是微分类器。Berryman 早年还写过一篇用 logprobs 做分类的文章,他承认自己 2025 年就在博客里演示过这个 pattern,还补了句自嘲:"想法和执行力哪个重要?"
<user>
So Donny said "nice haircut" to me today. Does he like me?
</user>
<assistant>
<thinking>
Let me size this up.

<prediction>
claim: Donny is romantically interested in Jess.
probability: 0.04
</prediction>

Yeah, "nice haircut" is not exactly a love confession.
</thinking>

I hate to break it to you, but... probably not.
</assistant>
技术上讲,Jev 的判断规则无非是:给定状态和一组问题,LLM 生成下一个 token 的概率分布,然后取出目标 token(比如 true/false)的相对概率归一化,作为"答案概率"返回。nol(是否)问题看两个 token,choice(选择)问题给一组选项看相对概率取最高。Berryman 的分析是,这套东西不需要特殊的架构,常规 LLM 就是"一种不断给每个后续 token 分配概率分布的、极度通用的分类器"——而 Jev 只是把其中两步抽象成了通用产品。
所以他认为护城河不在架构。那在哪儿?大概率在训练数据——不是原始数据,而是把它变成"校准过"的 Jev 的那套手艺。TypeSafe 联创 Diogo Almeida 在争议里说得很明白:"我们自认为是数据研究实验室,绝大部分研究都在做真正通用的数据(认知核心),而且 100% 合成。"Berryman 猜,理想的数据集是海量的、结果已知的样本——工单最后怎么被路由、简历对应的候选人有没有被录用、评论对应的真实星级——跨领域喂进去,练出"跨域泛化的分类肌肉"。
他同样不确定那个 secret sauce 是不是在强化学习里:让 agent 在有限选项里做决策(比如维基百科演示、Doom 演示),或者预测预训练截止日之后发生的事件的结局。但他强调,这些都不算护城河,除非 Jev 真的准——他已经找到了一些 Jev 概率不靠谱的领域。速度、成本、易用都是明摆着的,唯独"准确性"最难验证。
OpenAI 的下一步,他给了两个版本。平庸版:直接抄 Jev 发一个新模型类型。有趣版:把分类能力折进常规 LLM 里,比如引入一个 <prediction> 语法,让模型在自己的 thinking 块里随时做一次校准过的快速判断——判断该不该继续推理、工具调用安不安全、该路由到哪个规模的模型——全程不离开 GPU,因为这是模型内置能力、不是外部工具。MoE 时代每个前沿模型都是混合专家,微调几轮割出一个"专精快判断的专家"并非天方夜谭。
结论他留给了数据说话:如果 Jev 的准确性和泛化性撑得住,那 TypeSafe 的生死就看那个护城河到底多深——如果训练数据和 RL 真难复刻,他们大概率没事,甚至可能被 OpenAI 直接收购而不是被干死;如果护城河很浅,OpenAI 自己造,窗口很快就会关上。Diogo Almeida 自己的态度倒是坚定:"如果模型质量重要,那我们长期会处于非常好的位置。"
来源: