今年初英伟达发布DLSS 5时,可能没多少人想到,这项充满争议的技术还能以这么快速度迭代、进步。
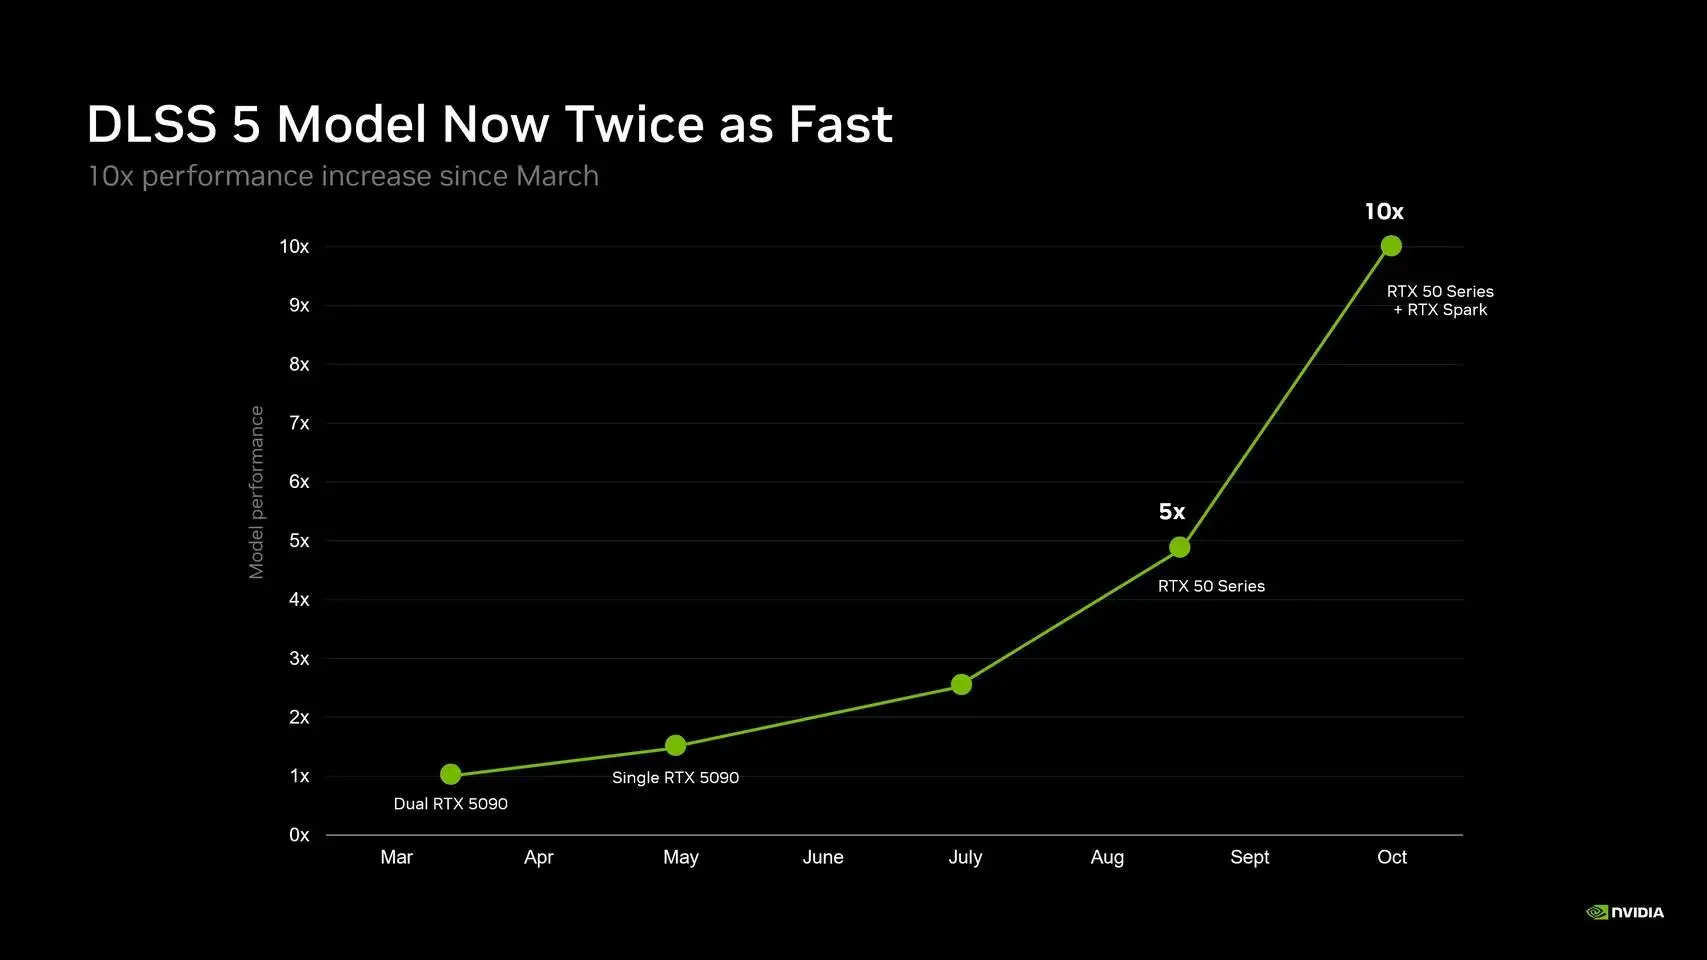
10月13日,英伟达宣布了DLSS 5新模型升级,模型参数量减少24%,显存占用也降低了20%,但运行速度相比9月的版本再次翻倍。算上此前的优化,过去半年多,DLSS 5的模型运行速度已经提升了:
整整10倍。
图片来源:英伟达
甚至不需要最早公布时的两张RTX 5090,只要一张RTX 50系列显卡就能运行DLSS 5。这样的升级,已经超出了一次常规的性能优化。
要知道,过去几十年,游戏画质的提升很大程度上依赖GPU不断增强传统图形计算能力,从光栅化到光线追踪,都是如此。但从DLSS 4到DLSS 5,神经(网络)渲染技术毫无疑问正在成为一个关键变量,这次就引入了最新的3D引导神经渲染技术。
简单来说,「神经(网络)渲染」就是让神经网络直接参与图形渲染,甚至利用AI生成更逼真的光照、材质等视觉细节,而不必全部依靠传统图形算法计算。
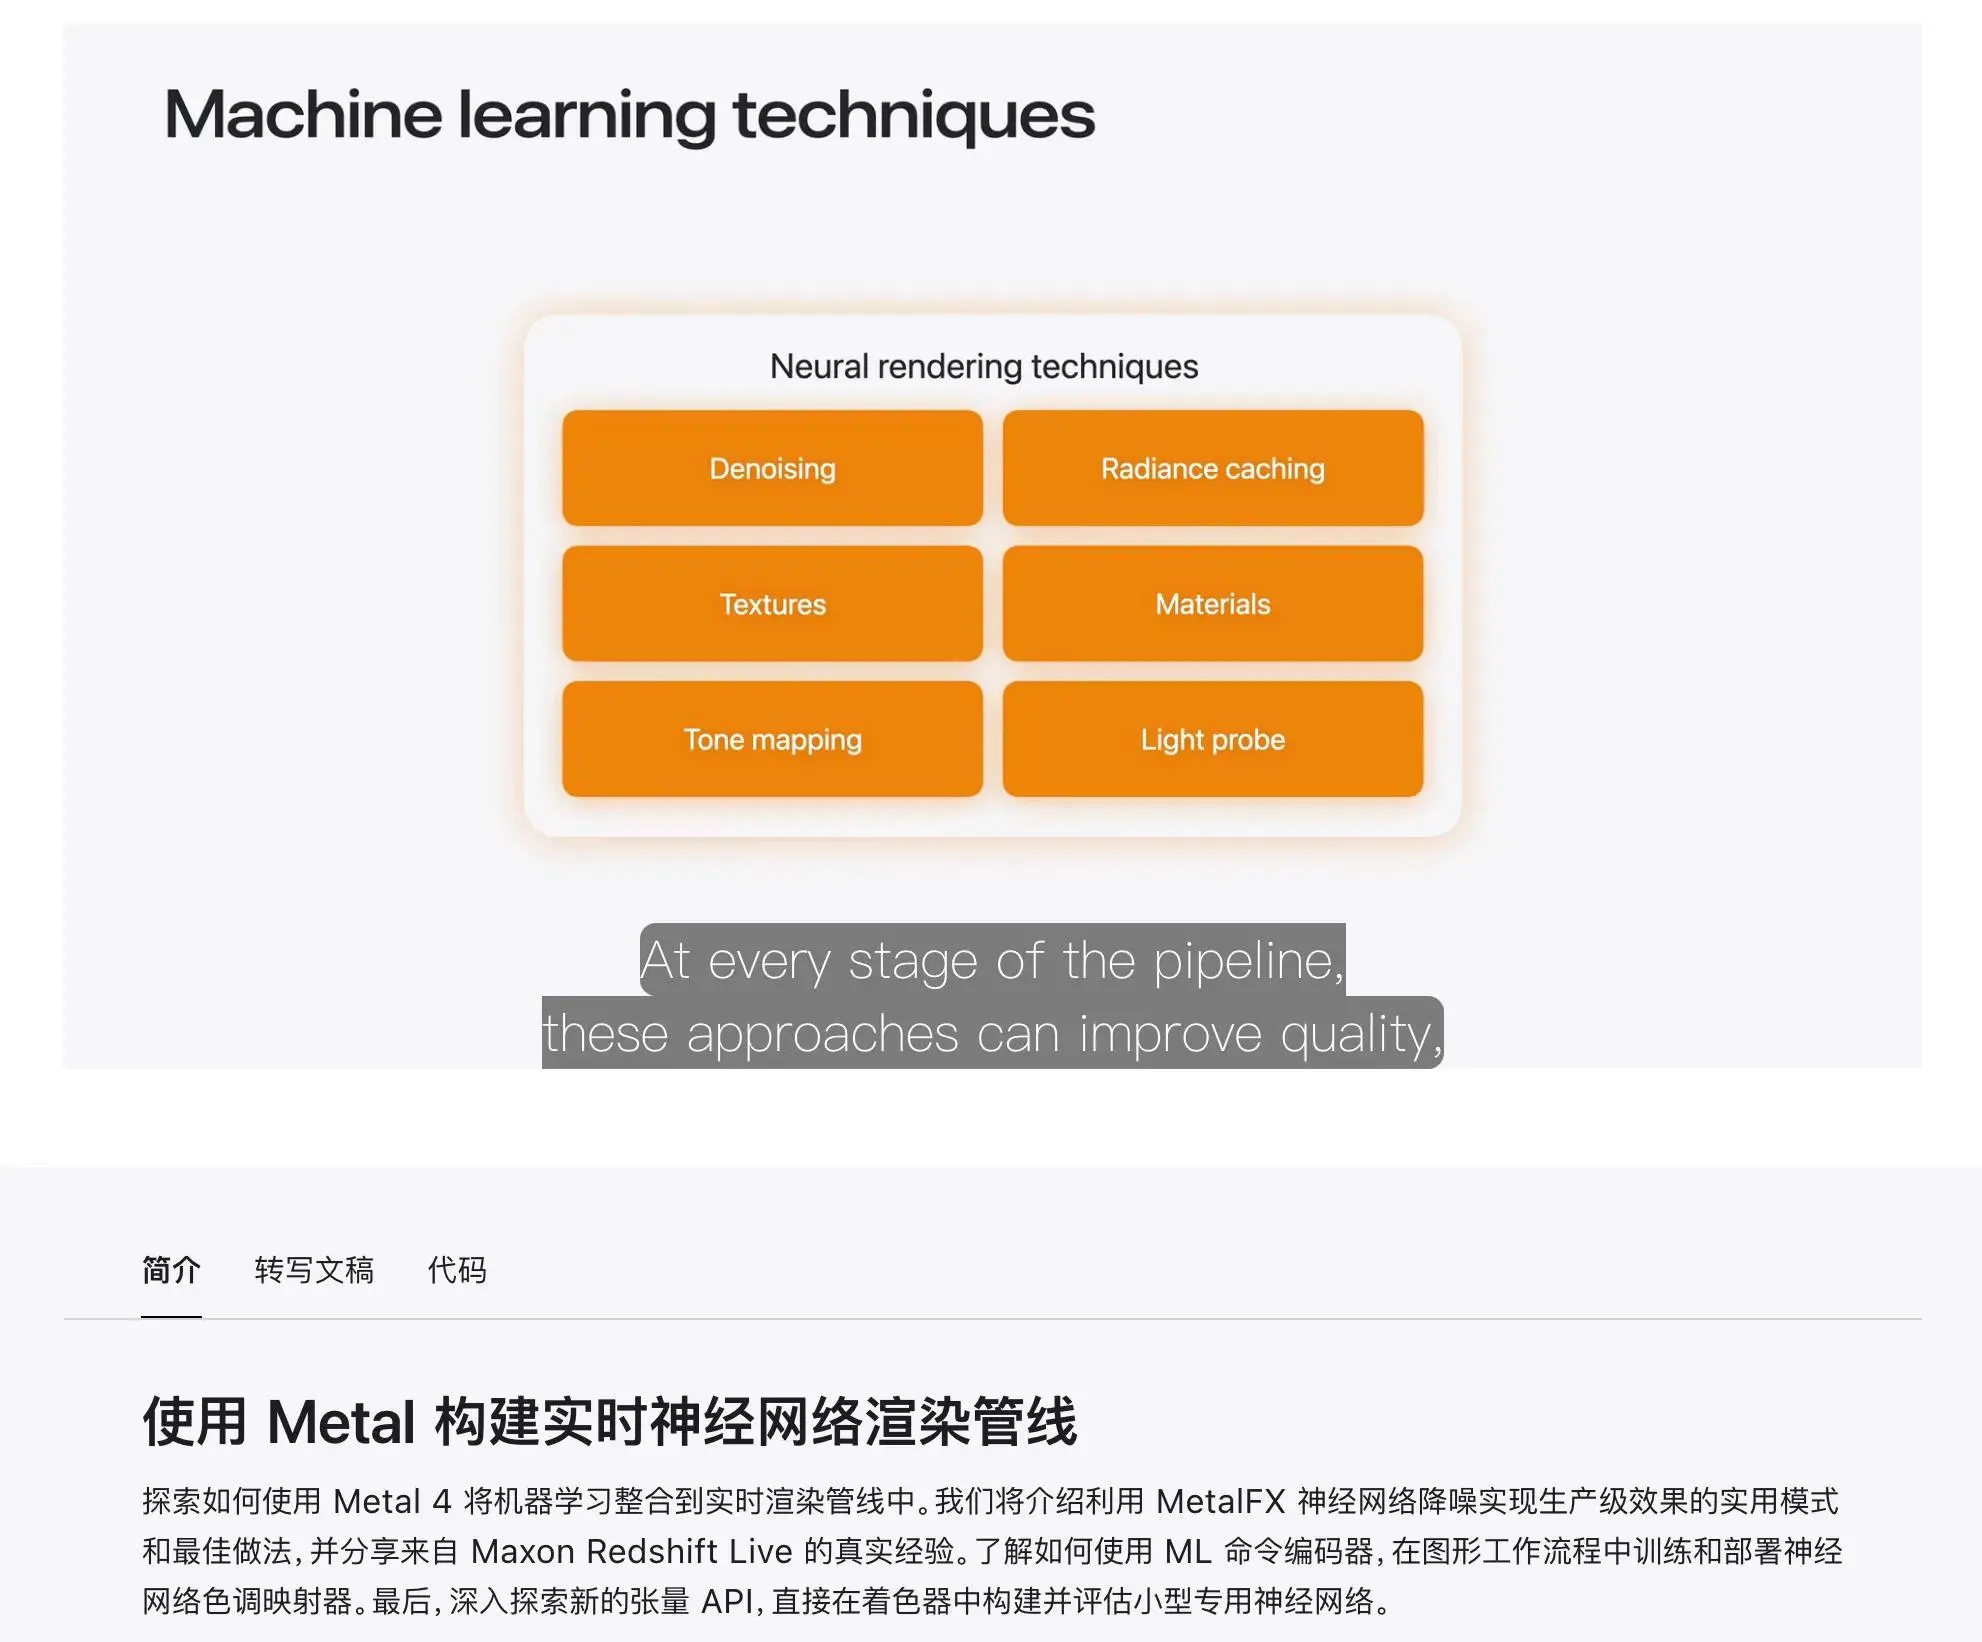
不止英伟达,不止PC。苹果早在去年WWDC上就通过Metal 4提供了将机器学习整合到实时渲染管线中的能力,并从去年的A19系列和M5芯片开始,在GPU中加入了神经网络加速器;而高通、联发科,也都在新一代旗舰芯片上首次引入了神经渲染技术。
图片来源:苹果
各家的实现方式和落地阶段不尽相同,但方向上都在让神经网络,或者说AI真正深入渲染管线的核心。
对于已经发展了几十年的计算机图形技术,这或许意味着一场比单纯提升GPU性能更深刻的变化。
半年提速10倍,神经渲染究竟改变了什么?
需要先说明,DLSS 5最新升级的重点在效率。
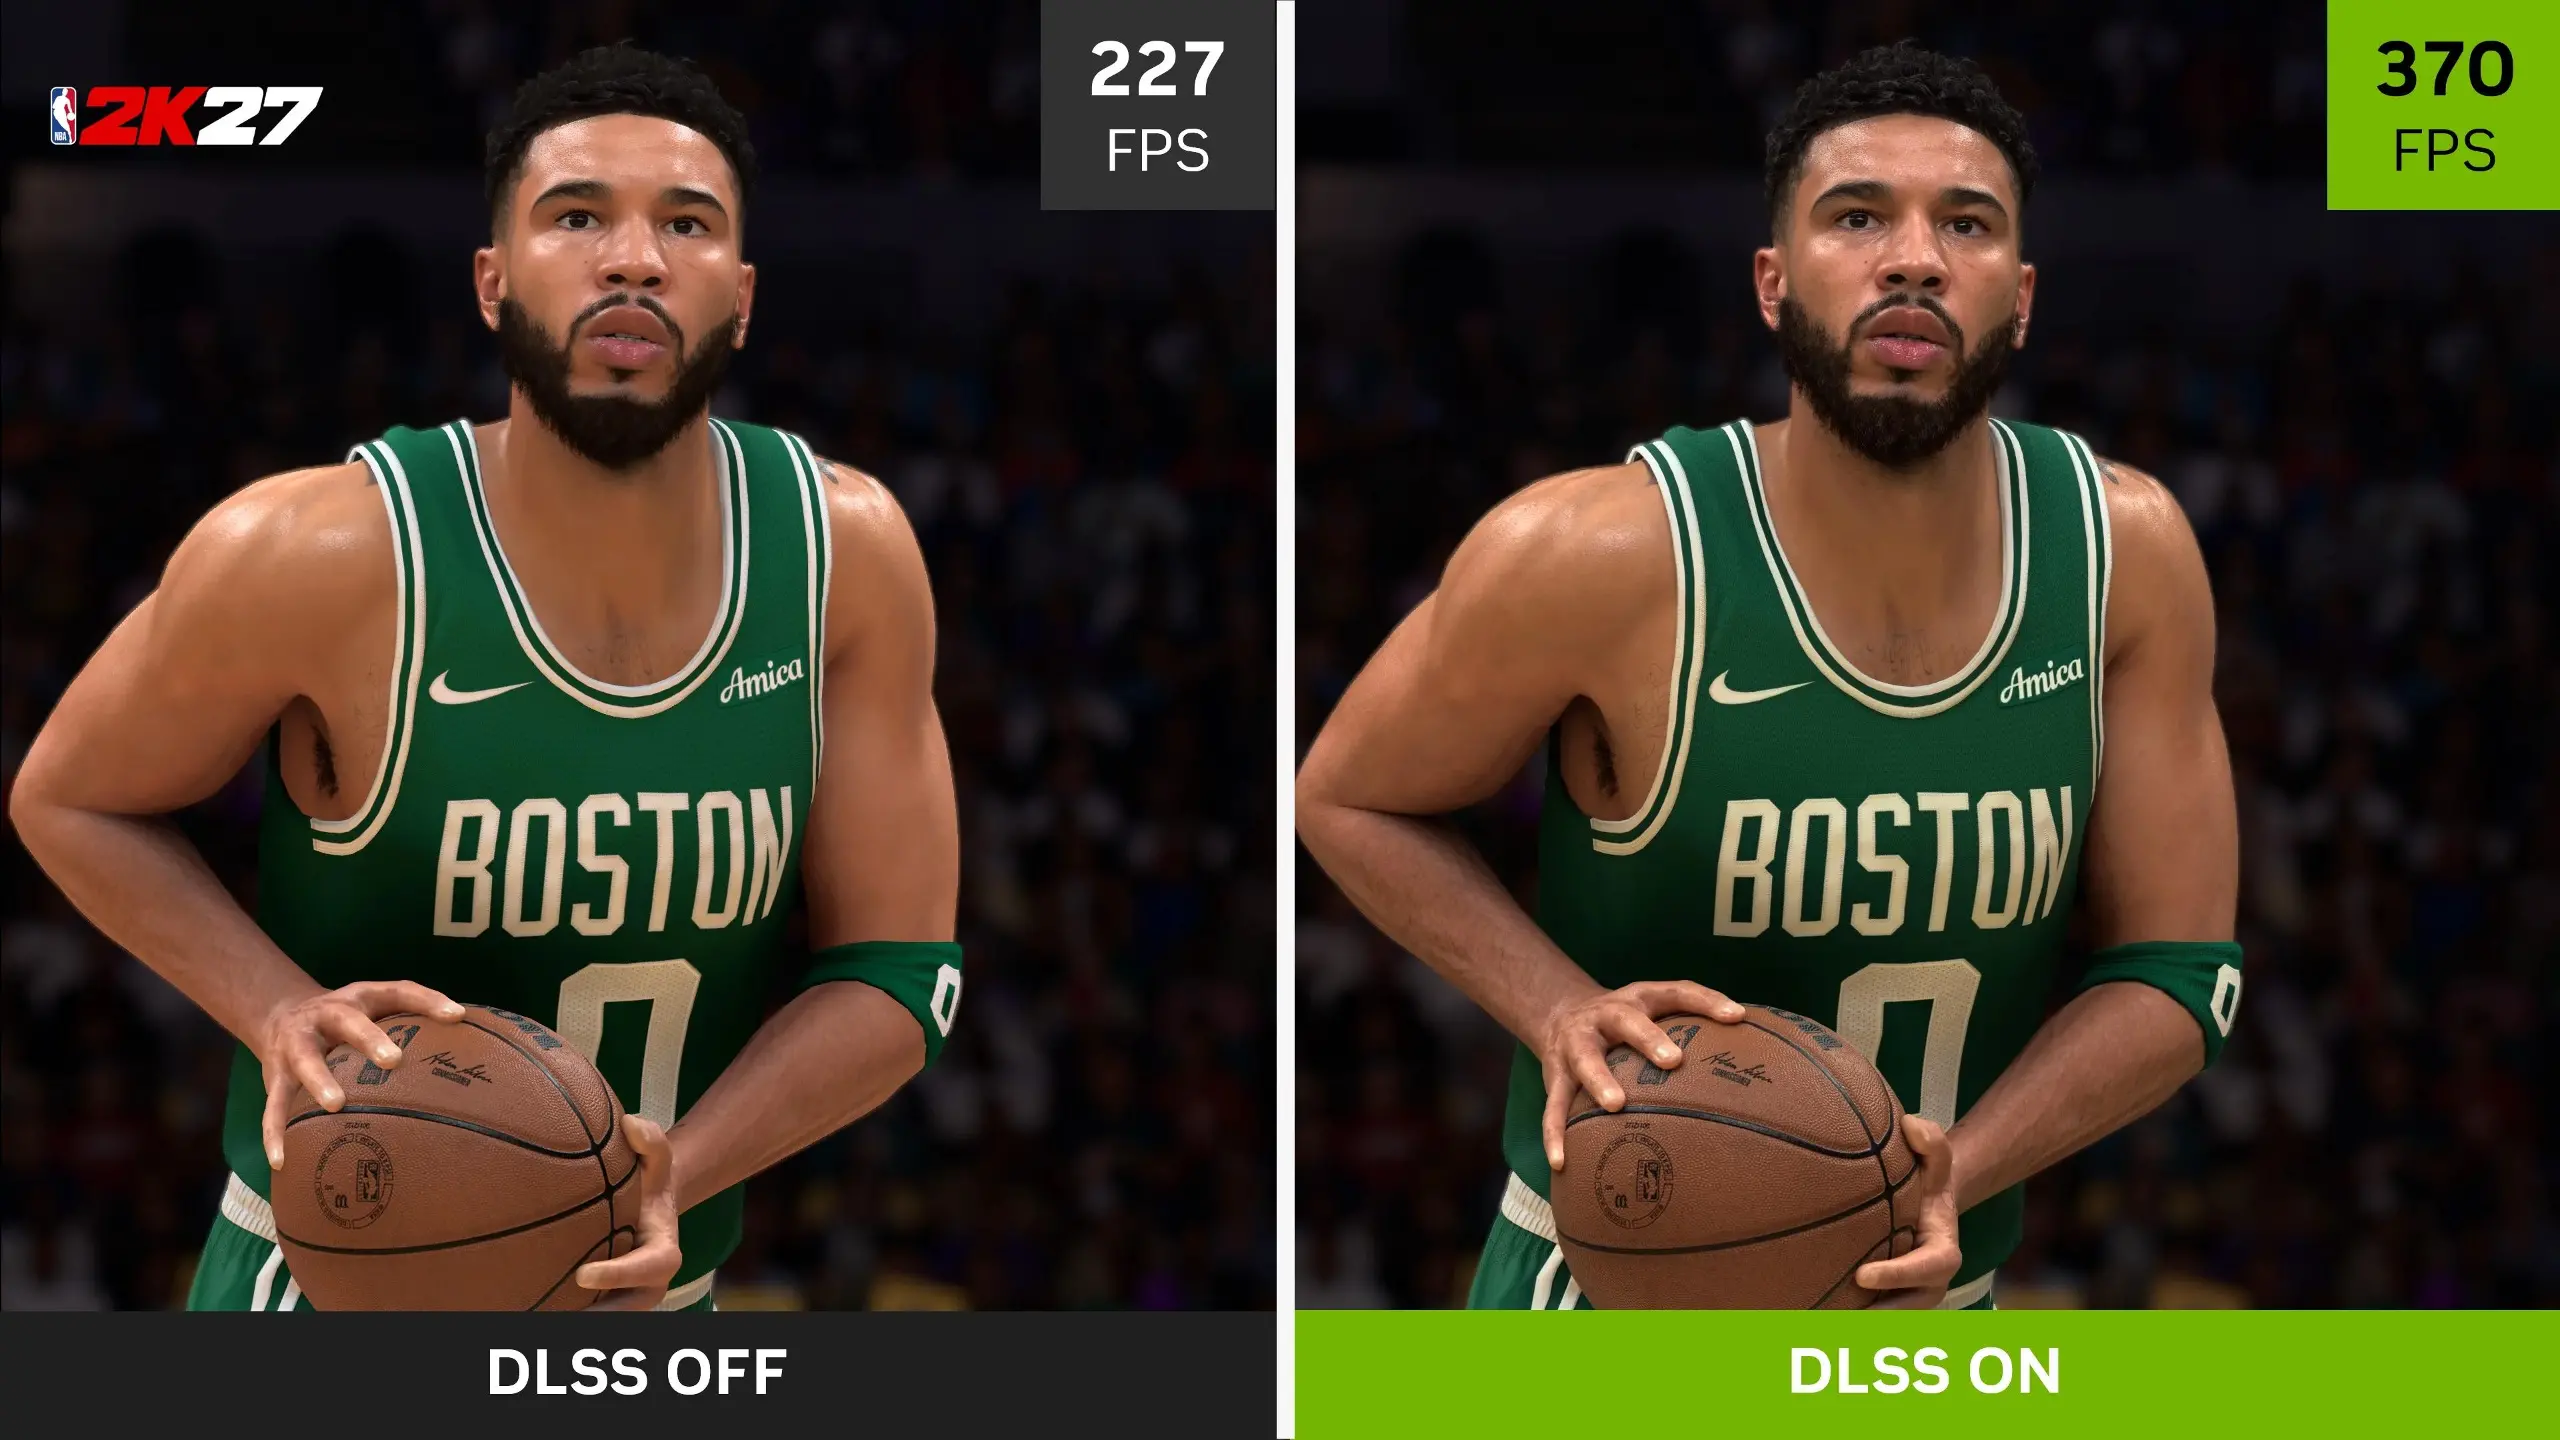
按照英伟达的说法,通过神经网络模型与渲染管线的共同优化,新模型的参数量已经缩减至约1.18亿,同时将GPU运行开销降低了一半,基本保持了原有的视觉效果。按照测试结果,新模型可以让《NBA 2K27》的帧率最高提升40%。
图片来源:英伟达
DLSS 5也正在加快进入更多游戏。除了将于10月16日推出的《NBA 2K27》,新模型还将陆续进入《霍格沃茨之遗》《燕云十六声》,并在10月23日接入RTX Remix,让更多经典游戏重制项目也有机会用上这项技术。
而半年多时间实现10倍提速,也足以说明英伟达在模型优化上取得了多大的进展。当然,这里的10倍指的是神经渲染模型的运行速度,而非游戏整体帧率。
回顾过去几年,从DLSS超分辨率到帧生成、光线重建,英伟达其实一直在尝试让神经网络分担GPU的图形计算。比如超分辨率不需要GPU直接渲染完整的高分辨率画面,而是先以较低分辨率渲染,再通过神经网络重建细节;光线重建则利用AI处理光线追踪中不完整、带有噪声的采样结果。
这些技术已经在一定程度上改变了传统图形渲染的计算方式,但它们主要还是围绕已有渲染结果进行重建、增强或补帧,DLSS 5则进一步把神经网络用于生成画面的视觉表现。
举个例子,要在游戏中呈现一张足够真实的人脸,传统图形渲染需要通过精细的几何模型、材质贴图,以及光照和皮肤次表面散射等计算,共同模拟真实皮肤的视觉效果。理论上,投入更多的建模与计算资源,就可以得到更逼真的结果,但代价也会越来越高。
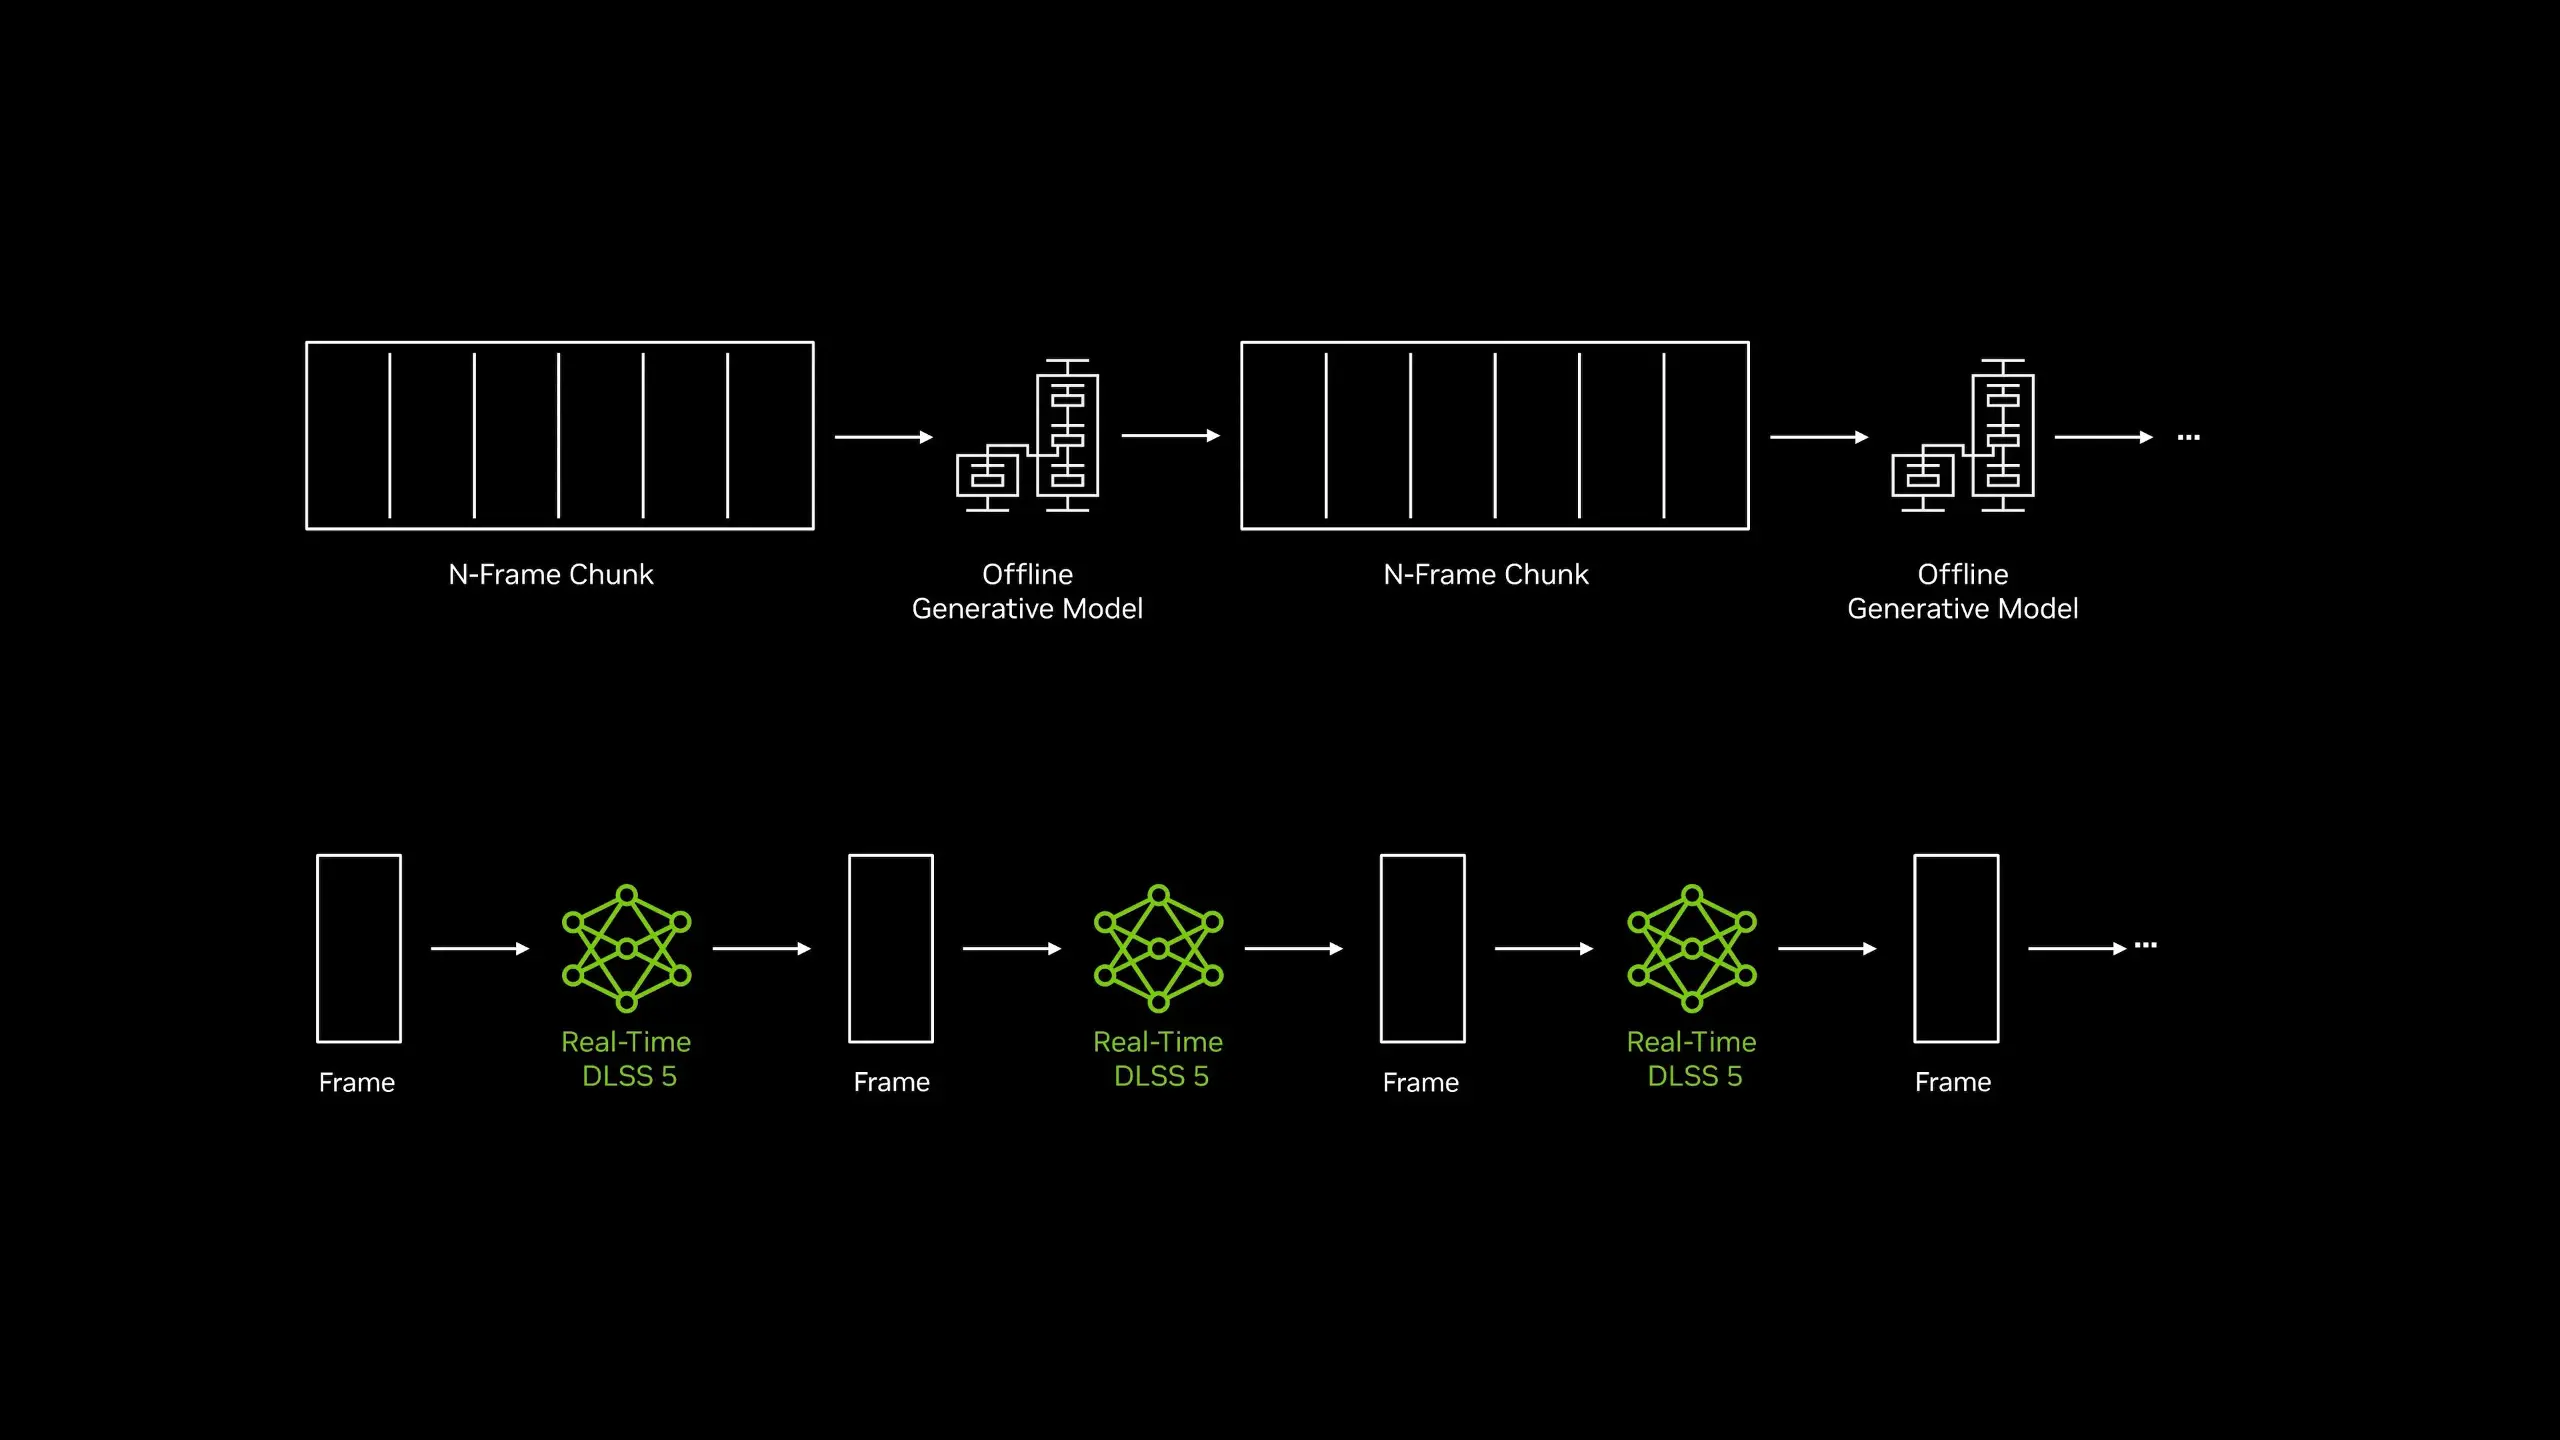
DLSS 5提供了另一种思路。它仍然需要游戏引擎提供基本的3D结构、材质和光照信息,但不必让传统渲染器独自完成所有视觉细节,而是借助从真实世界图像中学习到的知识,由生成式神经网络补充皮肤、光照、材质等复杂效果。
图片来源:英伟达
从这个角度看,DLSS 5试图突破传统实时渲染在画面真实感上的限制。当然,这一层神经渲染本身也需要额外的计算,此次优化降低的正是它自身的运行开销。
一言以蔽之,神经渲染真正改变的,是GPU不再需要完全依靠预先编写好的图形算法,逐步计算出画面中的所有效果。对于一些复杂的视觉问题,神经网络也可以通过学习、预测甚至生成来完成。
这并不意味着未来的游戏画面都要交给AI生成。游戏世界的几何结构、物体位置、角色动作,以及诸多需要严格遵循游戏规则的视觉信息,依然离不开传统图形渲染。更有可能的未来是,传统图形算法与神经网络计算逐渐融合:
前者负责那些需要精确计算、明确约束的部分,后者则承担一些可以近似求解、计算成本又十分昂贵的任务。
这也解释了为什么,神经渲染不仅受到英伟达、英特尔、AMD的重视,也开始成为手机芯片厂商的新方向。
手机拥抱「神经渲染」,高通联发科们加速中
相比PC,手机其实更需要神经渲染。
原因不难理解。过去十几年,手机GPU的性能虽然不断提升,但受限于功耗、散热和内存带宽,始终无法像桌面显卡一样,通过持续增加计算资源来换取更好的游戏画质。
尤其是从《原神》算起,《崩坏:星穹铁道》《鸣潮》等大型手游,以及越来越多PC、主机游戏登陆移动平台,玩家对手机游戏的画质、帧率都有了更高要求。光线追踪等技术的引入,也进一步加重了GPU的计算负担。
问题是,手机GPU能够分配到的功耗预算终究有限。厂商可以通过更先进的制程、更高效的架构来改善能效,却很难改变手机轻薄机身和被动散热的基本限制。
神经渲染提供了另一种可能。
既然一些复杂的图形计算可以交给神经网络近似求解,就不一定需要GPU继续依靠传统方法完成所有计算。尤其是超分辨率、光线降噪,以及未来更复杂的材质、光照计算,都有机会通过神经网络降低计算成本,在有限功耗下实现更好的画质。
某种程度上,手机比PC更迫切地需要这种「以算法换算力」的能力。然而,手机上的神经渲染反而更难做好。
神经网络计算本身也需要消耗算力、内存带宽和电力,而且实时游戏对延迟十分敏感。以60fps为例,每帧只有约16.7毫秒的总时间预算。如果引入神经网络之后,模型推理和数据传输的额外开销抵消了传统渲染节省的成本,最终反而可能得不偿失。
更麻烦的是,手机SoC虽然早就集成了NPU,但GPU渲染得到的颜色、深度、运动矢量等数据,需要及时送入神经网络处理。GPU与NPU可以共享系统内存,但让两个计算单元协同工作,仍可能涉及额外的内存访问、数据格式转换和任务同步。这些开销如果处理不好,不仅可能增加延迟,还会带来额外的带宽和功耗压力。
所以,手机芯片厂商现在需要解决的,不只是提高GPU的AI算力,更是如何让神经网络计算足够高效地融入渲染管线。
今年高通、联发科的新一代旗舰平台,恰好给出了各有侧重的思路。
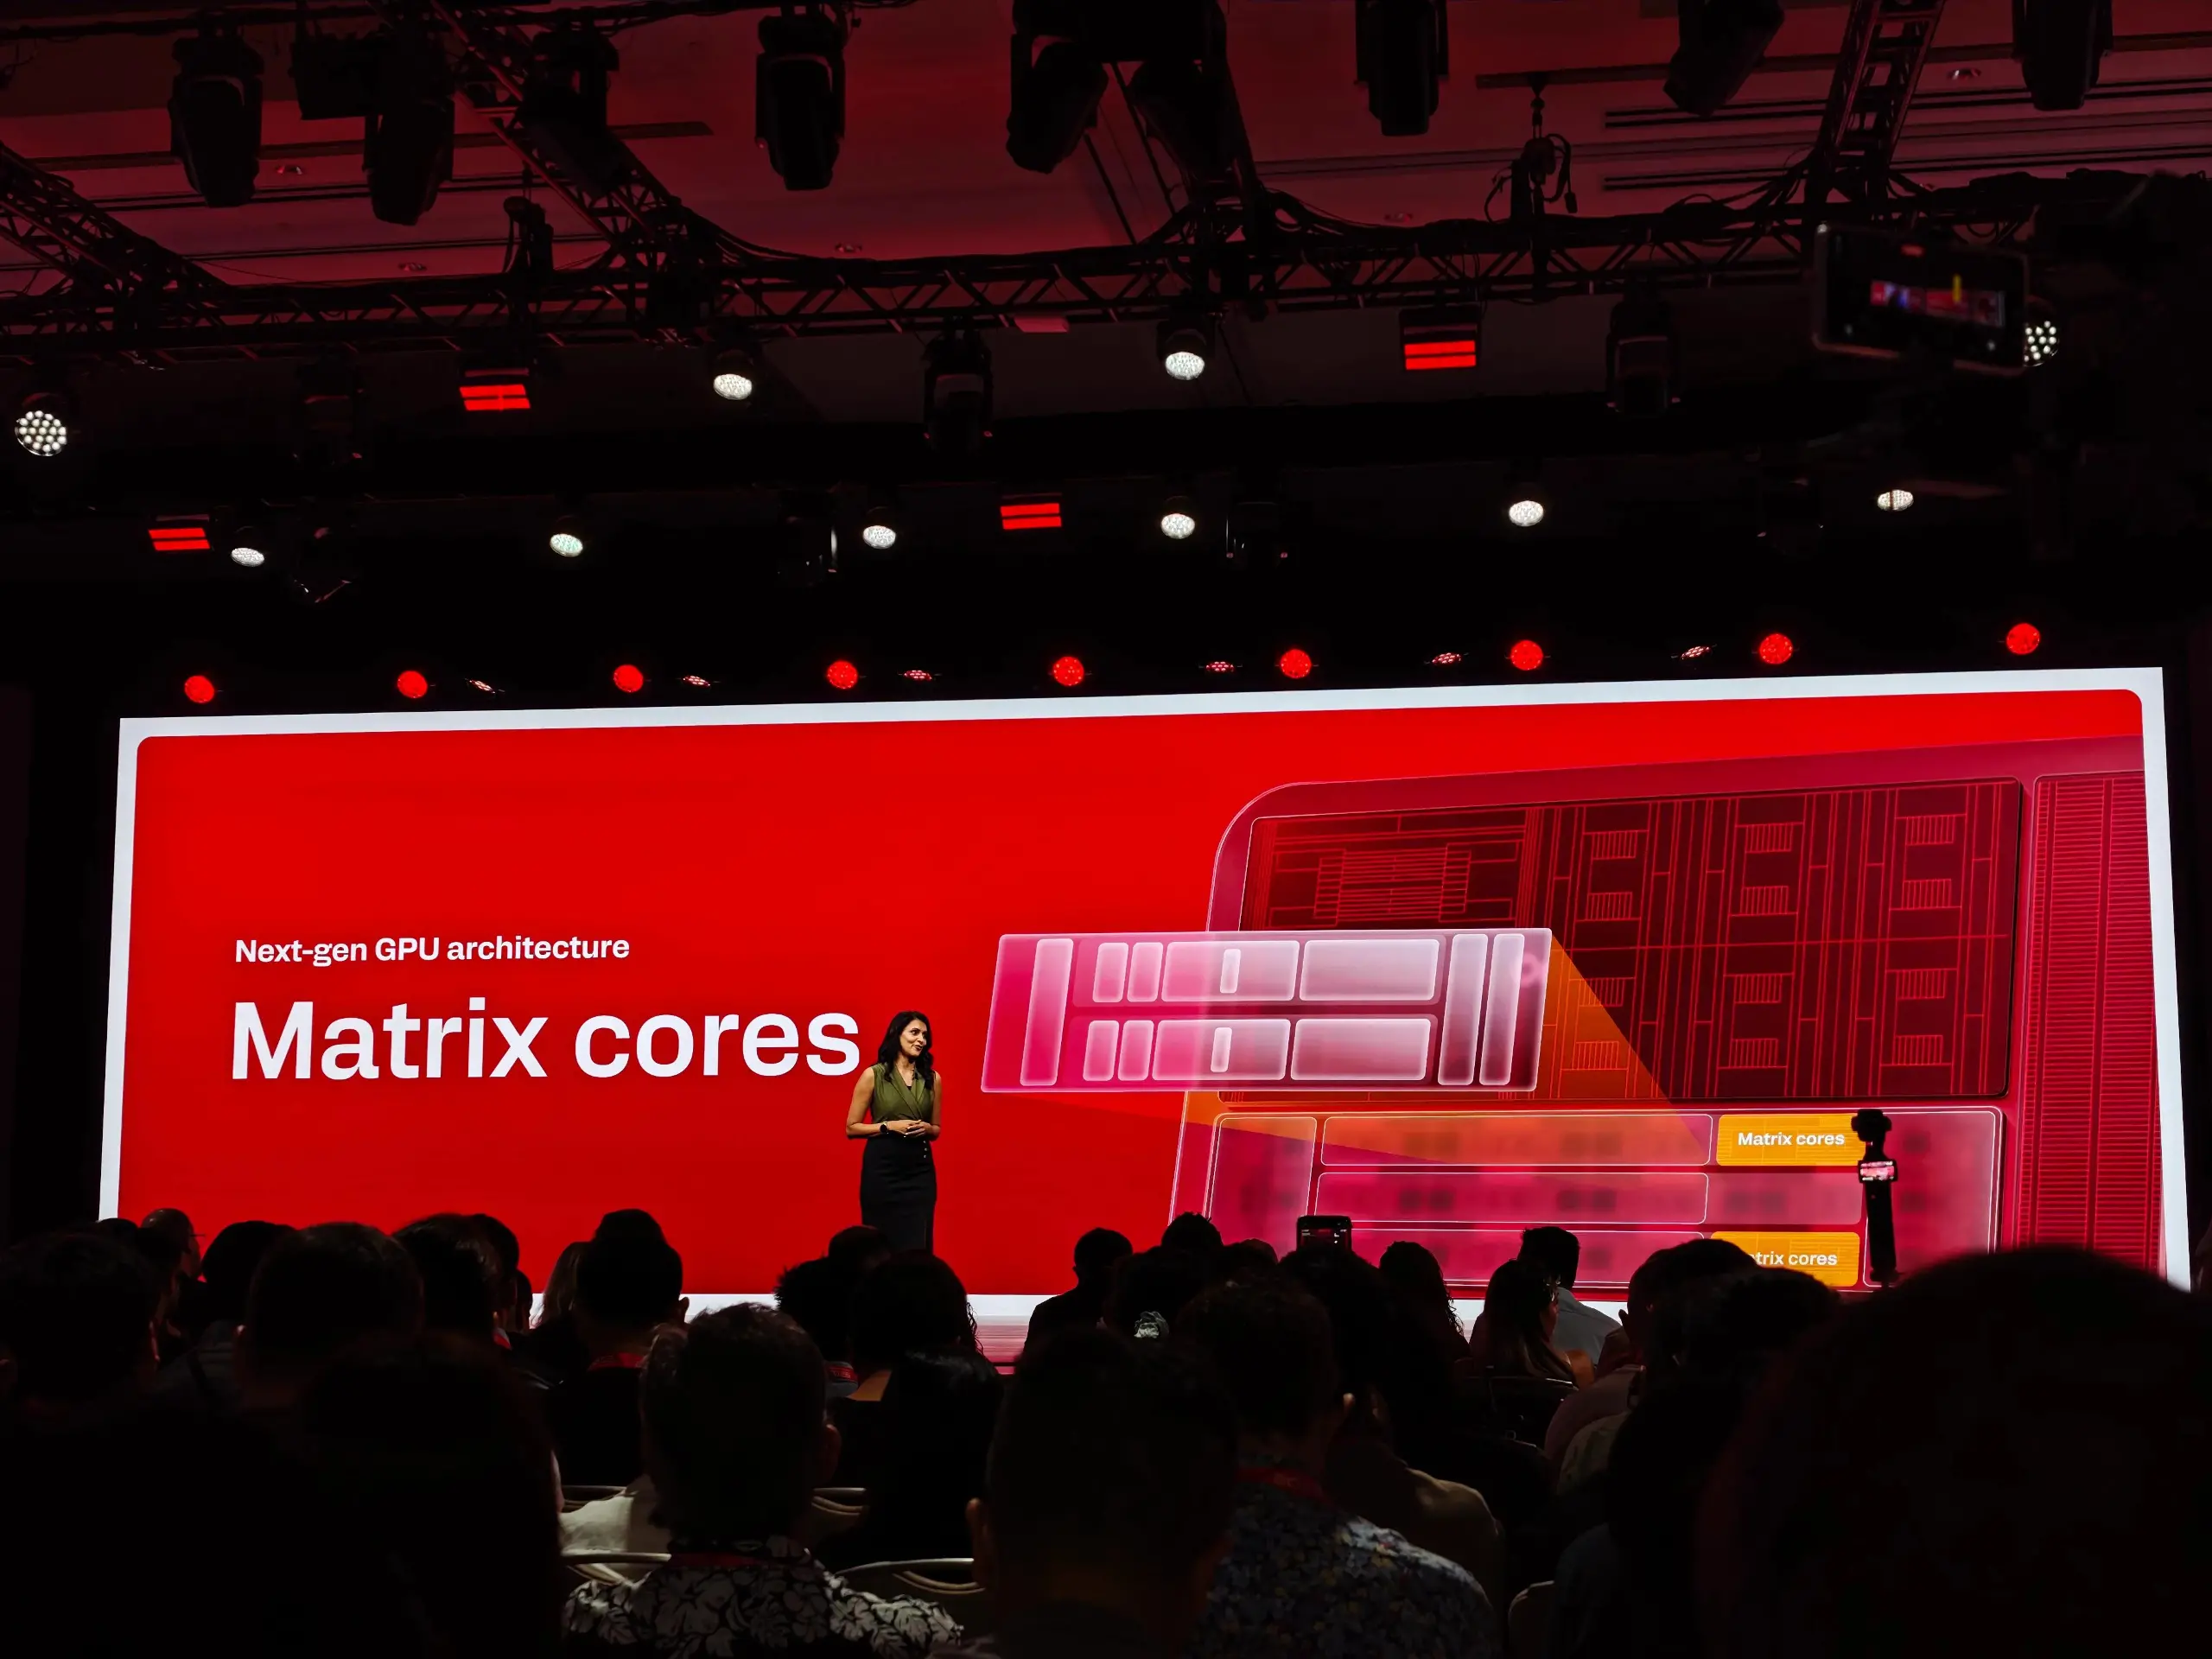
高通在第六代骁龙8超级至尊版上推出了Adreno Neural Fusion神经渲染技术,同时首次在Adreno GPU内部加入专用的Matrix Cores矩阵计算核心,GPU可以用专门的矩阵计算硬件,更高效地处理神经网络任务。
第六代骁龙8超级至尊版,图片来源:雷科技
比如神经超分辨率所需的颜色、深度和运动矢量数据,本来就存在于图形渲染流程中,GPU可以直接调用Matrix Cores进行推理,而不必专门将数据交给另一颗处理单元。
高通还为此配备了18MB的Adreno HPM片上高速缓存,尽可能将模型运行所需的中间数据保留在GPU内部,减少对外部内存的访问。
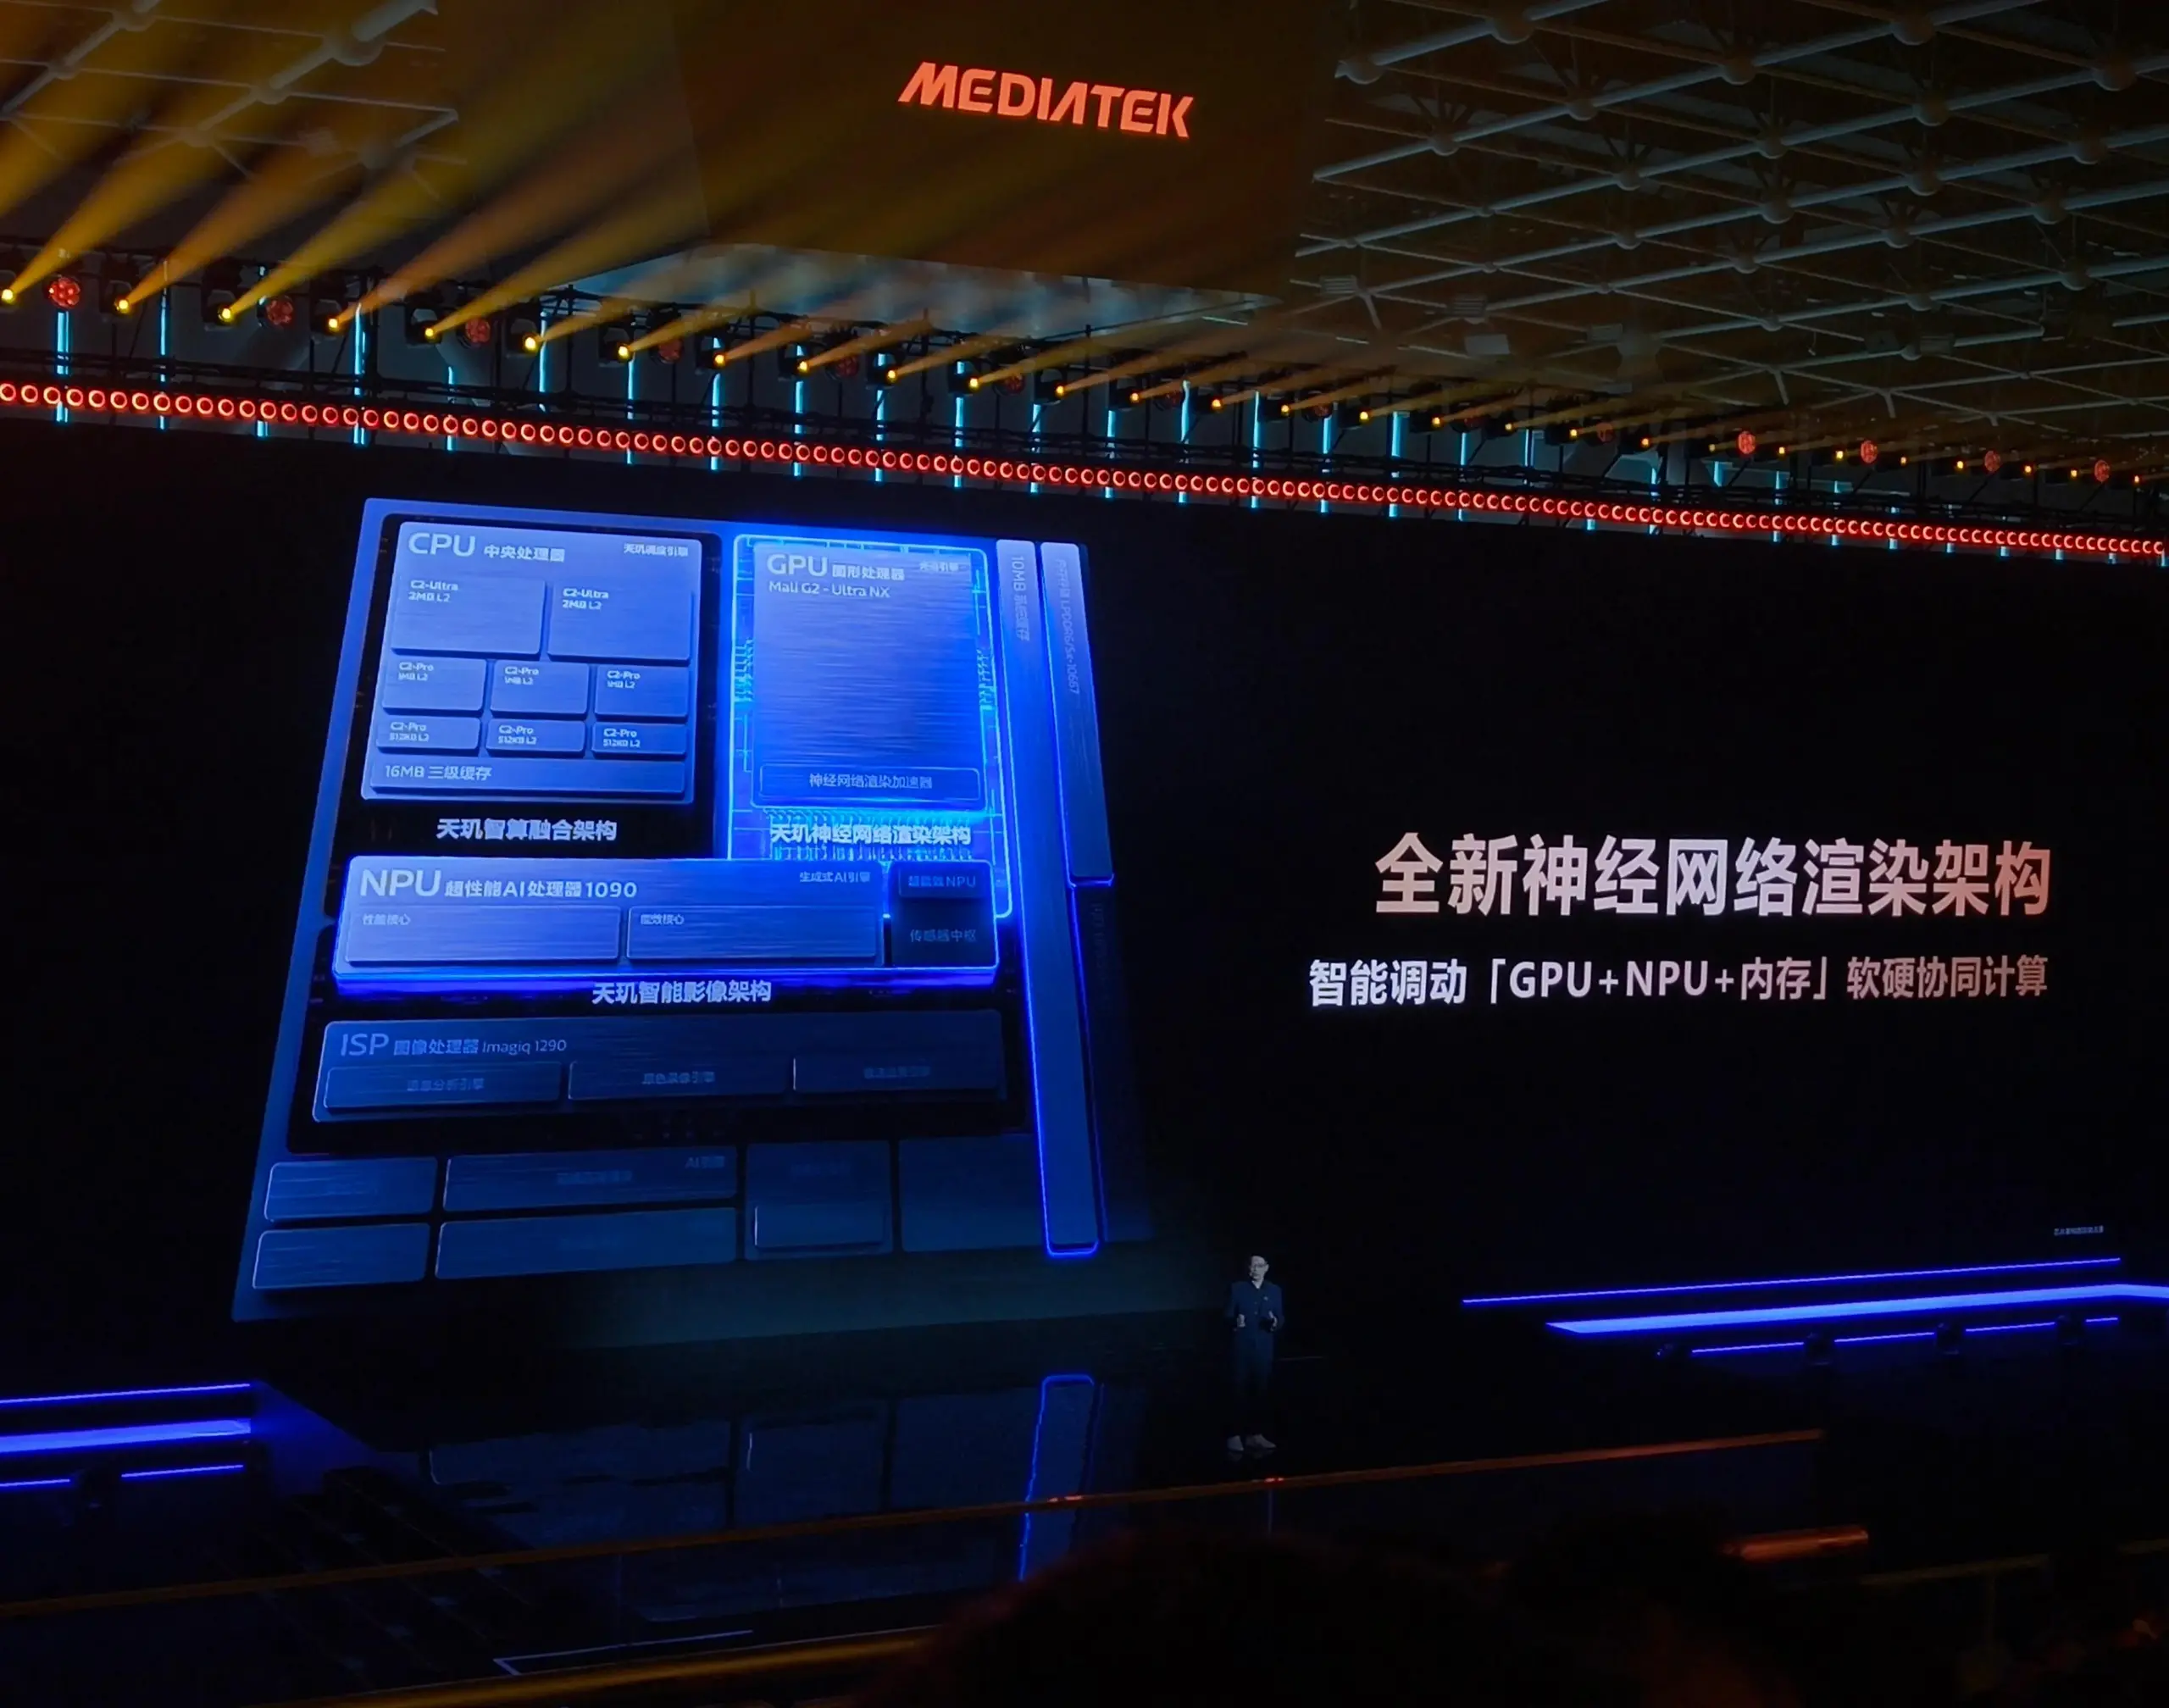
联发科则在天玑9600 Pro上首次引入天玑神经网络渲染架构,核心在于GPU与NPU之间的即时同步互连,让两个原本相对独立的计算单元能够更高效地协同工作。
天玑9600 Pro,图片来源:雷科技
简单来说,高通更强调把神经网络计算直接放进GPU内部,联发科则强调打通GPU与NPU之间的连接,让传统图形计算和神经网络计算能够更紧密地结合。
配合新的动态缓存架构,联发科希望在保持光栅化、光线追踪能力的同时,通过神经网络提高超分辨率的画质与处理速度。
两家的思路也并非完全分开。按照高通的SDK说明,在没有Matrix Cores的设备上,Adreno Neural Fusion也可以通过GPU与NPU协同完成推理。毕竟,GPU内部的矩阵计算也需要占用芯片面积和功耗预算,而独立NPU如果能够通过高效互连参与渲染,也可能发挥自身在AI计算能效上的优势,并不存在绝对的优劣。
但无论是苹果、高通还是联发科,目前的手机神经渲染都还处在相对早期的阶段。
尤其是与DLSS 5相比,手机端已经明确公布和开放的能力,仍然更多集中在超分辨率、降噪、帧生成,以及部分可编程神经着色技术上,距离利用生成式AI大规模增强游戏中的材质和光照表现,还有不小的距离。
但这并不意味着手机需要完全照着DLSS 5的发展路线前进。
事实上,DLSS 5过去半年多的迭代已经证明,神经渲染模型的计算成本还有相当大的优化空间。更小的模型、更高效的推理,加上针对神经网络计算重新设计的GPU架构,都可能让过去只能在高端PC上实现的部分技术,逐渐具备在手机上运行的条件。
更重要的是,从苹果到高通、联发科的一系列动作,意味着手机芯片已经开始从硬件和开发工具两个层面,为更复杂的神经渲染做准备。
写在最后
如果说过去移动GPU的竞争主要还是围绕传统图形性能和光追能力展开,那么接下来,神经网络能够以多低的成本参与渲染、又能替代多少昂贵的传统计算,很可能成为新的竞争焦点。
对于手游和玩家而言,这或许也是一个值得期待的变化:未来游戏画质的提升,不再只能等待传统图形算力的提升节奏。