最近AI圈开始流行起来用Opus 5.5拍电影。你没听错,这个压根不具备看视频能力的模型,竟然可以用来拍电影。
事情的起因是一位名为anabology的博主,他抱着试一试的心态,花了5分钟的时间给Opus 5.5写了提示词和情绪板,以及给模型开了调用Midjourney的使用权限,然后他就去睡觉了。
12个小时后,Opus 5.5生成了一段非常连贯的反乌托邦微电影,并且画面中的人物、风格和叙事始终保持统一。
马斯克转发了这个视频,随后表示“这已经是AGI的80%到90%了”。接下来连着几天,马斯克都在社交媒体上转发这类Opus 5.5拍的电影,并且配文都是赞赏。
正是由于这件事,原本是讨论代码、软件的技术社区,开始兴起了一股Opus 5.5拍电影的热潮。
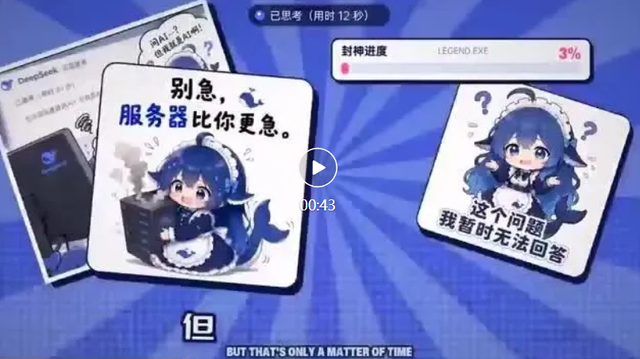
比如下面这个视频,它所采用的制作方法就和anabology相同,用Opus 5.5给DeepSeek还没发布的V4.1 Pro拍了一个二次元风格的预告片。
01
为啥Opus 5.5能拍电影?
在整部微电影里,Opus 5.5其实一帧画面都没有“生成”过。
在整部微电影里,Opus 5.5其实一帧画面都没有“生成”过。
Opus 5.5的作用是导演。它负责研究提示词、歌词、分镜、剪辑,以及每一帧的动态设计。至于画面里最基础的那一层,也就是每个镜头的关键帧底图,则是交给Midjourney这样的图片生成模型来产出。
这套做法被称为“编排式混合制作”。通用大模型负责统筹,专业的图像模型负责出图,最后再由代码把它们串成一部片子。
正如开头所说,除了提示词和图片生成模型的调用权限以外,anabology还给了Opus 5.5一个情绪板(moodboard)。
情绪板是影视、广告、设计行业里很常见的东西,简单说就是一组参考图加几句关键词,用来提前定下整部作品的“调性”,比如整支影片应该是什么色调、什么光影、什么质感、什么情绪。
导演拿着情绪板去和美术、摄影沟通,大家就不会各画各的。
到了Opus 5.5这里,情绪板的作用就相当于主提示词,Opus告诉图片生成模型该生成什么内容,图片生成模型再对照着情绪板去生成图片。所以几百张图出来,人物和风格才不会跑偏。
还有一点,视频的数学本质就是编程。
视频无非是一串连续的帧,Opus在做视频的时候,就是在不断回答第N帧应该长什么样。
如果能写出一个“给定时间点,算出这一帧”的函数,渲染就变成了一个确定性的代码问题。
镜头推拉、人物位移、转场淡入淡出,说到底都是随时间变化的参数。而这正是编程模型最熟悉的领域。
因此,拍电影本质上是一个复杂的长任务管理。
整条流程里,Opus 5.5一人分饰四角。它是导演,负责敲定分镜节奏与视觉风格;它是制片,负责拆解任务、并行调度多段代码;它是画师,只不过它不自己画,而是给Midjourney写提示词,要求它按照电影的画面需求来生图;它还是剪辑,负责音画同步与成片输出。
开发一个软件,和拍一部电影,对模型来说其实是同一种能力,它们的底层逻辑,都是把一个大目标拆成许多小步骤,然后一步一步完成。
最关键的一点,Opus 5.5它能自己检查自己。
Opus 5.5虽然看不了视频,然而它能看图片。所以它靠看渲染出来的静态截图来发现问题,比如人物脸变了、构图歪了、字幕盖住了主体,然后再回头去改代码。并且生成与验证都在同一个上下文里自动完成。
这就是为什么Opus 5.5明明不是一个视频生成模型,却能一口气做出5分钟的片子,还能保持画面连贯。
传统视频模型一次只能生成几十秒的画面,每一段都是一次独立的“抽卡”,这个镜头里人物长这样,下个镜头变成另外一个模样,也是常有的事。
可Opus 5.5不一样,它是靠管理出来的。
02
既然如此,我也凑个热闹
既然话都说到这份上了,那我能不能也按照anabology的方法,用Opus 5.5拍电影呢?
于是我准备了第一个提示词:为我拍摄一部电影,主题为‘在那黑色的无知之海上,吾乃闪耀的知识灯塔。’全程不得使用如Seedance之类的任何视频生成模型,其余模型皆可使用,不做限制。
情绪板:真人微电影,实景实拍。轻微胶片颗粒,真实皮肤质感,发丝细节,环境真实景深,安静治愈叙事感,院线独立电影质感。
负面提示词为:动画,CG,二次元,夸张美颜,塑料质感,变形手,多余肢体,鲜艳滤镜,漫画,特效,水印。
于是就有了这个视频。
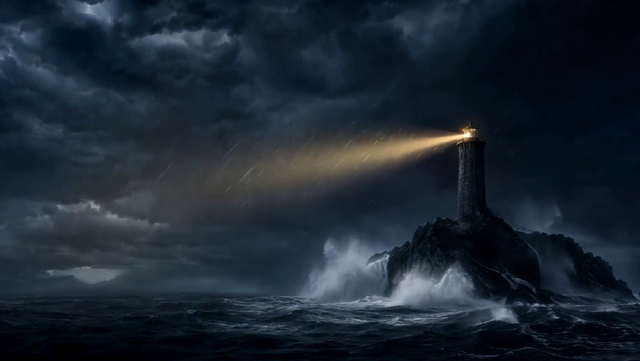
以下为Opus 5.5的剪辑过程。
“在那黑色的无知之海上,吾乃闪耀的知识灯塔。”本是一句来自游戏中的台词,可Opus 5.5是完全按照字面意思来理解并制作视频的。
于是我决定加大难度,我要Opus自己先研究我的提示词,再根据提示词生成各种素材,并且这次我会只提需求,而不描述画面内容。
提示词:游戏王5d's里有这样一幕,游星对布鲁诺(安提诺米),可在TV动画中,并没有出现加速同调星尘龙这张卡,它是后来OCG在2022年的追加卡。加速同调星尘龙这张卡很特殊,它的卡图取自动画原画,并且它代表了布鲁诺将加速同调这门技术传递给了游星。所以我想让你还原动画里布鲁诺对游星,然后由游星召唤出加速同调星尘龙,但此时,游星和布鲁诺一起喊出召唤台词。
情绪板:TV动画美术参考板,游戏王5D's原版动画画风,2000年代日式赛璐璐动画,手绘原画质感,干净轮廓线,少量胶片噪点。
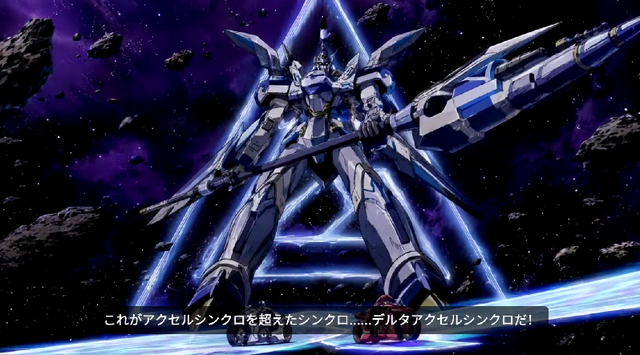
以下为Opus 5.5调用Midjourney所生成的关键帧图片。
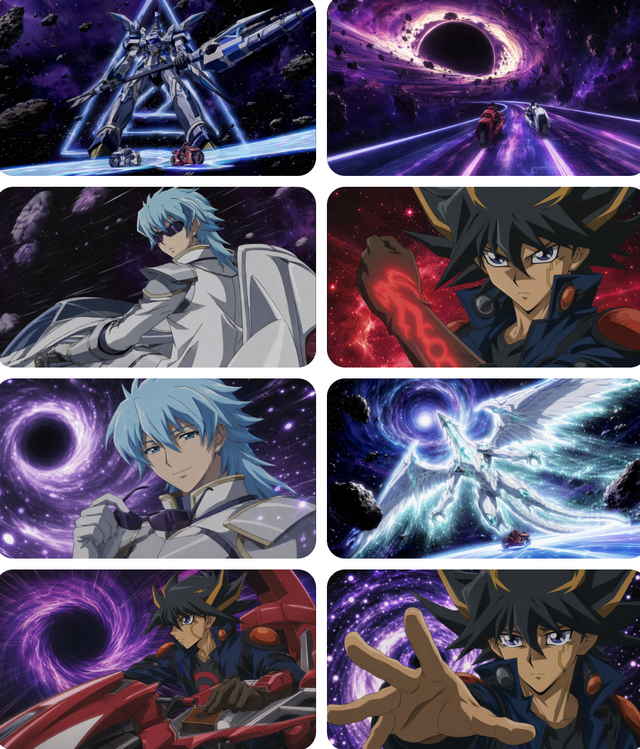
可以看到,虽然视频中不动游星很还原动画原作,但布鲁诺与原作偏差比较大,加速同调星尘龙除了是“龙”以外,外形几乎全错。
还有一点,就是这次Opus 5.5一口气生成了1分半的视频,其生成长度远超任何视频生成模型。
相较于其他视频生成模型,根本不需要给Opus 5.5任何参考的构图、台词,它完全可以自己去找参考。
尤其是在视频第48秒处,Opus更是把动画中的名台词“加速同调连光都可以超越”加了进去,显然它对场景的理解非常到位。
03
Seedance危险了
坏了,这回Opus要抢Seedance饭碗了,不仅一口气能生成长视频,还能自己找素材。可事情远没有那么简单。
视频生成模型跟Opus最大的差别在于,传统视频模型基于海量素材,一次性生成完整的画面;而Opus 5.5走的是纯代码渲染,逐帧搭建。
其最大差异在于可编辑性。
用传统视频模型,你对结果不满意,往往只能去改提示词,然后整条重新生成。重新生成意味着一切都要重来,上一版里满意的部分也可能跟着消失,这就是常说的“抽卡”。
Opus则不一样。正如B部分展示的剪辑截图一样,哪个镜头不对,就只改对应镜头的几行代码,参数、运动、风格都能精确控制,且画面里的元素还能分层拆解。
相当于是Opus5.5把专业的视频模型,给降格成了下游的“渲染工序”。
一旦分镜、走位、运镜这些上游资产,全都由通用模型掌握,那么视频模型在产业链上的价值就降低了。
传统的视频生成模型依然重要,但它不再决定创意本身,它变成了流水线末端的机器,只负责按照Opus的要求生产素材。
其实GPT-6 Astra就已经展示过类似的能力,它可以在Blender里搭白模,然后再甩给 Seedance 2.5渲染。也就是说,上游的“怎么拍”,已经由通用模型说了算,Seedance只负责把它拍出来。
Seedance一直在卷的是“像素”,比如更真的脸、更长的时长、更高的分辨率。这些都是实打实的进步,但Opus 5.5根本不在像素层打。它比的不是谁的画面更细腻,是谁来决定画面该是什么样子、谁来掌控整个创作流程。
所以,几十秒和几分钟的差距,只是表象。真正的危险在于入口。可能在未来的某一天,视频创作者就不想打开视频生成模型了,他们只需要通用大模型。
一旦入口被通用大模型拿走,专业视频模型就从“创作者的第一站”,变成了“工具柜里的一个API”。
今天调用Seedance,明天换成别的渲染器,对上游的导演来说只是改一行配置的事。