首页
>
资讯
>
独家 | 清华 AIR 首届博士李健雄创立本溯智能:五源资本领投,押注动作原生具身模型
独家 | 清华 AIR 首届博士李健雄创立本溯智能:五源资本领投,押注动作原生具身模型
常春藤、线性、华山资本跟投,AIR副教授詹仙园任首席科学家。
作者丨邓哲敏
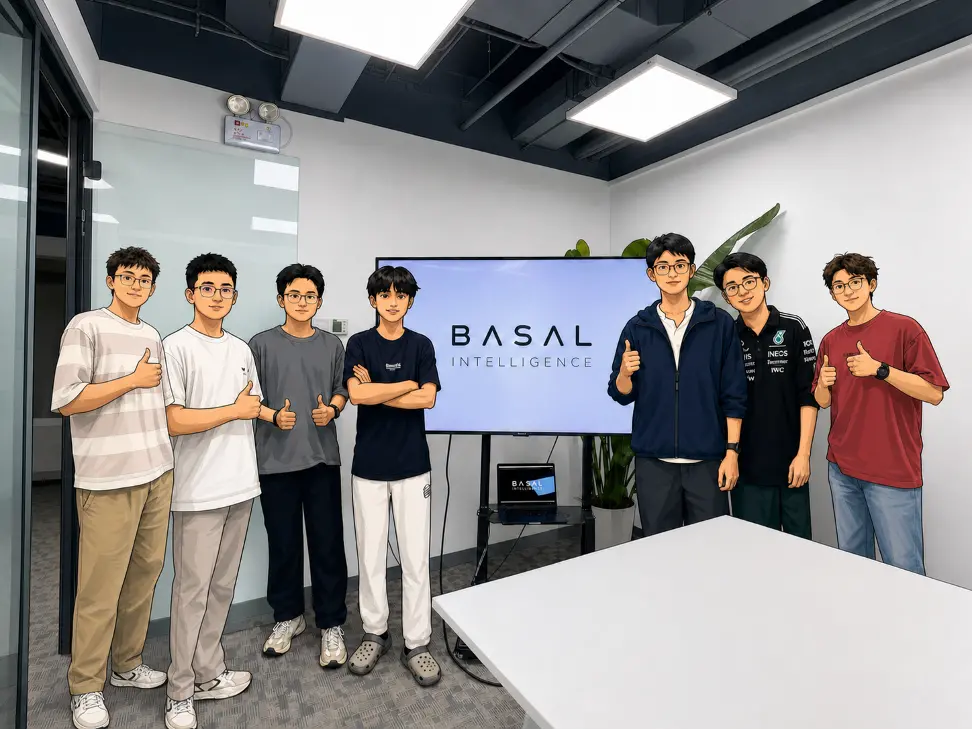
雷峰网·鲸犀独家获悉,清华大学智能产业研究院(AIR)首届博士生李健雄已毕业,并创立具身智能公司本溯智能(BASAL Intelligence,简称 BASAL)。目前,本溯智能已获得五源资本领投,常春藤资本、线性资本、华山资本 WestSummit Capital 参与投资。
团队核心成员包括首席科学家、清华 AIR 副教授詹仙园,以及 7 名长期合作的年轻研究者。据本溯智能称,创始团队组建前,核心成员分别拿到字节跳动 Top Seed、英伟达、小米等企业的高薪 offer 和海外高校博士录取机会,合计放弃的年薪总包接近 4000 万元,其中李健雄个人放弃的最高年薪总包接近千万元。
本溯智能官方资料显示,公司不会追随市面上已成主流的“预训练基模+后训练部署”范式,而是选择押注动作原生的 In-Context 具身基础模型,试图让机器人在更换场景后无需重新训练,在现场完成学习与适应。
当前具身智能的主流路线,是先预训练一个基础模型,再针对每个任务做后训练部署交付。
这套范式在工厂标准化场景下已经跑通,但一旦环境、物体或作业流程发生变化,机器人往往需要重新采集数据、重新训练。面对现实世界中无穷无尽的长尾场景和长尾任务,这条路的规模化天花板显而易见。
本溯智能对此有一个直接的判断:这本质上还是工业自动化的延伸,并不是真正意义上的具身智能。
在团队看来,真实世界中与物理环境交互的动作信息,很难通过语言被完整、准确地描述;现有以语言为中心的 VLA 路线,也因此在精细操作和跨场景泛化上存在先天局限。
本溯智能的目标,是让机器人具备现场学习的能力:当面对训练阶段从未见过的新场景、新任务或新本体时,无需重新训练模型,只需通过少量人类示范和自主尝试,在几分钟内完成快速学习与适应。
本溯智能将其方法论归结为智能决策的第一性原理,提出“动作原生的 In-Context 具身基础模型”技术路线。
区别于现有方案以语言为中心,本溯智能将动作作为模型的核心表达方式,让模型直接学习与世界交互的动作、任务反馈、失败纠正以及人类示范之间的关系。模型的大部分容量用于动作生成,并通过长上下文组织机器人的连续物理交互,使机器人能够根据此前的动作、结果、失败和反馈,持续调整后续决策。
本溯智能认为,动作比语言更接近机器人与物理世界交互的本质,而 In-Context Learning 则让模型具备在部署后持续学习的能力。
据雷峰网·鲸犀观察,走一条人迹罕至的小路,意味着必须和行业主流叙事正面交锋。以多模态大模型、自然语言指令为中心的 VLA 路线,仍是资本与产业界最熟悉的语境,客户也更习惯让机器人听懂人话的产品叙事。弃用语言中心、强调动作原生,短期内会显著抬高落地沟通成本。本溯智能得向客户解释清楚,动作原生模型交互并不比语言指令更难集成进现有产线。
支撑上述路线的,是团队自 2024 年起持续研发的两项核心技术——跨具身模型 X-VLA 与高效隐空间世界模型 ODEWorld。
X-VLA 聚焦跨本体动作表达。仅使用不足 1000 小时的预训练数据,便在多项第三方评测中取得领先结果;其团队基于该模型,从 400 多支参赛队伍中脱颖而出,获得 IROS 2025 智元机器人挑战赛总冠军。ODEWorld 则通过连续物理时间的隐空间建模,为长时序物理信息表达和机器人的 In-Context Learning 提供更高效的技术基础。
据公开资料显示,本溯智能是国内最早系统探索跨本体快速适应与 In-Context 具身学习方向的团队之一。
本溯智能关注的是具身智能规模化的一个关键成本矛盾:越来越多的企业愿意引入机器人,却难以承受每换一个场景就要重新采集数据、重新训练的高昂代价。如果 In-Context 具身学习真的成立,部署成本将随着机器人学习经验的积累持续下降,而非随场景增多线性攀升,这是这门生意最诱人的地方。
从 X-VLA 在 IROS 竞赛中的冠军表现,到 ODEWorld 在长时序物理建模上的技术积累,本溯智能已在学术层面展示出相当的技术深度。团队接下来面临的关键挑战,在于将几分钟现场学习的能力,在更多真实场景、更多本体、更多任务类型中持续验证。