王拓为身上有一组典型的“清华系AI创业者”标签:00后、清华大学计算机系博士在读、师从清华泛在智能实验室任炬教授,博二即完成博士阶段核心成果。
但比起这些标签,他还有一个特质,即始终关注那些“会长期发生”的问题。因此,在云端承担大规模模型训练和复杂推理需求的背景下,王拓为将关注重点放在另一类问题上:如何让端侧AI的推理、执行与数据处理能力真正落地到真实设备中。2025年1月,他创立北京万象智维科技有限公司(以下简称“万象智维”),组建团队持续推进端侧AI的产品化与商业化。
围绕端侧智能,团队逐步形成了以端侧模型推理引擎 OmniInfer 为核心的技术路线,并进一步延伸至模型部署、任务执行、端云协同等基础设施能力。随着端侧 AI 从“模型能够运行”走向“系统能够持续、稳定地承载智能任务”,团队也将软件能力进一步拓展至硬件与整机形态,并围绕更多端侧应用场景开展探索。
一、带着问题走出实验室
从清华大学泛在智能实验室到万象智维位于AI原点社区的办公室,只有几公里。但对王拓为而言,他跨越的,是从“技术成立”到“技术落地”的距离。
读博期间,他长期开展大模型系统与端侧高效推理研究,重点围绕模型动态稀疏性与端侧两级存储架构,探索通过模型布局、缓存管理、推测执行和异构计算等系统优化,使更大规模的模型能够在资源受限的终端上高效运行。这些研究为万象智维后续构建端侧推理引擎、模型调度框架和移动端智能体系统提供了重要技术基础。博士二年级时,他已经提前完成了大部分博士阶段的核心成果。“其实那时候,已经足够毕业了。”他说。但也正是在那个阶段,一个更现实的问题开始浮现:为什么许多在学术上足够先进的技术,始终无法真正进入真实世界?
他逐渐意识到,决定AI价值的,并不只取决于模型和技术本身,更取决于其能否被产品化、进入真实场景,并在复杂环境中持续运行。
在一次与导师,清华大学泛在智能实验室主任任炬的深入交流中,两人形成了共同判断:如果想继续推动这条技术路线向前,仅靠学术体系已经不够。“我们发现彼此都有创业的想法,就一拍即合了。”王拓为回忆,“而且,如果一件事情我已经看到了方向,却没有尽力去做,我会后悔。”
2025年1月,王拓为正式创立北京万象智维科技有限公司。任炬作为联合创始人兼公司发起人,为公司的技术方向与长期发展提供持续支持。依托实验室在端智能、边缘智能、端云协同以及端侧大模型系统等方向的长期科研积累,团队逐步将前沿研究成果沉淀为可落地的端侧 AI 基础设施能力,并进一步向推理引擎、智能系统、算力硬件等产品方向延伸。
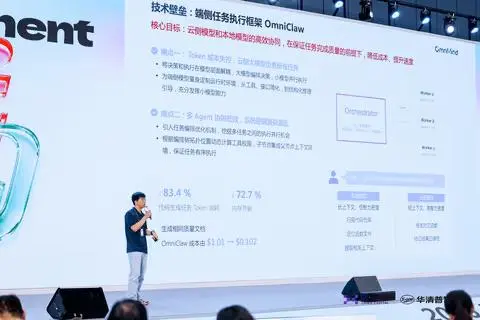
王拓为,万象智维联合创始人兼CEO
万象智维以端侧 AI 软硬件基础设施为核心,围绕终端设备智能升级、系统级端侧解决方案及算力模组等场景,推进企业级项目合作与标准化产品协同发展,提升端侧智能的部署、交付与规模化复制效率。
工业和信息化部办公厅印发的《人工智能中小企业创业支持计划(2026—2028年)》提出,在行业应用、数据服务、智能算力等重点领域培育人工智能创业企业,并支持拓展应用场景资源供给。面向这一方向,万象智维将持续推进端侧模型部署、终端设备智能升级和系统级解决方案的产品化,以场景验证带动技术迭代和应用落地。
二、端侧智能需要怎样的新基础设施
在王拓为看来,端侧 AI 并不是简单地把云端模型“搬到设备上”。云侧与端侧从硬件架构、模型形态到运行方式都存在明显差异,这也意味着过去围绕云端建立起来的 AI 基础设施,很难被直接复用。
首先是硬件不同。云端 AI 的计算体系主要建立在 CPU 与 GPU 之上,拥有充足的显存、内存和高速互联,软件栈也长期围绕 GPU 集群进行优化。而在手机、PC、可穿戴设备等终端上,核心计算平台通常是一颗高度集成的系统级芯片,CPU、GPU、NPU、内存与存储共享有限的功耗和系统资源。端侧推理因此不只是“把算子跑快”,而需要同时考虑计算单元调度、内存占用、功耗以及不同芯片之间的适配。
其次,端侧 AI 所面对的模型形态与云端不同。云端服务多围绕一个或少数通用大语言模型构建;端侧则需要在小模型、量化模型、专用模型和多模态模型之间,结合设备算力、功耗与具体任务进行动态选择和调度。模型也不再只是通过远程接口提供能力,而需要与摄像头、麦克风、文件、传感器及系统权限协同工作。由此,云端常用的模型推理服务、智能体执行框架和运行机制难以直接迁移至终端,需要围绕端侧设备特征重新设计。
因此,端侧 AI 需要一套新的基础设施:既要向下屏蔽不同系统级芯片、计算单元和存储体系的差异,也要向上统一模型部署、推理调度、任务执行和设备能力调用。万象智维希望构建的,正是这样一层位于模型与终端硬件之间的基础设施,使不同模型能够以更低成本完成跨设备部署与适配,并真正成为终端持续可用的系统能力。
三、如何让大模型在端侧跑得快、跑得稳
端侧推理最难的地方,不是把模型搬到手机上,而是要重新思考模型应该怎样适应端侧硬件。相较于云端服务器,端侧设备受限于电池容量、功耗和系统资源,模型运行需要在性能、能耗与内存占用之间重新权衡。“很多在云端行之有效的优化方法,到了端侧都要重新做一遍,本质上是在带着镣铐跳舞。”王拓为形容。
针对这一问题,万象智维自研端侧模型推理引擎 OmniInfer。与传统推理框架主要围绕单一计算单元做算子优化不同,OmniInfer以系统级协同为重点,结合动态稀疏性、CPU-GPU-NPU异构调度、两级存储与数据布局优化,降低大模型在端侧系统级芯片上的资源开销。
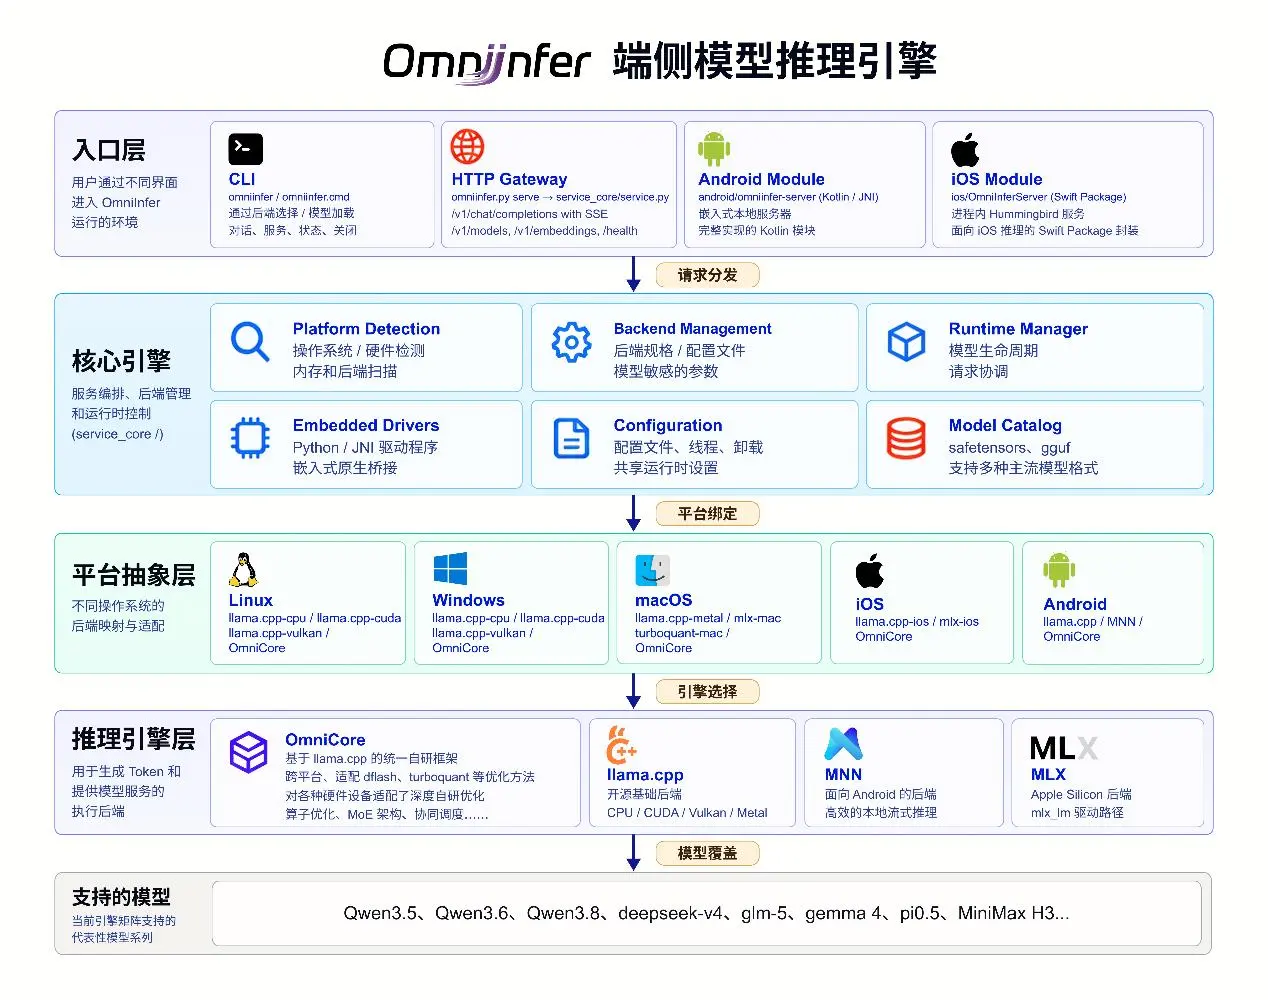
端侧模型推理引擎 OmniInfer
围绕 OmniInfer,万象智维进一步搭建了完整的端侧模型部署工具链。OmniStudio提供模型转换、量化压缩、算子适配与设备部署的一体化能力,覆盖 Android、iOS、macOS、Windows、Linux 等主流平台,并降低跨芯片、跨系统适配的工程成本。在此基础上,公司又进一步布局 OmniQuant、OmniRouter、OmniClaw 等能力,将技术边界从单一模型推理延伸至模型压缩、端云调度和端侧智能体执行。
万象智维认为,端侧AI基础设施的关键能力在于形成一套适配不同模型、系统级芯片与终端形态的基础设施。围绕这一目标,团队将能力体系划分为三个层次:底层解决模型的高效运行,中间层解决快速部署与跨设备适配,上层则进一步支持模型调用本地工具、执行任务并与云端能力协同。
在端云协同上,万象智维并不把端侧与云侧视为替代关系:云端仍然适合承担复杂推理、大规模计算和全局编排,而端侧则更适合承接高频、实时、与本地数据和设备能力紧密相关的任务。通过合理分流,团队希望在保障任务质量的同时,降低成本、改善���应速度并提升对本地数据的保护能力。
四、从科研积累到产业实践
万象智维团队既依托清华大学泛在智能实验室OmniLab的长期研究积累,也具备产品化与工程化落地经验。除王拓为外,多位来自实验室的博士生长期围绕端侧 AI、大模型系统、异构计算与智能体等方向开展研究,并通过研发协同深度参与公司的技术推进。团队目前约 30 人,由核心全职团队与科研协同力量共同构成,并持续保持与实验室科研团队的紧密技术联动。
此前,万象智维曾开源过一个底层技术框架。起初,团队认为这只是一次面向少数开发者的技术释放,但项目上线后,社区反馈远超预期:大量开发者持续提交技术优化建议,有人凌晨三点仍在讨论产品架构,甚至有海外用户主动提出协助建立国际社区。一位来自墨西哥的开发者,在跨越时差与语言障碍的情况下,自发承担起海外频道的长期维护工作。
这种“科研创新 + 产业实践”的协同,是万象智维推进端侧 AI 基础设施产品化的重要基础。未来,公司将继续以基础设施能力服务硬件与终端生态,并在此基础上稳步拓展面向个人级、家庭级的端侧应用场景。
“如果未来 AI 要真正理解一个人、服务一个人,那么一定会有越来越多的智能,运行在离人更近的地方。”王拓为在采访中留下了这样一句话。端侧AI的价值,不只在于将模型部署到设备上,更在于在用户授权与安全边界内,提升模型对真实场景的响应和服务能力。沿着这个问题继续往下走,AI 的下一站,或许并不只在更大的云端,也在每个人的身边。