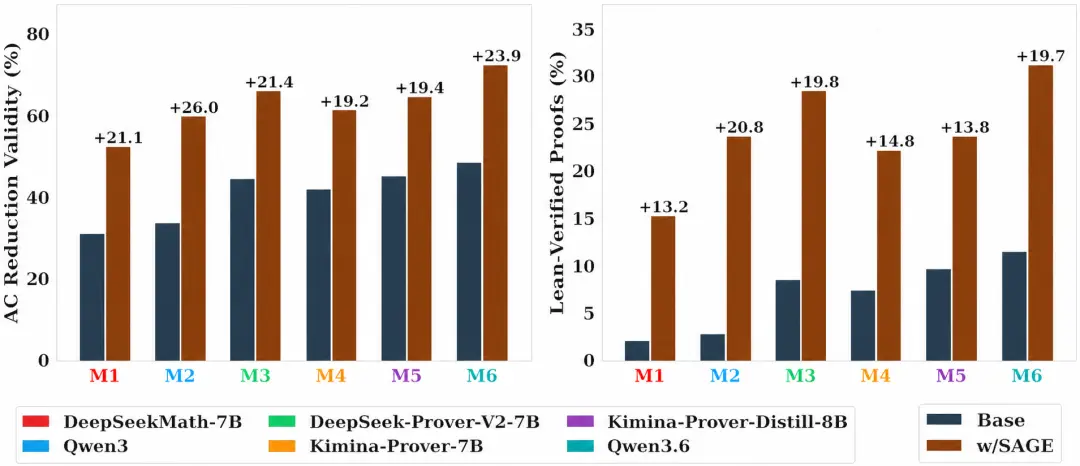
大模型解短题常能给出流畅答案,推理链一长,却可能每一步都看似合理、终点仍然失效。来自弗吉尼亚理工大学、威斯康星大学麦迪逊分校和达特茅斯学院的研究团队在 NeurIPS2026 论文中提出 SAGE:用符号闭包分析(SCA)解释长推理中的探索偏差与累积偏差,再把这一诊断变成训练时的结构引导。在 12 个基准、7 个模型家族的评测中,SAGE 的总体表现优于所比较的后训练方法;在 Andrews–Curtis(AC)实例上,Qwen3 的 Lean 验证通过率接近基础模型的 8 倍。
-
论文名称:SAGE:MitigatingLong-HorizonReasoningBiasesviaTopologicalGuidance
-
会议:NeurIPS2026
-
作者:XinyueZeng,JiaweiZhang,YujunYan,DaweiZhou
-
单位:VirginiaTech,UniversityofWisconsin-Madison,DartmouthCollege
-
论文链接:https://arxiv.org/abs/2609.30192
-
代码链接:https://github.com/Susan571/SAGE-NeurIPS2026
一、长推理的难处:终点才有奖,岔路却越来越多
依靠最终答案给奖励的后训练,已显著提升模型的数学推理能力;但长任务里的奖励往往稀少而滞后。一条解题路径可能经过几十甚至上百次变换,训练过程却只知道结尾成败,难以判断从哪一步开始偏离。
一种思路是让人类或过程奖励模型逐步评分,代价是要取得可靠的过程标签或验证器;另一种思路是改造探索与奖励,却不必刻画任务本身的结构。SAGE 因而追问:为什么模型更容易走向 “看起来对” 的分支?终点奖励为什么很难把早期偏差纠回来?
论文用 Andrews–Curtis(AC)任务作为压力测试。给定一个由生成元与关系式构成的群表示,模型要依次执行允许的 AC 变换,尝试到达平凡表示。每一步是否合法可以检查,但合法操作不等于已经找到通向目标的路径;真正的成功信号要到整条序列结束才能确认。
实验求解的是 1,190 个按论文设置构造的 AC 实例。这一任务把 “局部合法、全局难成” 的矛盾放大,适合检验长程推理是否能持续朝目标推进。
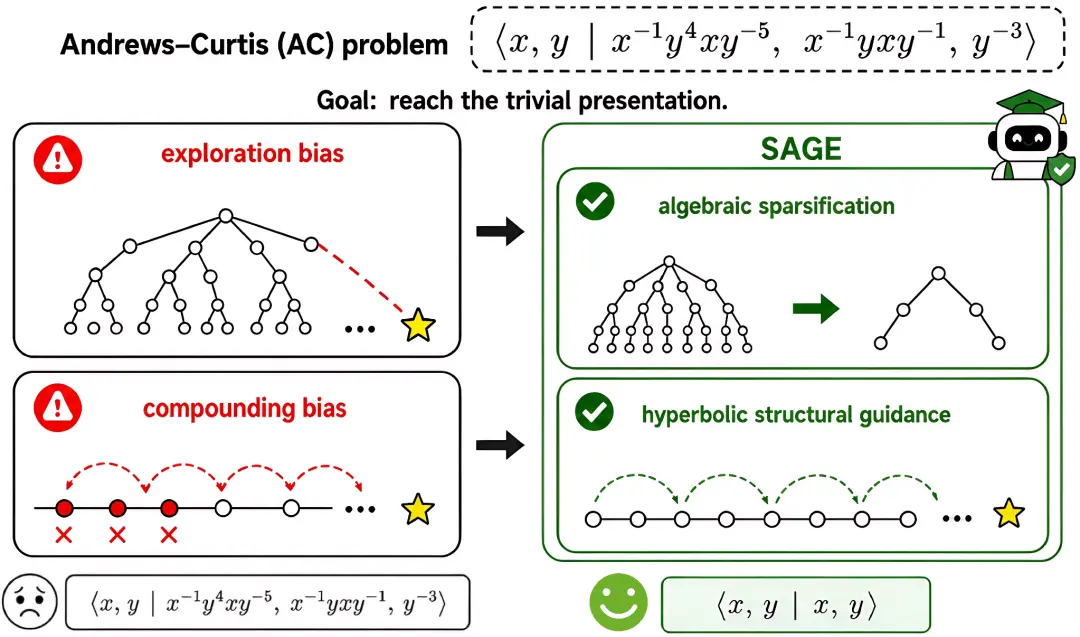
图 1:以 AC 任务为例,SAGE 分别用代数稀疏化和双曲结构引导缓解两类偏差。
二、SCA:把两种 “走偏” 放到同一张结构地图上
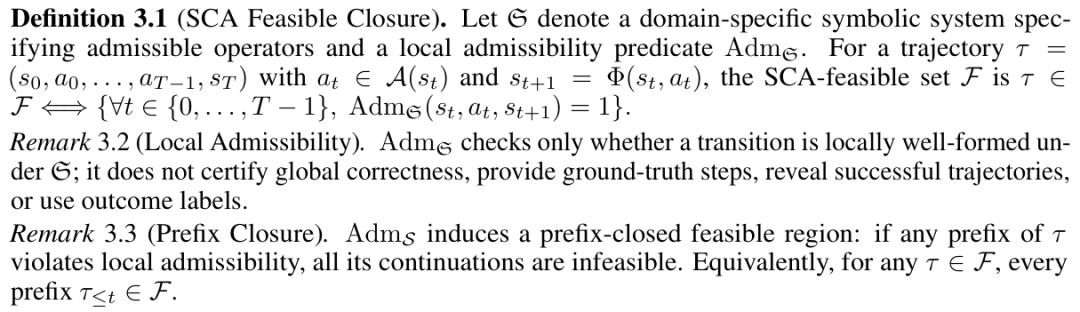
SCA(SymbolicClosureAnalysis,符号闭包分析)先给 “还能继续走” 的路径下定义:从起点出发,只要每一步都符合任务规定的局部操作,就属于局部可行域 F。它具有 “前缀封闭” 性质 —— 一旦某一步不合法,后面的延续也不能把这条前缀变回合法路径。这里的可行只是局部条件:F 中也可能有走不到答案的路线,真正成功的轨迹集合更小,而且训练时并不知道。
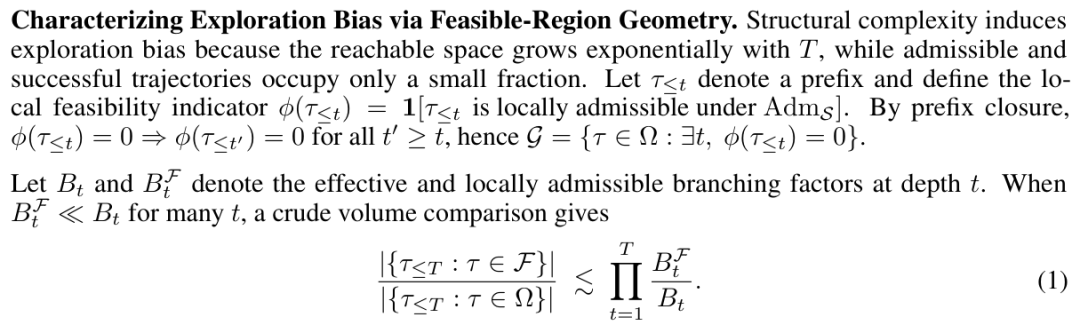
第一重困难是探索偏差。设第 t 层的有效分支数为 Bₜ,其中局部可行的分支数为 Bₜᶠ。论文给出的几何直觉是:深度 T 的可行前缀占比大致受到各层 Bₜᶠ/Bₜ连乘制约。若许多层都只有少量分支可行,这一比例会随深度迅速缩小;终点奖励有限时,随机采到有用轨迹就更难。
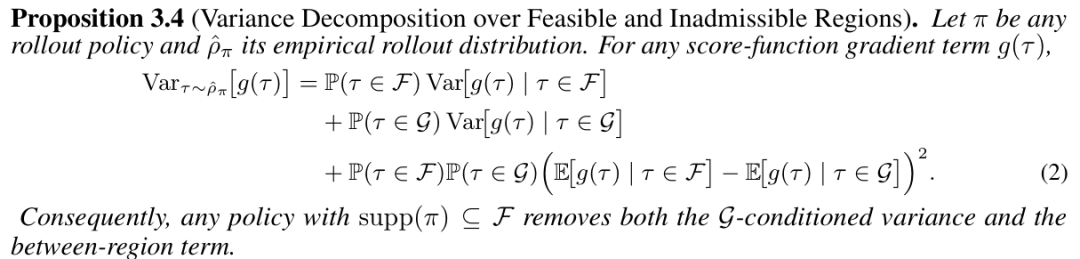
论文进一步把策略梯度的波动拆成三部分:可行域内的方差、不可行域内的方差,以及两类轨迹平均信号不同造成的方差。如果采样真正集中到 F,后两项会消失。这一分解解释了为什么 “把预算花在哪些分支上” 会影响学习信号的质量;它并不意味着局部合法就能保证解出题目。
第二重困难是累积偏差。仅在终点给奖励时,早期决策缺少直接纠偏。论文考虑带 KL 正则的优化:若参考策略找到成功轨迹的概率为 p、终点奖励上界为 Rmax、KL 惩罚强度为 λ,则最优策略与参考策略的总变差距离有如下上界。
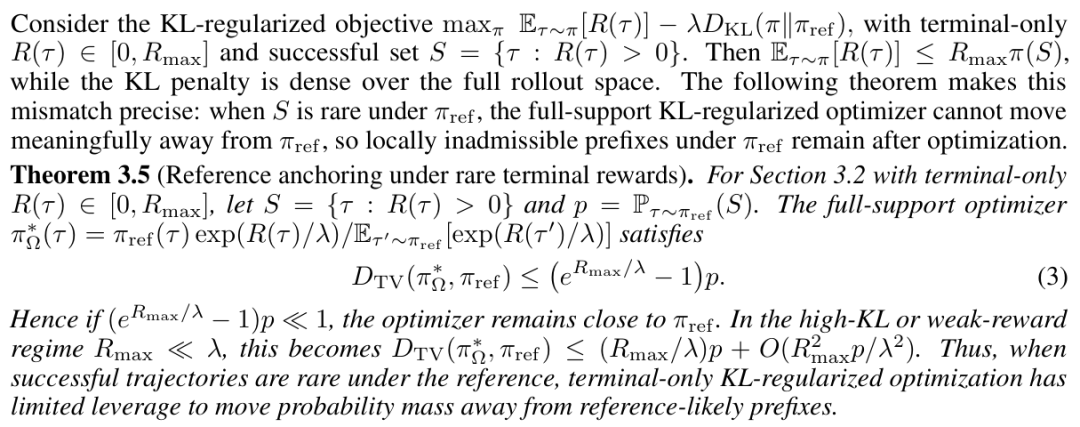
当成功轨迹极罕见、奖励相对于 KL 约束又不强时,这个上界很小;训练难以大幅摆脱参考模型原有的早期选择,微小偏离因而可能沿长链延续。
SCA 因此给出了两个明确的设计目标:一是把采样概率集中到更有希望的局部可行分支;二是让前缀在到达终点前就得到与目标结构有关的反馈。AC 这样的符号任务能精确定义局部合法性;自然语言任务则需要估计残差和目标锚点,理论保证不能原样搬过去。
三、SAGE:让理论诊断参与训练
SAGE(StructuralAdmissibility-GuidedExploration,结构可采纳性引导探索)把上述两个目标写成互补的结构势函数。它们不是直接给出标准解,而是在训练时评价候选推理步:哪些操作与尚未解决的结构更相容,哪些前缀更接近任务目标。
代数稀疏化针对探索偏差。系统把当前尚未解决的结构表示为 “残差”,再比较候选操作对应的代数子空间能解释多少残差;解释得越多,候选操作获得越高的软兼容分数。它提高相关分支被采样的机会,但不会把其他局部合法操作一刀切地删除。
双曲结构引导针对累积偏差。系统把当前状态与目标结构映射到适于表示层级关系的双曲空间,用两者的距离形成逐步反馈:不必等终点奖励出现,训练就能区分更接近或更偏离目标的候选前缀。这里的 “接近” 是一个训练时构造的结构信号,并不是对最终正确性的证明。
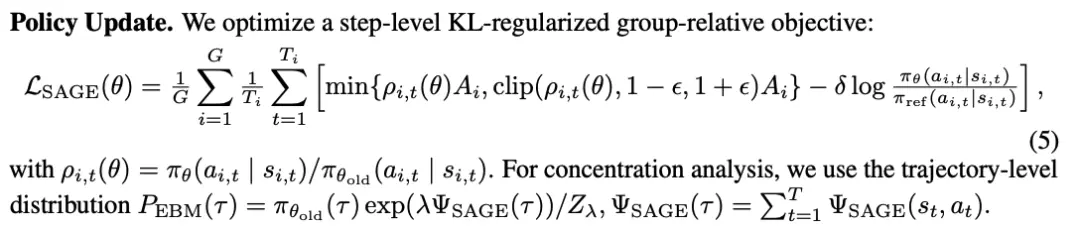
在实现上,旧策略先提出一组候选推理步,SAGE 用两种势函数软重排训练时的采样;轨迹结束后,再把终点奖励与平均结构分数合起来计算组相对优势,更新策略。论文还给出一个有条件的集中性结论:若势函数能把全部局部可行与不可行轨迹拉开正间隔 Δ,重加权后两类轨迹的概率比至多乘上 exp (−λΔ)。条件是否成立,取决于具体任务中的结构先验。
这些结构模块会增加训练阶段的候选评分与距离计算成本。训练完成后,推理直接使用学到的策略,不再运行这套评分或额外搜索;因此论文所说的 “无额外推理开销” 指的是不再引入结构引导模块的在线计算。
四、结果:从平均准确率到可验证的长链成功
评测覆盖 7 项闭式数学、4 项自由文本推理和 1 项 AC 长程符号任务,共 12 个基准、7 个模型家族。比较对象包括 SFT、GRPO、EMPO,以及针对过程反馈的 GRPO-PRM。论文报告各方法采用可比的 rollout 预算、生成长度和解码约束。
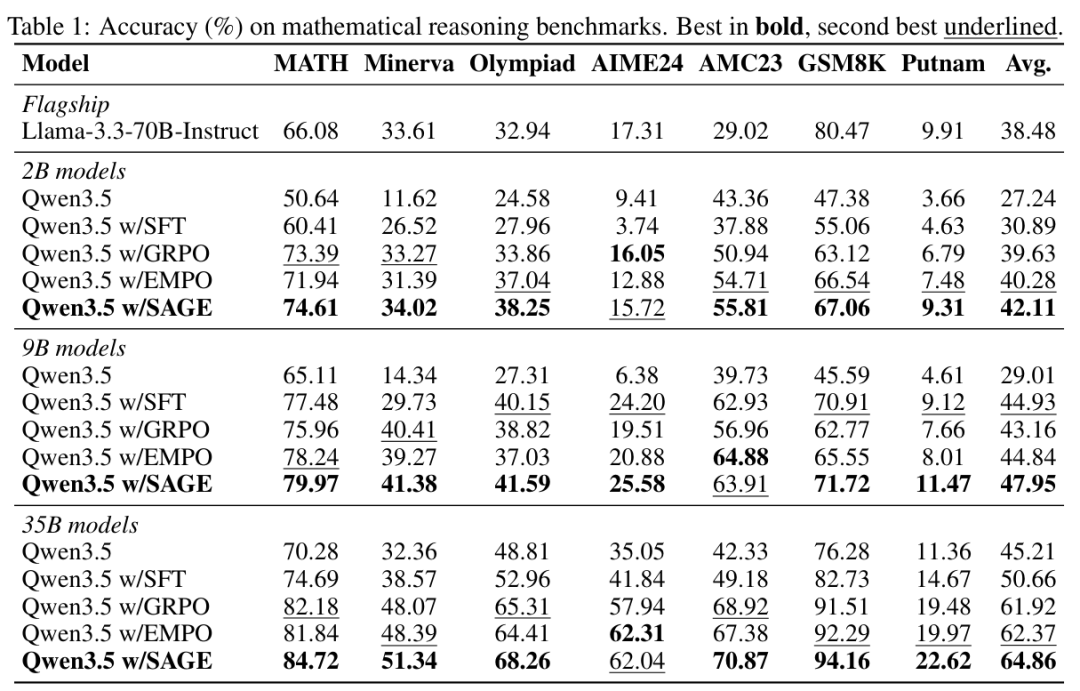
1. 封闭数学推理:Qwen3.5-2B、9B、35B 的 SAGE 平均值分别为 42.11%、47.95%、64.86%;较同规模最强后训练基线高 1.83、3.02、2.49 个百分点。单项并非全胜,例如 35B 的 AIME 为 62.04%,略低于 EMPO 的 62.31%。
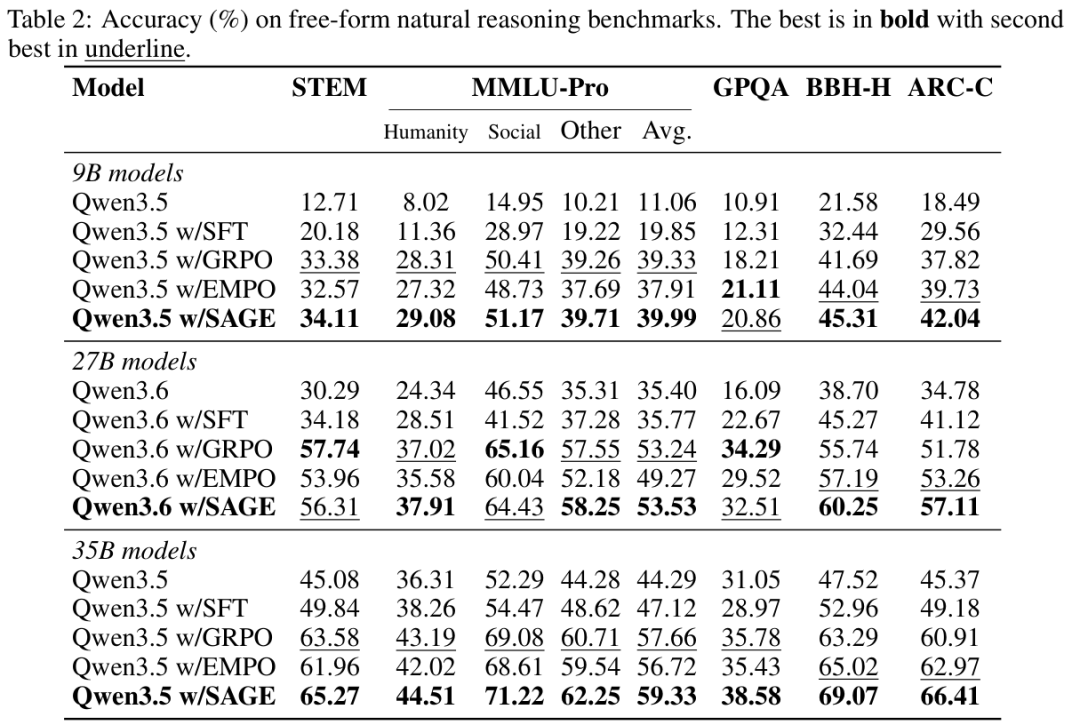
2. 自由文本推理:在 9B 模型上,MMLU-Pro 平均准确率由 EMPO 的 37.91% 提升至 SAGE 的 39.99%;BBH-H 从 44.04% 提升至 45.31%,ARC-C 从 39.73% 提升至 42.04%。但 GPQA 上 SAGE 的 20.86% 略低于 EMPO 的 21.11%。到 35B 规模,SAGE 在这四项指标中均居所列后训练方法之首,其中 BBH-H 为 69.07%,ARC-C 为 66.41%。
3. AC 长程任务:论文分别测量 AC 变换有效率(局部步骤是否符合规则)、ACPathSolving(整条路径是否到达目标),以及 Lean 验证通过率(最终证明是否通过形式化检查)。图中比较六种骨干模型的基础版与 SAGE 版:前者的 AC 变换有效率提高 19.2—26.0 个百分点;Lean 验证通过率提高 13.2—20.8 个百分点。在 Qwen3 上 SAGE 版的 Lean 验证通过率接近基础版的 8 倍。
再看有明确数值的同规模方法对照:在 Qwen3.5-35B 的 AC 实验中,GRPO 的 “变换有效率 / 路径求解率 / Lean 通过率” 为 54.28%/23.05%/14.64%;SAGE 达到 59.83%/31.76%/23.69%。使用学习式过程奖励的 GRPO-PRM 在 Lean 指标上为 17.36%,仍低于 SAGE 的 23.69%。
五、结语:从终点奖励走向结构引导
随着大语言模型生成越来越长的推理链,一个问题也愈发突出:步骤变多,并不意味着模型始终走在通向答案的路径上。终点奖励能告诉模型最后是否答对,却很难指出前面哪一步开始走偏。长程推理需要的,是在训练中更早地利用路径本身的结构。
SCA 从局部可行性出发,解释可行分支如何随深度变得稀少,以及稀有的终点奖励为何难以纠正早期选择。基于这一分析,SAGE 提出一套结构引导的后训练方法:代数稀疏化根据尚未解决的残差调整候选步骤的采样,双曲结构引导根据状态与目标的距离为推理前缀提供反馈,并将两种信号用于策略更新。训练不依赖金标准的逐步解答,完成后也无需在推理时额外运行结构评分。
数学、自由文本与 AC 实例上的结果显示,这种方法大大提高了答案准确率。它提供了一条新的训练路径:让模型不只从最终成败中学习,也从推理过程的结构中学习如何选择下一步。
未来,如何在规则不如 AC 明确的任务中构建可靠的结构信号,仍需继续检验。但这项工作表明,改善长推理还可以从 “让模型更有效地选路” 入手。
当训练能让模型避免那些看似合理、却难以通向目标的岔路,长推理才有机会走得更远。
作者信息
曾欣悦,弗吉尼亚理工大学计算机科学博士生,研究方向包括大语言模型推理稳定性和可靠性,相关成果发表于 ICML,ICLR,NeurIPS 等等国际顶级会议。目前致力于构建可解释、可部署的 LLM 评估与推理方法。
个人主页:https://susan571.github.io/
实验室主页:https://sites.google.com/view/dawei-zhou/vlog-lab
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com