
最近,TypeSafe AI 推出的 Jev 模型火爆出圈,将「输入状态 → 输出决策 + 概率」的模型形态重新带回了大众视野。开发者只需提供状态和问题,Jev 就能直接返回预先定义的选项、分数或事件概率,且结果可直接被代码调用。
虽然 Jev 目前没有开源,架构和训练细节也未公开,但从其公开的 API 和特性来看,有四个核心亮点:
-
✨ 直接输出决策 + 概率
-
⚡️ 支持并行概率预测
-
🎯 概率本身就是预测的核心,而不只是附属品
-
⚖️ 追求概率校准:不只要选对,还要让给出的概率反映真实正确率
这些核心亮点,与 NeurIPS 2025 的入选论文 ConfTuner 不谋而合。两者在概率建模和校准上的技术直觉高度一致:不仅关注模型最终输出了什么结果,更关注各个候选结果背后完整的概率分布。
新加坡国立大学团队在 ConfTuner 中提出的 Tokenized Brier Score 方法,正是通过直接训练候选置信度的概率分布,让模型表达的「把握」更接近其实际的正确率。

图源:ConfTuner 论文 Figure 1。论文用医疗场景说明,模型对错误答案表达过高置信度,可能影响人的后续判断。
-
论文:https://arxiv.org/abs/2508.18847
-
代码:https://github.com/liushiliushi/ConfTuner
-
延伸项目:JevTuner https://github.com/liushiliushi/JevTuner
把一句「我有 80% 把握」,变成一组可以训练的 token 概率
假设模型回答完一道题,接下来要输出「Confidence: 80%」。在生成置信度的这一步,模型已经为词表中的候选 token 计算了 logits。ConfTuner 从中取出代表 0 到 100 等置信度的候选 token,再在这些候选上做 softmax,得到概率分布。
这一步很关键:研究对象不再只是最终说出的「80%」,而是 0%、1%……100% 各个候选置信度对应的整组概率。这些候选值在同一步计算中得到,不需要把每个数字分别生成一遍。
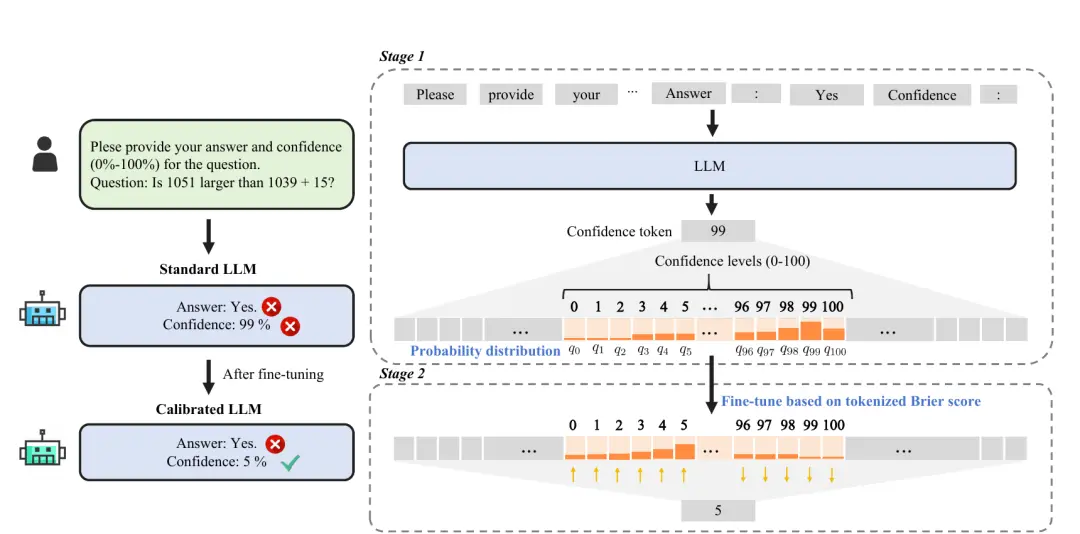
图源:ConfTuner 论文 Figure 2。上半部分取得候选置信度 token 的分布,下半部分利用 Tokenized Brier Score 进行微调。
这就是两者在技术思路上非常相似的地方。Jev 的公开接口让开发者一次拿到候选决策的概率;ConfTuner 则从 token logits 中一次读出候选置信度的概率,并直接训练整个分布。关注点都落在一组概率如何产生、如何校准,而不只是最后取出的那个结果。
只有对错标签,为什么也能学会「有多大把握」?
取得概率只是第一步。ConfTuner 的核心是 Tokenized Brier Score。
设 为模型输出置信度 Token
 的概率,
 为该 Token 代表的数值型置信度,
 表示答案是否正确(正确为 1,错误为 0)。其训练损失函数定义为:
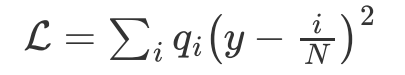
直观来看:如果模型答错了题,却把较高的概率分配给了「99% 确信」,就会受到严厉的惩罚;反之,如果答对了,损失函数则会鼓励模型输出更高的置信度。这种方式极大地降低了数据标注成本——训练数据只需提供答案的对错标签,完全不需要人工去标注「这道题模型应该有 73% 的把握」。
更重要的是,论文在数学上证明了该损失函数是一个 Proper Scoring Rule(适当评分规则):在对同一类输入取期望时,能使损失最小化的预测,必然会把概率质量集中在最接近真实正确率的置信度 Token 上。这为模型的概率校准提供了坚实的理论保证。
实验验证:校准误差显著下降
研究团队在 HotpotQA 上进行了训练,并在 GSM8K、TriviaQA、StrategyQA 和 TruthfulQA 等多个任务上进行了泛化测试。核心衡量指标是 ECE(Expected Calibration Error),即预测置信度与实际正确率之间的差距,该值越低,说明校准越好。
论文报告显示,在五个数据集上,LLaMA、Qwen、Ministral 三个基座模型的平均 ECE 分别从 0.2768、0.3781、0.4393 降至 0.1082、0.2872、0.1884:
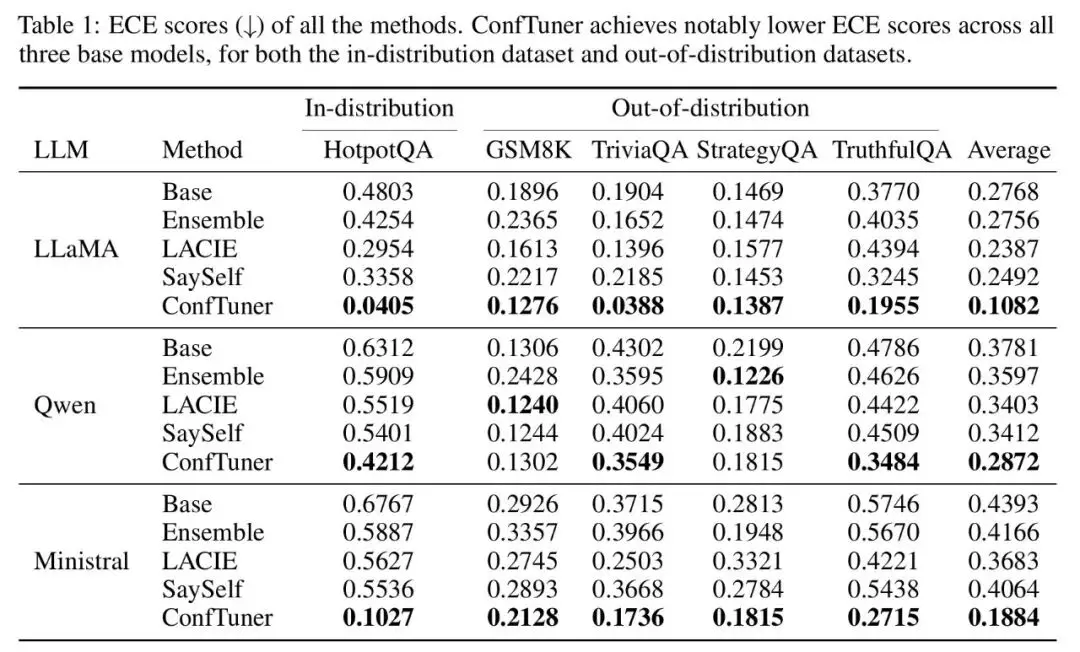
图源:ConfTuner 论文 Table 1。右侧 Average 列是正文引用的五数据集平均值;ECE 越低越好。
在可靠性图(Reliability Diagram)中,ConfTuner 展现出的预测置信度与实际准确率之间的误差面积大幅度减少,显著优于其他基线方法。
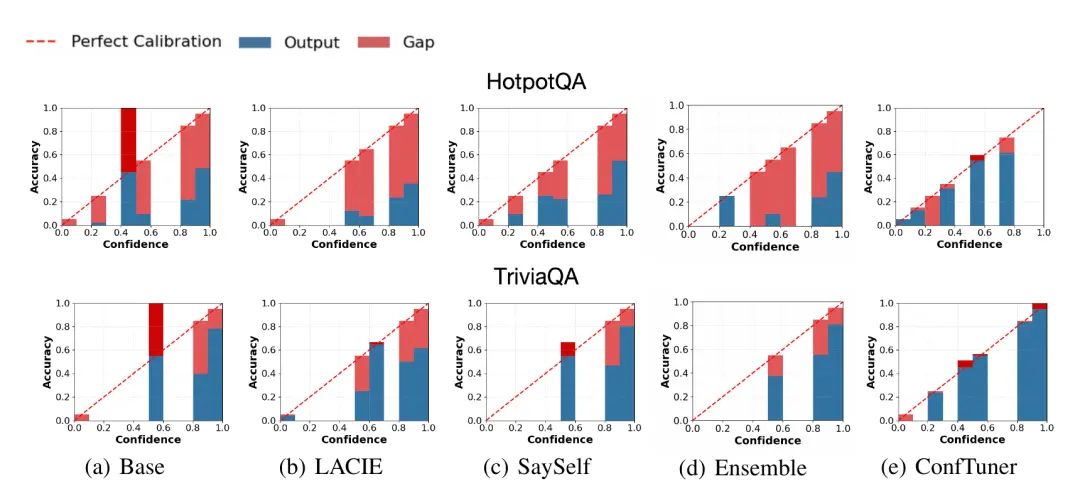
图源:ConfTuner 论文 Figure 3。两行分别是 HotpotQA 和 TriviaQA,最右列为 ConfTuner。
训练效率同样突出。在论文采用的 4 张 A40 GPU 训练条件下,ConfTuner 使用 2,000 条训练数据,约 4 分钟完成微调。而其他训练方法 LACIE 与 SaySelf 分别需要 26 分钟和 120 分钟。
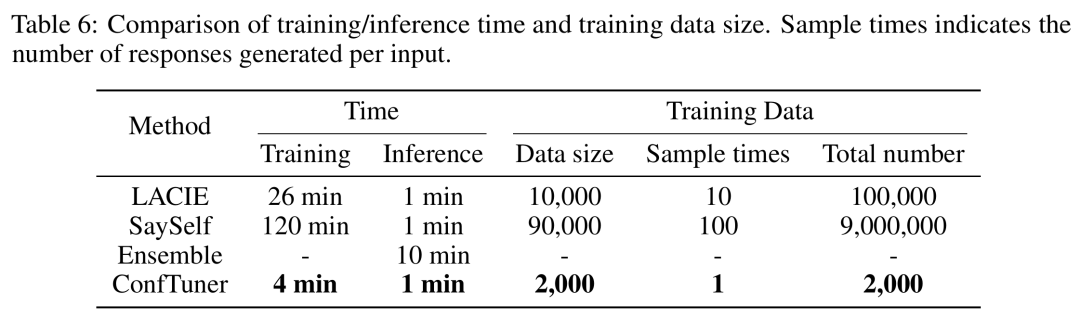
图源:ConfTuner 论文 Table 6。训练时间基于 4 张 A40 GPU,推理时间基于 1 张 A40 GPU;「Sample times」表示每个输入生成回答的次数。
此外,经过校准的概率还能直接赋能下游任务:例如,让低置信度答案触发模型的自我修正,或将其路由给更强大的模型处理。在相同的计算预算下,基于 ConfTuner 的模型级联策略在 HotpotQA 和 TruthfulQA 上分别获得了最高 9.3% 和 5.5% 的准确率提升。
这也是 Jev 式接口的价值所在——当概率直接进入代码逻辑并决定任务走向时,概率校准就从一个单纯的学术指标,变成了整个系统是否可靠的基石。
从置信度 token,走向决策 token
Jev 的走红也引发了新的思考:如果候选 Token 不再代表「0% 到 100% 的把握」,而是代表具体的业务决策,能否继续沿用「直接训练概率分布」的思路?
ConfTuner 团队近期开源的延伸项目 JevTuner 给出了一个可运行的探索方案。它为候选决策设置了单 Token 槽位,直接读取这些槽位的 Logits 以获取完整的决策概率分布;在训练阶段,利用正确的决策标签和多分类 Brier Loss 来优化概率。
项目提供的推理输出格式如下,开发者可以直接解析决策及各个候选项的概率分布:
{"decision": "billing","probabilities": {"billing": 0.84,"technical": 0.09,"sales": 0.03,"other": 0.04}}
需要说明的是,TypeSafe AI 尚未公开 Jev 的底层架构,JevTuner 并非在声称复现 Jev 的内部实现,而是提供了一种技术路径上的可行性探索。两者的共同价值在于指明了一个方向:将候选概率作为模型的直接一等输出,并在训练中真正对这些数值本身负责。
当越来越多的 AI 决策被接入自动化工作流,「选对了」仅仅是及格线;模型给出的概率是否经得起严苛的检验,才真正决定了这些 AI 判断能否被工业界规模化信任和使用。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com