从Figure的30个陌生家庭,到Light-O1的人类动作预训练:机器人智能正在寻找新数据源。
Figure最新发布的Helix 2.5演示,把人形机器人的竞争带到了一个新的问题上:机器人是否已经开始具备进入陌生世界的能力?视频中,Figure人形机器人进入30个此前从未见过的家庭环境,在没有针对具体家庭重新采集数据、没有进行环境级微调的情况下,完成整理物品、铺床、折叠毛巾等连续任务。它让机器人开始展示一种更接近“真正”智能的能力:去往新地方,理解环境,并完成任务。
而几乎在同一阶段,另一组视频也引发了广泛关注。
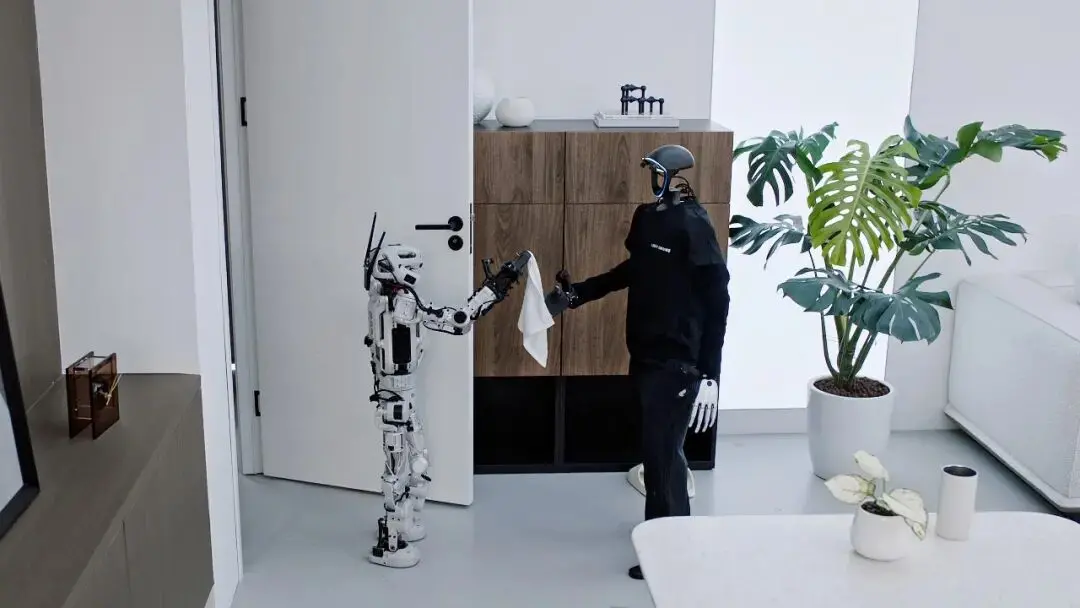
来自中国的具身智能公司亮源新创,21日公开了其最新技术成果视频:同样的真实家居场景,机器人开门迎人、递物、收纳、整理床铺,一镜到底地做完一整套家务。这与Figure展示的家庭泛化能力形成了一个有意思的对应:前者展现了机器人已经可以进入未知环境,利用已有经验完成任务;而后者则更进一步——两台形态迥异的机器人,在同一个模型的驱动下各自作业、彼此递物,甚至可抗进行中的人为干扰。
无论是Helix 2.5的30个陌生家庭测试,还是亮源新创的双人形实景演示,本质上都在探索同一个机器人行业长期面临的问题:机器人能否将预训练阶段获得的能力,迁移到新的环境、任务和机器人本体中,而不再依赖针对每一个场景重新采集数据、训练适配。越来越清晰的一条路径是:让机器人直接向人类自身的日常行为学习。
1.Figure的答卷:
人类行为数据的规模效应初显

先读懂Figure交出的成绩:机器人在30栋陌生房间中执行整理物品、铺床、折叠毛巾三类任务,共尝试420次、成功237次,综合成功率56%。对这份成绩最有力的注脚,来自Figure披露的对照实验:不使用这批预训练数据、以同样任务设置训练的模型,成功率只有9%。从9%到56%,中间隔着的,是千万条量级的人类自身行为视频预训练——这是行业第一次看到,人类行动数据被推到这个量级之后,机器人在陌生环境里的表现会发生什么。
而Helix 2.5的飞跃有一个明确来源:8月25日公开的Index数据平台。它付费招募普通人拍摄自己的日常操作,据公开披露,累计上传视频已超过1600万条,Figure已向创作者支付1500万美元报酬,新数据以每秒30至35分钟的速度涌入;每1000小时数据覆盖373项独特任务、1146种物体、116种环境。为消化这些数据,公司还锁定了至少35亿美元的算力供应。
把Index与对照实验连起来读,这次发布真正的重点便浮出水面——不是56%这个数字,而是它背后初显的规模效应:当人类自身行动数据从数万小时级的专门采集,扩大到千万条视频、并以每秒30分钟的速度持续涌入,机器人第一次带着大规模的人类经验走进陌生环境。它验证的不是某项具体技能,而是一种趋势——随着人类行动数据规模扩大,机器人利用已有经验适应陌生环境的能力持续提升。
这也解释了那些巨额投入的真正含义:一家全球估值最高的人形机器人公司,正在用真金白银为这条规律下注——人类行动数据的规模,值得如此投入。Figure创始人阿德科克说的:随着数据量增加,迁移效果有“可预见的提升”——这句话,值得被铭记。
2.Light-O1的答卷:
把人类经验压缩成机器人智能

四天后出现的第二份答卷,来自亮源新创。随演示视频同步公开的,是一份完整技术报告,主角是全身智能基础模型 Light-O1。它能力的来源,写在报告最核心的一处:Light-O1的人类行动数据,来自互联网上已经存在的大规模人类行为视频。根据技术报告中的示意性评估,这类数据规模超过10亿小时。
这些数据的价值并不只是规模,而在于它天然记录了人类在真实世界中的行为经验。从做饭、修理、搬运,到运动、攀爬,再到人与人之间的协作,以及任何人工采集流程难以提前设计的长尾场景,互联网视频记录了人类如何与物理世界持续交互的过程。
正如技术团队在采访中提到,如果互联网文本压缩了人类知识,那么互联网视频正在压缩人类在这个世界中留下的行为经验。大语言模型通过互联网文本获得了对语言世界的理解,而机器人需要通过互联网视频获得对物理世界的经验。
但如果互联网视频包含了如此丰富的人类行为经验,为什么过去并没有直接成为机器人基础模型的训练资源?原因在于,人类视频记录的是“别人如何行动”,而机器人需要学习的是“自己的身体如何行动”。视频中包含丰富的视觉信息,却缺少机器人可以直接执行的动作表示;同时,人类与机器人之间还存在身体结构、动作空间和视觉输入方式上的差异。
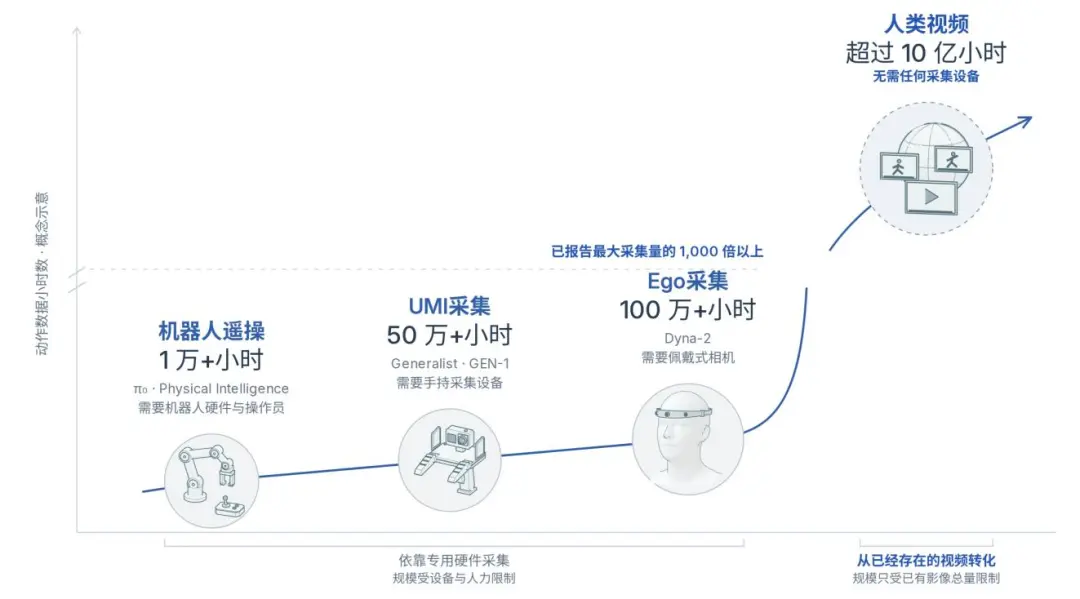
互联网可提供10亿小时+海量人类行为预训练数据
因此,真正困难的问题并不是获得更多视频,而是如何让这些人类经验跨越观察、具身和控制之间的鸿沟:机器人需要从视觉输入中理解世界(观察),将人类动作转化为不同身体都能够复用的知识(具身),再将这些知识转化为机器人可以执行的行动(控制)。
Light-O1围绕这一问题建立了一套人类动作预训练体系。模型从互联网视频中恢复结构化的人类动作信息,并通过统一人形动作表示,将互联网中的人类行为、第一视角数据以及机器人动作数据映射到同一个动作空间。
这一步决定了,人类经验究竟只能停留在视频中,还是能够真正进入机器人的身体。Light-O1学习的不是某一个人的固定动作,而是不同身体背后共享的运动规律,使动作知识能够跨本体迁移。
通过这种统一表示,动作知识不再绑定某一个人的身体,也不绑定某一台机器人的机械结构,而成为可以迁移到不同任务和不同机器人本体上的基础能力。在此基础上,Light-O1通过多模态时序建模和大规模预训练,从人类行为序列中学习动作规律,形成可迁移的人类动作先验(Human Action Prior):一种能够被带入不同任务、不同环境和不同机器人本体中的动作知识。
因此,Light-O1展示出的并不只是提前写好的动作脚本,而是从人类行为中学习到的可迁移动作能力。
而对于基础模型而言,更关键的问题是:这种经验学习路径是否能够随着规模扩大持续增强?Light-O1的实验进一步回答了一个比“数据有没有用”更深的问题:预训练规模是否决定了机器人基础能力提升的上限。
为了验证这一点,Light-O1将预训练数据规模从3.75B Token逐步扩展至120B Token,并在不同规模的预训练模型基础上进行后训练。实验结果显示,随着预训练规模扩大,模型在公开第一视角人类数据、公开机器人数据以及亮源自有 LightBot 数据上的动作预测误差持续下降;单纯增加后训练,并不能替代扩大预训练规模带来的能力提升。
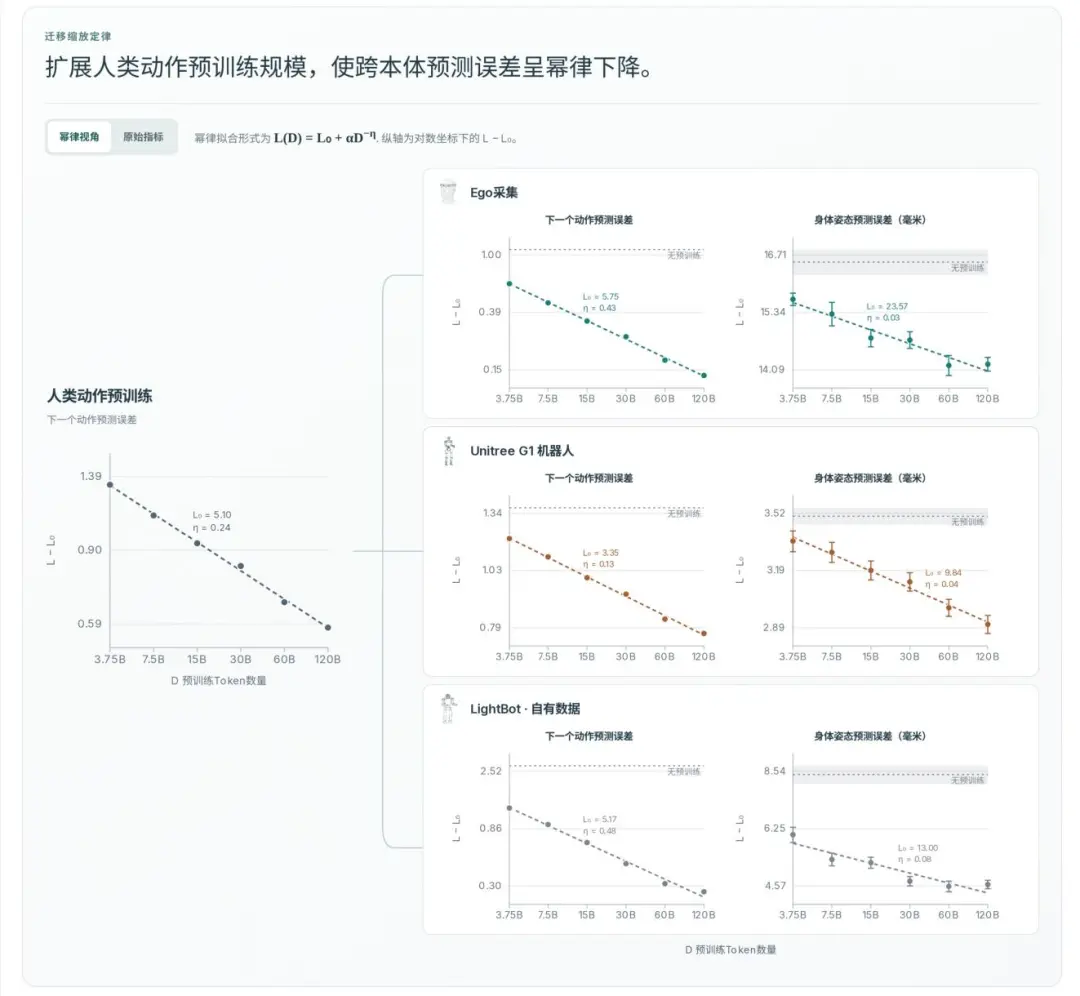
Light-O1首次验证人类全身动作预训练的跨本体迁移扩展规律
这一趋势说明,人类动作预训练的价值并不只是提供更多数据,而是在规模扩大后持续提升机器人基础能力。四天前,Figure创始人阿德科克曾提到,人类行动数据规模扩大后,机器人迁移效果会呈现出“可预见的提升”。Figure的实验展示了这一趋势在人类行为数据规模扩大后的初步体现;而Light-O1进一步通过跨视角、跨本体的规模化实验,将这种提升关系转化为可测量的模型规律:随着预训练规模增加,模型适配后的动作预测能力持续增强。
3.预训练能力进入真实世界,
机器人开始处理未知任务

Light-O1的价值,最终需要在真实机器人环境中被验证。相比完成某一个固定动作,更值得关注的是:当机器人面对连续任务、环境变化以及未被单独示教过的情况时,是否仍然能够保持行动能力。
在演示视频中,LightBot与G1之间完成了一次毛巾交接。这个动作看似简单,却并不存在对应的“机器人与机器人协作”真机采集数据。根据团队介绍,真机采集阶段主要覆盖的是人与机器人的协作,而预训练数据中天然包含大量人与人之间的协作行为。
对于模型而言,“从一个人手中接过毛巾”和“从另一个机器人手中接过毛巾”,并不是两个完全不同的问题,而是同一种任务意图在不同执行主体之间的变化。经过预训练,人类社会中的协作经验被迁移到了机器人之间的交互。
更能体现泛化能力的,是一些并未出现在任务脚本中的意外情况。视频中,G1擦完桌子转身时意外碰到了地上的瓶子,瓶子被踢到了新的位置;随后,LightBot重新识别环境变化,移动到新的位置并将瓶子重新拿起。这个过程并不是预先设计好的异常处理流程,而是在执行过程中自然发生的环境变化。团队也表示,他们最终选择保留这一版本,是因为相比一次完美完成任务,这种面对意外并调整行为的过程,更能体现机器人在真实环境中的泛化能力。
类似情况还出现在其他长程任务中。例如,当门没有完全关闭、台灯没有成功打开时,机器人能够根据当前状态重新判断并继续执行任务。真实世界中的长程任务无法依靠后训练覆盖所有可能的 corner case;机器人需要依靠预训练阶段获得的环境理解和行为经验,处理那些没有被逐条示教过的情况。
这些表现也解释了为什么Light-O1强调大规模预训练的价值。真实世界中的任务变化无法依靠后训练逐一覆盖,机器人不可能为每一种物体变化、环境扰动和长程任务提前采集数据。
据团队披露,部分演示任务对应的真机后训练数据量仅为几十到一百条级别。大量能力并不是通过针对每个任务重新采集数据获得,而是来自前期大规模人类行为预训练形成的基础能力。
除了任务泛化能力,这套人类行为数据体系也影响机器人的运动表现。技术团队介绍,高质量人类运动数据经过处理后进入底层训练,使机器人不仅能够完成任务,还能够实现动作之间更加自然的衔接和协调。换句话说,大规模人类行为数据提供的不只是“做什么”,也包括“如何流畅地完成”。
最终,这些能力也体现在量化评测中。Light-O1在覆盖24项任务的模拟基准 RoboCasa GR-1 上取得79.3%的综合成功率;在超过3万条指令的人类盲评中,获得1472.8 Elo评分,并在六类指令中保持领先。
相比单一任务上的技能展示,这些结果更试图说明:Light-O1探索的不是一个机器人完成多少任务,而是一种基础模型能力如何从预训练迁移到真实世界的方法。
4.开源,与三段范式的闭环

随报告发布,亮源新创同步开放了Light-O1-Preview的模型权重与代码,并上线网页版 Playground。用户无需部署复杂环境,只需输入自然语言指令,即可观察模型推理过程与生成的全身动作。这使研究者能够更低成本地验证模型能力,也让基础模型从实验室环境进一步走向更广泛的真实使用场景。
对于具身智能而言,开源的意义并不只是开放一个模型,而是让基础能力进入更大规模的应用和反馈循环。大模型行业的发展已经证明,模型能力的提升不仅来自训练阶段,也来自进入真实世界后的持续使用、反馈和迭代。对于机器人而言,开源则意味着让更多开发者、研究者和应用方参与到能力验证和场景扩展中,加速基础模型从实验环境走向真实部署。
将这次发布放回亮源新创自身的技术路线中,整个脉络更加清晰。亮源新创将 Physical AI 的发展划分为三个相互衔接的阶段:规模化预训练、规模化对齐、规模化部署。
其中,规模化预训练回答的是机器人基础智能从哪里来。Light-O1给出的答案,是让模型从互联网规模的人类行为数据中学习动作知识;规模化对齐回答的是基础能力如何适配具体机器人和任务,此前发布的全身技能学习与通用导航等工作均属于这一阶段(根据本次报告,导航能力也已作为子能力融入 Light-O1)。其核心目标,是降低机器人能力扩展对于高成本真机遥操作数据的依赖——因为一名操作员、一台机器人、一个时间点只能产生有限数据,而想覆盖更多本体、更多环境和更多任务,传统采集方式很难持续扩展。
最后,规模化部署回答的是能力如何进入真实世界并持续演进。团队给出的参考来自大模型行业的发展路径:过去一年,GitHub代码规模并没有发生数量级变化,但开发者生产效率因为代码助手等工具的普及而大幅提升。变化的关键并不只是数据增加,而是模型进入了更广泛的使用场景,并通过真实反馈不断迭代。对于具身智能而言,对应的路径一方面是开放模型能力,另一方面是让机器人能够稳定运行于真实环境——这也是此前发布的 Light REACT 在整体体系中的位置。
至此,三段范式形成了完整闭环:规模化预训练建立基础智能,规模化对齐让能力适配机器人本体,规模化部署则让能力进入真实世界并持续扩展。而这条路线能够成立,背后依赖的是一套不断扩张的数据和基础设施体系。据团队介绍,探索互联网视频预训练路线的早期阶段并不顺利。在最初几个月里,数据规模扩大并没有立即带来明显效果,模型指标也没有出现预期变化。真正困难的并不是提出利用互联网数据的想法,而是建立一套能够持续筛选、处理和利用这些数据的数据体系。
随着数据管线不断迭代,Light-O1背后的基础设施逐渐形成规模。据团队披露,目前数据基础设施运行于千卡集群,每周视频处理吞吐已经达到20万小时;相比六个月前约1.25万小时的水平,实现了大幅提升。从寻找数据来源,到建立数据处理体系,再到模型能力扩展,Light-O1探索的并不仅是一款机器人模型,而是一条类似大模型时代的数据—训练—部署路径。正如报告最后留下的判断:It's time to scale。
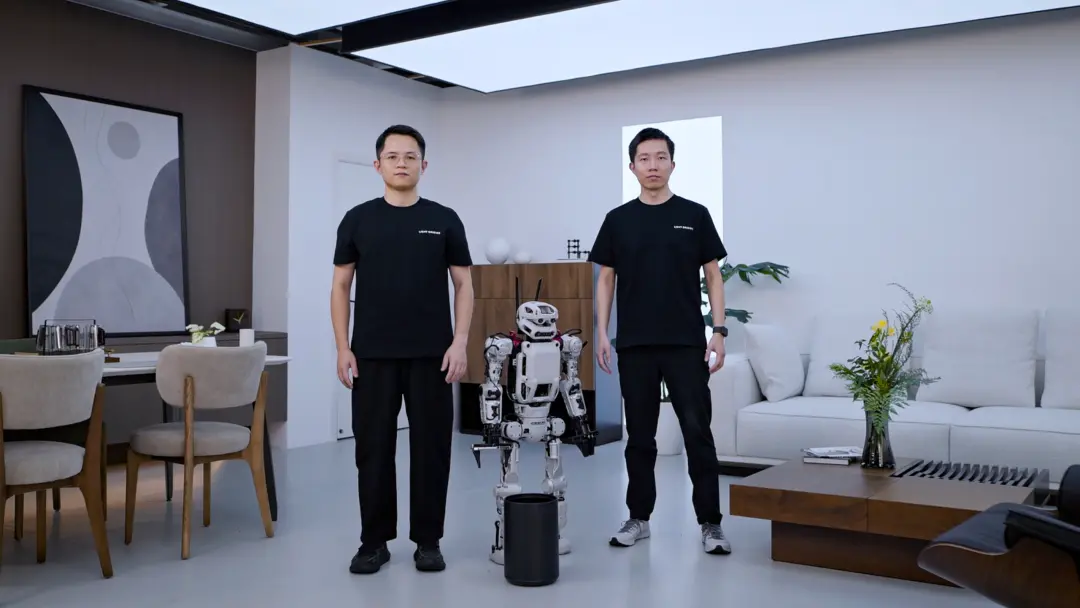
It's time to scale
5.人类行为数据,
正在成为机器人智能的新基础

从更长期看,真正决定机器人基础模型竞争力的,可能不是谁能够购买更多已有数据,而是谁能够建立持续产生智能的数据体系。正如亮源新创团队在采访中提到,如果大家使用的都是市场上可以买到的数据,那么最终能力上限可能会逐渐接近;真正形成差异的,是如何利用更大规模、更丰富、更接近真实世界的数据,并将其转化为模型能力。
这也是为什么 Figure 与亮源新创此次几乎同时将关注点落在人类行为数据上,具有特殊意义。前者通过大规模人类行为数据验证机器人在陌生环境中的泛化能力,后者则进一步探索如何将互联网规模的人类行为经验转化为可迁移、可扩展的机器人基础智能。两条路径虽然不同,却共同指向一个正在形成的技术方向:人类行为数据正在成为 Physical AI 基础模型竞争中的关键变量。
未来,具身智能领域的竞争或许不只是机器人硬件能力的竞争,也不只是单项技能的竞争,而是谁能够建立更强的数据体系、更有效的预训练方法,以及让机器人从真实世界经验中持续获得能力提升的路径。随着 Figure 和亮源新创分别从“家庭泛化”和“人类动作预训练”两个方向推进这一探索,它们也正在成为观察 Physical AI 基础模型演进的重要样本。
(封面图及文中配图来源:亮源新创)
END.