从一套终端芯片平台,走向支撑个人AI跨设备运行的计算底座。
作者|王博
发自美国夏威夷
9月22日,美国夏威夷茂宜岛,高通在2026骁龙峰会上发布了新一代旗舰移动平台——第六代骁龙8超级至尊版和第六代骁龙8至尊版。
这是高通首次将2nm工艺用于旗舰移动平台。两款平台均搭载最高5GHz的Oryon CPU和重新设计的Hexagon NPU;其中,第六代骁龙8超级至尊版还在Adreno GPU中首次加入Matrix Cores,并支持8K/60fps视频拍摄。
单纯看数据,很容易让这次发布落入一场围绕性能、功耗和影像参数的讨论。
但在今年的峰会中,高通和到场嘉宾反复强调关键词是:Agentic AI。
智能体AI是一项系统级挑战,图片来源:「甲子光年」拍摄
高通公司总裁兼首席执行官安蒙(Cristiano Amon)与万事达卡高级研究员Raja Rajamannar讨论了一个问题:当AI智能体从推荐商品走向代替用户下单、付款,会发生什么?
Raja认为,用户交给智能体的不只是一项任务,还有一部分行动权限。智能体需要了解用户的偏好和消费习惯,也可能接触身份、支付凭证等敏感信息。因此,当Agent开始替用户花钱,衡量它是否“智能”已经不够。用户还需要知道:它掌握了哪些信息,为什么作出这个决定,支付前是否会再次确认。
这正是Agentic AI与过去端侧AI的区别。一次拍摄、翻译或问答,通常有明确的输入和输出;智能体面对的是一个目标,需要持续感知、保存上下文、规划任务、调用工具,并在获得授权后采取行动。
对用户而言,这可能只是一句“帮我买下来”;对芯片而言,背后却是一条持续流动的任务链。
麦克风和传感器需要随时理解周围发生了什么,CPU负责规划任务和调用工具,NPU运行语言及多模态模型,GPU和ISP处理图像与视频,通信模块负责在终端与云端之间传递数据,并以尽可能低的时延完成。与此同时,用户的个人上下文、模型状态和KV Cache还要在不同计算单元之间被反复读取。
计算负载由一次短促的调用,变成长期运行的系统。
这也改变了芯片性能的衡量方式,一场更深层的计算架构调整正在发生。
高通公司总裁兼首席执行官安蒙,图片来源:高通
高通过去几年一直在讲“计算连续体(compute continuum)”,希望把AI计算分布到手机、PC、汽车、边缘设备和云端。2026骁龙峰会提供了一个更加具体的观察窗口:当Agent真正开始替用户办事,芯片和计算平台需要具备什么能力;而高通又将如何把移动时代积累的低功耗计算、异构处理和连接优势,转化为智能体时代的底层平台。
「甲子光年」认为,这一次,高通带来的表面看点是首款2nm骁龙旗舰平台,但Agent正在重塑骁龙。
1.从一次推理到一条任务链

“我们正在从以App和助手为中心的时代,迈向智能体时代。”
这是安蒙在2026骁龙峰会现场演讲时给出的观点,但他很快提到了一个问题:“未来手机会消失吗?”
他的判断是,手机并不会消失。
安蒙在现场把未来手机概括为两个并存的维度:一边仍是用户打开App亲自操作;另一边,智能体感知环境、理解意图、保存记忆并代表用户行动。
后一个维度意味着,即便用户没有拿起手机,芯片仍可能持续工作。
但这对于手机内部移动计算平台来说并非易事,它需要解决三道难题。
第一道难题是持续感知。
第六代骁龙8超级至尊版的传感器中枢采用双Micro NPU。根据高通公布的数据,其性能提升85%、功耗降低20%,可以在不频繁唤醒主应用处理器的情况下处理环境语音、活动和个人情境。
高通技术公司高级副总裁兼手机业务总经理Chris Patrick介绍,这一架构能够带来个人记录(Personal Scribe)的特性。按照用户指示,个人记录可对对话进行索引,识别对话中的不同发言者,将重要信息整理至专属的、安全的个人知识图谱中。
这类设计的意义并不局限于增加一个功能。Agent需要“随时知道发生了什么”,手机又必须维持全天续航。如果每一次环境声音、位置变化和唤醒词都交给主CPU或主NPU处理,智能体很难长期在线。
第二道难题是任务编排。
Agent会反复执行“理解—规划—调用—观察—修正”的循环,还要处理条件分支和失败重试。高通将CPU定义为智能体循环的编排调度中心,并在新一代Oryon CPU中引入FlexCache,让8个核心共享同一个L2缓存池,按需动态分配资源。
它所解决的并非简单的缓存容量问题。多步任务在不同核心间迁移时,如果相关数据仍停留在共享缓存中,系统就可以减少访问外部内存的次数。5GHz提供瞬时响应,Oryon FlexCache则试图让这种响应在复杂任务中保持连贯。
第三道难题是更长的上下文和多个模型并发运行。
新一代Hexagon NPU加入面向Transformer负载的Element Accelerator,并把大容量共享内存扩大50%。数据显示,这套架构最高支持32K Token上下文,部分模型的预填充性能最高提升80%。
相比性能提升,更值得关注的是共享内存。更多模型状态、激活值和中间张量可以留在片上,系统访问外部DDR的频率随之下降。
上述架构变化中的模型推理、任务调度与内存管理能力,在现场一款30B参数混合专家(MoE)模型的端侧部署中得到集中体现。
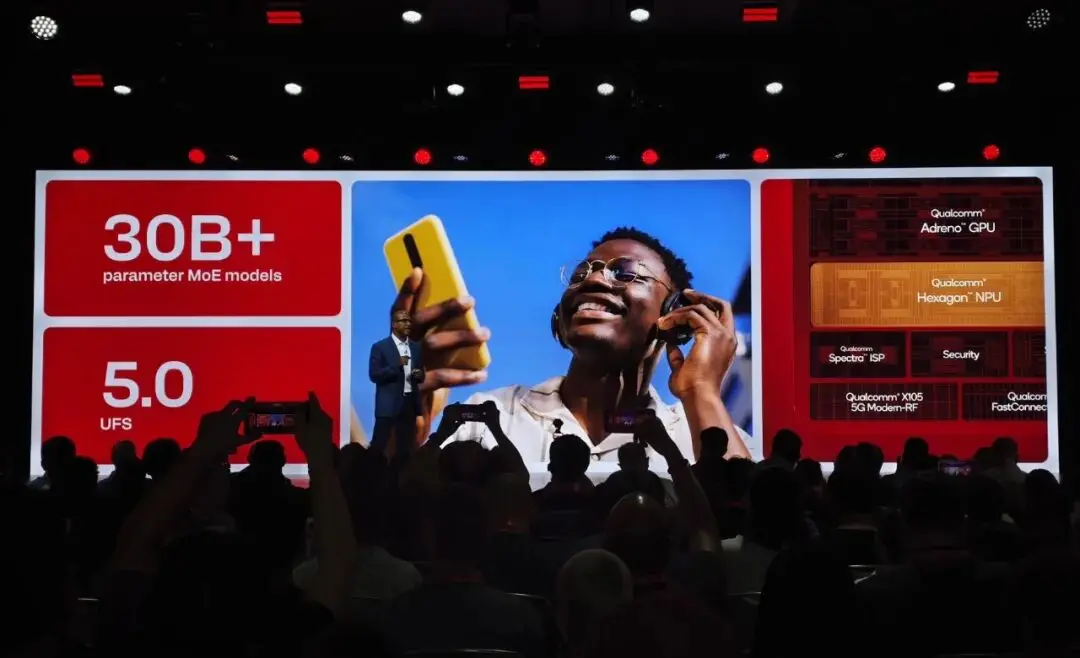
图片来源:「甲子光年」拍摄
2026骁龙峰会期间,高通技术公司宣布携手阶跃、无量火与江波龙开展四方合作,基于第六代骁龙8超级至尊版移动平台,将阶跃StepEdge-Omni 30B-MoE模型面向端侧进行深度适配与推理优化,成功打造具备自主服务和个性化能力的端侧智能体助手。
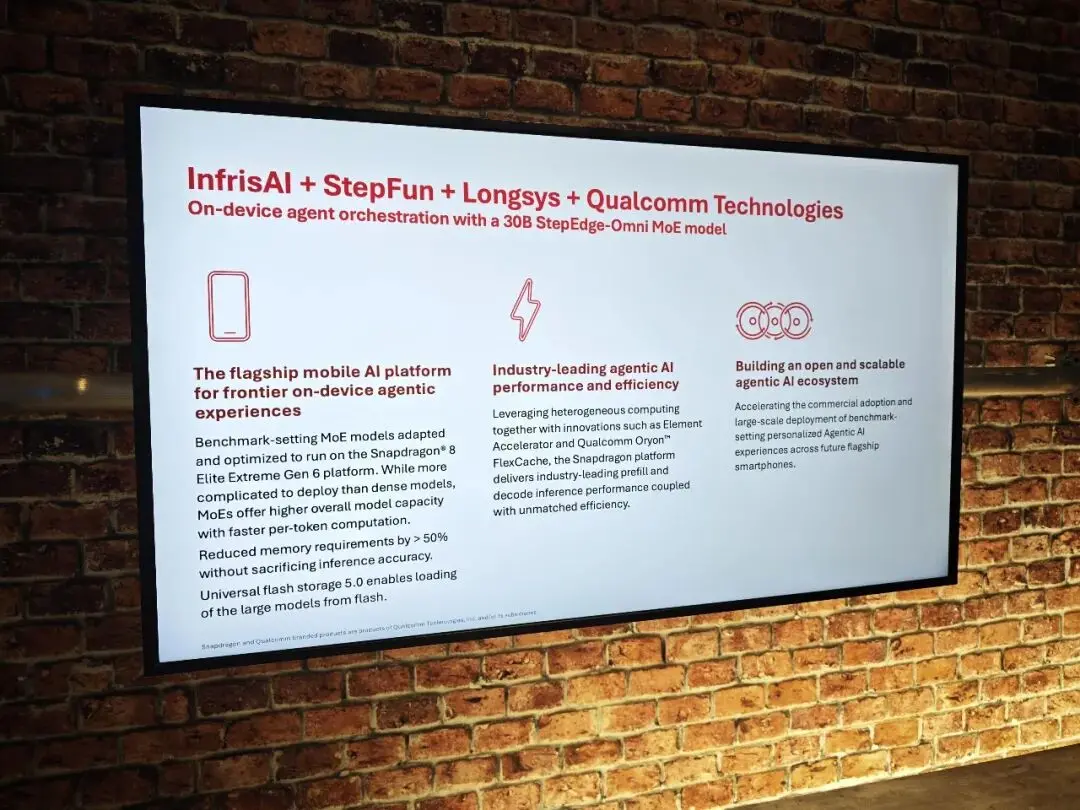
图片来源:「甲子光年」拍摄
「甲子光年」现场体验发现,在这套端侧AI方案中,智能体从邮件理解一路完成行程规划、日历同步、航班酒店推荐、行程分享和邮件草拟,全程在本地运行。
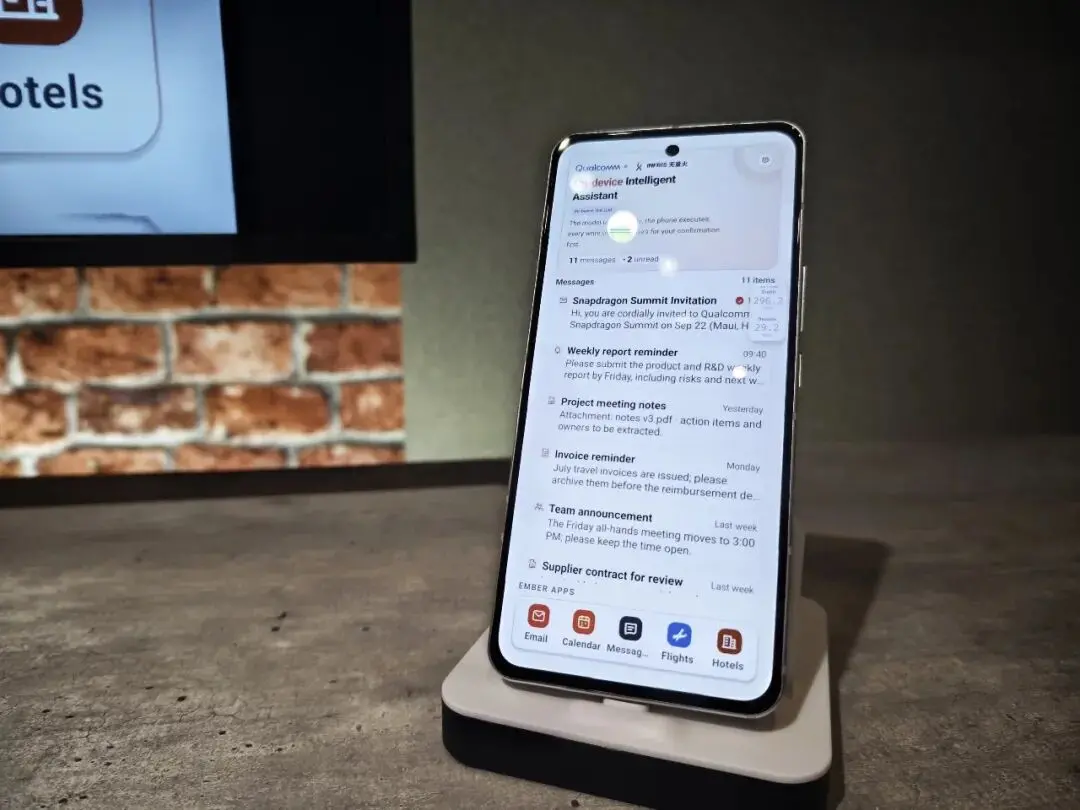
图片来源:「甲子光年」拍摄
30B代表模型拥有300亿参数,并不意味着生成每个Token都要调用全部参数。其实,这类MoE模型每一步大约只激活30亿路由参数。更多“专家”保存在端侧闪存中,任务需要时再按需加载,以控制计算量和内存带宽压力。
这说明,端侧大模型的落地已经超出单一计算单元的能力边界。
无量火的推理引擎负责CPU、GPU和NPU间的编排;江波龙则提供了端侧AI存储解决方案,模型权重可从端侧闪存高效加载,通过存储与计算协同减少大模型对运行内存的持续占用,进一步提升模型加载和运行效率。
在这套四方合作方案中,模型运行内存需求较行业常规方案降低超过50%,预填充吞吐超过330 Token/s,解码吞吐超过28 Token/s。得益于NPU与GPU双引擎协同,其预填充性能较仅使用NPU的通用推理方案提升超过30%。
这些数据来自特定参考设计和软件栈,尚不能直接推演到量产手机的功耗、温度和持续性能。但它们说明,端侧Agent的竞争已经进入系统工程阶段:模型架构、推理引擎、计算单元、内存与闪存需要共同优化。
其中,一个容易被忽略的变化是,NPU已经不再独自承担所有AI计算。
在30B MoE方案中,GPU也参与了模型推理,说明AI负载正在从NPU扩展至多个计算单元。另一条并行变化出现在图形管线中:新一代Adreno GPU进一步加入Matrix Cores,并配合18MB Adreno独立高速显存(High Performance Memory,HPM)。HPM本质上是一块GPU片上的专用优化缓存,可以让AI超分、帧生成等任务留在图形管线内,减少对系统内存的反复访问。
不同计算单元正在根据自身特点承担不同类型的AI负载:NPU处理语言和多模态模型,GPU适合并行计算与神经渲染,ISP负责提取图像中的情境信息,CPU负责规划和编排,传感器中枢则以较低功耗保持持续感知。
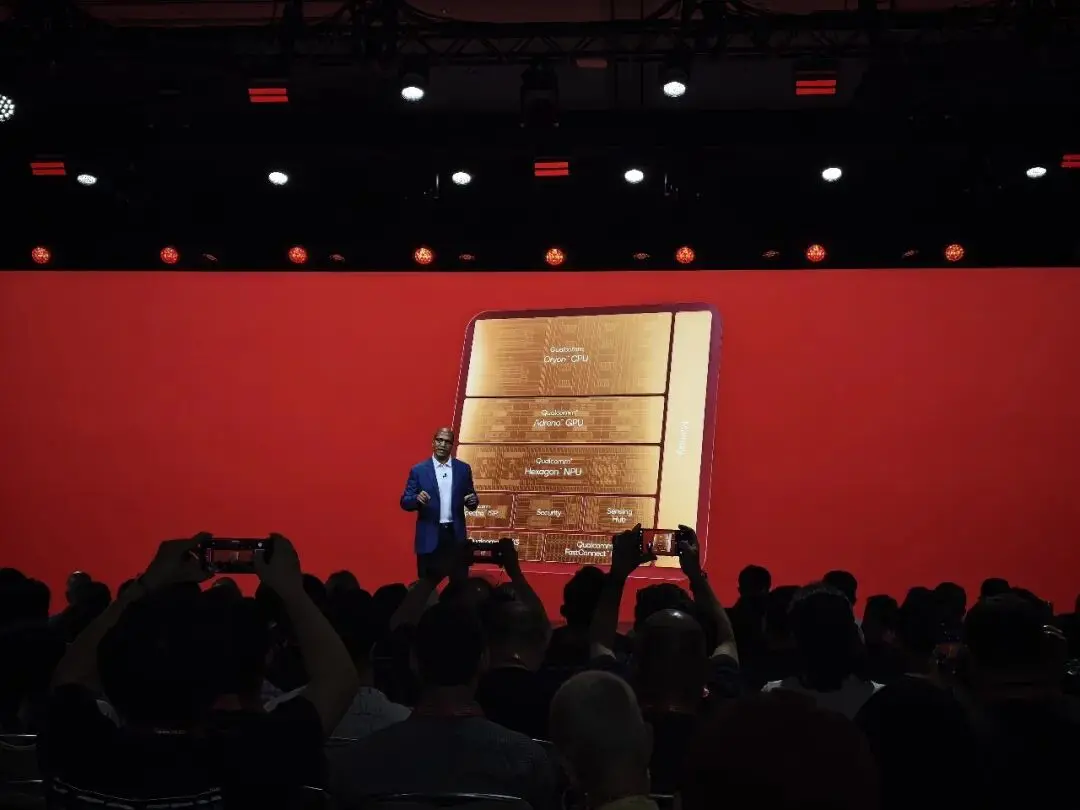
图片来源:「甲子光年」拍摄
因此,面向Agent的芯片很难再依赖某一个计算单元。真正的挑战是,如何让这些模块围绕同一条任务链稳定协作,并尽量减少任务切换中的等待和数据搬运。
2.让任务所需的数据尽量留在计算附近

算力增长曾是AI硬件最显眼的主线。进入推理阶段后,越来越多瓶颈出现在另一侧:数据能否及时送到计算单元。
Agent会进一步放大这个问题。
对话持续时间更长,KV Cache随之增长;规划、反思和工具调用会产生更多Token;多个模型和工具同时参与;同一项任务还可能在CPU、NPU、GPU、终端和云端之间迁移。
计算单元等待数据的时间开始增加,数据搬运本身也在消耗能量。
TrendForce今年4月发布的“AI内存墙”报告指出,MoE和长上下文处理正在快速抬高模型权重与KV Cache的容量需求,推理瓶颈开始从算力不足转向内存容量,并推动热数据、温数据与冷数据重新分层。
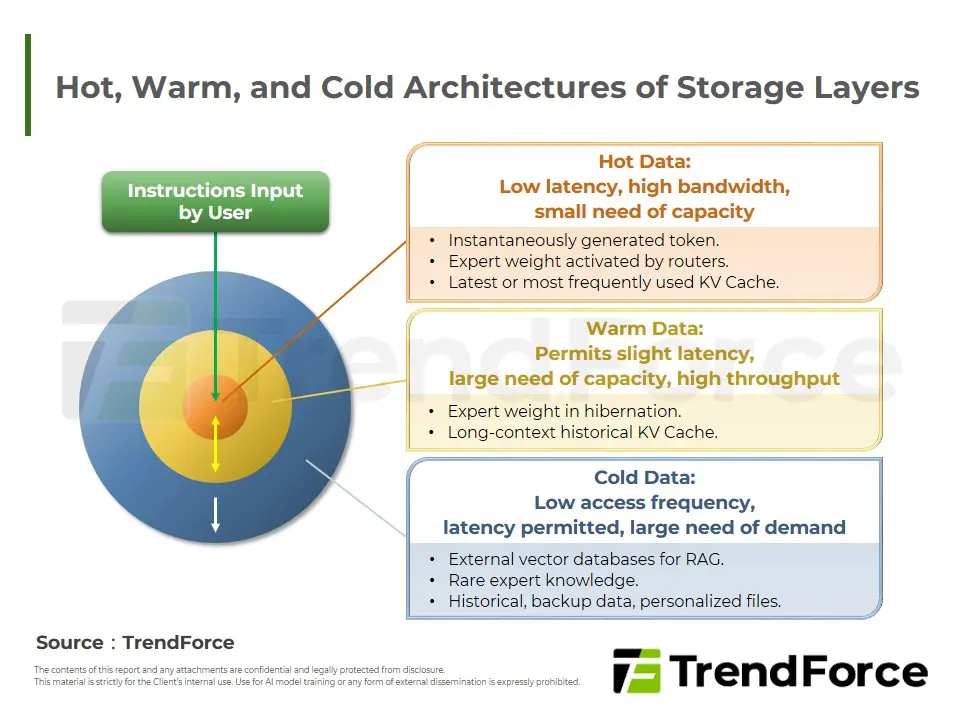
图片来源:TrendForce
微软研究团队发表于《Joule》的研究则估算,长推理和Agent查询由于生成Token增加、并发效率下降,单次查询能耗可能比普通查询高出一个数量级以上。即使长查询只占每日请求的10%,总能耗也可能翻倍。
「甲子光年」认为,Agent想要处理越复杂任务,系统就越需要精打细算地管理每一次数据移动。
沿着这条线回看新一代骁龙,Oryon FlexCache、Hexagon NPU共享内存和Adreno HPM看似属于三个不同模块,实质上都在完成同一件事——让任务所需的数据尽量留在计算附近。
CPU减少访问外部内存,NPU少搬运模型状态,GPU则让AI图形任务留在图形管线内部完成。
今年峰会另一个值得注意的信号来自HBC。
今年6月,高通发布了面向数据中心的高带宽计算(High Bandwidth Compute,HBC)路线。其核心思路是把部分计算放到内存附近,减少模型权重和中间数据在内存与加速器之间往返。在高通飞龙(Dragonfly)数据中心路线中,高通开始把每瓦Token数列为衡量推理效率的关键指标,而不再只强调峰值FLOPS。
这次骁龙峰会上,安蒙又把这条路线延伸到终端。他在主题演讲中透露,高通已经为骁龙平台开发HBC协处理器,让内存与AI处理单元靠得更近,并计划把这项技术带到智能手机、PC、智能眼镜和汽车等边缘终端。
他还形容这是“一项有趣且很多人并未预料到的创新成果”。
安蒙介绍高通HBC,图片来源:高通
不过,高通尚未公开面向骁龙平台的HBC协处理器在封装、容量、带宽、功耗和量产平台等方面的具体信息。但这次表态透露了,HBC已经从一项数据中心技术,进入高通个人AI终端的产品路线图。
安蒙给出一个判断:未来一些智能体终端每天可能在本地处理100万Token,同时还要保持全天续航。
这个数字属于高通对未来负载的设想,却准确点出了架构压力。今天的片上缓存适合留住最热的数据,闪存可以保存大模型权重,系统内存承接运行状态;当模型更大、上下文更长、Agent运行更久,手机也需要新的数据分层与调度方式。
从Oryon FlexCache到HBC,高通正在把同一条技术逻辑铺到不同尺度:计算能力继续增长,数据移动的距离和频率必须下降。
智能体时代的性能竞争,可能越来越像一场内存架构竞争。
3.Agent走出手机,生态决定它能走多远

走进2026骁龙峰会的体验区,比舞台上的演讲更容易感受到高通生态的广度。
现场既有手机和PC厂商,也有AI模型公司、操作系统公司、支付机构以及眼镜、耳机等可穿戴设备厂商;展台上则摆放着搭载不同骁龙平台的手机、笔记本电脑、智能眼镜、XR设备和智能耳机产品。
同一个骁龙标识出现在截然不同的终端中,也揭示了Agent落地的另一个现实:芯片提供共同的计算基础,最终体验仍取决于操作系统、模型、应用与终端厂商如何配合。
高通技术公司高级副总裁兼XR、可穿戴与个人AI业务总经理Ziad Asghar认为,智能手机仍是智能体的重要枢纽,但手机无法独自收集用户全部情境。手表、眼镜、耳机、指环和其他可穿戴设备始终伴随用户,能够“看用户所看、听用户所听”。
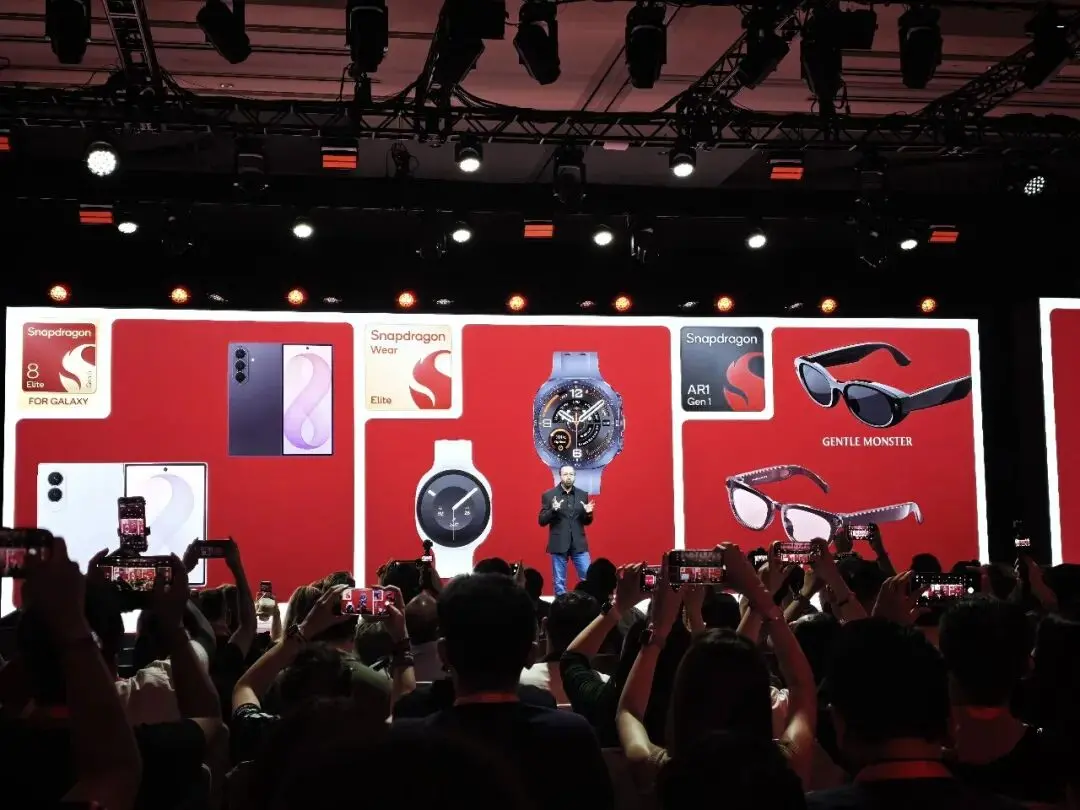
图片来源:「甲子光年」拍摄
手机可能负责保存长期上下文和调度任务,眼镜提供视觉信息,耳机承担语音交互,PC负责复杂生产力工作,汽车延伸出行场景,云端则处理更大规模的模型推理。
当智能体从手机走向眼镜、手表和汽车,一个新的问题随之出现:用户将通过什么方式与它交互?
在许多无需屏幕的场景中,语音是最自然的入口。耳机和智能眼镜又能长时间贴近用户,既可以接收指令,也能持续获得声音、视觉和环境信息。
但「甲子光年」此前与一些智能眼镜厂商交流时了解到,空间尺寸和能耗仍是个人AI终端面临的现实限制。镜架或耳机中可容纳的芯片、电池和散热结构十分有限,端侧算力、续航与佩戴舒适度之间很难兼得。模型稍大、任务稍复杂,设备就可能需要借助手机或云端完成计算。
因此,这类终端要从手机的配件变成相对独立的智能体入口,关键并非简单塞入更强的芯片,还要同时解决低功耗感知、端侧AI、语音拾取、网络连接和续航问题。
这次骁龙峰会,高通发布了第二代骁龙音频平台至尊版,尝试把Personal AI延伸到耳机、音频眼镜等更小型的终端。第二代骁龙音频平台至尊版也是高通首款专为将优质音频与语音技术、终端侧智能和连接能力相结合而打造的平台。
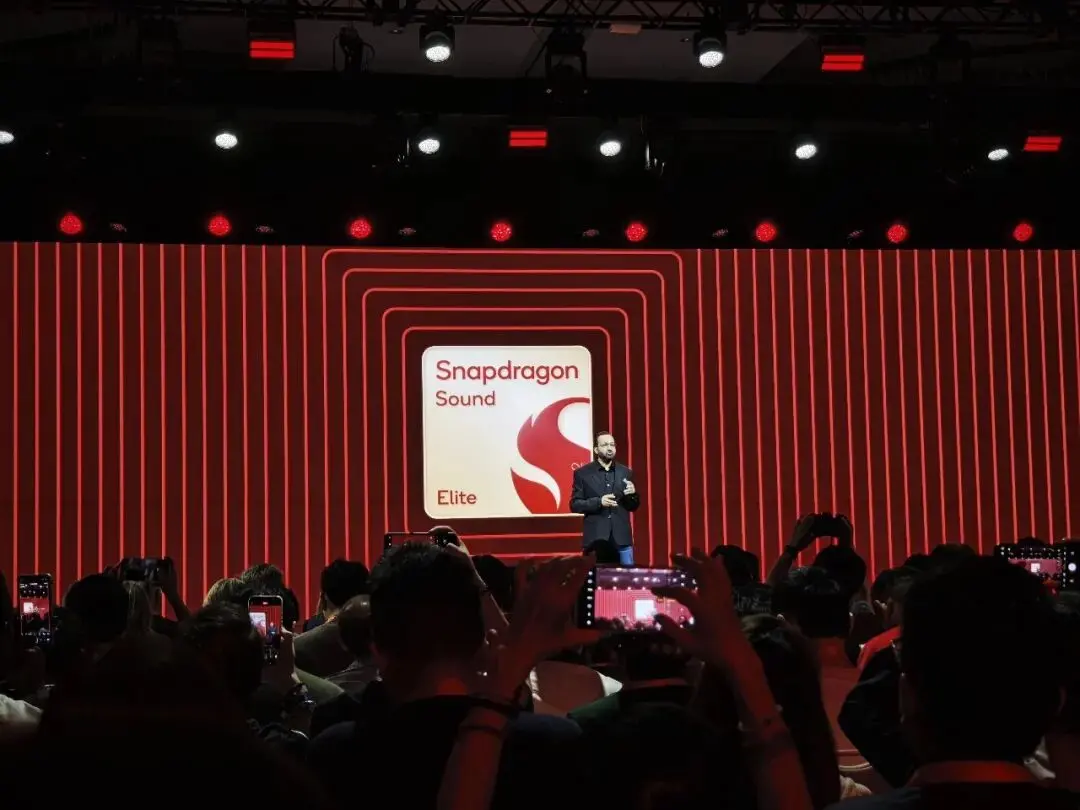
图片来源:「甲子光年」拍摄
它把终端侧AI、音频处理、蓝牙和超低功耗Wi-Fi 6E整合在一起,并支持带有摄像头的耳机、音频眼镜等多模态形态。摄像头的主要用途不是拍摄照片,而是为智能体补充用户眼前的环境信息。
根据高通提供的数据,平台峰值AI算力达到前代两倍,SoC(系统级芯片)面积缩小约30%,Wi-Fi空闲场景下的目标功耗降低最高40%。其中功耗数据仍来自设计仿真,最终表现需要等待芯片和量产终端实测。
比参数更值得注意的,是高通同步推出“骁龙畅听应用与智能体”生态。
借助超低功耗Wi-Fi和XPAN,耳机可以直接连接AI助手、内容和云服务,不再完全依附手机。开发者和服务商也可以通过MicroEJ框架,把应用与智能体部署到搭载骁龙畅听平台的终端中,并在产品销售后继续增加服务。
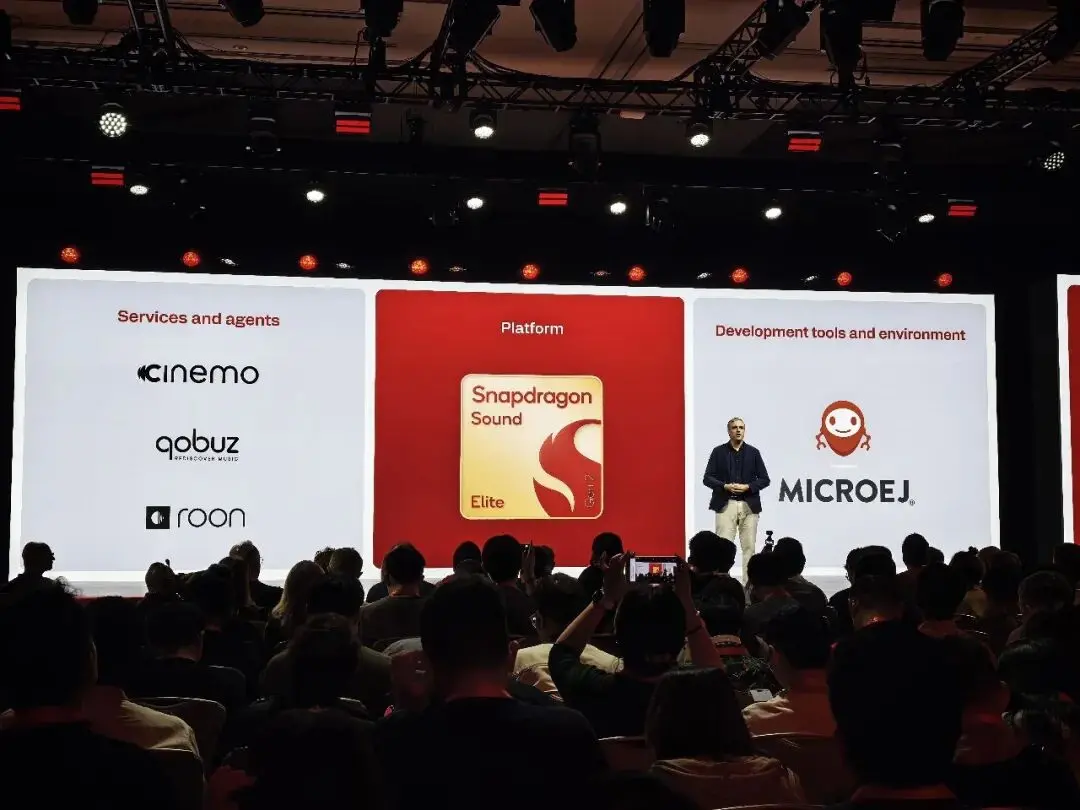
图片来源:「甲子光年」拍摄
耳机厂商Cleer在峰会现场展示了融合音频、视觉和AI能力的概念产品;惠普也在开发基于该平台的新产品,高通则表示正与Bose共同探索后续产品。
不过,这些仍处在早期阶段。概念产品、参考设计和合作开发并不等于规模出货,但它们说明耳机的定位正在改变:从播放手机声音的配件,转向可以独立感知环境、连接服务和调用智能体的入口。
类似变化也在PC上发生。
峰会现场展示了照片管理、播客制作、企业安全等多种智能体AI工作流。这些任务的共同点是持续运行、处理本地数据并调用多个工具。相比手机,PC拥有更宽松的功耗和散热空间,也天然承载邮件、文档、会议和企业应用,因此可能成为Agent处理复杂生产力任务的重要节点。
此次亮相的、搭载骁龙X Elite平台的Googlebook,则把Agent进一步推向操作系统入口。
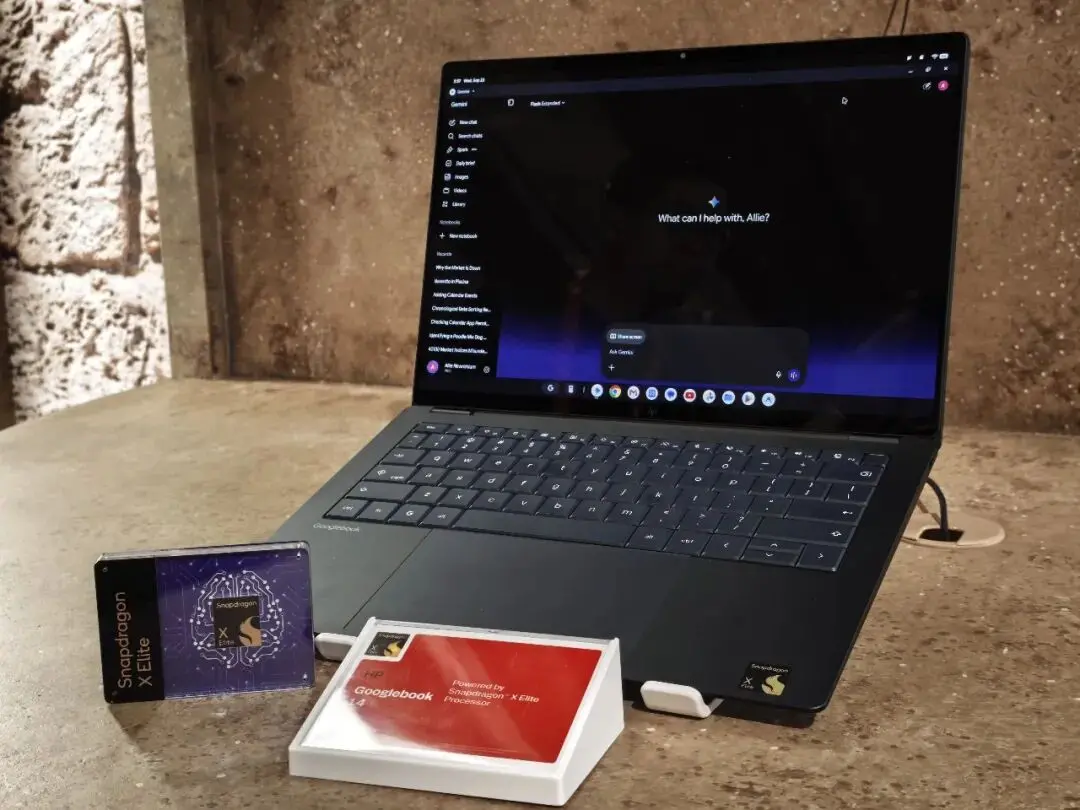
Googlebook,图片来源:「甲子光年」拍摄
谷歌平台与设备业务高级副总裁Rick Osterloh把Gemini Intelligence描述为传统操作系统之上的“智能层”。在Googlebook中,Gemini可以在后台处理邮件和日程,Magic Pointer把AI能力直接带到光标位置;设备还可以访问搭载骁龙平台的Android手机中的照片、文件和下载内容。「甲子光年」还在现场看到,Gemini可以通过Googlebook的摄像头指导一位用户的吉他指法。
对高通而言,专注个人PC端的骁龙X系列由此进入一个新的操作系统和终端品类。对谷歌而言,骁龙NPU提供了本地语音、低时延推理和隐私处理的硬件基础。
Linux支持则是另一个重要信号。
高通宣布,骁龙X2系列将扩展至Linux生态,并计划把Hexagon NPU和Adreno GPU等核心驱动提交至上游社区。Debian计划在2026年底前获得支持,Ubuntu认证预计在2027年上半年完成。
这项动作短期内未必带来庞大的消费市场,却有利于扩大开发者和企业应用覆盖。一个横跨Windows、Googlebook和Linux的平台,也更符合Agent跨硬件、跨操作系统运行的需求。
从手机、耳机到PC,再到Googlebook和Linux,高通的路线逐渐清晰:为不同终端提供相对统一的计算基础,为Agent跨设备延续上下文、分配任务和调用服务创造底层条件。
向下,高通拥有Oryon、Hexagon、Adreno、低功耗感知和连接技术;向上,它覆盖手机、PC、耳机、眼镜、XR、汽车、边缘物联网和数据中心。收购Modular后,高通还获得了Mojo语言、MAX推理框架和跨硬件部署能力,试图进一步补齐开发工具与AI软件平台。
不过,高通并不直接掌握大多数消费终端的操作系统、应用分发和最终AI入口。一项智能体任务从手机流向耳机、PC和汽车时,仍然需要生态伙伴共同参与。
其中任何一环没有开放接口,任务链都可能中断;任何一个环节出现权限和安全问题,用户也可能收回交给Agent的控制权。
埃森哲今年6月发布的对16个国家25590名消费者的调查显示,85%的受访者对与Agent协作持开放态度,74%愿意把议价、投诉处理等例行任务交给严格按指令行动的Agent;32%愿意让Agent决定购买什么,但付款仍由自己完成;愿意把购买全过程完全交给Agent的人只有9%。

图片来源:埃森哲
这组数据与峰会上的购物、订餐和行程演示形成呼应。用户愿意让智能体搜索信息、比较商品和安排行程,越接近付款、身份和对外沟通,用户越希望保留最后一步。
端侧推理可以减少个人数据离开设备的次数,硬件安全可以保护身份和支付凭证,但用户是否愿意长期使用Agent,还取决于权限是否透明、操作能否追溯、错误发生后由谁负责。
再回到骁龙峰会的体验区,同一个骁龙标识已经出现在手机、PC、眼镜、耳机和XR设备中。这种覆盖构成了高通发展Agentic AI的基础,也提出了下一阶段更难的问题:高通能否把分散在不同终端上的计算能力,连接成一套稳定、开放且值得信任的个人AI系统。
首批2nm骁龙旗舰移动平台、新一代音频平台、Googlebook和Linux支持,都是这条路线上的不同节点。
Agent正在重塑骁龙,而骁龙也正在从一套终端芯片平台,走向支撑个人AI跨设备运行的计算底座。
“行业改变了。”在演讲中,Chris Patrick感叹,但他很快切换到了下一张slide,“我们也改变了。”
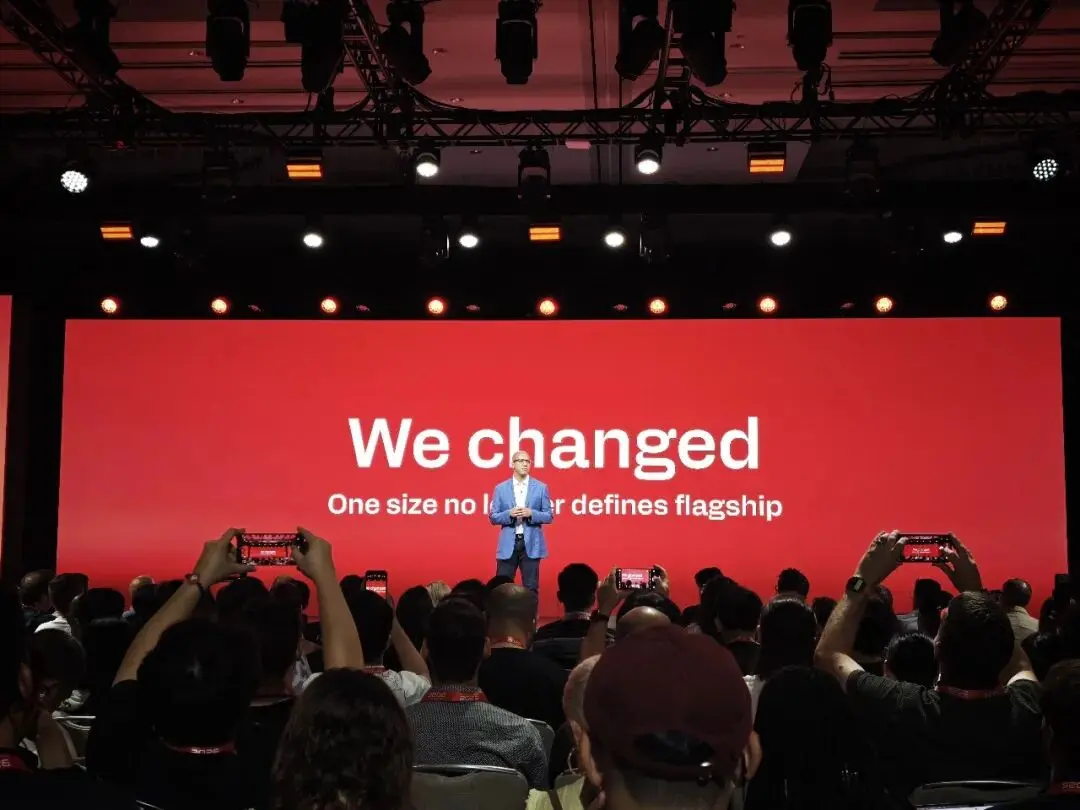
图片来源:「甲子光年」拍摄
(封面图来源:「甲子光年」拍摄)
END.