9月20日,启元机器人上海新品发布会。
Q1、T1双新品的亮相赚足了眼球,但在行业人士看来,这场发布会还有一个更值得关注的信号
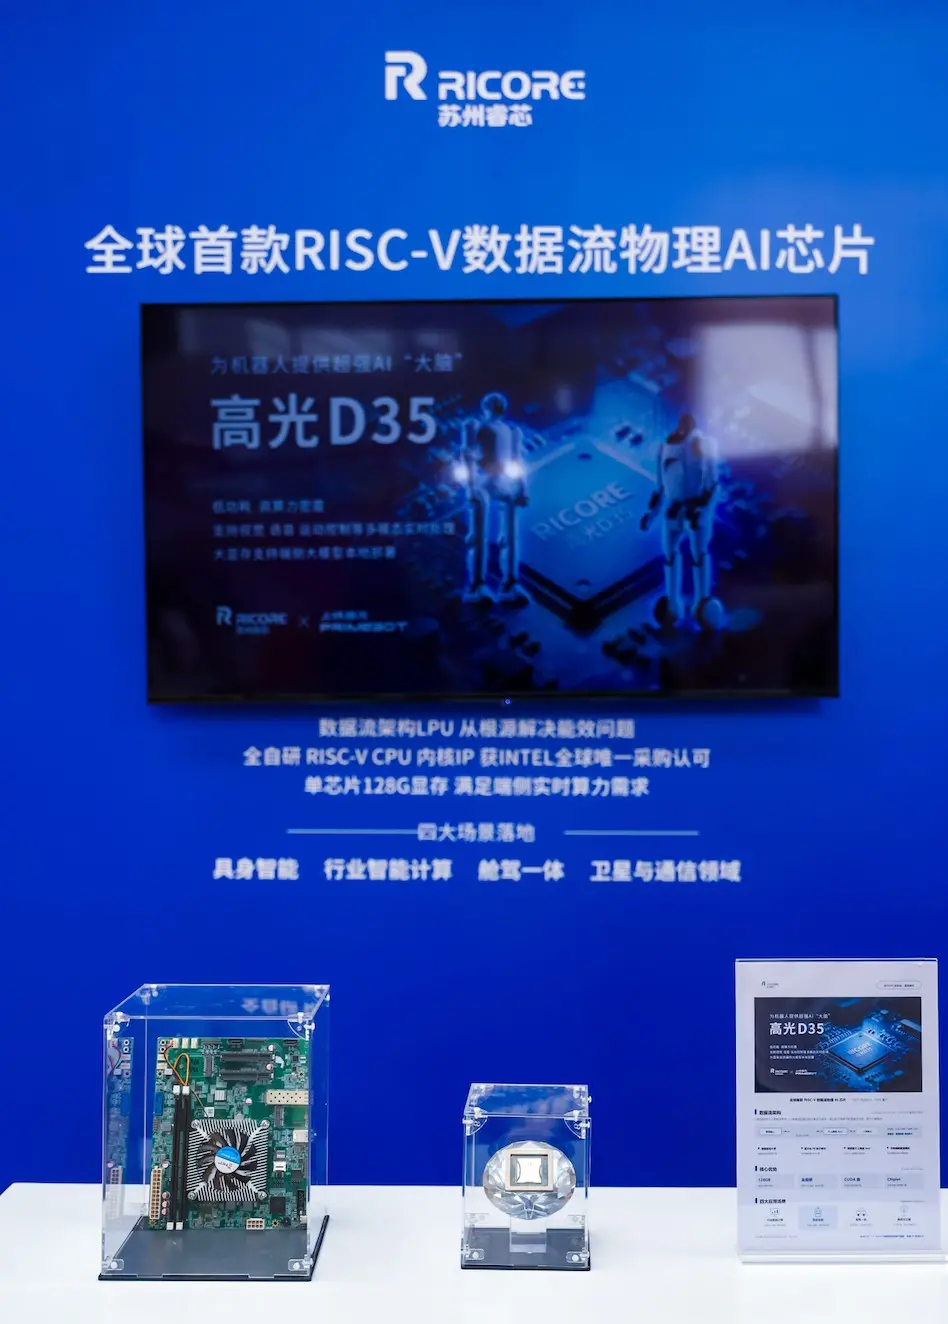
苏州睿芯,成为启元机器人的算力生态合作伙伴。
一家是消费级具身智能的新锐品牌,一家是数据流AI芯片的硬核玩家。两家公司的牵手,为什么值得拿出来单独聊?
因为这背后,藏着一个正在发生的产业变化:
具身智能的算力竞赛,已经从“拼性能”进入了“拼架构”的新阶段。
而数据流架构,正在从实验室走向产业一线。
一、具身智能,遇到了算力的“不可能三角”
人形机器人的端侧算力,有一个“不可能三角”
高性能、低功耗、低成本,三者不可兼得。
为什么这么说?我们来拆解一下机器人端侧到底需要算什么:
• 视觉感知:摄像头的实时画面处理,目标检测、场景理解、人脸识别……每一帧都要算,24小时不间断。
• 运动控制:步态规划、平衡控制、手臂动作、避障……这些对延迟极其敏感,差个几十毫秒可能就摔倒了。
• 多模态大模型推理:语音理解、对话生成、任务规划……大模型参数量动辄几十上百亿,端侧能不能跑得动?
• 多传感器融合:IMU、力觉、触觉、激光雷达……各种传感器的数据要实时融合处理,数据量巨大。
把这些加在一起,算力需求是惊人的。
但机器人的端侧环境又极其苛刻:
• 功耗不能高:电池容量有限,算力芯片功耗每增加10W,机器人续航可能就少半小时。
• 体积不能大:头部空间寸土寸金,芯片要做得足够小,散热还要压得住。
• 延迟必须稳:运动控制是实时系统,延迟波动比延迟本身更可怕。
传统的GPU方案,性能够强,但功耗和体积下不来;
传统的MCU方案,功耗够低,但性能差太远,跑不了大模型;
NPU/ASIC方案,是目前的主流路线,但在多模态、大模型推理场景下,算力利用率和灵活性仍然是挑战。
具身智能需要的,不是“更强的芯片”,而是“更对的架构”。
二、数据流架构:天生为高效AI推理而生
什么是数据流架构?为什么它能解决具身智能的算力痛点?
要回答这个问题,得先理解传统控制流架构(CPU/GPU)的根本问题在哪。
控制流的“通勤困境”
CPU和GPU都是“指令驱动”的。控制器发出指令,计算单元按照指令去内存里取数据、计算、再把结果写回内存。
这个模式下,数据就像上下班的人,从家里(内存)出发,挤地铁(总线)到公司(计算单元)上班,下班再挤地铁回家。
早高峰堵不堵?堵。
通勤时间占比高不高?高。
AI推理场景尤其如此。AI计算的特点是:数据量大、计算模式相对固定、需要反复访问内存。 用传统控制流架构跑,大量时间和功耗都花在了“数据搬运”上,真正用于计算的比例并不高。
这就是所谓的“存储墙”问题。
数据流的“就地办公”
数据流架构完全反过来。
它没有中央控制器,也没有“取指-译码-执行”的流程。数据到了,计算自动触发。 计算节点像一个个独立的办公室,数据(员工)到了就直接开始工作,算完的结果直接传给下一个计算节点(隔壁办公室),不需要回内存“打卡”。
这种架构带来了三个天然优势,每一个都精准命中具身智能的痛点:
✅ 能效比更高——算力不浪费
没有指令调度开销,没有反复的数据搬运,每一丝功耗都用在真正的计算上。对于靠电池驱动的机器人来说,能效比就是生命线。同样的电池容量,能效比高一倍,机器人就能多跑一倍时间。
✅ 延迟更确定——运动更稳
数据流的计算路径是预先定义好的,数据流动的时间可预测、可控制,不会出现控制流架构下的调度波动。对于机器人的运动控制来说,“稳定的低延迟”比“偶尔的低延迟”重要一万倍。
✅ 天然多模态并行——视觉语音一起算
机器人同时要处理视觉、语音、传感器等多种数据。数据流架构的计算节点天然并行,多路数据同时处理,不需要像GPU那样分时复用,效率更高。
简单说:控制流架构是“人找活干”,数据流架构是“活找人干”。
人找活干,灵活但效率低;活找人干,专一但效率高。
AI推理这种“活很多、模式固定”的场景,数据流架构的效率优势是天生的。
三、高光D35:为什么是它?
国内做AI芯片的公司不少,启元为什么选择了睿芯的高光D35?
我们来拆解一下这颗芯片的几个关键能力,看看是不是正好踩中了机器人的需求点:
1. 数据流架构 + RISC-V:从架构到指令集全自主
高光D35是全球首款RISC-V数据流物理AI芯片。这句话里有三个关键词:“数据流”“RISC-V”和“物理AI”。
数据流解决了架构创新的问题,RISC-V解决了指令集自主的问题。两者叠加,意味着这颗芯片从底层架构到指令集,每一层都是自主可控的。
对于机器人产业来说,这意味着什么?意味着供应链安全、意味着长期迭代有保障、意味着不会被卡脖子。
物理AI则定位的很清楚,这颗芯片不擅长大模型训练,主要聚焦的就是边缘AI推理场景。
而且睿芯的RISC-V CPU内核不是“玩票”的。这个IP已经获得了Intel全球采购认可。能被国际半导体巨头纳入供应链体系,技术含金量不用多说。
2. 单芯片128GB超大显存:大模型端侧落地的关键
机器人要变聪明,离不开大模型。但大模型有个特点:参数量大,吃显存。
7B模型全精度要28GB显存,13B要52GB,70B更是要280GB……就算量化到4bit,70B模型也需要35GB以上的显存。
很多端侧芯片的显存只有几GB、十几GB,根本跑不了大模型,只能跑一些轻量模型。
高光D35单芯片支持128GB高速显存。这个量级,在端侧芯片里是第一梯队的。意味着它可以在端侧运行更大的模型,机器人的智能能力天花板更高。
显存够不够大,直接决定了端侧AI的“智商上限”。
3. Chiplet先进封装:灵活适配不同场景
机器人不是一个单一产品。有人形机器人,有服务机器人,有工业机器人,有特种机器人……不同的机器人对算力的需求差异很大。
如果每一种需求都重新流片一颗芯片,成本太高了。
高光D35采用Chiplet多芯粒封装技术,可以通过不同的芯粒组合,灵活适配不同算力档位的产品需求。入门级的小机器人用少芯粒配置,高端人形机器人用多芯粒配置,软件栈统一,硬件按需组合。
这对于生态合作来说特别重要:一颗芯片的架构,可以覆盖启元全系列产品的算力需求。
4. 全栈软件生态:好用才是硬道理
芯片光有硬件参数没用,能不能让开发者快速上手、能不能跑主流模型、工具有没有,软件生态才是真正的护城河。
高光D35的软件栈是完整的:CUDA兼容编译器、Triton支持、Model Zoo模型库、vLLM/SGLang推理引擎……主流的AI开发工具链都能用,开发者迁移成本低。
对于启元这样的机器人公司来说,这意味着算法团队不用花大量时间做底层适配,可以把精力放在应用层创新上。
四、这不是“供应商关系”,而是“生态共建”
说到这里,你应该能理解为什么启元和睿芯的合作值得关注了。
这不是简单的“甲方向乙方采购芯片”的关系
这是场景方和芯片方的深度生态共建。
启元提供什么?
• 真实的具身智能应用场景
• 大量的机器人端侧算力需求
• 产品迭代反馈,帮助芯片持续优化
睿芯提供什么?
• 数据流架构的底层算力技术
• 高光D35芯片和完整软件栈
• 长期的架构演进路线图
两者结合,形成一个正向循环:
场景需求驱动芯片优化,芯片能力反过来拓展场景边界。
这种“应用+芯片”的深度绑定模式,在产业史上曾经诞生过很多伟大的组合
苹果的iPhone + A系列芯片,
特斯拉的电动车 + FSD芯片,
华为的手机 + 麒麟芯片……
最懂场景的公司,和最懂芯片的公司,一起做出来的东西,往往是最好的。
五、写在最后:数据流的大时代,才刚刚开始
高光D35和启元机器人的合作,是数据流架构从“技术概念”走向“产业落地”的一个标志性事件���
就在几年前,数据流还只是学术论文里的概念、顶会里的研究方向。
但现在,它已经开始走进工厂、走进城市、走进机器人
从论文里的公式,变成了现实世界里的算力。
ISCA 2026最佳论文提名,是学术界对数据流架构的认可;
Intel全球采购认可,是产业界对睿芯技术能力的认可;
而启元的生态合作,则是场景端对数据流路线的投票。
学术、产业、场景,三重认可,正在汇聚。
对于睿芯来说,启元是数据流进军具身智能的第一个标杆客户;
对于启元来说,睿芯是其算力生态的重要底座。
而对于整个行业来说,这次合作可能意味着——
国产具身智能的算力自主之路,有了一条新的、可行的路径。
更多的答案,9月25日杭州第五届全球数字贸易博览会,高光D35量产发布会,我们接着看。