作者,Evil Genius
只要大家坚持不下桌,轮也该轮到我们了。
今天我们来补充靶蛋白抗体设计的一些内容。
如果靶蛋白三维结构已经知道,设计能够特异性结合它的抗体,本质上就是一个:
“先找靶点表面合适的表位(epitope)→ 再设计能够互补识别该表位的抗体结合面(paratope)→ 通过结构建模、序列设计和实验筛选不断优化”
可以把整个过程理解成下面这条路线:
一、总体设计思路
| 阶段 | 核心问题 | 常用方法/工具 |
|---|---|---|
| 1. 靶蛋白结构分析 | 靶蛋白哪里适合抗体结合? | PDB、PyMOL、ChimeraX |
| 2. 表位发现 | 找到特异性表位 | Epitope prediction、结构分析 |
| 3. 表位筛选 | 哪个表位最值得设计? | 保守性、表面暴露、特异性分析 |
| 4. 抗体骨架选择 | 用什么 antibody scaffold? | VH/VL、scFv、Fab、nanobody |
| 5. CDR设计 | 如何让抗体识别表位? | CDR grafting、Rosetta、RFdiffusion等 |
| 6. 分子对接 | 抗体能否正确结合? | HADDOCK、RosettaDock、ClusPro |
| 7. 结构优化 | 如何提高结合稳定性? | Rosetta/FoldX/MD |
| 8. 序列优化 | 哪些突变提高亲和力和特异性? | ProteinMPNN、Rosetta等 |
| 9. 实验筛选 | 计算结果是否真实? | ELISA、SPR、BLI |
| 10. 亲和力成熟 | 从 nM 做到更高亲和力 | 定向突变+筛选 |
二、第一步不是设计抗体,而是先找“表位”
这是整个过程最重要的一步。
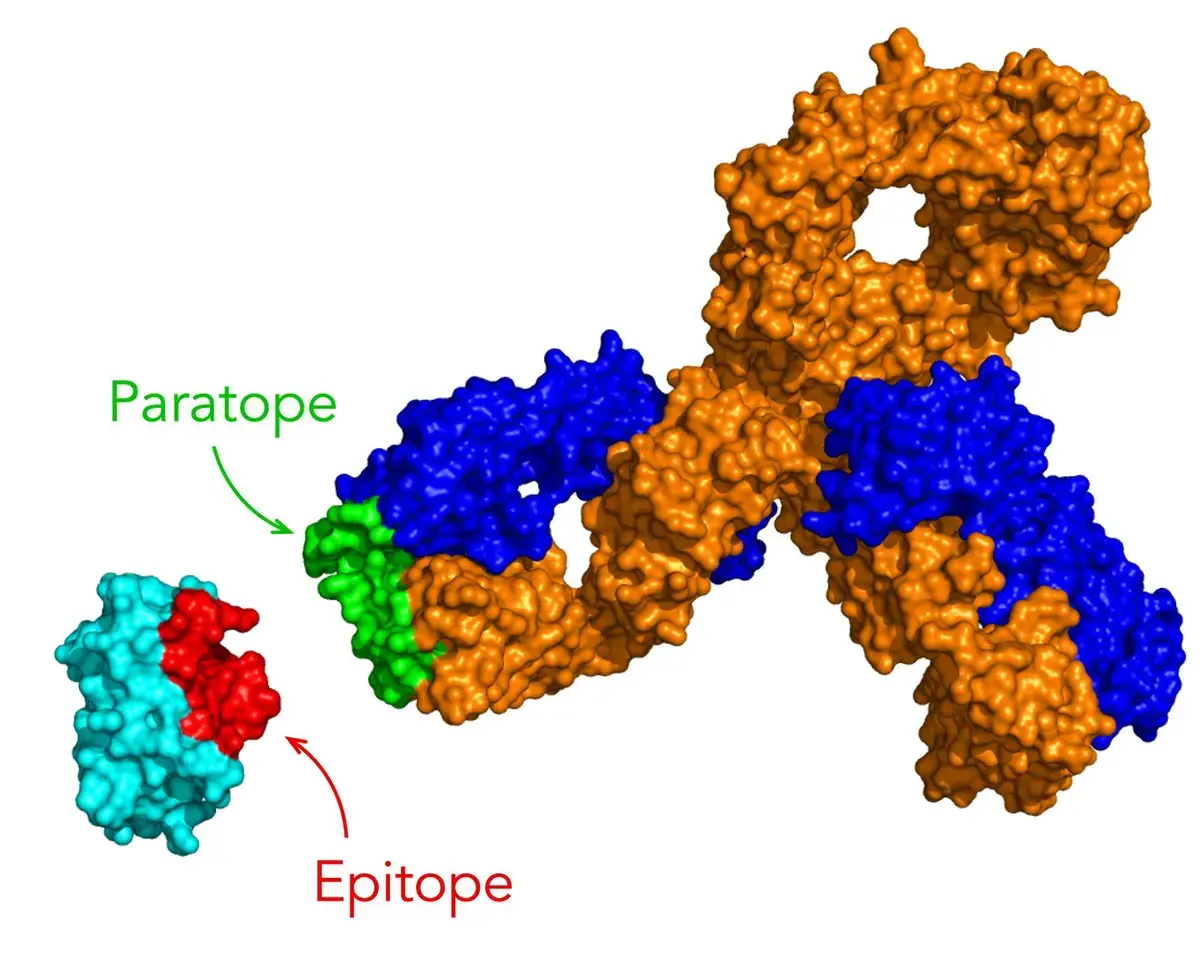
假设靶蛋白:
Target protein ┌─────────────────┐ / \ / Surface \ | | | ★ Epitope | \ / └─────────────────────┘ ↑ antibody binding 抗体并不是随机结合整个蛋白,而是识别蛋白表面的一个区域。
理想表位通常具有:
-
表面暴露
-
有一定面积
-
具有独特的三维形状
-
与其他同源蛋白存在差异
-
不被糖基化等因素严重遮挡
-
能形成较好的氢键、疏水作用、盐桥等相互作用
三、特别重要:如果目标是“特异性”,首先分析同源蛋白
例如要设计:
抗 EGFR 突变体抗体
不能只看 EGFR 的结构。
应该同时拿:
Target protein ↓ Target mutant ↓ Wild type ↓ Homologous proteins ↓ 结构比对 ↓ 寻找 target-specific surface 例如:
WT protein AAAAA----BBBBB----CCCCC ↑ conserved Mutant protein AAAAA----BBXBB----CCCCC ↑ mutation ★ ideal epitope 如果希望抗体只识别突变蛋白而不识别 WT,那么最有价值的表位往往是:
包含突变位点,并且突变造成局部表面性质明显变化的区域。
这比单纯寻找“结合能最低”的位置更加重要。
四、第二步:确定抗体采用什么形式
常见设计形式:
| 抗体形式 | 特点 |
|---|---|
| IgG | 完整抗体,实验和治疗常用 |
| Fab | 保留抗原结合能力,结构研究常用 |
| scFv | VH + VL,通过 linker 连接 |
| VHH / Nanobody | 单域抗体,体积小 |
| Fv | VH + VL |
| 双特异性抗体 | 同时识别两个靶点 |
如果主要是做计算设计,通常可以先从:
VH + VL / scFv / nanobody
开始。
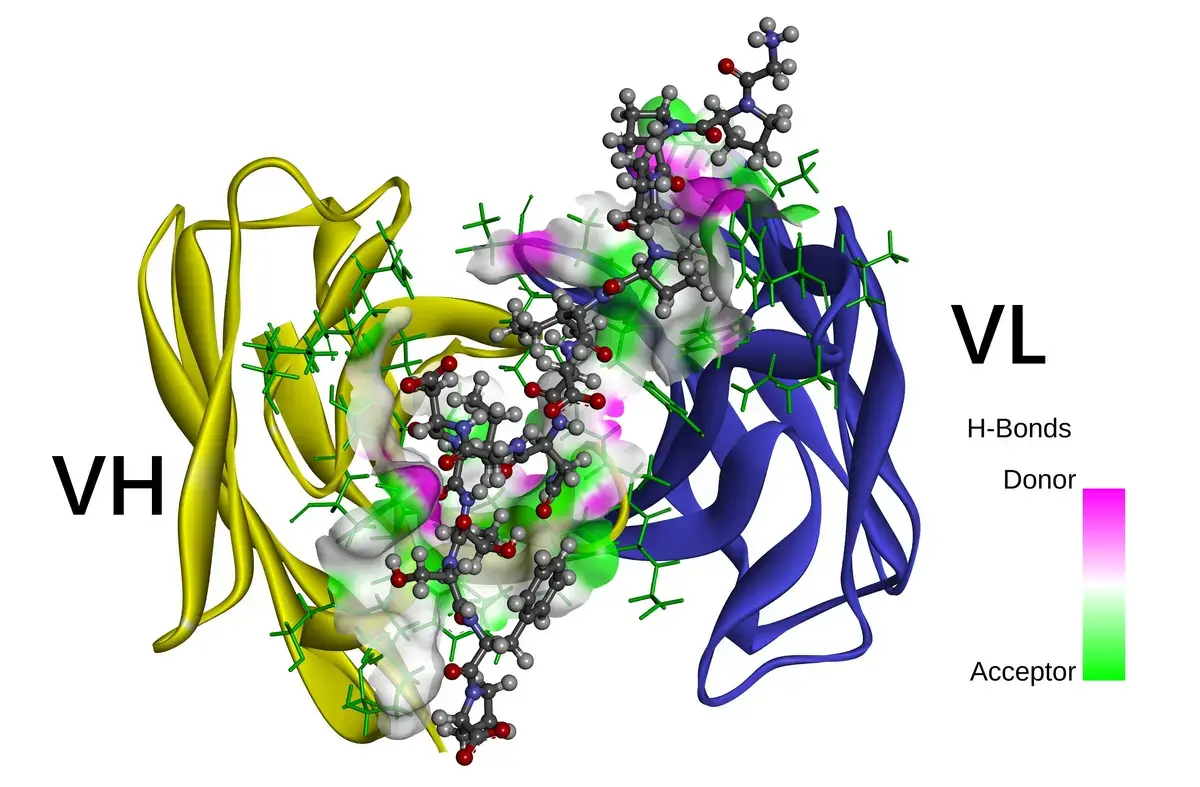
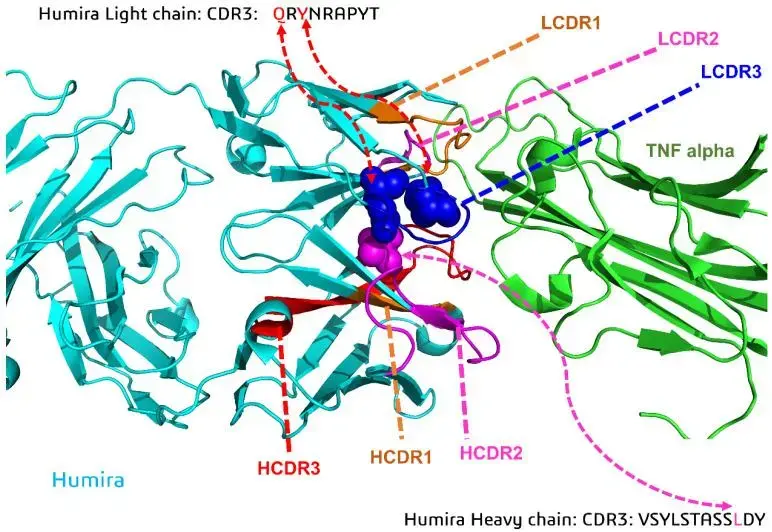
五、真正决定“识别谁”的是 CDR
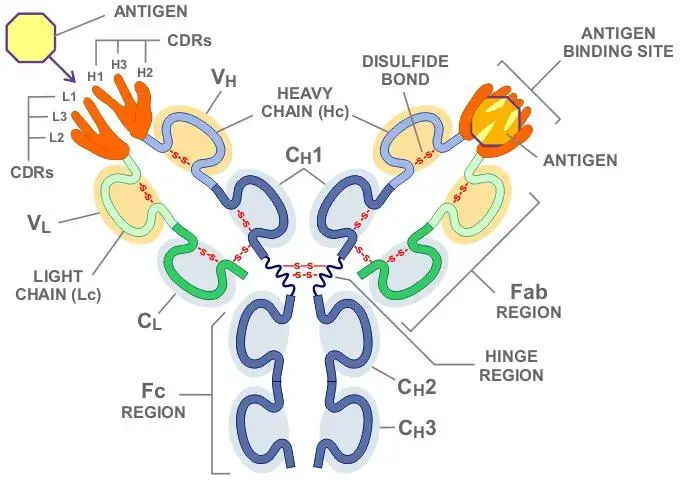
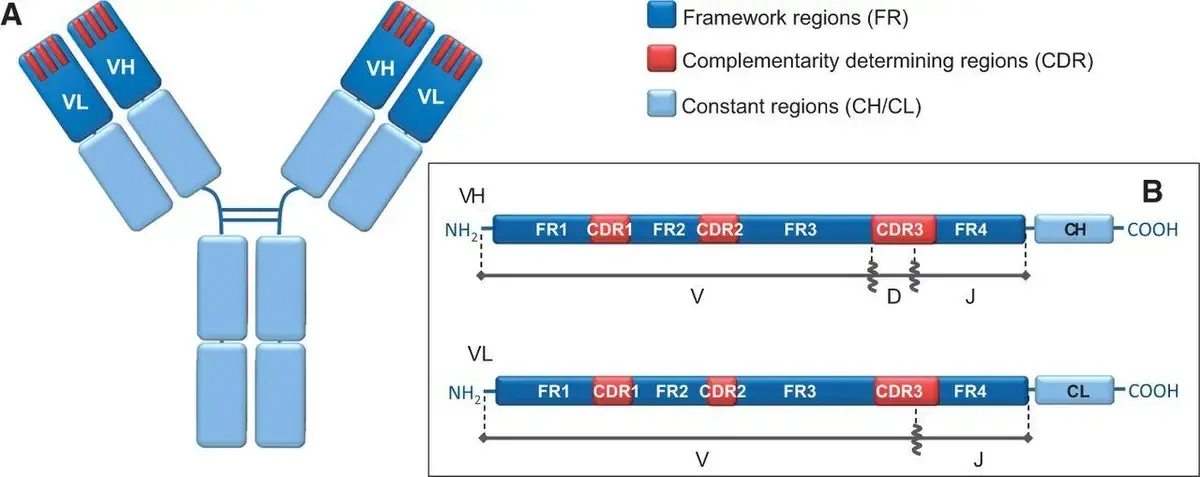
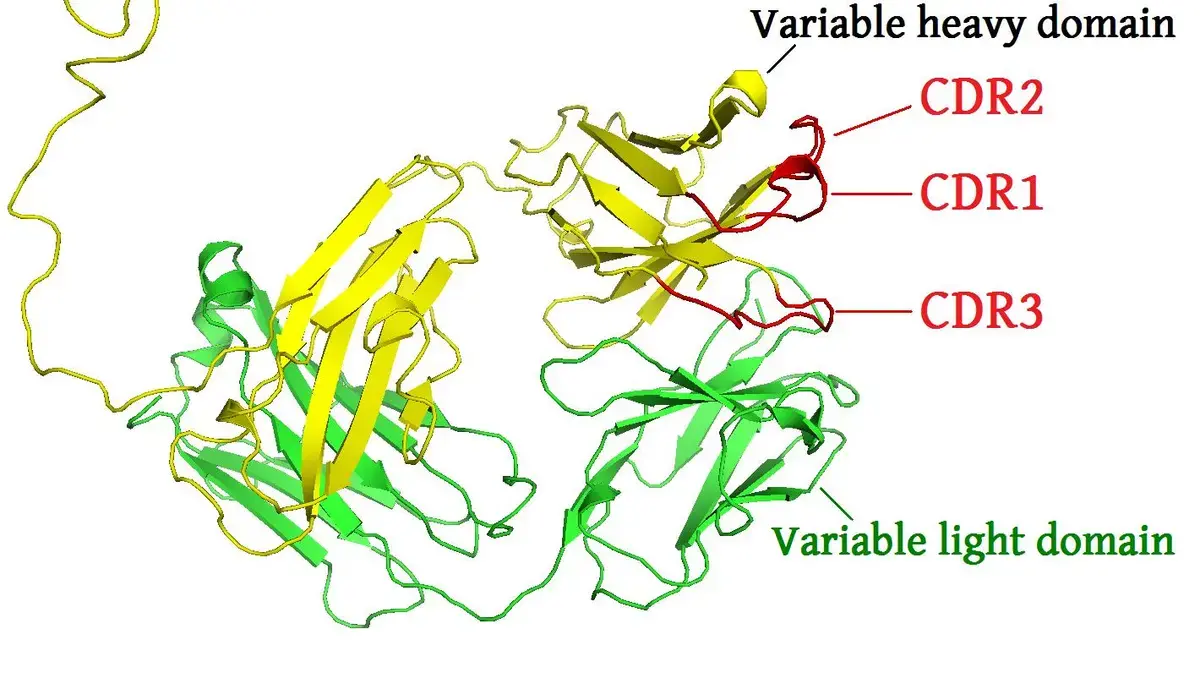
抗体结构大致可以理解成:
Antigen ┌───────────────┐ │ │ │ EPITOPE │ │ ★ │ └───────┬───────┘ │ CDR-H3 ★★★★★ / \ CDR-H2 CDR-H1 \ / \ / VH VL \ / CDR-L 其中尤其重要的是:
CDR-H3
它通常对抗原识别贡献非常大。
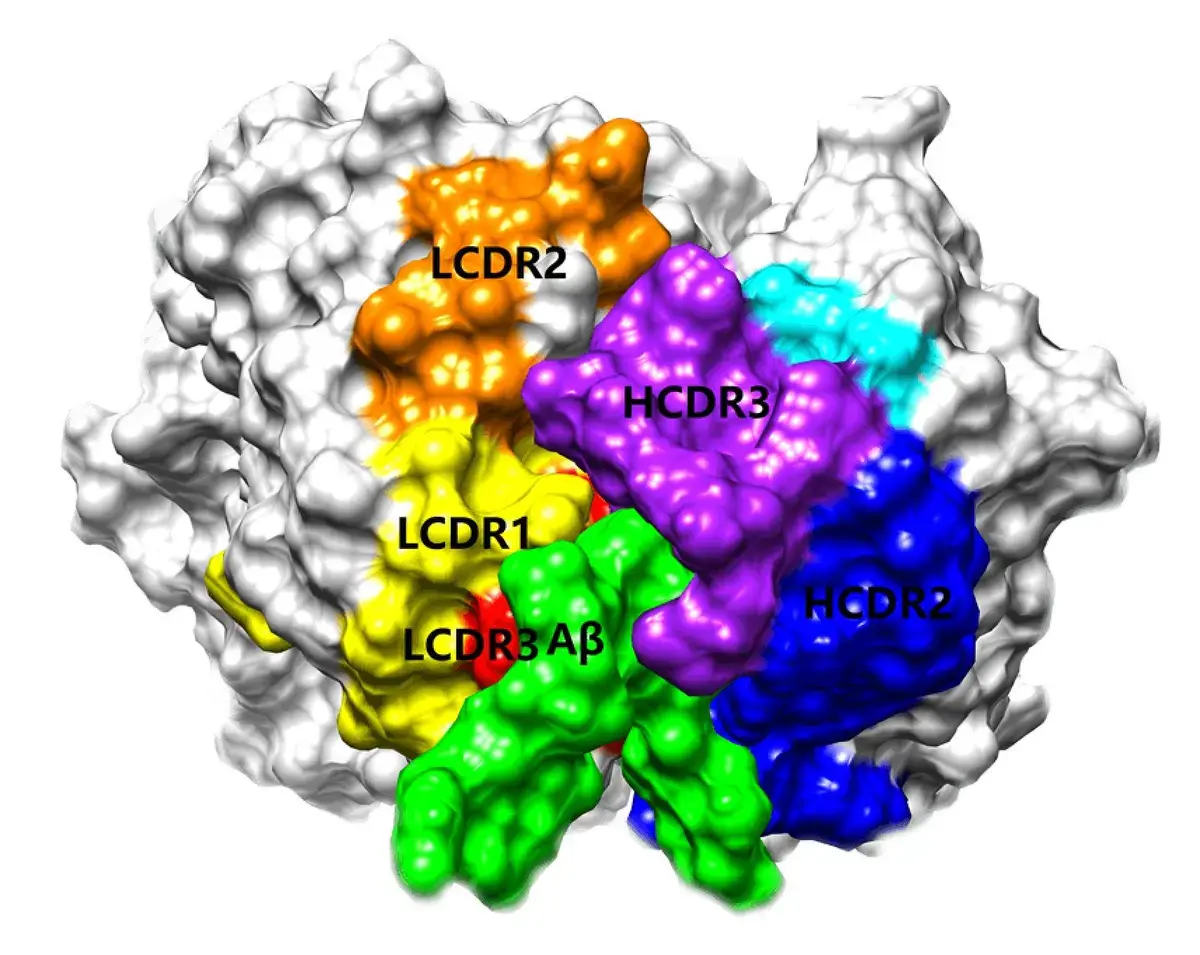
所以结构抗体设计的核心其实可以进一步简化成:
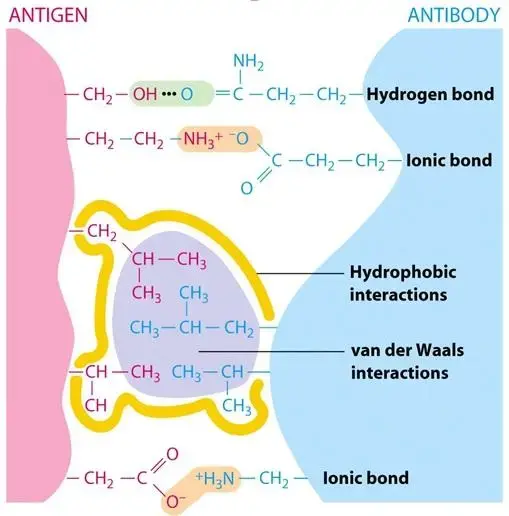
设计一个 CDR 区域,使其三维形状和化学性质与表位互补。
六、可以把抗体设计理解成“锁和钥匙”
例如靶蛋白表面:
Target surface O ──────── / \ | + H | ← 表位 | O | \________/ ↓ Antibody CDR \ / \_/ O + 希望形成:
Shape complementarity + Electrostatic complementarity + Hydrogen bonds + Hydrophobic interactions + Van der Waals interactions 所以不是简单地:
“找一个 docking score 最低的抗体”
而是:
表位 → CDR三维形状 → 界面互补 → 序列优化 → 亲和力/特异性验证
七、现在比较重要的一条路线:De novo antibody design
如果没有现成抗体,可以采用:
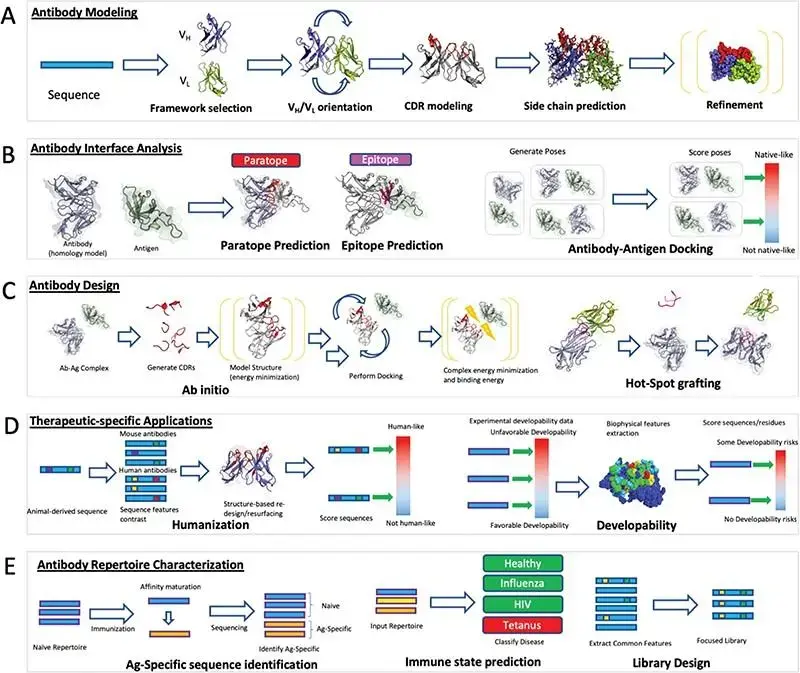
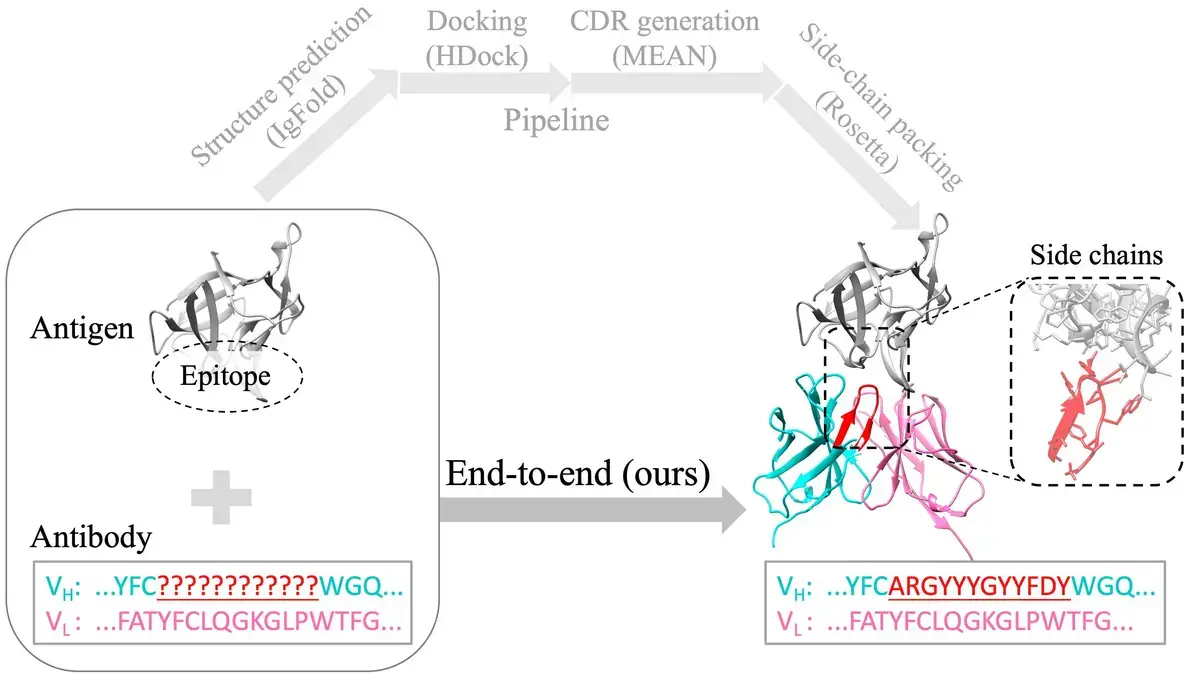
Target structure ↓ Epitope identification ↓ Define antibody binding site ↓ Generate antibody backbone ↓ Generate CDR sequences ↓ Structure prediction ↓ Antibody-antigen docking ↓ Interface optimization ↓ Sequence optimization ↓ Experimental validation 其中可以使用一些现代生成式蛋白设计方法。
例如:
-
RFdiffusion
-
ProteinMPNN
-
Rosetta
-
AlphaFold/AlphaFold-Multimer 等结构预测方法
-
HADDOCK
-
ClusPro
这些方法承担的任务并不完全相同。
八、一个比较现代的“AI抗体设计”框架
可以把它画成:
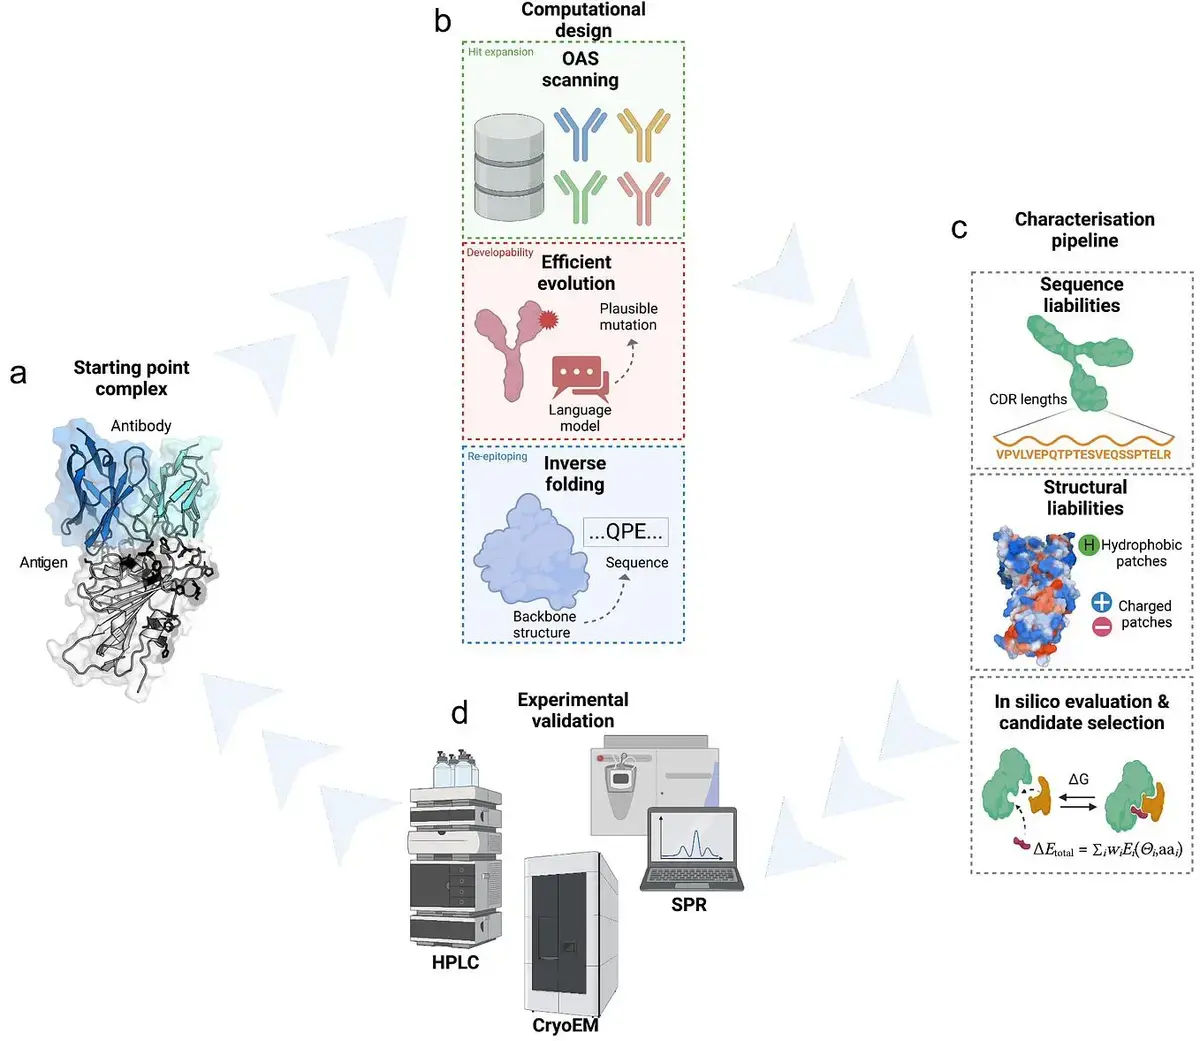
Target protein │ ↓ ┌────────────────┐ │ Epitope mining │ └───────┬────────┘ ↓ Target epitope │ ↓ ┌────────────────────┐ │ Backbone generation│ └─────────┬──────────┘ ↓ Antibody backbone │ ↓ ┌────────────────────┐ │ CDR generation │ └─────────┬──────────┘ ↓ Candidate antibody │ ↓ Antigen-antibody docking │ ↓ Interface optimization │ ↓ Sequence design │ ↓ Structure prediction │ ↓ MD / scoring │ ↓ Candidate ranking │ ↓ Experimental test 九、如果已经有一个抗体,就更容易
如果不是从零开始,而是:
已经有一个能够结合靶蛋白的抗体,希望提高亲和力/特异性
路线会变成:
Existing antibody ↓ Antigen-antibody complex ↓ Identify interface ↓ Identify CDR residues ↓ Virtual mutation ↓ Docking / Rosetta ↓ ΔΔG calculation ↓ MD ↓ Select mutations ↓ Experimental validation 这种属于:
Affinity maturation / antibody optimization
比完全 de novo 设计简单很多。
十、如果只有靶蛋白,没有抗体,推荐如下计算路线
Step 1:靶蛋白准备
PDB ↓ remove unwanted molecules ↓ add H ↓ check missing residues ↓ minimize ↓ Target structure Step 2:表位分析
Target ↓ surface mapping ↓ solvent accessibility ↓ conservation ↓ hotspot analysis ↓ candidate epitopes Step 3:抗体生成
Candidate epitope ↓ Antibody scaffold ↓ CDR-H3 design ↓ CDR-H1/H2 ↓ CDR-L1/L2/L3 Step 4:抗原-抗体对接
可以尝试:
HADDOCK / ClusPro / RosettaDock
得到:
Antigen + Antibody ↓ multiple docking poses 然后重点分析:
-
interface area
-
shape complementarity
-
H-bonds
-
salt bridges
-
hydrophobic contacts
-
buried surface area
-
interface ΔG
-
hotspot residues
十一、然后 Rosetta 优化
例如:
Antigen │ │ antibody │ CDR-H3 / \ residue1 residue2 │ │ mutation mutation ↓ ↓ Rosetta relax ↓ interface ΔG ↓ MD ↓ candidate selection 可以对 CDR 的部分残基进行计算突变扫描。
例如:
CDR-H3 W A G Y F D Y ↑ mutate A → F A → Y A → W A → L A → V ... 然后比较不同突变对结合界面的影响。
十二、但这里有一个非常关键的区别
如果目标是:
“让抗体结合这个蛋白”
那么主要优化:
binding affinity
但如果目标是:
“让抗体只结合这个蛋白,而不结合类似蛋白”
那么必须同时优化:
Affinity + Specificity
例如:
Target ★ / \ / \ Antibody │ │ ↓ strong binding Homolog ★ / \ / \ Antibody × weak/no binding 因此需要做:
positive design + negative design
也就是:
Target ↓ maximize binding Off-target proteins ↓ minimize binding 这其实是特异性抗体设计最核心的计算思想之一。
十三、最终可以形成一个完整的“结构驱动抗体设计”体系
Target protein structure │ ↓ ┌────────────┐ │ Epitope │ │ prediction │ └─────┬──────┘ ↓ Candidate epitopes │ ┌───────────┴───────────┐ ↓ ↓ Target-specific Off-target analysis analysis │ │ └───────────┬───────────┘ ↓ Antibody scaffold ↓ CDR design ↓ Antigen-antibody docking ↓ Interface analysis ↓ Rosetta optimization ↓ Sequence design ↓ MD simulation ↓ ┌───────────┴───────────┐ ↓ ↓ Affinity Specificity │ │ └───────────┬───────────┘ ↓ Candidate antibodies ↓ Experimental validation ↓ Affinity maturation