DeepSeek 把压箱底的推理框架开源了。这次不是模型,是那个决定算力成本和电费多少的中间层——DeepInfer。
推理框架这个角色,普通用户感受不到,但它每天都在起作用。训练让模型「学有所成」,推理让模型「为人所用」——海量用户调用时,是推理框架在统筹调度庞大的算力集群,它的效率直接决定 AI 服务的算力成本和电力消耗。DeepSeek 之前开源了一串大模型、TileLang 编译工具、推理算子库,这次把内部推理框架 DeepInfer 也全面开源,算是在这条线上补上了最关键的一块。
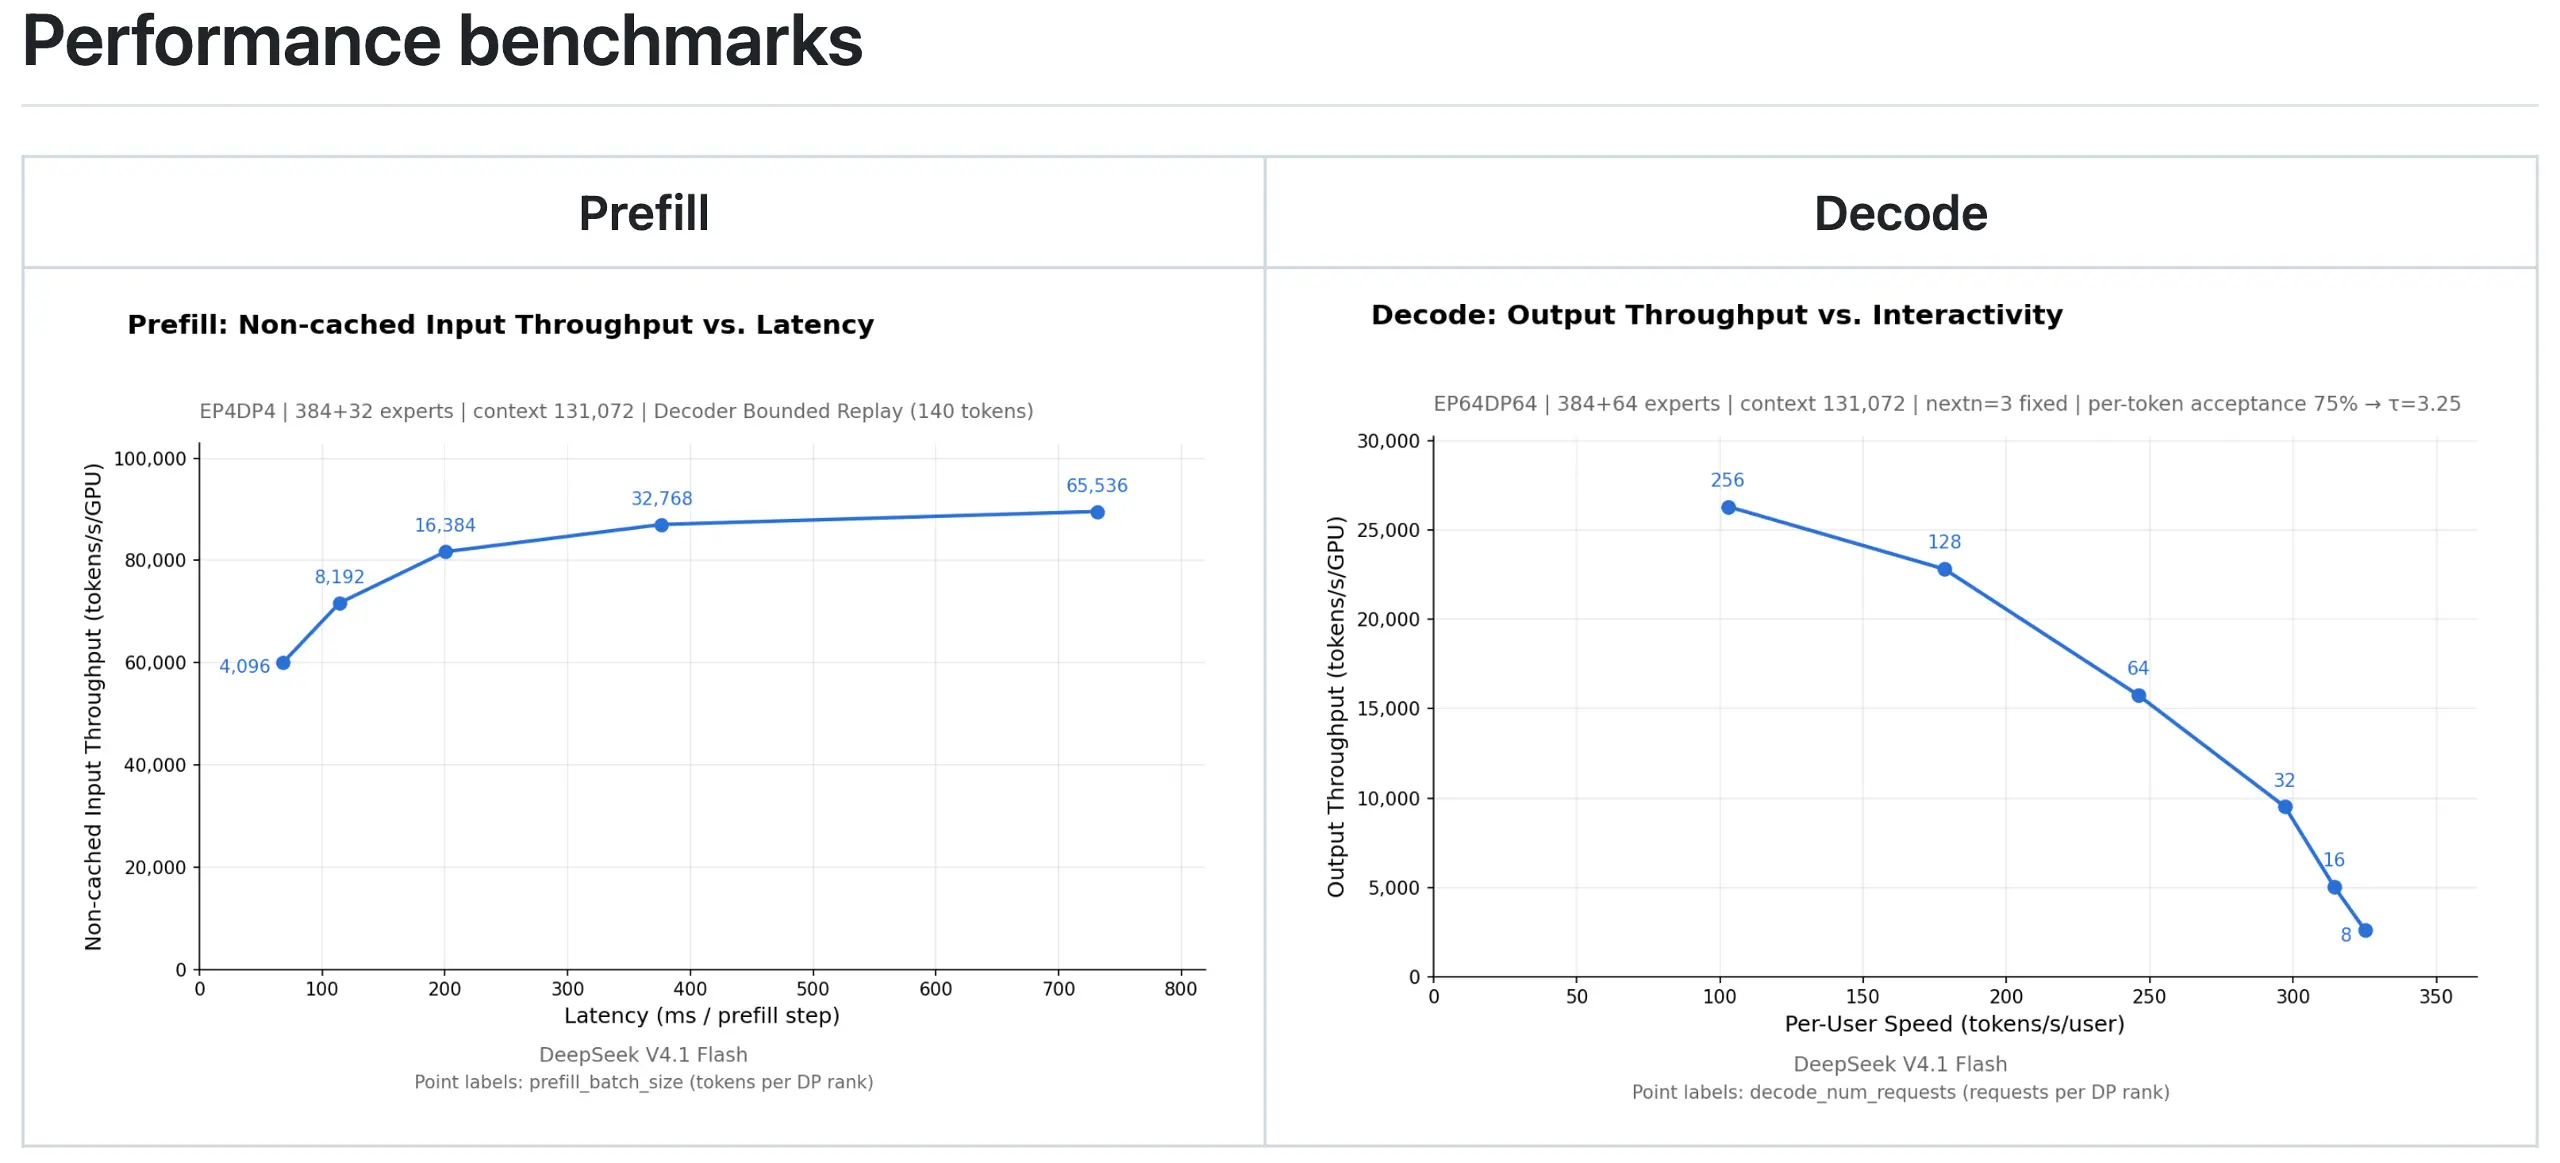
DeepInfer 的定位很清楚:集成高性能算子与深度优化的推理引擎,支持分布式推理、推测解码、SWA Bounded Replay、结构化输出这些能力,而且同时兼容英伟达和华为昇腾平台——这个「双平台」不是顺带一提,对国内要跑昇腾的团队是实打实的价值。官方说,DeepSeek V4.1 Flash 的高吞吐、低延迟大规模推理服务就是基于它跑的,而且未来新模型的推理代码和后续优化也会在这里持续更新。
同步开源的还有一个容易被忽略但很关键的组件:deepseek-recipe,一个生产级 Token 编解码组件,和 DeepSeek 官方 API 的处理逻辑完整对齐。这意味着社区自建部署能获得和官方 API 一致的体验——对齐到什么程度,直接决定私有化部署能不能「无缝替代」官方服务。
DeepSeek 这次的姿态值得注意。官方的引文是「为善与众行之,为巧与众能之」——翻译过来就是把好东西拿出来一起用。它开源的主线很清楚:模型(权重)+ 算子库(TileLang)+ 推理框架(DeepInfer)+ 编解码组件(recipe),整个服务链路都放出来了。对一个有大量真实流量的厂商来说,把生产级推理栈开源,既是对社区的技术输出,也是把「私有化部署的体验标准」握在自己手里——开发者按你的标准部署,生态就长在你的体系上。
DeepSeek V4.1 Flash 刚在 1017 版本里强调过「许愿式编程」和搜索 API,现在又开源推理框架——这一周 DeepSeek 的动作密度不低。推理开源这个动作,对想自建 AI 服务的企业比模型本身更实用。
参考来源: